Vidu S2上线:实时换装、换人、空间视频一步到位
Vidu S2来了,视频能像P图一样边播边改
你有没有试过在看AI生成的短视频时,突然冒出一个念头:“要是她穿那件衣服就好了”或者“能不能把背景换成海边”?以前这种想法只能想想,现在Vidu S2直接把它变成了现实。
生数科技最新发布的Vidu S2模型,最大的亮点就是实时视频编辑能力。正在播放的视频,你可以随时换装、换人、换背景、换画风,而且效果相当自然。比如一位女士在接受采访,系统能在不中断播放的情况下,给她换上不同款式的衣服——驼色大衣的袖口甚至会半遮住她手腕上的首饰,细节处理得很到位。
当然也有小瑕疵。某些颜色块在动态中略显涂抹感,戴帽子时头发偶尔会穿模。但整体来看,人物动作连贯、脸部一致性强、服装形变真实,已经远超多数同类工具的表现。
除了换装,换背景也玩出了花样。一个跳舞的女孩可以瞬间从室内切换到沙漠、森林或城市街头,仿佛在拍MV。更离谱的是“换人”功能:办公室里的你,下一秒就能变成牛来、财神爷,甚至一只尖叫鸡,还能完美融入原场景的透视和光影中。打工人开会时替换成财神爷,说不定真能让老板多看两眼。
风格迁移同样流畅。同一个人物切换赛博朋克、水彩、油画等风格,全程画面稳定,没有闪烁或断裂感。这四类编辑能力——换装、换背景、换主体、换风格——让直播、虚拟演出和创意视频多了大量临场发挥的空间。观众发个弹幕“穿恐龙服”,主播可能真就秒换上了。
数字人升级:720P画质+中途传图+复杂动作
Vidu S2的另一个核心是S2-Avatar,也就是实时互动的数字人模块。相比上一代S1的540P,这次直接提升到720P,面部细节和衣物纹理更清晰。更重要的是,它现在能执行大幅度的身体动作了。
实测对比很直观:让数字人跳舞、转圈、跺脚,S1基本没反应,S2却能准确完成。这意味着数字人不再只是“嘴上答应”,而是真正“身体力行”。
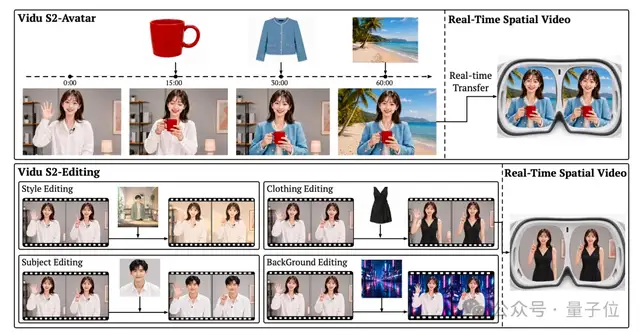
更关键的升级是中途接收参考图。你可以在对话进行中上传一张图片,让它穿上图中的衣服、拿起指定物品,或者进入新场景。比如聊着天突然发张咖啡杯照片,它就能伸手去拿;发件西装照,它立刻换装。这种能力让数字人从“聊天搭子”变成了能配合演出的“搭档”。
背后的技术支撑是一套重新设计的状态跟踪机制。系统需要知道当前画面里有什么、人物在做什么、上一条指令是否完成,才能合理响应下一条。为此,Vidu S2引入了一个叫VLM Agent的视觉语言模型智能体,持续解析已生成画面,规划后续动作,并在合适时机调整生成条件。
空间视频:让AI角色“走出屏幕”
除了2D交互,Vidu S2还押注了空间视频。所谓空间视频,是利用双视角(如主摄+超广角)录制,记录景物的立体深度信息,在Apple Vision Pro这类设备上能呈现三维沉浸感。
现在,基于S2-Avatar可以实时生成空间视频,基于S2-Editing还能实时编辑空间视频。比如把一段普通访谈转成立体格式,或者用头显摄像头捕捉的真实环境作为“画布”,叠加AI生成的角色。
团队坦言,头显对分辨率和延迟要求极高——画面糊了会晕,延迟高了转头时画面会“打架”。目前还在优化中,但方向很明确:从固定视角扩展到全景空间视频,让你转头就能自由探索AI生成的世界。元宇宙的雏形,或许就藏在这种实时交互里。
69天迭代,技术底牌怎么打?
从Vidu S1到S2,只用了69天。两个月前S1刚实现“语音控制数字人无限时长互动”,打破传统“音频驱动口型+预设动作”的局限。S2则在此基础上全面升级。
要实现“边播边改”,首先得解决流式生成的稳定性。视频每一帧都是现场计算,速度必须跑赢播放,否则就是卡顿幻灯片。团队用SageAttention加速计算,多GPU协同调度减少等待,让整条链路跑得更顺。
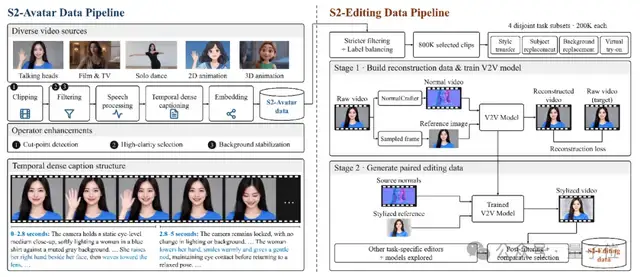
训练数据也做了扩充。为了让人物动作更丰富,加入了舞蹈、2D/3D动画素材,并对视频做背景稳定处理,保留大幅动作的同时减少镜头晃动干扰。标注方式也按事件顺序重构:记录动作何时开始、带来什么变化、结束后处于什么状态。这样“抬手→拿杯→端着说话”的衔接才有清晰的学习依据。
流式训练的难点在于误差累积——前面一帧偏了,后面可能一路崩。Vidu S2先用Hybrid Forcing学会分段生成,再通过Self-Replay Forcing“复盘”:让模型连续生成一段视频,给结果分块加噪,进行因果回放。这样后续片段的反馈能反向影响早期表示,即使前面有偏差,后面也能接稳。
画质和实时性的平衡靠的是Backbone-Refiner两阶段架构。Backbone在低分辨率下确定主体结构、运动和语义内容;Refiner负责生成细节。两者通过异步流水线并行工作——一位画师打底稿抓动作,另一位精修细节,互不等待。这才实现了720P输出不掉帧。
而“时间戳对齐”是实时编辑的关键。用户中途发一张衣服图,模型不仅要认出“换成什么”,还得知道“从哪一帧开始换”。Vidu S2重新设计位置编码,将参考图注入位置与时间戳绑定,确保新条件从指定时间点生效,并保持运动与光照连续性。
最后是强化学习。双向阶段用DPO优化画质、表情、动作自然度和音画同步,为流式训练提供强教师模型;流式阶段采用Streaming NFT,直接优化因果模型。模型先生成自己的视频轨迹,再沿用SRF回放思路做奖励优化,让训练贴近实际运行状态。
不搞内测,当天全量开放
最让人意外的是,Vidu S2发布当天就全量开放,不设内测、不限名额。这种操作在AI模型发布中并不多见,某种程度上也是对技术成熟度的自信。
从Vidu S1的语音互动,到S2的实时编辑、高清动作、空间视频,人与AI的交互正变得越来越自然。两年前还觉得“虚拟人能听懂并执行复杂指令”是科幻,现在它已经成了直播间里一点就有的功能。
传送门也放在这儿:官网vidu.cn提供在线体验,API平台和arXiv上的技术报告则供开发者深挖。至于普通用户?不妨去试试把老板变成财神爷——万一真管用呢。