AI BioDesign 启动:用百万级并行实验闭环训练蛋白质设计模型
AI 不再只是出图,而是驱动整个实验流程
AI 设计蛋白质早已不是新闻。从 AlphaFold 预测结构,到后来的 de novo 蛋白质生成,机器学习模型已经能批量产出自然界从未见过的分子蓝图。但这些设计能不能真正起作用,还得靠试管、细胞和动物实验说了算。过去几年里,AI 生成能力突飞猛进,实验验证却常常卡在低通量的老路上——一次只能测几十个候选,成了整个研发链条的瓶颈。
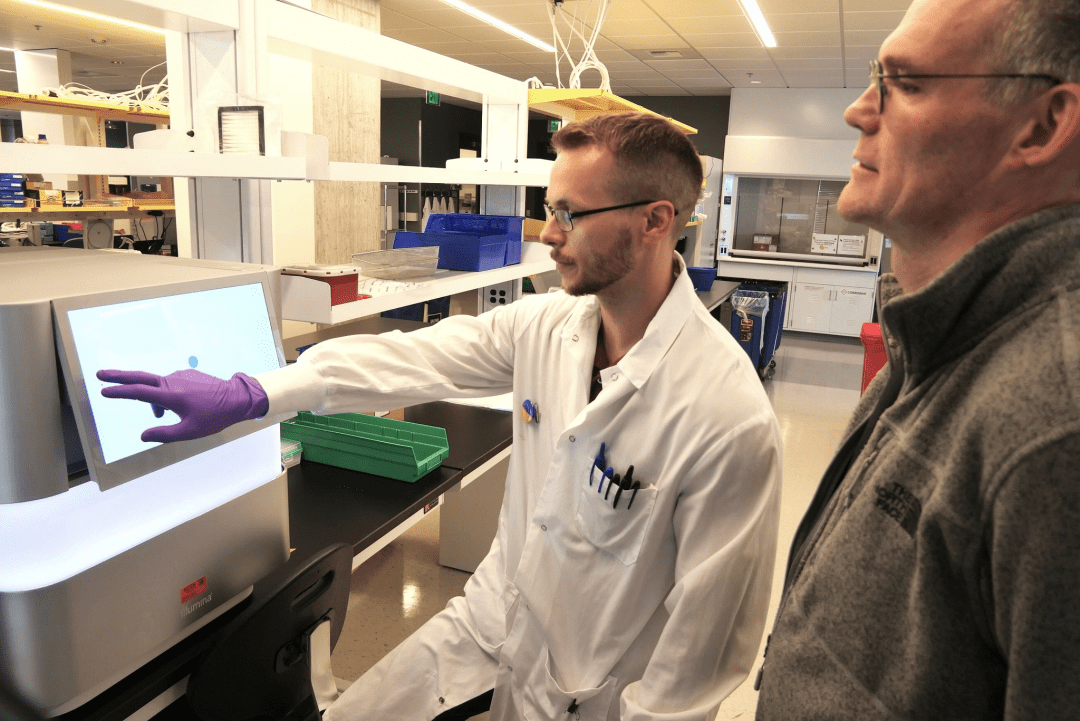
9月3日,Allen Institute、华盛顿大学和 Fred Hutchinson Cancer Center 联合启动了 AI BioDesign 项目。这个为期五年、总投入 9460 万美元的计划,由诺贝尔化学奖得主 David Baker 和基因组学专家 Jay Shendure 共同牵头。它的目标不是简单地让 AI 出设计图,而是把实验本身变成模型学习的一部分。
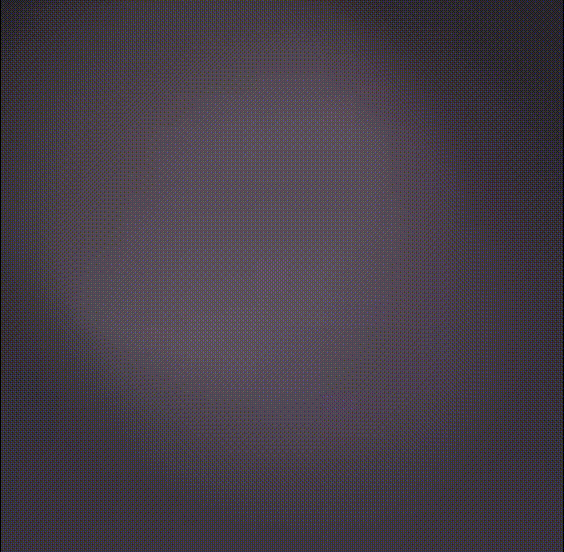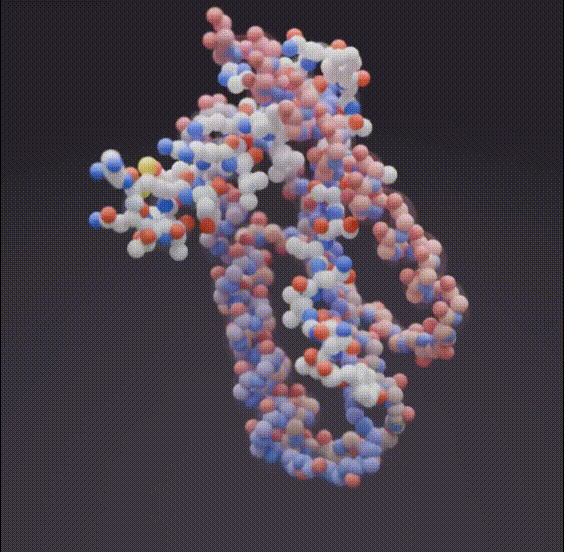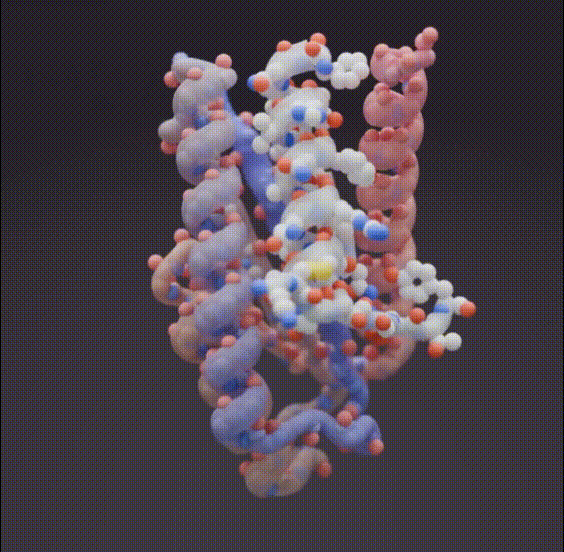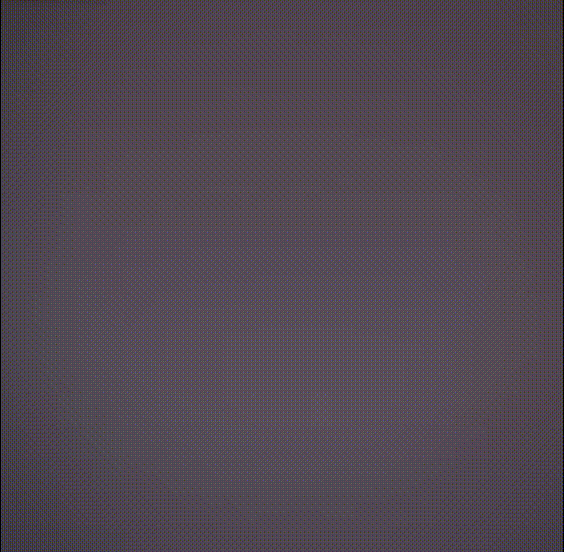
项目提出的核心工作流叫「Design、Build、Measure、Learn」:模型先生成一批候选序列;研究人员合成对应的 DNA 或蛋白;接着通过大规模实验一次性测量成千上万甚至数百万个设计的表现;最后,这些真实数据回流到计算端,用于训练下一代模型。这个循环会持续运转,实验室不再是终点,而是模型进化的重要环节。
把实验做成“数据流水线”
传统生物实验讲究精细控制,通常一次只聚焦一个或少数几个分子。这种模式在 AI 能批量生成百万级候选的时代显然不够用了。AI BioDesign 的关键突破在于转向 multiplex experiment(多重并行实验)——不是靠机器人重复做几百万次独立实验,而是利用分子生物学本身的并行特性,在同一个反应体系里同时测试海量设计。
据 GeekWire 对项目实验室的实地探访,团队已部署高通量 DNA 测序平台,能够一次性读取数百万条人工设计的序列表现。最近一次实验就测试了约 600 万条不同 DNA 序列。这种规模并非来自机械堆砌,而是巧妙利用了测序技术天然的并行能力:所有候选序列被打包进同一个文库,在细胞中同时表达,再通过测序信号强度判断各自的功能活性。
只有当实验系统的数据吞吐量与 AI 的生成能力匹配,整个闭环才能真正跑起来。否则,模型再强,也只能在小样本反馈中打转,无法触及更广阔的生物设计空间。
实验不再盲目,而是为模型“精准喂料”
AI BioDesign 的另一个重点,是让实验本身变得更聪明。项目内部设有专门的机器学习团队,他们和湿实验研究人员坐在一起,共同决定下一轮该测哪些设计。
比如,当模型已经能稳定生成某类结构时,实验可以优先挑选那些处于模型预测边界的设计——它们最有可能暴露模型的盲区。某些结果可能证实现有假设,另一些则可能揭示全新规律。无论哪种情况,都能为下一轮训练提供高价值信号。
这种策略本质上是在用信息增益指导实验资源分配。不是随机筛,也不是只挑“看起来好”的,而是主动寻找能推动模型认知边界的样本。Allen Institute 将这套体系称为“可持续学习的生物设计平台”,目标是逐步积累属于人工设计体系的大规模生物学数据集。
并非从零开始,而是已有技术的系统化延伸
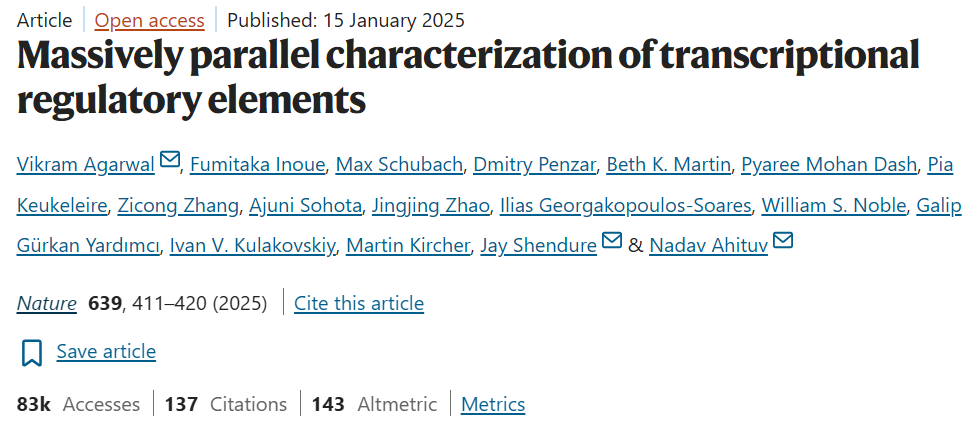
AI BioDesign 并非凭空出现。2025 年,Shendure 团队就在《Nature》发表过一项关键研究:他们利用 lentiMPRA 技术,对超过 68 万个 DNA 序列进行了功能测试,覆盖三种人类细胞类型。结果显示,约 41.7% 的序列表现出调控活性。团队随后用这些数据训练序列模型,成功预测了顺式调控元件的功能及部分遗传变异的影响。
这项工作已经展示了“大规模实验 + 模型训练”的正向循环。AI BioDesign 则在此基础上更进一步:不仅用实验数据训练模型,还让模型直接参与实验设计决策,形成双向闭环。未来,这套系统将被用于多个具体方向,包括靶向癌细胞的蛋白质、具有细胞类型特异性的 DNA 开关、调控蛋白质降解或稳定的分子,以及能分解塑料的酶。
更长远的目标甚至包括用生物分子构建具备计算功能的系统——这已经超出了传统药物研发的范畴,进入合成生物学的新领域。
重新定义科研的基本单元
目前,AI BioDesign 还没有宣布任何临床产品或新药。它现阶段的产出是一套正在运行的实验基础设施、一支融合计算与实验的研究团队,以及一个围绕持续学习构建的方法论框架。
但它的意义或许不在于某个具体分子,而在于改变了科研的基本节奏。当研究人员能同时处理百万级设计,并实时获得反馈时,“提出假设—做实验—分析数据—形成新假设”这一经典流程就被彻底重构了。科研单位不再是单个蛋白或基因,而是一个动态演化的数据-模型共生体。
这种模式如果跑通,可能会重塑整个生物研发的范式:AI 不再是辅助工具,而是驱动整个发现引擎的核心;实验也不再是验证终点,而是持续学习的燃料。AI BioDesign 的真正野心,或许是让生物学进入“数据驱动迭代”的新阶段。