清华与稳准智能发布LimiX-2,400M参数结构化数据模型登顶国际评测
LimiX-2 登顶三大国际结构化数据评测
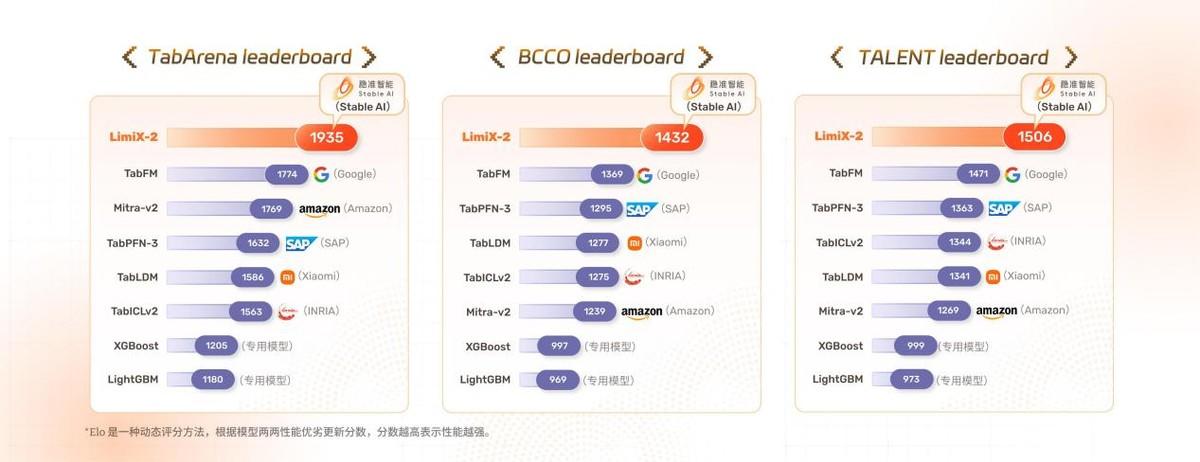
9月16日,稳准智能与清华大学计算机系崔鹏教授团队联合发布了新一代结构化数据基础模型 LimiX-2。这款模型的参数规模提升至4亿(400M),并在 TabArena、BCCO 和 TALENT 三个主流国际评测基准上均取得第一。具体来看,其总体 Elo 分数分别达到 1935、1432 和 1506,超过了 Google、SAP、Amazon 等国际科技巨头的同类模型。
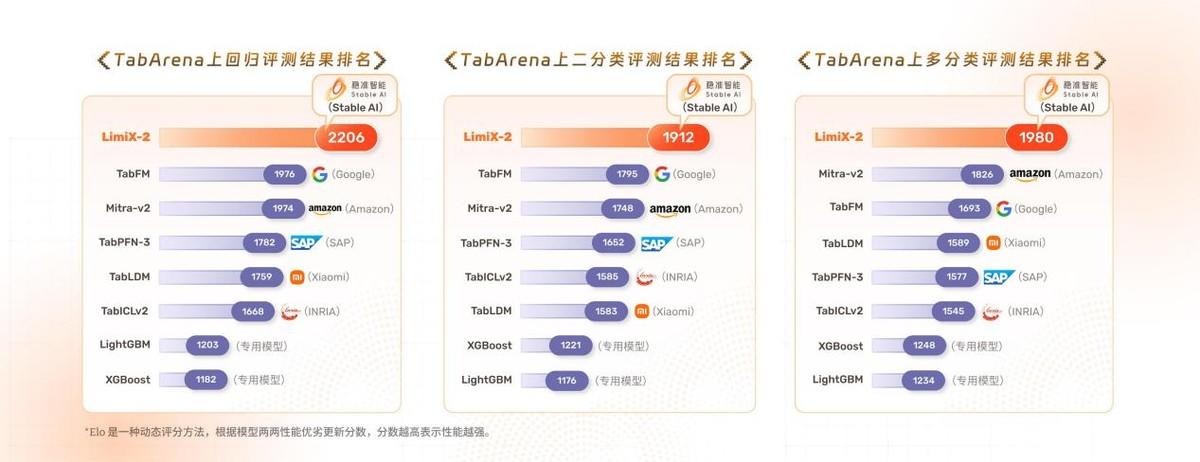
Elo 分数是衡量模型综合能力的排名指标,广泛用于结构化数据模型的横向比较。这三个评测覆盖了回归、二分类、多分类、缺失值填补等多种任务,重点考察模型在不同数据集上的泛化能力和预测稳定性。LimiX-2 在所有任务类型中均表现最优,尤其在 TabArena 上的三项子任务得分全部领先。
从“预测目标”转向“发现结构”
LimiX-2 的核心突破在于提出了一种名为“上下文机制网络”(Contextual Mechanism Networks, CMNs)的新建模范式。传统结构化数据模型,比如早期的 PFNs(Prior-data Fitted Networks),通常围绕一个预先指定的目标变量进行建模,学习如何根据其他特征预测该目标。这种方式本质上仍是“任务导向”的。
而 CMNs 的思路完全不同:它不再预设哪个变量是目标,而是把整个表格中所有变量之间的联合依赖关系作为建模对象。换句话说,模型关注的不是“Y 是多少”,而是“X₁、X₂、…、Xₙ 这些变量是如何相互关联、共同构成某种内在结构的”。
为了实现这一点,LimiX 团队设计了“上下文条件掩码建模”(CCMM)机制。在预训练阶段,模型会随机掩码部分变量的观测值,然后基于其余可见变量去预测被掩码的部分。通过在不同掩码模式下反复训练,模型被迫学习变量之间的条件依赖关系,而不是仅仅记住某个固定目标的映射。
这种训练目标的转变,直接影响了模型的架构设计。LimiX 采用“单元格级”(Cell-Level)表示:每个单元格(即某样本中某变量的取值)都被视为独立的基本单元,同时保留其列身份(column identity)、具体数值和缺失状态。这样的设计允许信息在变量之间、样本之间自由流动,为跨变量交互提供了基础。
统一任务接口,迈向通用数据智能
在 CMNs 框架下,传统的分类、回归、缺失值填补等任务,不再是彼此割裂的独立问题,而是对同一个底层数据模型的不同“查询方式”。例如,要预测某个变量 Y,只需将 Y 掩码,其余变量作为上下文输入,模型就会输出 Y 的条件分布。
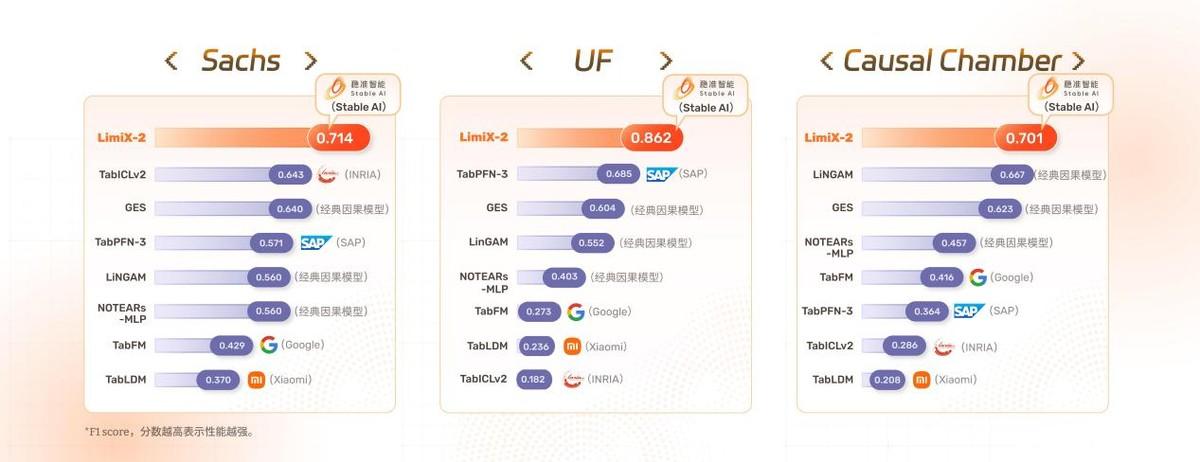
更重要的是,这种对联合依赖结构的建模,为因果推断打开了新的可能性。传统因果发现方法(如 PC 算法、GES)通常依赖强假设(如无隐变量、线性关系)或专家知识,在高维、噪声大的企业数据中效果有限。而 LimiX-2 通过学习变量间的统计依赖模式,可以在 Sachs、UF、Causal Chamber 等标准因果数据集上显著超越这些传统方法,初步展现出从相关性走向因果性的潜力。
合成数据引擎支撑预训练
结构化数据的一大难题是获取困难。与互联网文本不同,企业内部的表格数据往往涉及商业机密,难以公开共享。因此,当前主流的结构化基础模型(如 TabPFN、Mitra)普遍依赖合成数据进行预训练。
LimiX-2 升级了其自动化合成数据生成引擎。新引擎能模拟多种真实世界的数据生成机制,包括线性关系、非线性交互、周期性变化、高维稀疏性以及各种类型的噪声扰动。通过在这些多样化的合成数据上预训练,模型在接触真实企业数据前,已经“见过”大量复杂的变量关系模式,从而具备更强的迁移和泛化能力。
Scaling Law 再次得到验证
继 2025 年 11 月稳准智能首次提出“结构化数据基础模型遵循 Scaling Law”后,LimiX-2 将参数规模从上一代进一步扩大到 400M。这一举措并非盲目堆参数,而是为了在更大尺度上验证 CMNs 技术路线的有效性。
更大的模型容量有助于更精细地表达高维变量间的复杂依赖,尤其是在因果关系这类需要稳定统计估计的任务中。实验表明,随着参数增长,LimiX 在泛化性能和因果骨架发现的准确性上均有明显提升,说明其技术路径具备良好的可扩展性。
已落地800多个真实场景
截至 2026 年世界人工智能大会,上一代 LimiX 模型已完成超过 800 个结构化数据场景的通用性验证,并与 60 多家客户建立战略合作。这些场景覆盖了制造业、能源、材料科学等多个领域。
典型应用包括:
- 工艺参数优化:在半导体或化工生产中,自动调整上百个工艺参数以提升良率;
- 设备故障预测:基于传感器时序表格数据,提前预警关键设备异常;
- 电力与能耗预测:结合天气、负荷、历史用电等多源表格,精准预测短期用电需求;
- 材料性能建模:从成分、处理工艺到最终性能,构建端到端的预测与优化模型。
这些实践验证了 LimiX 的核心价值:用一个通用基础模型替代过去“一任务一模型”的碎片化开发模式,大幅降低 AI 落地门槛。
结构化数据赛道进入加速期
当前,结构化数据基础模型正处在类似 LLM 赛道 2020 年 GPT-3 发布前的关键节点。Google、Amazon、SAP 等国际大厂已纷纷入局,加速研发节奏。与此同时,以 LimiX 为代表的中国团队则探索出一条“产业场景驱动模型迭代”的差异化路径——先在真实业务中打磨技术,再反哺模型通用能力。
稳准智能首席科学家崔鹏表示:“LimiX-2 的发布是我们在结构化数据大模型方向上的重要阶段性成果。未来我们将继续深化对数据规律和因果关系的理解,推动 AI 从预测走向决策。”
目前,LimiX-2 的技术报告已公开于 arXiv(编号 2609.17488),代码和模型也已在 GitHub、Hugging Face 和 ModelScope 开源,供研究社区使用和复现。