Windows运维实测AMD AI云:从领算力到跑通PyTorch全流程
为什么Windows运维也想试试云端AI算力
传统Windows运维工作集中在系统部署、补丁管理、权限配置、日志排查和终端支持。但最近几年,AI工具开始渗透进日常任务:比如用大模型分析事件日志、自动生成PowerShell脚本、整理工单知识库、做自动化巡检报告,甚至辅助写技术文档。
这些场景通常不需要训练大模型,但经常要跑Python脚本、测试模型推理或验证Agent工作流。问题来了——办公电脑往往没有高性能独显,就算有,也很难在Windows上稳定装好ROCm、PyTorch和相关依赖。驱动冲突、版本不匹配、CUDA/ROCm混淆,随便一个都能卡住半天。
与其在生产办公机上反复折腾环境,不如直接用云端预配好的GPU实验平台。这次我试了AMD AI开发者云,目标很明确:不碰本地环境,从零开始领算力、进平台、跑通PyTorch GPU代码。
加入AMD AI开发者计划
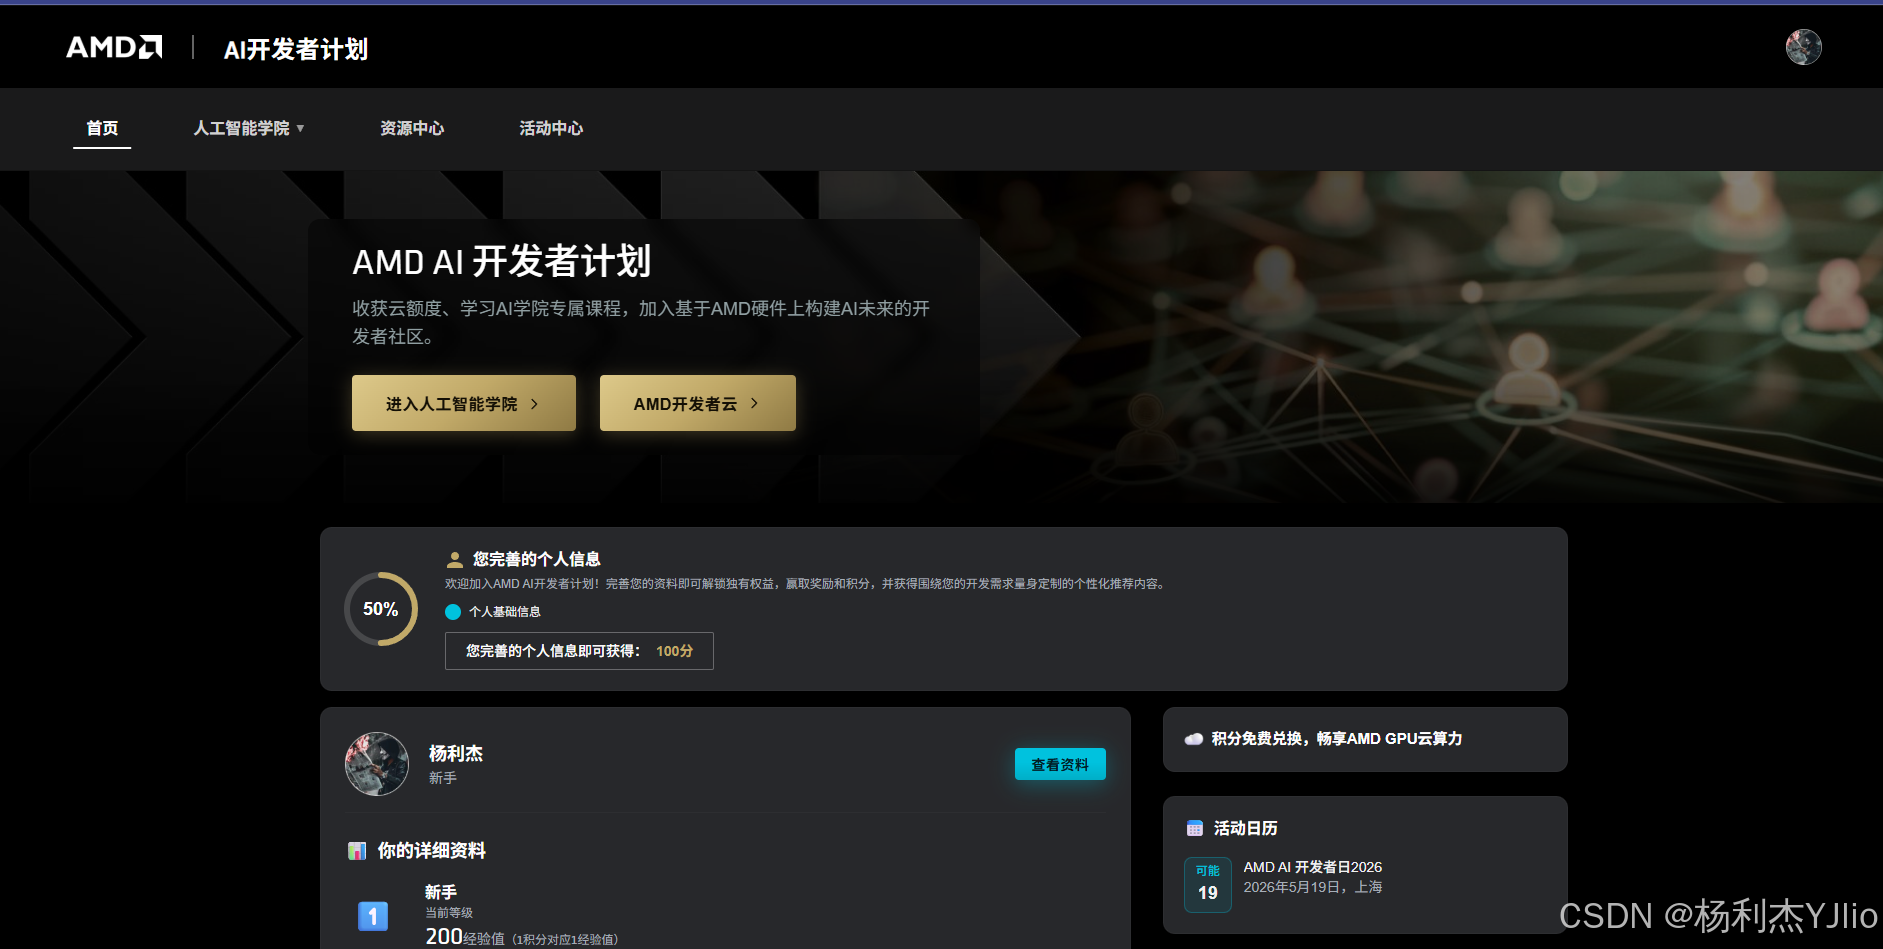
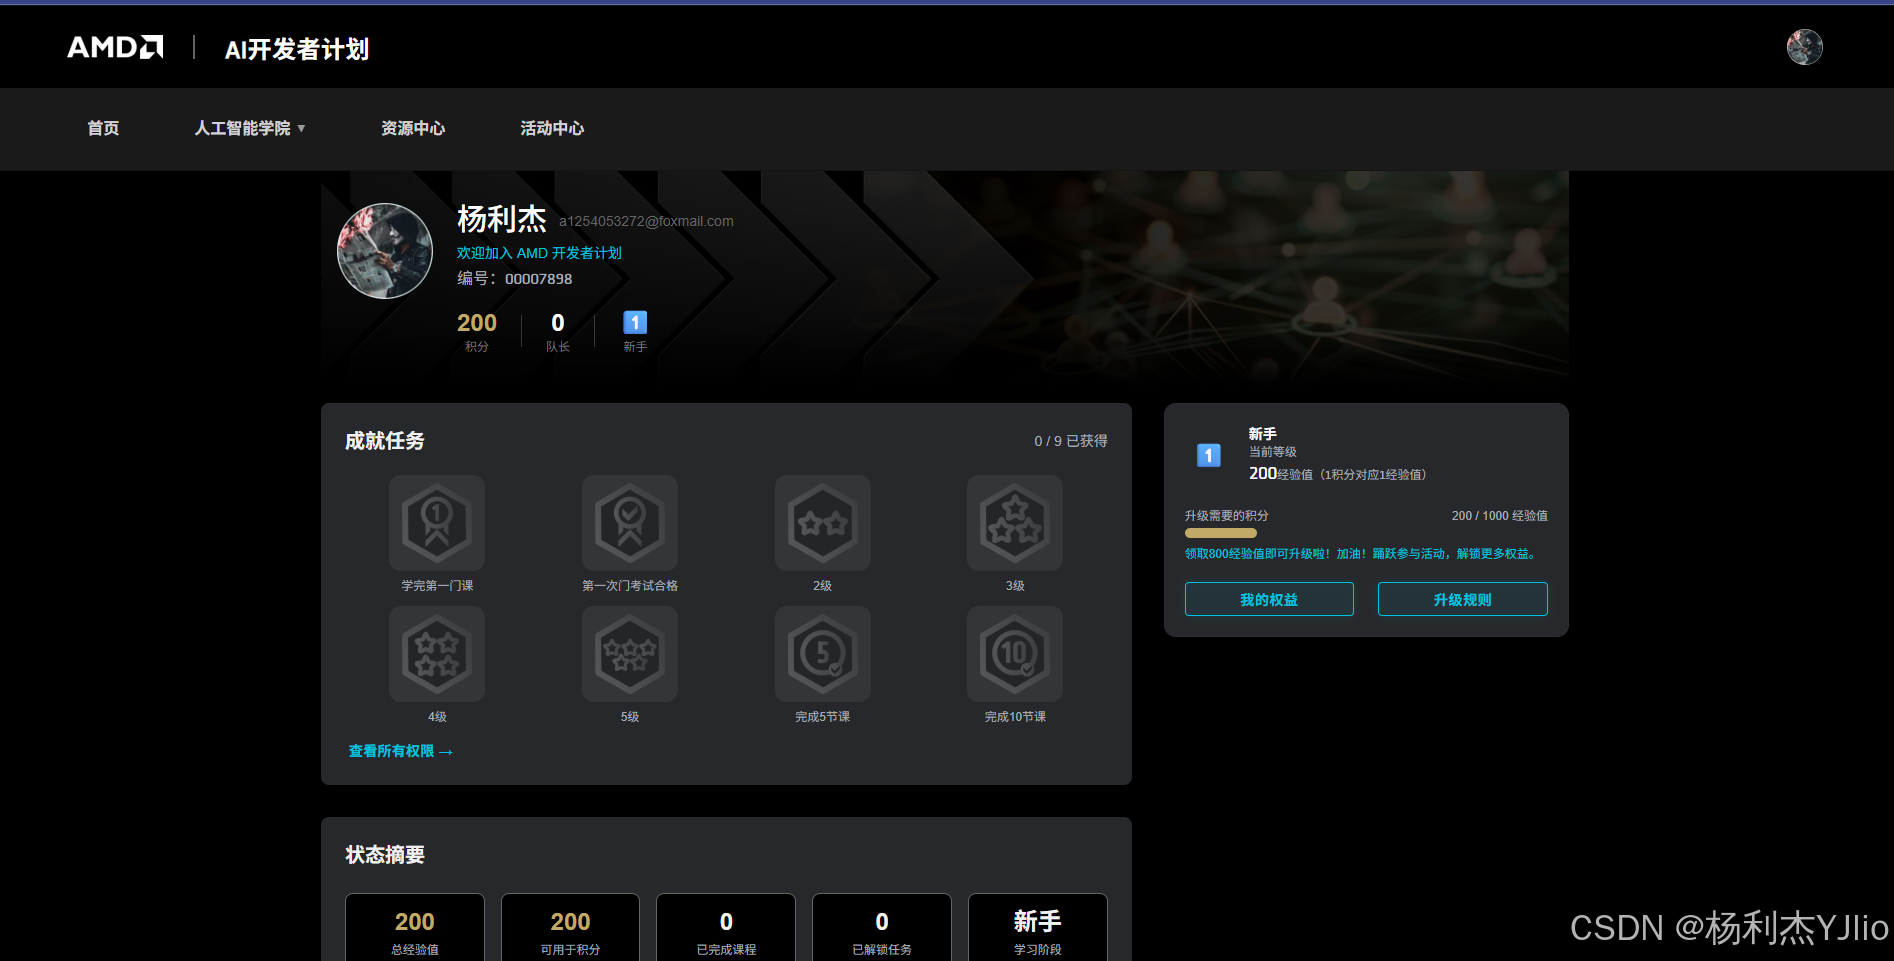
第一步是注册并登录AMD AI开发者计划(https://www.amd.com/ai)。页面会显示账号等级、经验值和当前积分。我这个新号初始有230积分,后续发现1积分能换1小时GPU算力。
这一步相当于完成云平台身份初始化。只要能看到积分和等级,说明账号状态正常,后面才能继续兑换算力和授权登录Radeon Cloud。
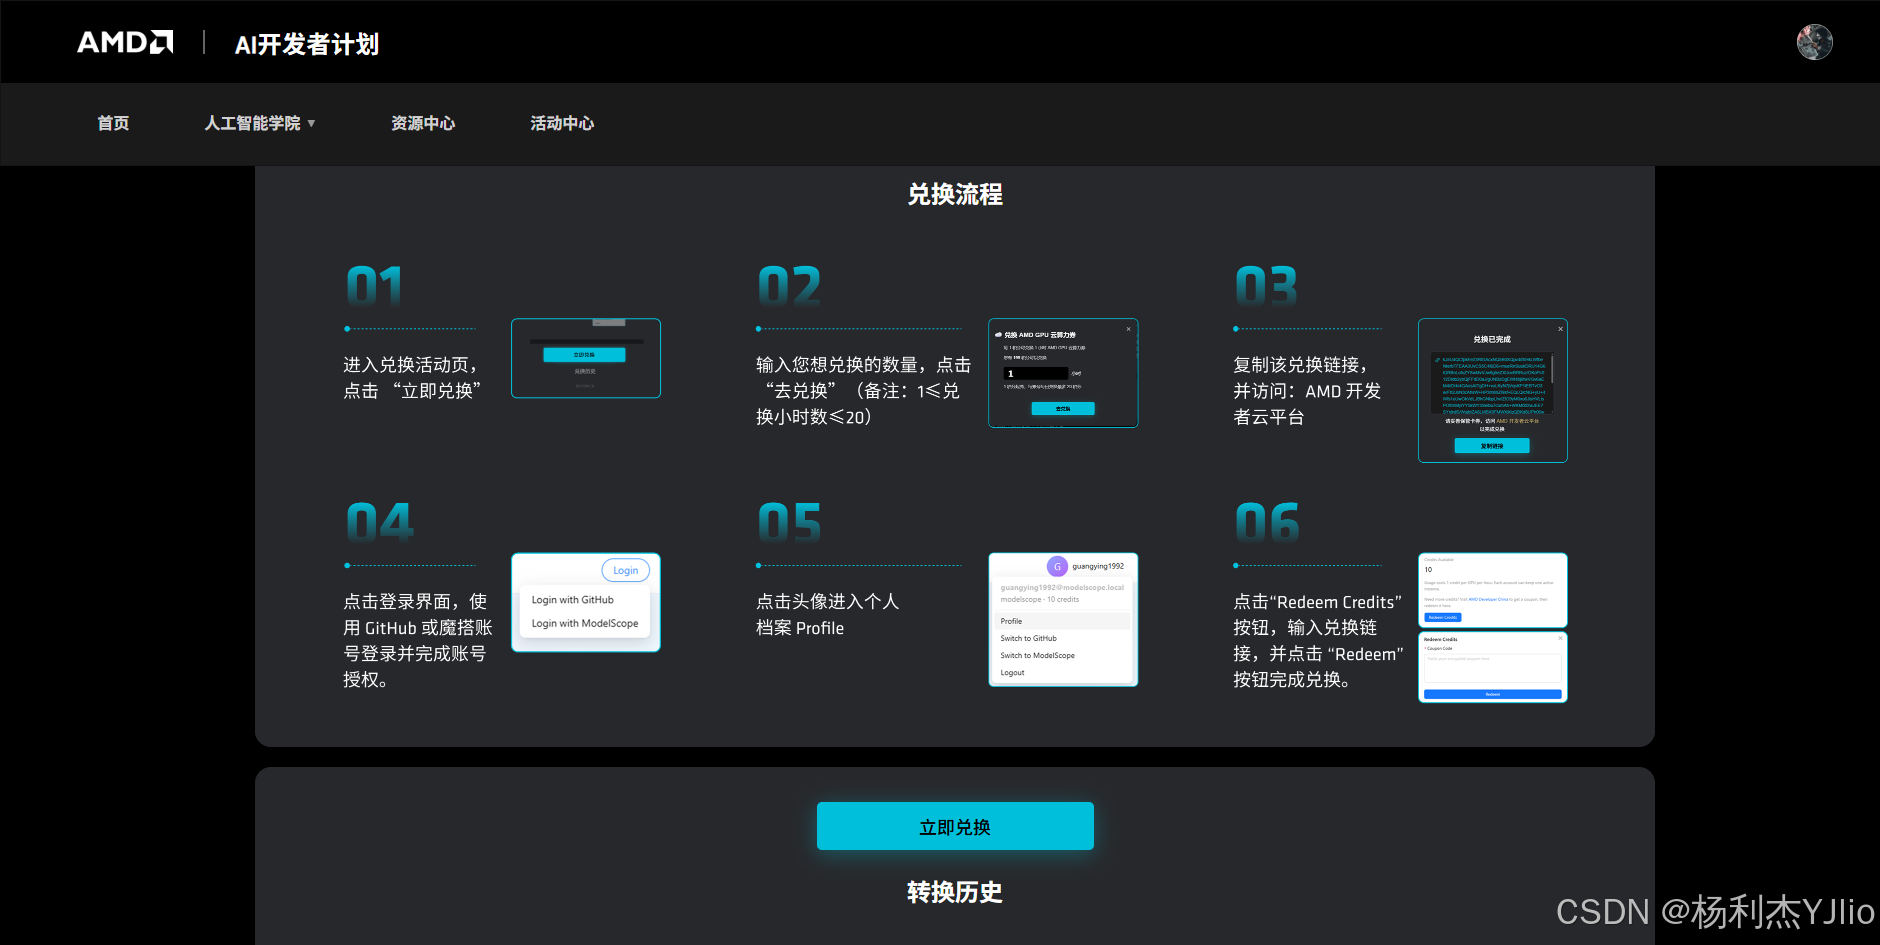
兑换GPU算力券
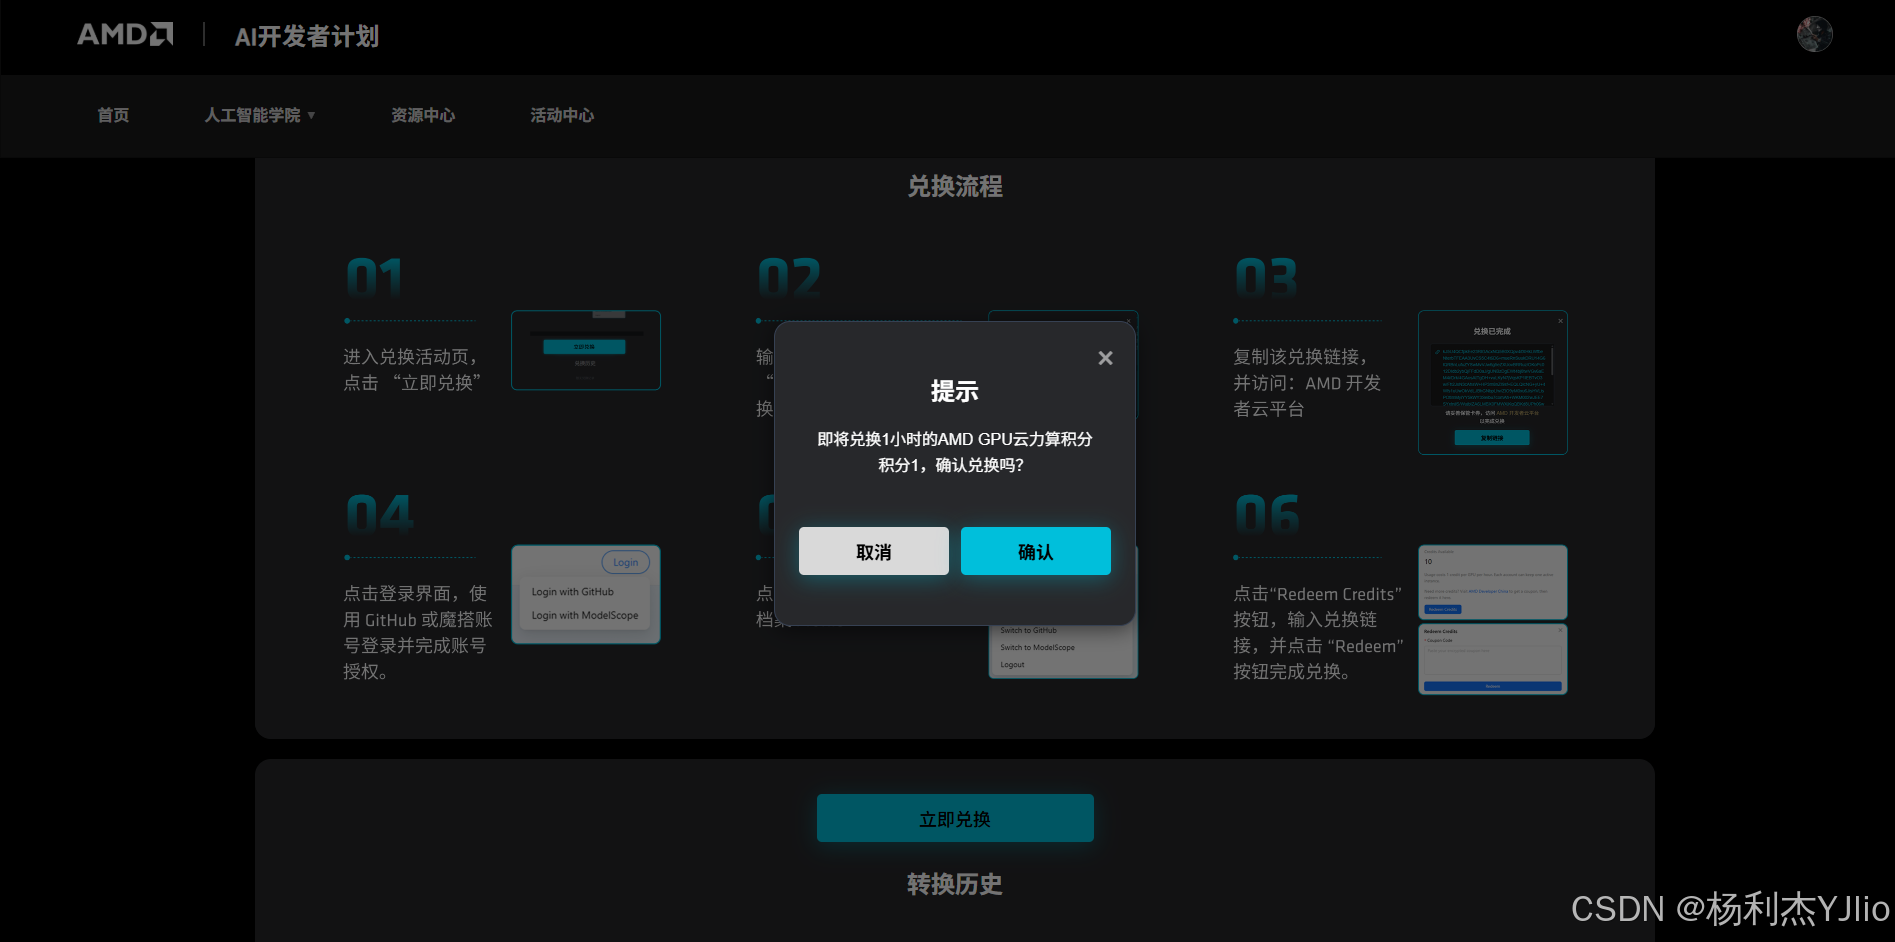
在开发者计划页面找到“GPU云算力兑换”入口,进入活动页。流程分六步:选时长、生成兑换链接、登录Radeon Cloud、进个人档案、粘贴链接、确认兑换。
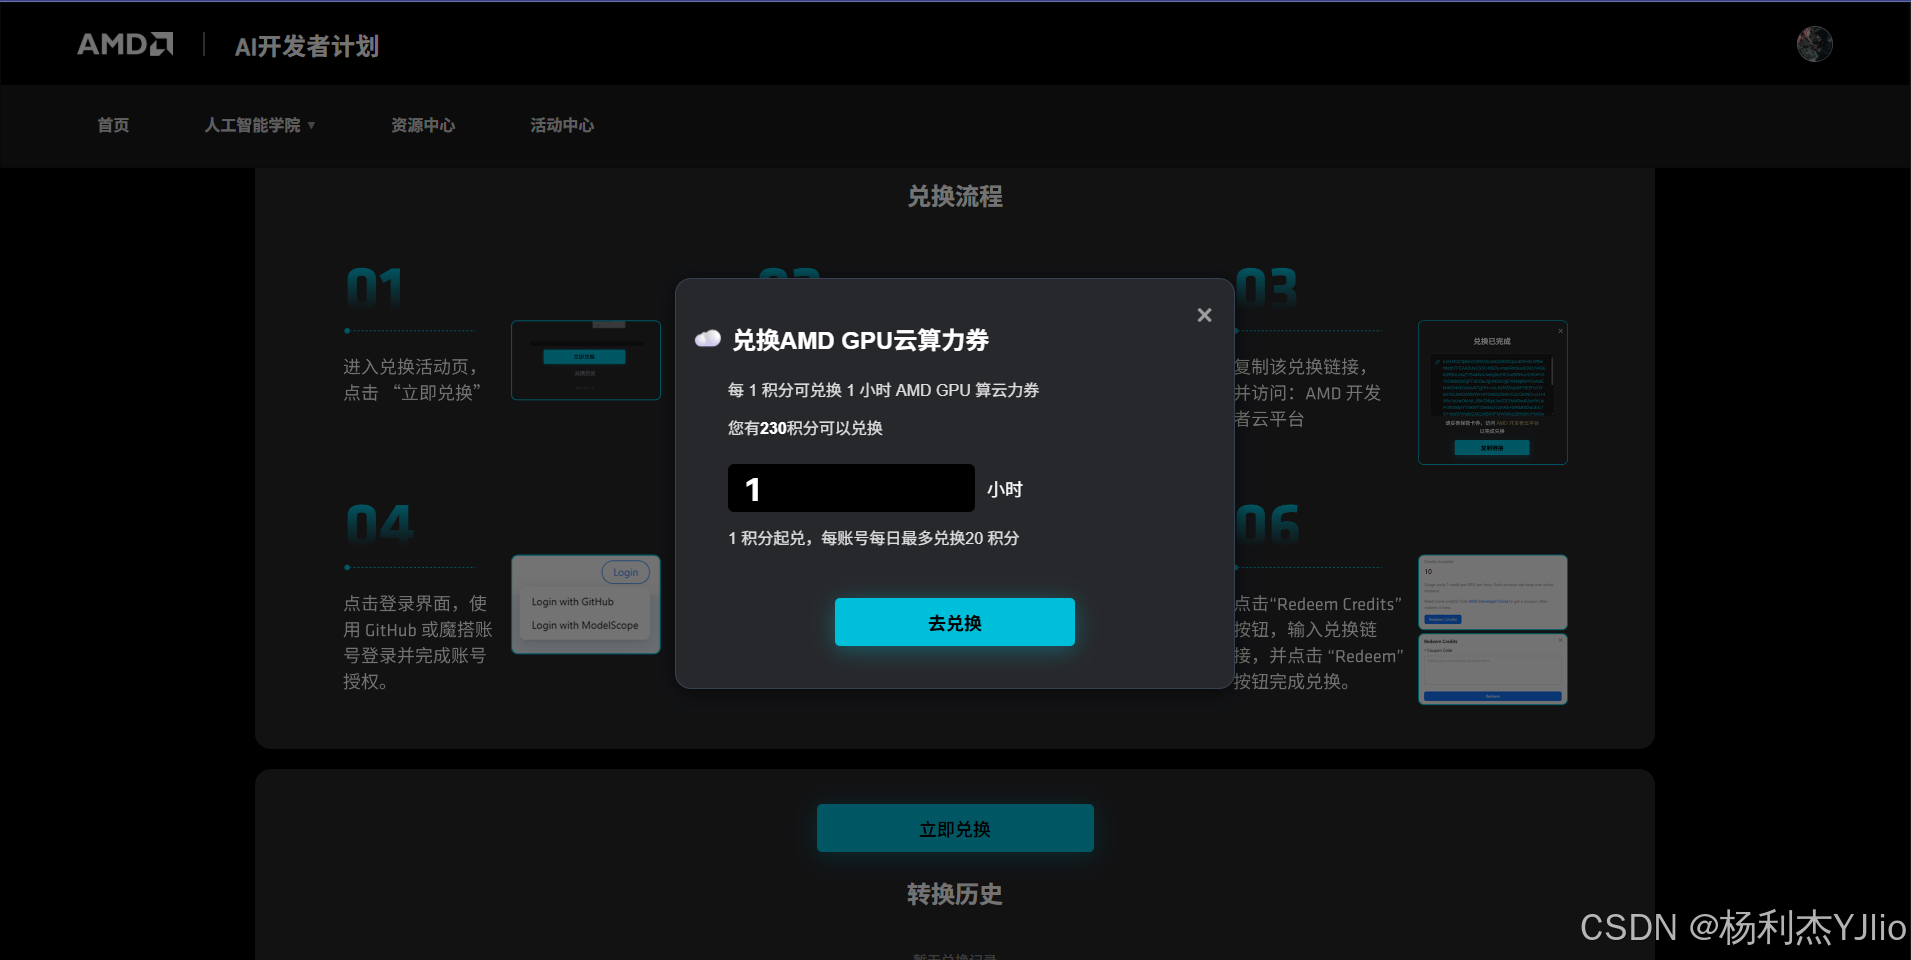
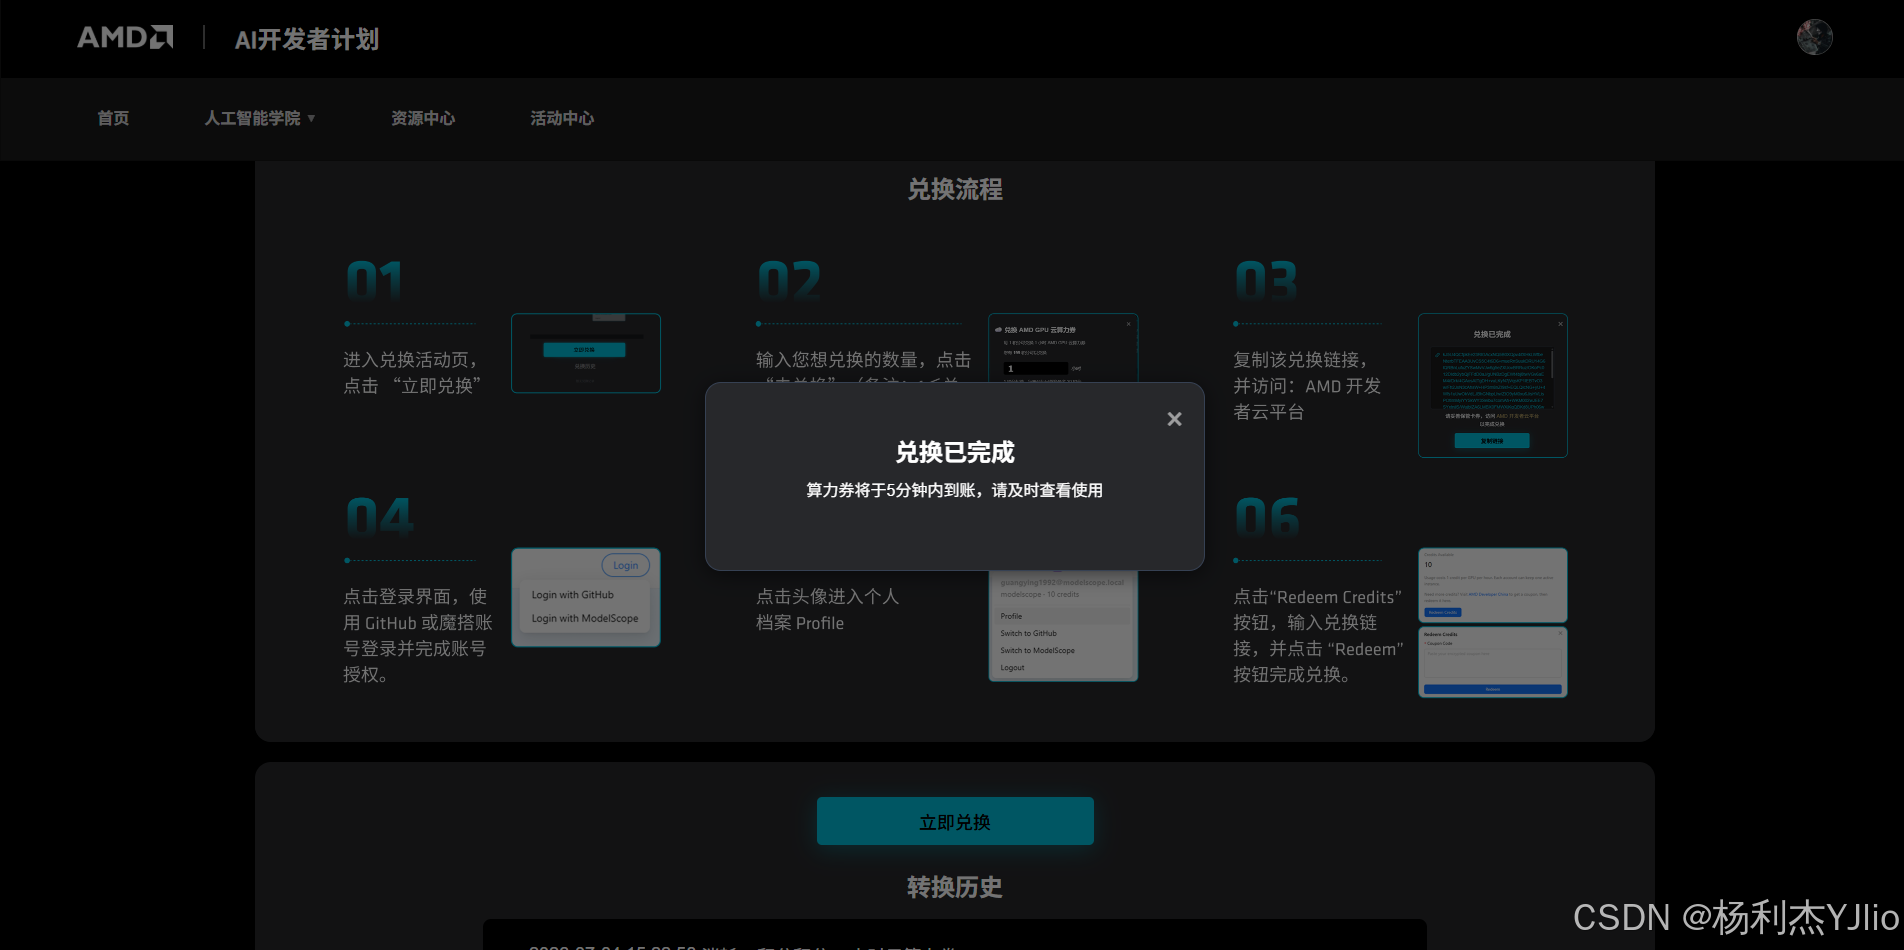
我先兑了1小时——新手建议从小额度开始,先把整个链路跑通再说。确认后页面提示“兑换成功”,算力券5分钟内到账。这里没看到复杂规则,就是简单的积分换时间,对临时实验很友好。
进入Radeon Cloud云画廊
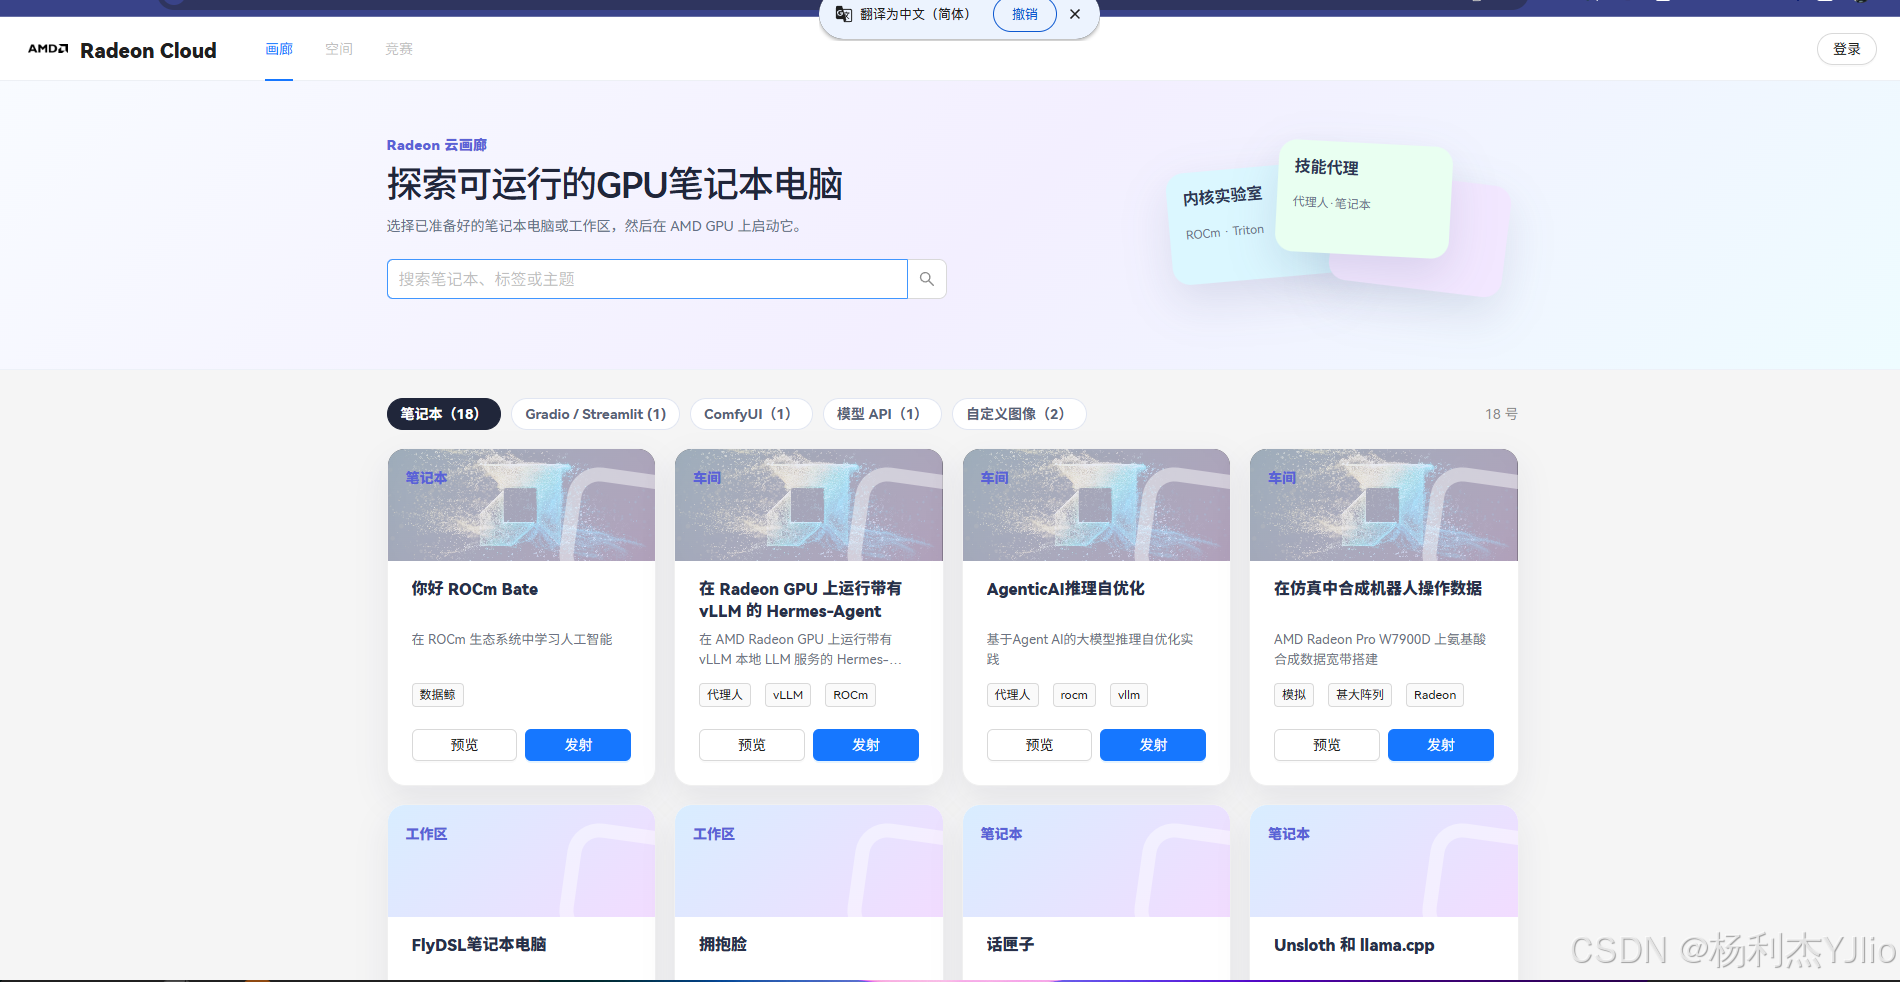
算力到账后,访问Radeon Cloud(https://cloud.radeon.com)。首页是“云画廊”,列出了多个预置模板:
- ROCm基础学习环境
- PyTorch + Jupyter Notebook
- vLLM大模型推理示例
- AgenticAI工作流模板
- 仿真数据处理项目
这些模板已经配好了GPU驱动、ROCm运行时、PyTorch和Jupyter,不用自己装。作为运维,我优先选了PyTorch Notebook模板——目标是验证GPU能否被识别并执行计算。
完成GitHub授权登录
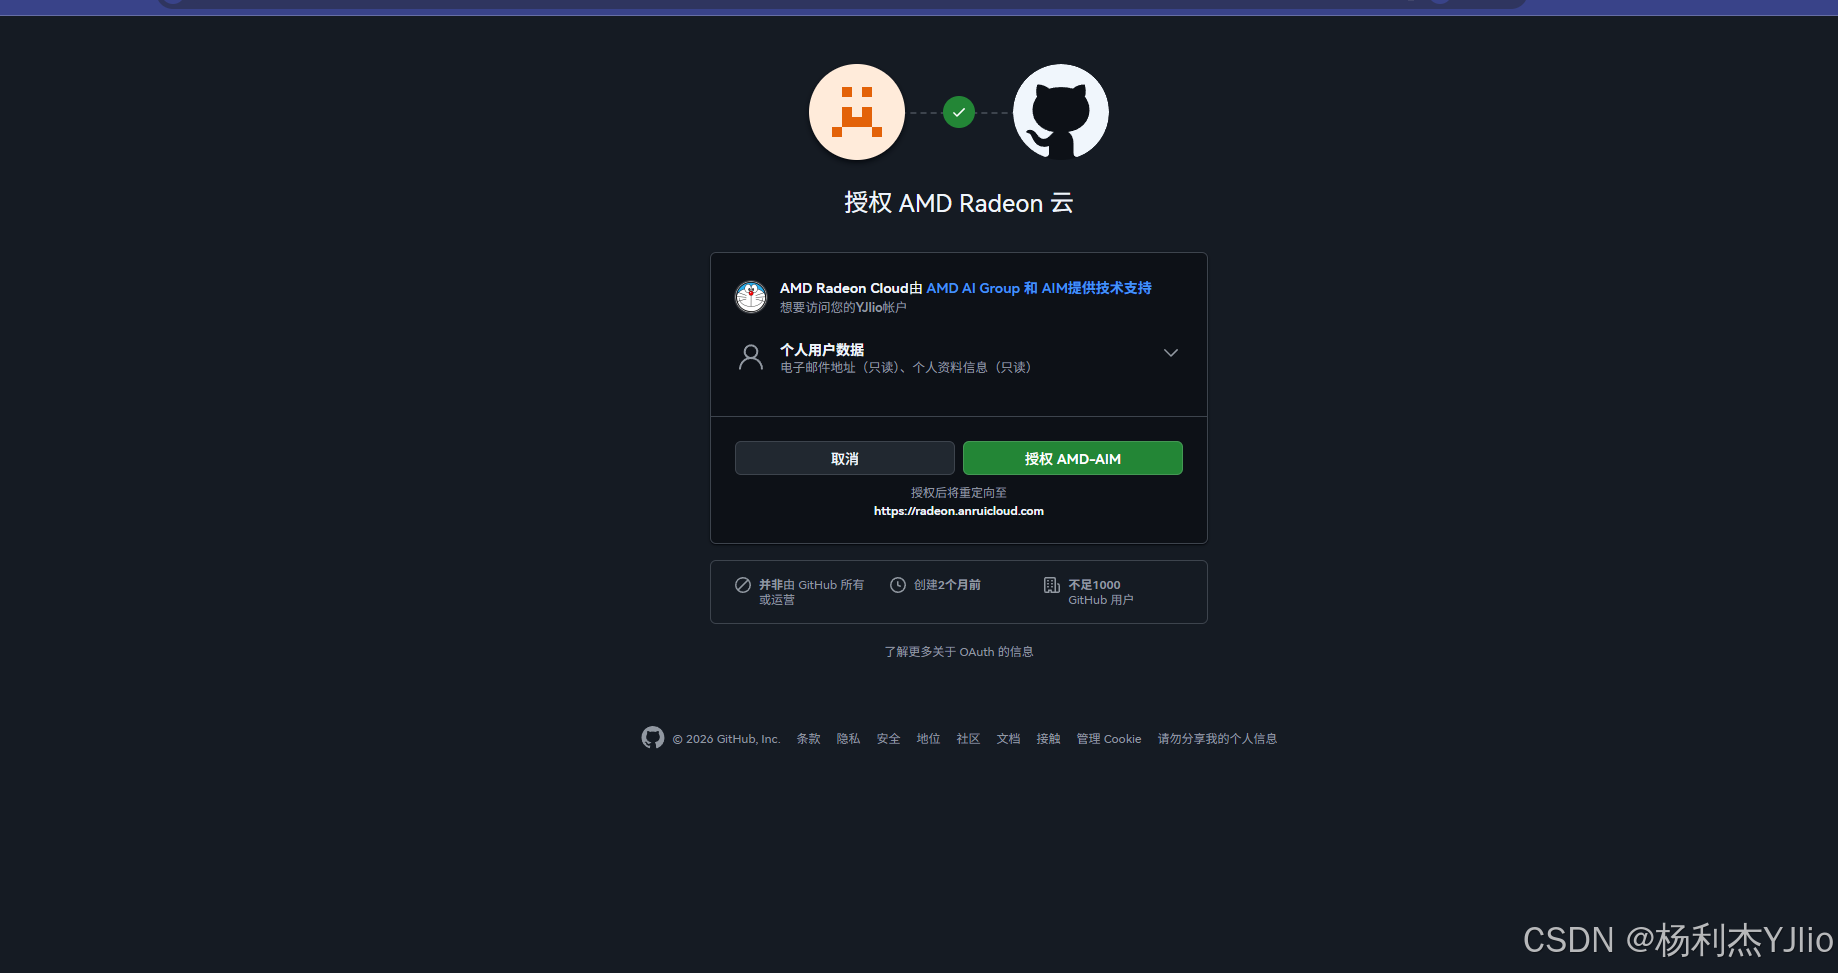
点击模板后,平台跳转到GitHub OAuth页面,要求授权Radeon Cloud读取基础账号信息(如邮箱)。这里要注意安全:
- 确认授权对象确实是AMD官方应用
- 权限仅限于公开资料,不涉及仓库或Token
- 后续截图务必遮挡邮箱和个人信息
授权完成后自动回到Radeon Cloud,开始创建工作区。
启动云端工作区
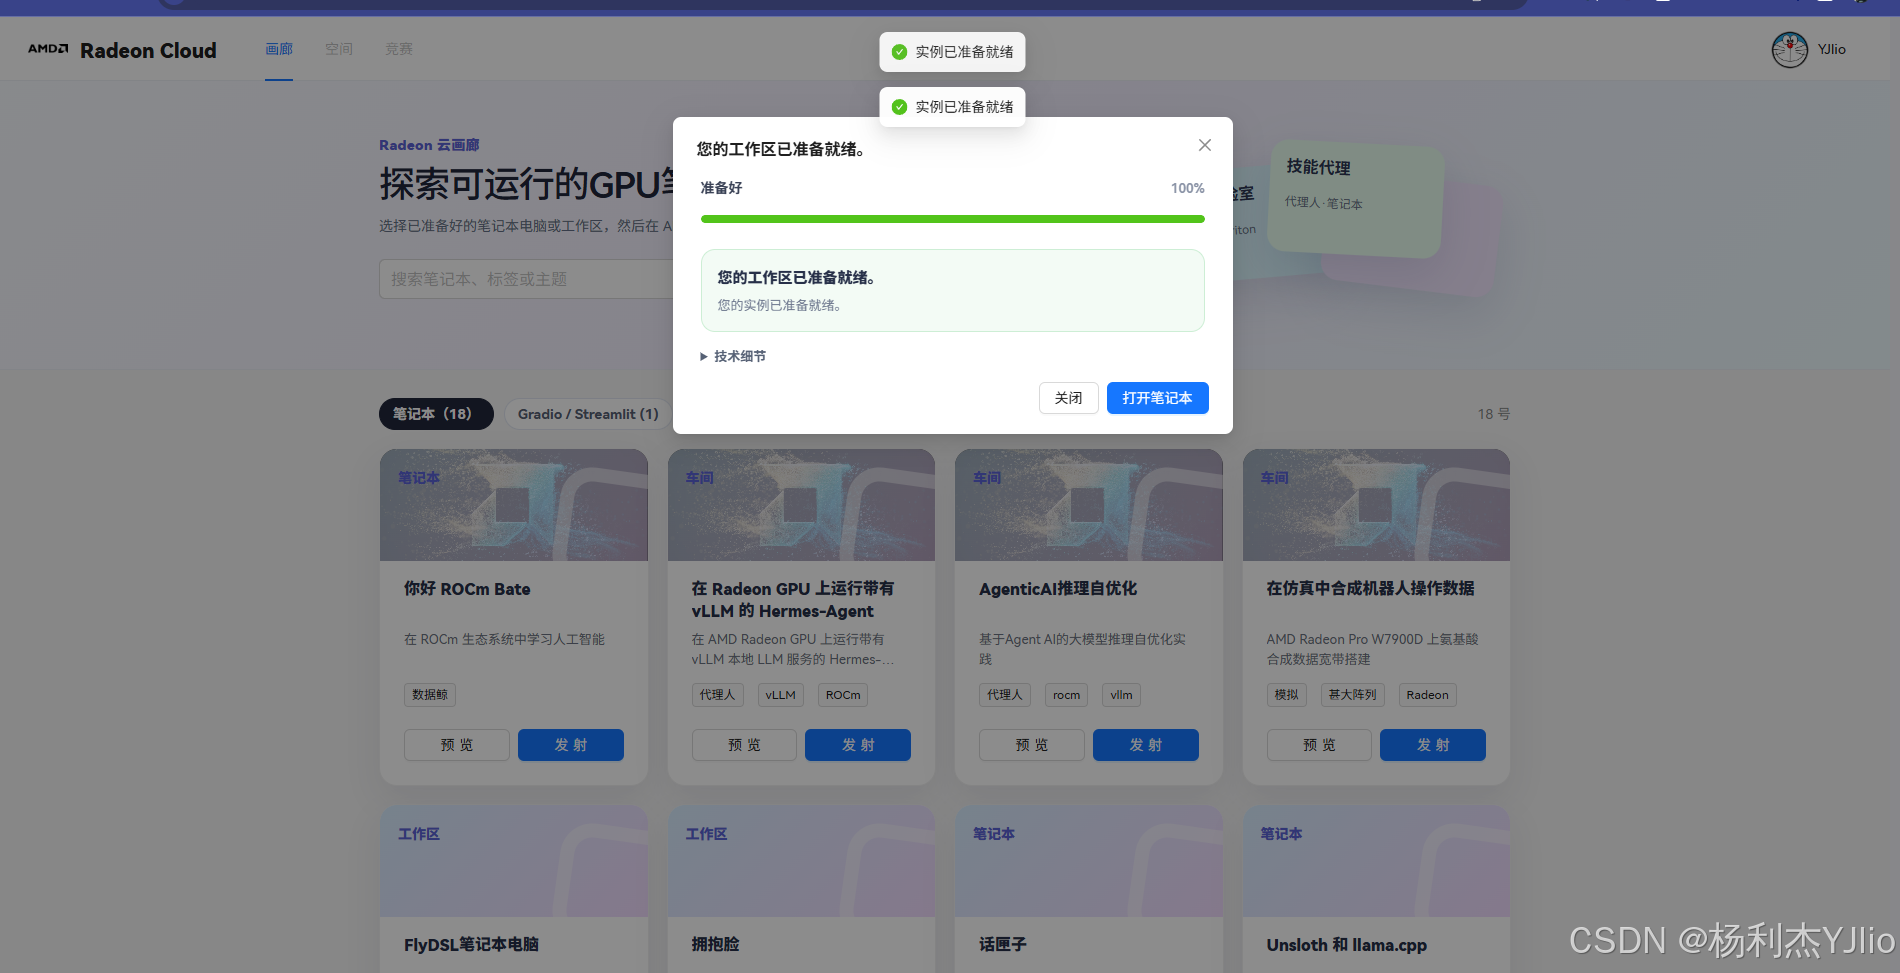
平台分配资源需要1-2分钟。进度条走到100%后,出现“打开笔记本”按钮。这意味着:
- 云端虚拟机已启动
- AMD GPU(RX 7900 XTX)已挂载
- ROCm运行时和PyTorch已预装
- Jupyter服务已就绪
整个过程完全不用管驱动版本、Python环境或依赖冲突。对只想跑代码的人来说,省了至少两小时环境调试时间。
运行PyTorch验证GPU
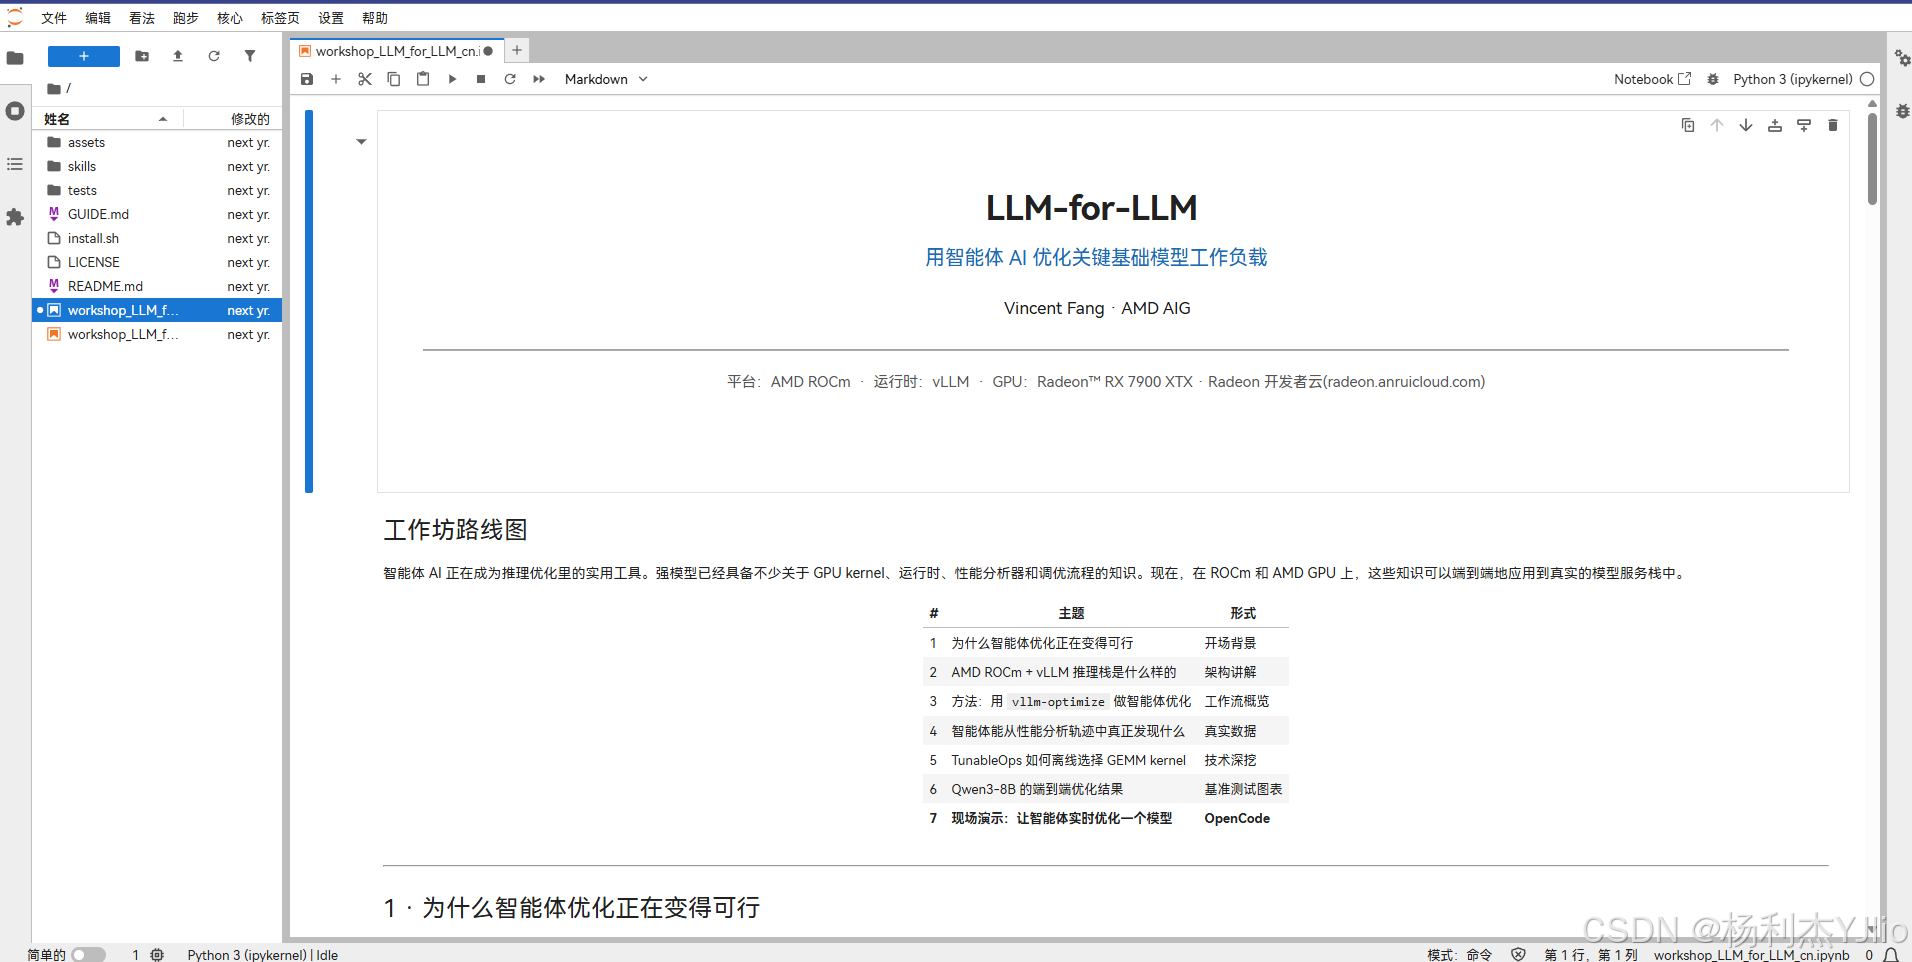
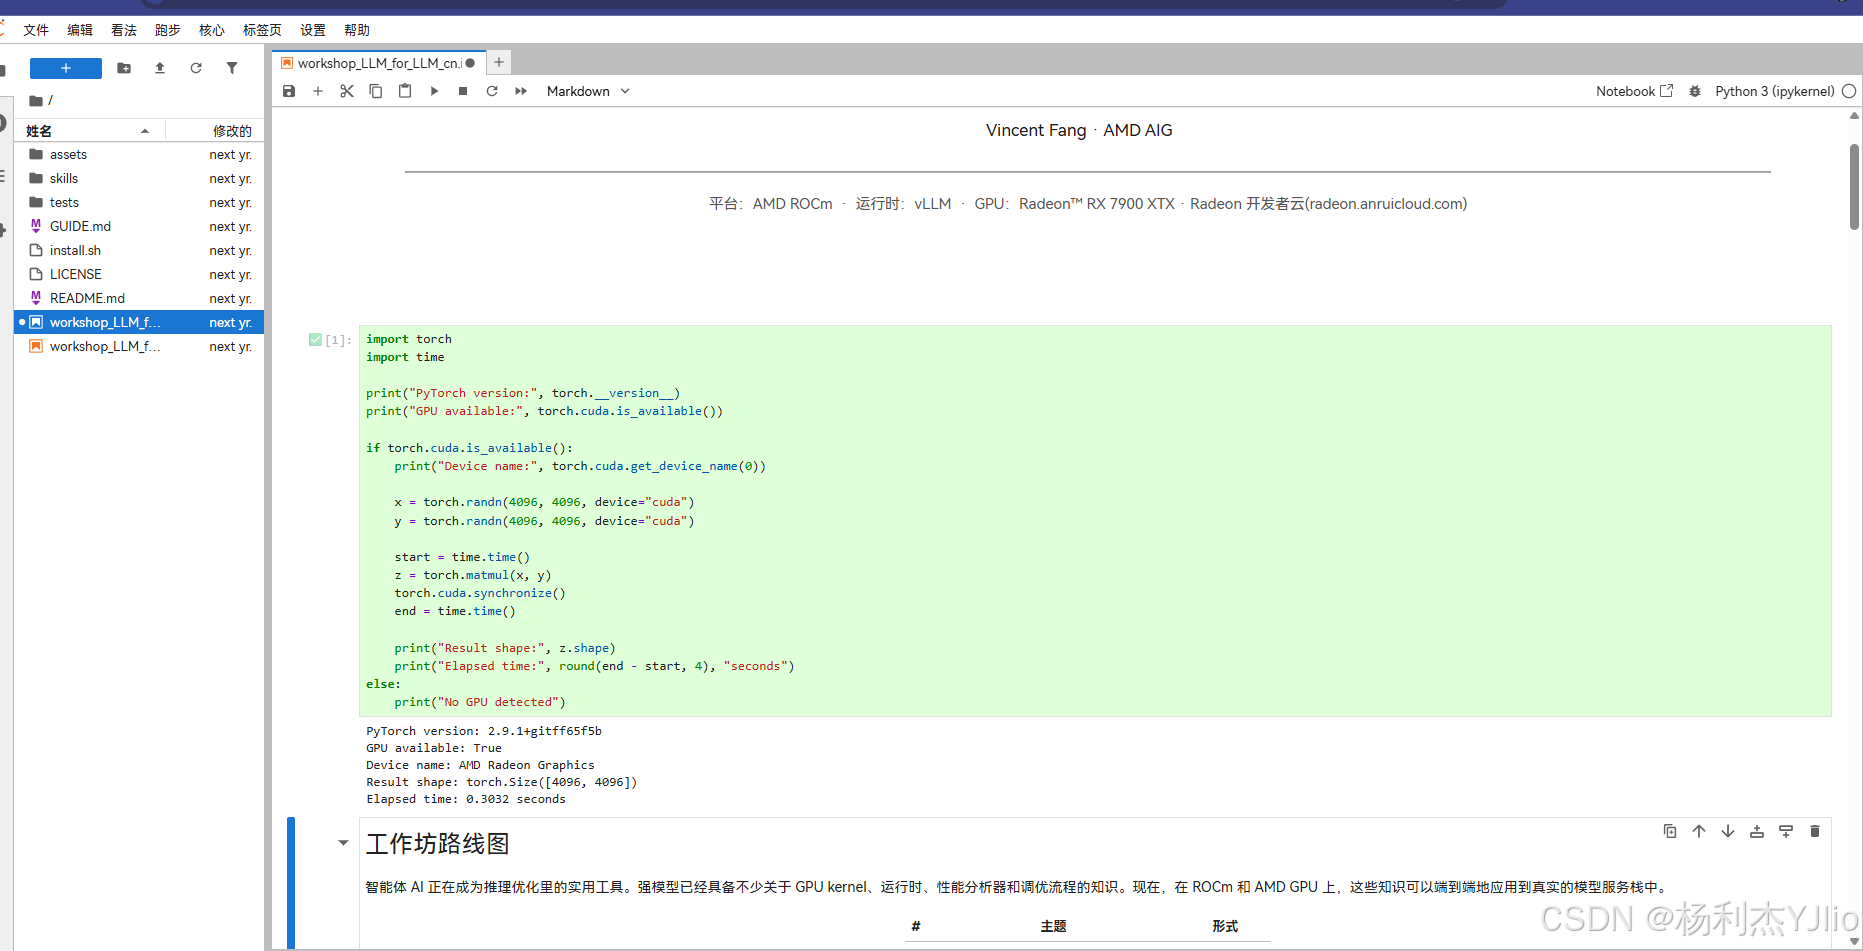
点开Notebook,里面已有示例文件。我新建一个单元格,运行最小GPU检测脚本:
import torch
import time
print("PyTorch version:", torch.__version__)
print("GPU available:", torch.cuda.is_available())
if torch.cuda.is_available():
print("Device name:", torch.cuda.get_device_name(0))
x = torch.randn(4096, 4096, device="cuda")
y = torch.randn(4096, 4096, device="cuda")
start = time.time()
z = torch.matmul(x, y)
torch.cuda.synchronize()
end = time.time()
print("Result shape:", z.shape)
print("Elapsed time:", round(end - start, 4), "seconds")
else:
print("No GPU detected")结果如下:
- PyTorch版本:2.9.1
- GPU可用:True
- 设备名称:AMD Radeon Graphics
- 矩阵乘法(4096×4096)耗时:约0.3秒
关键点:虽然代码用了torch.cuda接口,但在ROCm环境下它会自动映射到AMD GPU。这说明PyTorch对AMD硬件的支持已经比较成熟,至少基础计算没问题。
Windows运维视角的收获
这次体验对我这样的运维人员有几个实际价值:
- 绕过本地环境坑:不用在Windows上硬装ROCm,避免污染办公系统
- 快速验证想法:想测试某个AI脚本?5分钟进环境,跑完就关
- 学习成本低:通过预置模板接触ROCm/vLLM,比看文档直观
- 适合写教程:流程清晰,截图和结果都可直接用于技术分享
- 临时算力灵活:短期实验不用买硬件,积分够用就行
更重要的是,它把“环境准备”变成了标准化流程。以后遇到新AI工具,可以先在云端跑通最小案例,再决定是否迁移到内网服务器或本地——大幅降低前期试错成本。
后续还能探索什么
这次只完成了基础验证,后续可深入的方向包括:
- 跑vLLM示例:测试大模型推理速度和显存占用
- 结合运维场景:导入Windows事件日志,让模型做异常分类
- 性能对比:同一任务在CPU/GPU下的耗时差异
- 封装模板:把常用脚本做成Notebook模板,下次直接复用
- 研究ROCm细节:比如HIP转换、内核优化等底层机制
比如,可以把蓝屏dump文件或Office崩溃日志喂给模型,看它能否生成排障建议。这类任务不需要顶级算力,但依赖稳定的GPU环境——正好是云端平台的优势。
总结
AMD AI开发者云的核心价值不是“免费送算力”,而是提供了一个开箱即用的AI实验沙盒。对Windows运维来说,这意味着:
- 不用再纠结本地有没有GPU
- 不用花时间修环境依赖
- 能快速把注意力放回业务逻辑本身
从领积分到跑通PyTorch,全程不到30分钟。如果你也常被AI环境配置困扰,不妨试试这种云端路径——先跑通,再深挖,比一头扎进驱动安装明智得多。