AI 优化科学代码后,性能还能再提几倍?
Anthropic 的突破:AI 能优化科学模型
就在最近,Anthropic 发布了一项引人注目的研究:在不到四周的时间里,Claude 自动优化了 30 多个开源生物分子模型,包括 AlphaFold3、Boltz-2、Chai-1、ESMFold2 和 RFdiffusion 等已在科研中广泛使用的工具。
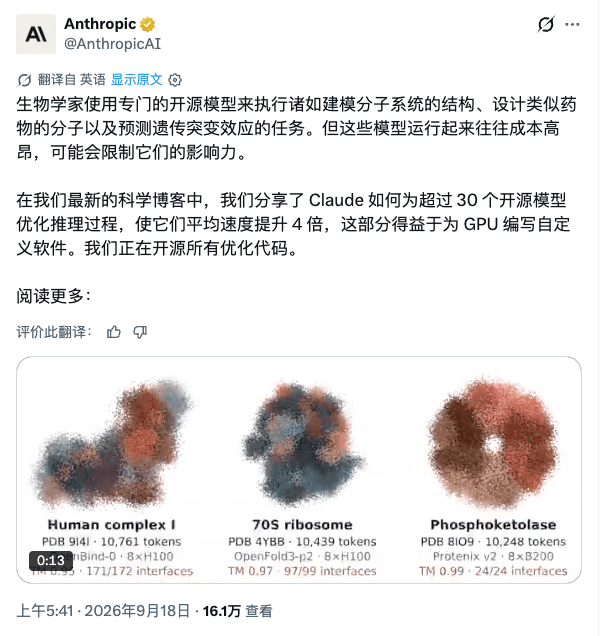
结果很实在:在允许输出有微小数值差异的前提下,任务平均提速约 4 倍;若要求结果完全一致,则平均提速接近 2 倍。所有优化后的代码均已开源。
更值得注意的是执行方式——这项工作主要由 Claude 自己完成,背后只有两名 Anthropic 工程师监督。他们懂生物建模,但并非 GPU kernel 或编译器优化专家。这意味着,AI 正在接管原本需要高度专业化工程技能的任务。
对科学家来说,这直接意味着:同样的计算预算,能跑更多模拟;同样的时间,能探索更复杂的假设。用 AI 加速现有科学软件,可能是当前最可行的科研加速路径。
但 Anthropic 的报告也留下了一个悬而未决的问题:AI 写出的科学代码,距离充分发挥硬件性能,还有多远?
一段跑得通、却慢了三倍的代码
几乎在同一时间,一个名为 ScienceIDE 的开源项目试图回答这个问题。9 月 17 日,AItonomy Foundation(由 PhAI Labs 与阿里 Qwen 赞助)发布了它的首个基础设施项目,目标是将全球科学代码库转化为 AI 可执行、可验证、可学习的环境。
在筹备过程中,团队拿 PLUTO 做了一次实验。PLUTO 是等离子体物理和天体物理领域一套经典代码,自 2007 年发布以来被广泛用于模拟流体、磁流体乃至相对论系统。它支持多种坐标系、物理模块和数值方法,本身已构成一种“计算物理基础设施”。
PLUTO 的复杂性不在代码行数,而在其数值实现的严密性。例如,Godunov 型激波捕捉格式需将空间重构、黎曼求解器和时间推进紧密耦合,每一步都涉及特定的数据依赖、访存模式和稳定性约束。磁流体模拟还需处理磁场无散条件,通过约束输运或散度清理等技术将物理守恒律嵌入数值流程——这些不是工程细节,而是科学内容本身。
PLUTO 团队自己也在推进 GPU 化,2025 年发布的 gPLUTO 就是基于 C++ 和 OpenACC 的全新实现。
AItonomy 团队则尝试用 AI 在 M1 Ultra、A100 和 H100 上重新实现 PLUTO 的磁流体力学模块。在 A100 上的一次测试中:
- AI 生成的第一版代码能运行,并在测试算例上产出符合预期的物理结果;
- 但相比团队使用的 128 核 CPU 节点,加速比不到 5 倍;
- 随后,团队花一两天与 AI 协作分析瓶颈,调整数据布局、内存访问模式、kernel 组织和冗余数据搬运;
- 在不改变所求解物理问题的前提下,性能又提升了近 3 倍。
这意味着,即使 AI 已经“写出了能跑的代码”,仍有数倍性能空间未被挖掘。
对于复杂科学计算,一次性生成的实现往往只是起点。要逼近硬件极限,AI 必须能测量性能、诊断瓶颈、修改实现、验证科学正确性,并基于反馈持续迭代。这不是靠换个提示词就能解决的。比如:
- 数据布局是否匹配线程访问模式?
- 相邻线程能否形成合并访存?
- 哪些中间结果值得缓存,哪些可重算以减少内存带宽压力?
- Kernel fusion 能否降低启动开销,又会不会因寄存器占用过高而降低 occupancy?
这些问题的答案,必须通过 profiling 和实际运行才能确定。
跑得通,不等于算得对
性能优化始终伴随着另一个核心问题:改写后的程序,还能可靠回答原来的科学问题吗?
Anthropic 的报告里就有一个典型例子。他们让 Claude 在单台 8 卡 B300 节点上预测包含 31,000 到 70,000 token 的完整病毒衣壳结构。推理全程跑通了——这在过去需要多节点集群。但报告坦承:这些结构没有被正确预测。原因在于,模型在远超训练上下文长度的场景下缺乏泛化能力,导致结构坍塌。
这个案例清晰地说明:程序能跑,不代表科学上正确。判断一个科学结果是否有效,不能只看是否报错退出,而要看它是否通过了科学意义上的验证。
在科学代码加速中,这条判据非常具体:
- 质量与能量守恒误差是否在可接受范围内?
- 磁场散度是否满足所选数值方法的要求?
- 激波位置、波速和关键物理量是否与参考解一致?
不同领域、不同问题,验收标准各不相同。如果不明确这些标准,程序完全可以通过跳过关键步骤、降低分辨率或简化物理过程来“变快”,同时失去科学价值。
ScienceIDE 将这一原则称为“科学等效性”,并将其作为任务是否完成的核心判据。
把科学代码变成 AI 的学习环境
如果一次优化只是一个交付物,那它只能被使用,无法被学习。ScienceIDE 想解决的是后者。
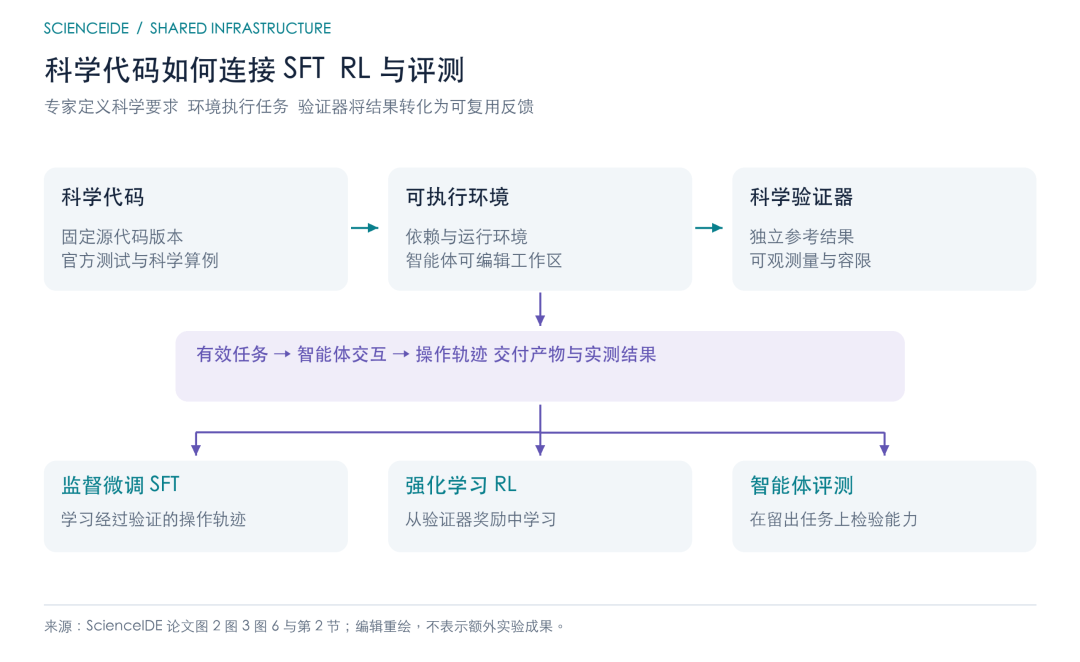
全球科学代码库蕴含大量人类知识,但这些知识分散在源码、编译脚本、测试用例,甚至研究者脑中的经验里。要让 AI 从中学习,需要将它们组织成可执行、可反馈、可判定的环境。
ScienceIDE 的做法是:由领域专家定义典型科学算例和验收标准,再与 AI 协作将代码库封装为标准化环境。在这些环境中,AI 可以:
- 接收任务(如“加速此模块”或“修复此 bug”);
- 修改代码并运行;
- 检查输出是否通过科学验证;
- 若成功,交互轨迹可用于监督微调或强化学习。
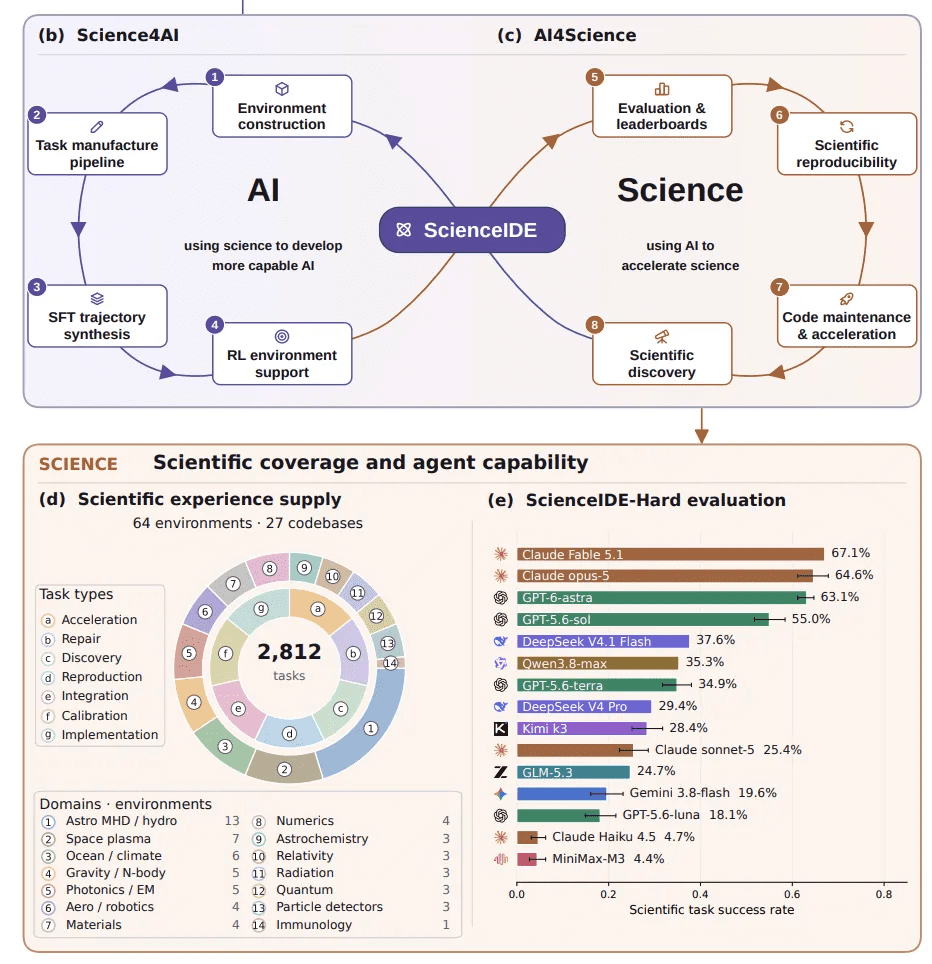
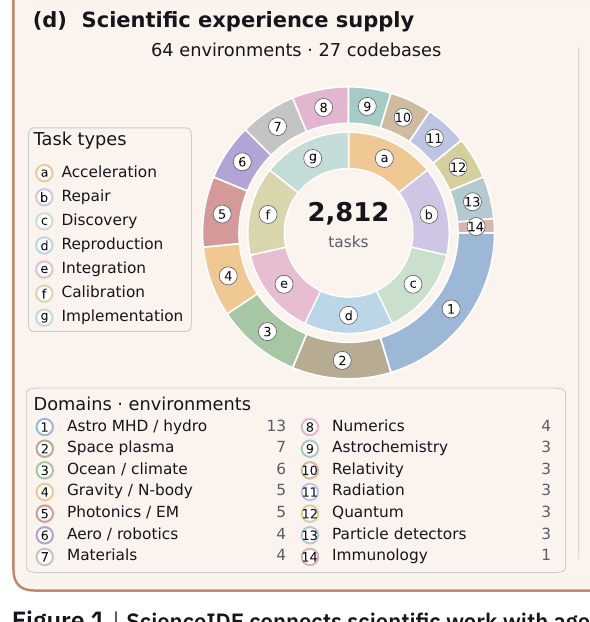
目前,ScienceIDE 已整合来自 27 个科学代码库的 64 个环境、2,812 个任务和 1,076 项可执行科学检查,覆盖天体磁流体、海洋气候、量子材料、粒子探测、免疫建模等多个方向。任务分为七类:加速、修复、发现、复现、集成、标定、实现。
需要说明的是,当前任务仍以修复和功能实现为主,加速类任务尚处早期阶段。团队表示正在构建完整的性能优化闭环:固定科学问题、输入规模和硬件预算,让 AI 修改实现,通过科学检查验证结果,再统一衡量运行时间和资源消耗。
最强模型也只做到 67%
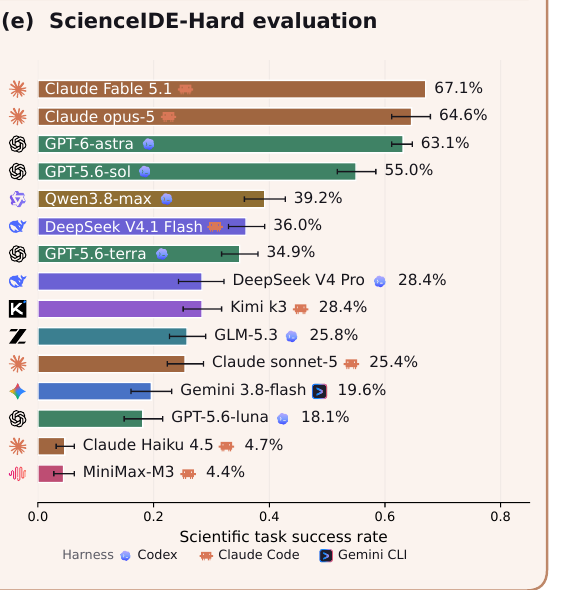
为了评估这类任务的难度,团队从现有环境中挑选 85 个难题组成公开评测集 ScienceIDE-Hard,涵盖 PLUTO、Athena++、MITgcm 等知名代码库,包含 52 个修复任务和 33 个实现任务。
评判标准很严格:必须在任务指定的验收条件下,与私有科学参考答案一致,而不仅仅是程序执行成功。
评测邀请了 8 家厂商的 15 个前沿模型参与,每个任务 episode 限时一小时。结果令人深思:
- 最强的 Claude Fable 5.1 成功率为 67.1%;
- Claude Opus 5 为 64.6%;
- GPT-6-astra 为 63.1%;
- 超过一半的模型成功率低于 30%。
这说明,真正的科学编程任务远未被解决。即使是最先进的模型,在面对需要深度领域知识和长程推理的科学代码时,依然会频繁失败。
科学不只是应用场景,更是训练场
有趣的是,这项工作还带来了另一侧的发现。
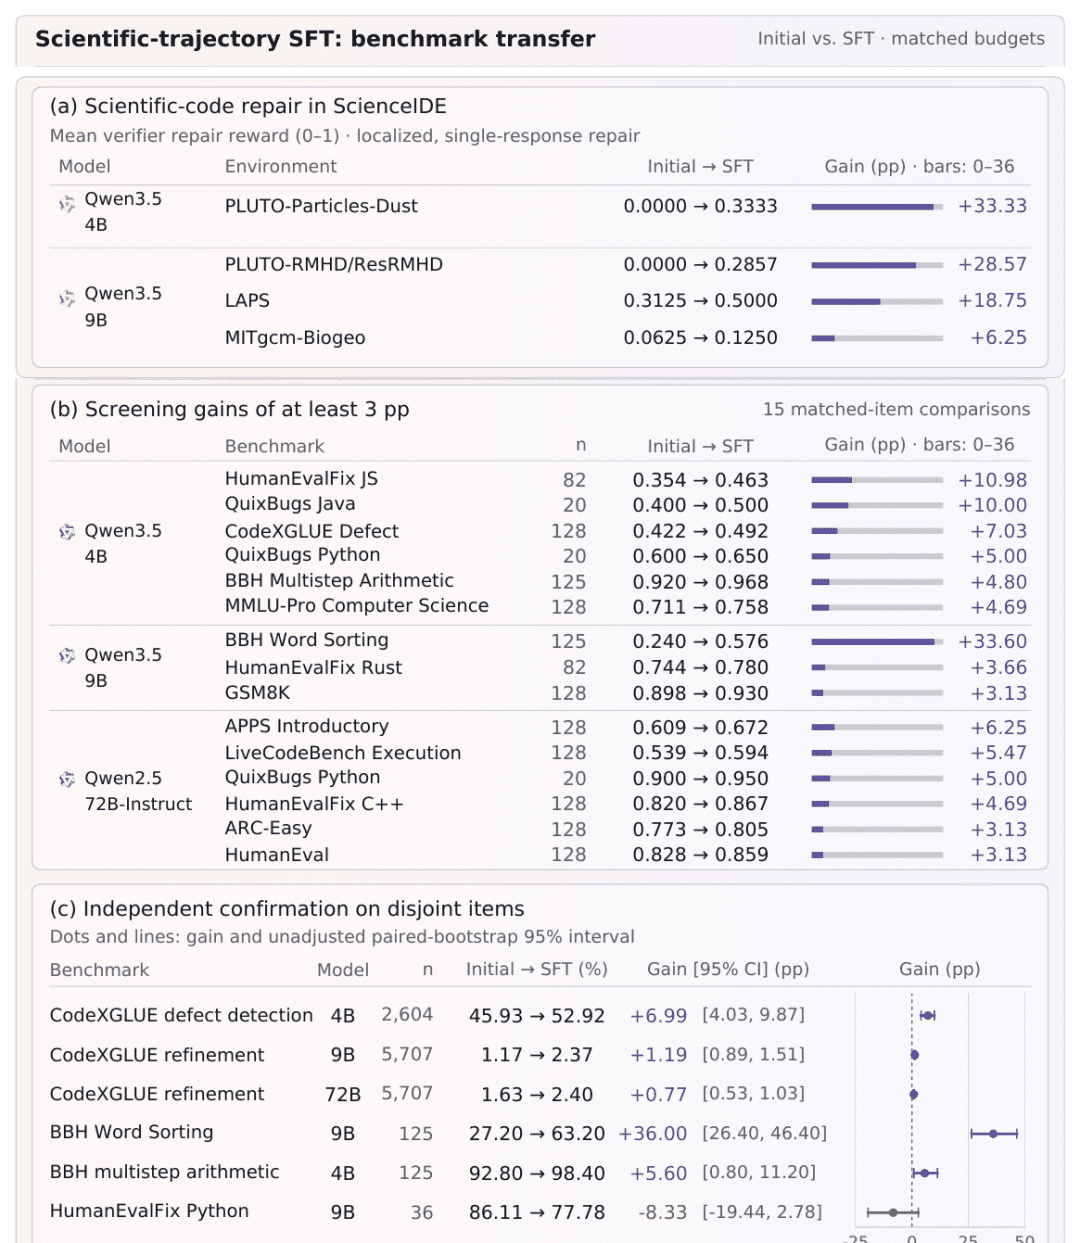
团队用这些经过科学验证的交互轨迹进行监督微调,训练并开源了 PhAI-IDE-4B、9B 和 72B 三个规模的模型。结果显示,提升的不仅是科学任务表现,代码、推理和知识类通用基准也同步受益。
例如:
- 在 72B 模型上,APPS Introductory 从 0.609 提升至 0.672,LiveCodeBench Execution 从 0.539 提升至 0.594;
- 在 9B 模型上,BBH Word Sorting 从 0.240 跃升至 0.576。
这组数据指向一个可能被低估的事实:科学任务天然具备长程性、约束性和多步推理特征,可能是推高 AI 智能上限的有效训练场。相比常规的短代码片段,科学编程要求模型理解物理规律、数值行为和硬件特性之间的复杂耦合。
一个非营利组织的公开邀请
AItonomy Foundation 是一家注册于硅谷的非营利组织,愿景是加速 AI 与科学之间的闭环。
按照其官网表述,这两个方向都依赖可靠的反馈机制:模型提出的假设需通过计算或实验检验;科研过程中产生的数据、操作记录和失败尝试,也需整理验证后才能成为 AI 的学习材料。论文能传递成果,却难以保留得出成果前的判断、调整与试错过程。
ScienceIDE 正试图把这些“隐性知识”显性化。科研人员可以从自己熟悉的代码库和典型算例出发,参与定义任务与验收标准,将专业判断转化为可重复使用的科学检查。
目前,已有来自伯克利、CMU、康奈尔、加州理工、哈佛、MIT、牛津、UCL、普林斯顿、斯坦福等二十余所机构的研究者以个人身份参与。
值得一提的是,团队公开表示希望将 Anthropic 此次开源的 36 个优化包整合进 ScienceIDE。这些包附带参考实现和明确的验收标准,条件近乎理想。如果实现,社区不仅能使用优化结果,还能在此类任务上训练和评测模型。
性能差距的背后,是迭代能力的差距
回到最初的问题:AI 写出的科学代码,离硬件性能极限还有多远?
PLUTO 实验给出的答案是:数倍。
而要拿到这数倍提升,靠的不是更强的一次性生成能力,而是测量、诊断、修改、验证、再迭代的闭环能力。
Anthropic 的工作证明了大模型有能力参与这类任务。ScienceIDE 则试图回答下一个问题:如何让这种能力被持续积累、复用,并迁移到新领域?
人类几十年积累的科学软件,本身就是一座尚未被充分利用的富矿。而此刻,它正迎来一位新的学习者——一个不仅能执行指令,还能从失败中学习、在约束下创新的智能体。