具身智能技术路线未定型,但基础设施需求已趋收敛
本体下线了,能力还没跟上
机器人本体开始批量下线,行业反而更焦虑了。
不是因为造不出来,而是因为一台机器人学会叠衣服、上下料或拧螺丝后,这套能力很难快速复制到第二台、第十台,更别说换一个工厂、换一种机械臂还能不能跑通。从一次成功到一万次稳定执行,中间缺的不是硬件,而是一套能持续生产、验证和复用“能力”的系统。
具身智能和纯数字世界的AI大模型不同,它必须在物理世界里完成动作、承受误差、应对干扰。每一次执行都会产生新数据,这些数据如果不能有效回流到模型和系统中,机器人就无法“越用越会”。
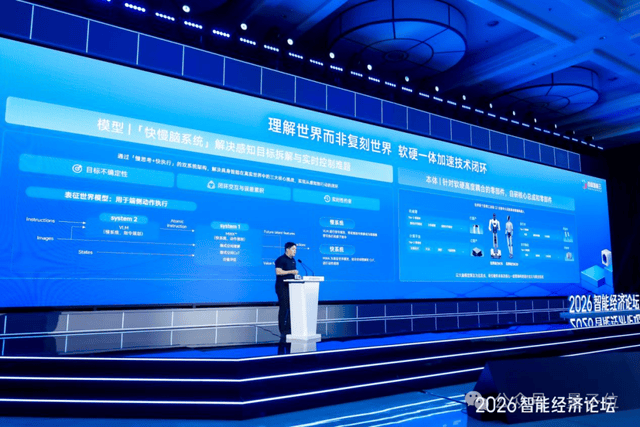
百度集团执行副总裁沈抖在2026智能经济论坛上打了个比方:今天的AI可能只是灯泡刚发明后的第一个月——灯亮了,大家看到了希望,但电力如何重塑社会分工,还没开始。
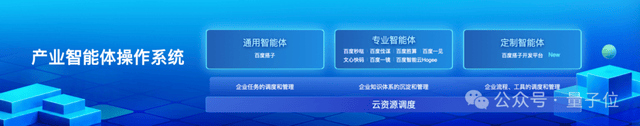
对具身智能来说,真正的考验是:当智能体进入工厂、仓库或家庭,企业能否把自身的知识、流程和工具,组织成可被机器人理解并执行的任务,并在此过程中持续进化。
能力也需要一条“产线”
如果说本体量产靠的是工业制造体系,那能力量产靠的就是AI基础设施。
所谓“能力量产”,指的是将一项已在真实场景中验证有效的技能(比如抓取异形零件、自主导航避障),通过模型、数据和反馈的闭环,以可控成本稳定复制到更多机器人和场景中。这背后涉及三个关键指标:任务成功率、人工接管率、单位任务成本,以及技能迁移所需的时间。
但现实是,很多团队卡在了“高频迭代”的工程瓶颈上。改一次模型,可能要重新适配算力、调整训练框架、重建仿真环境、重写部署脚本。数据采回来要清洗标注,模型训完要仿真验证,仿真过了还得真机测试,测试又暴露新问题……整个链条像一串互相牵制的齿轮,动一个就得全调。
这时候,全栈基础设施的价值就凸显出来了——它要把数据、训练、评测、推理和反馈这些节点,接成一条可重复运行的流水线。目标很简单:同样的时间和预算,让企业能多跑几轮实验。
第一环:让不同模型路线都能快速试错
目前,具身智能的技术路线远未收敛。VLA(视觉语言动作模型)、世界模型、全身运动控制等方案并行演进,谁主谁辅、如何融合,尚无定论。
百度智能云主任架构师应茹指出,技术越不确定,基础设施越要保持通用和灵活。企业真正需要的,不是某次训练快了多少,而是在固定周期内能完成多少次“训练-仿真-真机验证”的完整闭环。
有人一周能跑三轮,有人三周才跑一轮。长期看,试错频率本身就是竞争力。
百度推出的“百舸”AI算力平台,正是为了解决这类共性工程问题。它把数据准备、模型训练、仿真评测和推理部署整合进同一套工作流,统一处理算力调度、框架适配和环境管理。
例如,针对5B到20B规模的VLA或WAM(世界动作模型),百舸集成了SONIC训练配方,支持一键扩展至128卡集群;对WAM推理中的延迟瓶颈,通过工程优化将延迟降至原来的四分之一。这些改进不追求单点突破,而是整体缩短迭代周期。
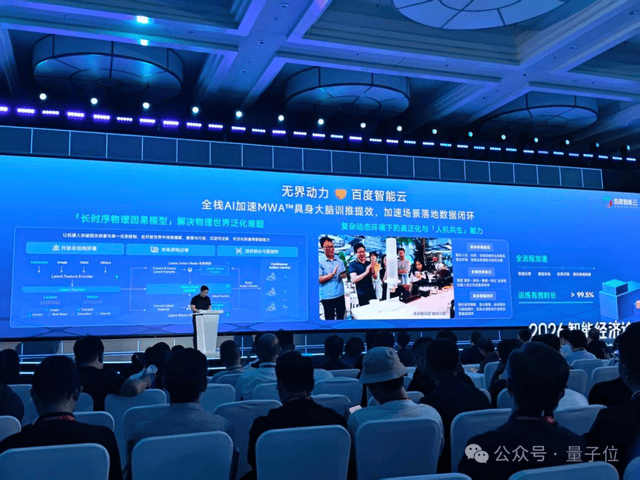
无界动力就是一个典型用户。其自研的MWA™具身大脑强调“快慢结合”,在工业和商业场景中同步推进性能、技能与泛化能力。每进入一个新场景,就带回一批新数据。依托百舸平台,其训练有效时长超过99.5%,意味着几乎没被底层工程问题拖慢节奏。
第二环:把真实操作变成可训练的数据
互联网给大语言模型留下了海量文本,但机器人想学会装一个零件,网上几乎找不到“教材”。
具身数据天然复杂:它包含视觉、动作、力觉、本体状态、空间关系和时序信息,且高度依赖具体本体和任务。采集之后,还要经历清洗、切片、标注、质检、管理、训练、评测等多个环节。
当前的核心难题,不是数据量不够,而是能否持续、高效地将真实现场转化为可学习、可验证的经验。
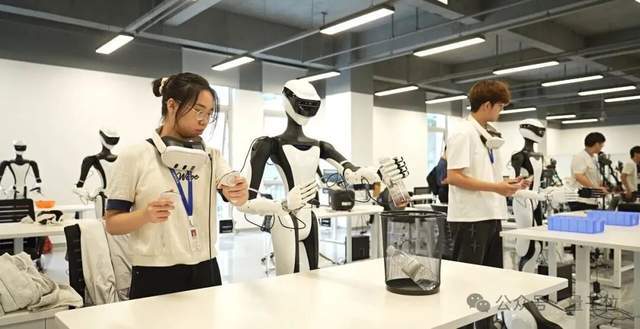
在东莞,由地方政府投入、百度智能云承建运营的具身智能训练场已投入使用。这里建成了大湾区首个实体化具身智能采标实验室,提供从真机采集、标注到仿真的完整工具链。
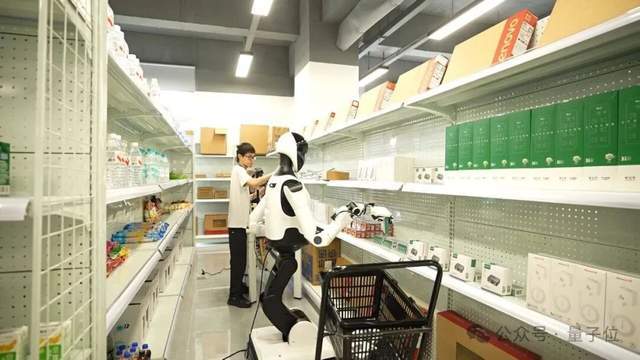
训练场规划了13个真实产业场景,覆盖家具、3C电子、五金模具和物流仓储,部署了50台套异构机器人本体,以及100多台Ego、UMI等无本体采集设备。这些场景直接对接东莞制造业的刚需,把产线任务变成训练任务。
数据生产走三条路径:真机遥操作保证真实性,无本体设备降低成本并扩大规模,仿真与算法生成补充多样性。所有数据统一纳入“采标管一体化平台”管理。
更重要的是,这个训练场还承担“中试”功能——机器人可以先在这里试训、验证,再进客户工厂。相当于把大量试错从正在运转的产线上提前剥离出来。
目前,该平台已服务35家具身智能企业。它不再只是一个数据车间,而是一个行业级的工业实训载体。
第三环:能力要稳稳落进机器人身体里
模型训好了,只完成了一半。真正面对用户时,机器人得听懂、理解、及时响应、正确执行,并长时间稳定运行。
消费级机器人品牌上纬启元推出了Q1、T1两款产品,面向家庭和个人场景。在其研发过程中,百度百舸提供了统一的训练、微调、推理和测试环境,集中管理AI任务与弹性算力调度。
上纬启元首席科学家董豪表示,这种一体化环境显著提升了数据流转效率和算法迭代速度。但更重要的是,机器人作为终端产品,背后是多个系统的协同:
- 模型负责理解和决策;
- 语音交互承接用户意图;
- 端云协同影响响应延迟;
- 安全机制保障长期稳定。
这些能力必须适配不同形态的本体。工业机器人追求节拍、精度和稳定性,而家庭机器人面对开放环境、高频交互和不可预测的用户行为。只有建立起跨本体、跨场景的适配能力,一项技能才有机会真正复制出去。
基础设施需求正在收敛
尽管技术路线百花齐放,但底层工程需求却显现出惊人的一致性。
无论是千寻智能、智元机器人、宇树科技,还是银河通用、星动纪元、跨维智能,这些企业在模型迭代、数据回流、本体部署和场景验证上,反复遇到相似的问题。
千寻智能接入百舸后,有效训练时长达98.8%,核心诉求就是减少工程干扰,把时间留给模型创新。智元机器人则看重全栈AI云的持续调用能力——随着产品推进,能按需使用训练、数据、部署等模块。
这些案例说明,当具身智能进入提效与落地阶段,行业分工正在清晰化:
- 模型架构、产品定义、场景理解,仍是企业的核心壁垒;
- 而算力调度、训练加速、数据处理、仿真评测、推理部署等共性工程问题,则适合沉淀到公共基础设施层。
百度智能云的布局正是沿着这条逻辑展开:
- 模型侧:百舸提供训练、推理与算力调度;
- 数据侧:覆盖采集、标注、管理与评测;
- 本体侧:补足语音交互、安全与端云协同;
- 场景侧:通过训练场和中试平台完成验证与复制。
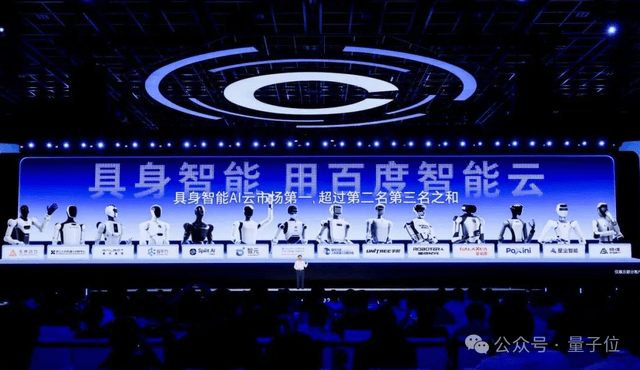
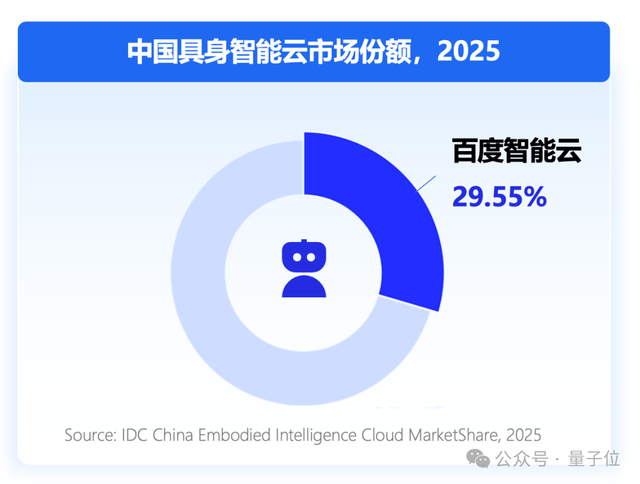
目前,百度智能云已为超过50家重点具身企业提供全栈支持。IDC和Omdia的报告均显示,其在中国具身智能云市场占有率第一。
但比市场份额更值得关注的是趋势本身:当不同路线、不同本体、不同场景的公司开始调用相似的底层能力,竞争焦点已从“谁先做出能力”转向“谁更快完成验证、复制和迭代”。
在技术路线尚未定型的今天,企业不必押注唯一答案,但必须确保自己还能继续试。未来的赢家,或许不是最早的那个,而是迭代最快的那个。