实测阶跃Step 5 Preview:27B激活参数跑出开源Top2的Agent能力
实测比榜单更说明问题
昨天阶跃星辰突然放出 Step 5 Preview,没预告、没预热,直接扔出一组硬参数:MoE 架构,总参数 600B,但每次推理只激活 27B,支持 100 万 token 上下文。在 Artificial Analysis(AA)最新评测里拿了 44 分,冲到全球开源模型第二。
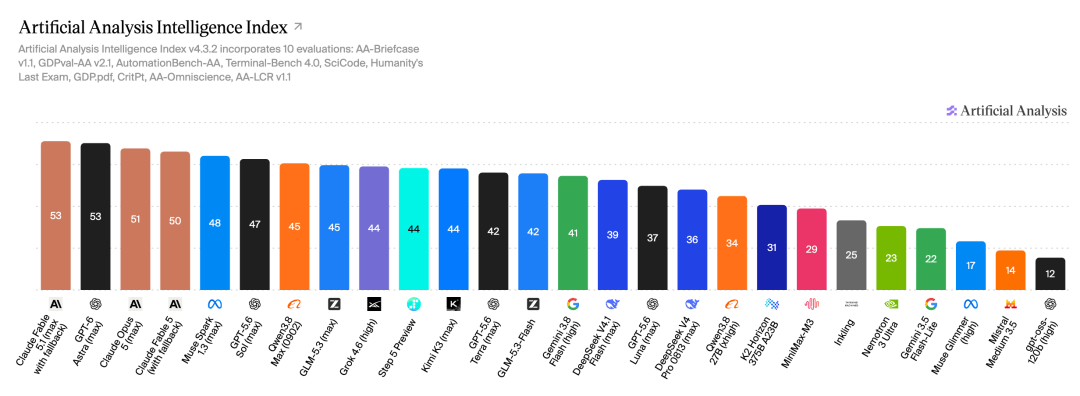
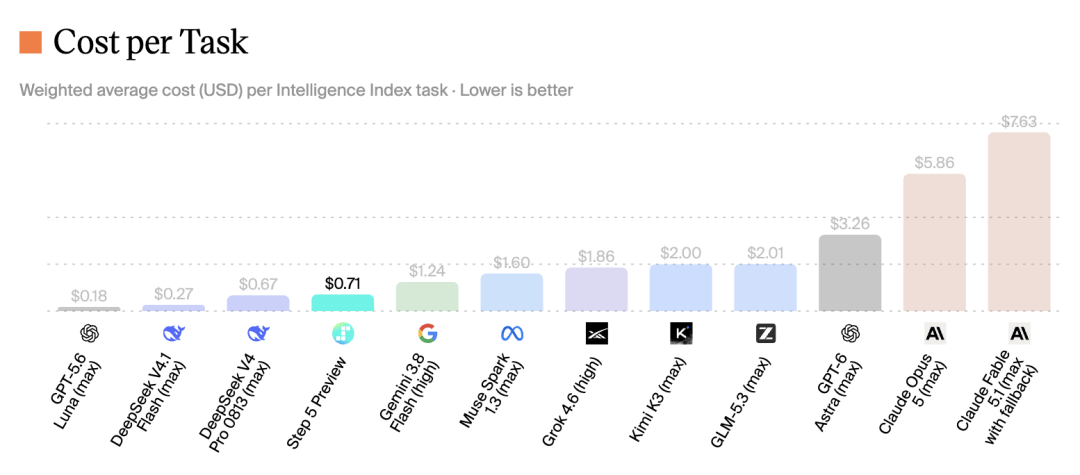
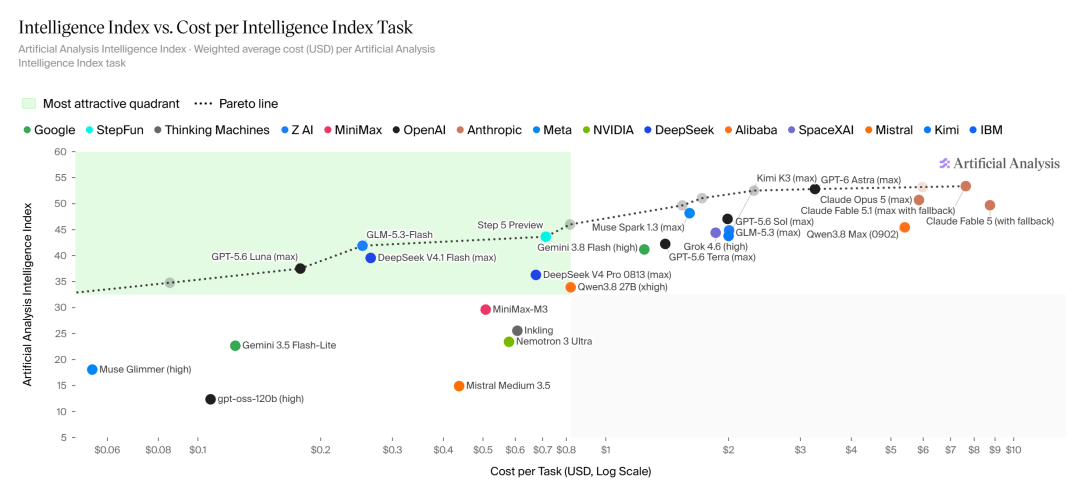
这个分数什么概念?其他达到 44 分的模型,基本都是万亿级参数选手。而 Step 5 Preview 的定价很实在:百万输入 1 美元,百万输出 2.7 美元,单任务成本只有 Opus 5 的 12.5%。在 AA 榜单的“智能指数 vs 单任务成本”图上,它正好落在帕累托前沿上——花同样的钱,它更聪明;要同样的智能,它更便宜。
但光看榜单容易上头。过去一年,各种刷榜模型层出不穷,真到干活时往往掉链子。所以我决定自己动手测一测:接上 API,让 Step 5 Preview 直接操作 Blender 和游戏引擎,看它到底能不能干点复杂的活。
让它建个“后室”,结果吓我一跳
第一个任务,我让它照着 Astra 最近带火的玩法,用 Blender 建一个“后室”(Backrooms)场景。Prompt 写得挺简单:黄墙、荧光灯、无限走廊、诡异氛围。没指望它真能做出完整作品,毕竟连基础建模、材质、灯光、动画、渲染都得自己调。
结果一个多小时后,它交回来一个 MP4 文件。点开一看,我愣住了——这哪是 AI 生成的?昏黄的灯光、闪烁的荧光管、VHS 录像带特有的噪点和色偏,连人物走路的脚步声都配上了。画面里那种空旷又压抑的感觉,简直像从恐怖游戏里截出来的。我第一反应是:“你是不是偷偷去哪个素材网站下载的?”
建模本身已经够稳了,更离谱的是它自己加的后期处理。这些细节我压根没提,但它判断出“后室”需要这种复古录像质感,主动补全了。虽然有点毛骨悚然,但不得不说,Agent 的自主决策能力确实上了一个台阶。
复刻乐高赛车,连音效都没落下
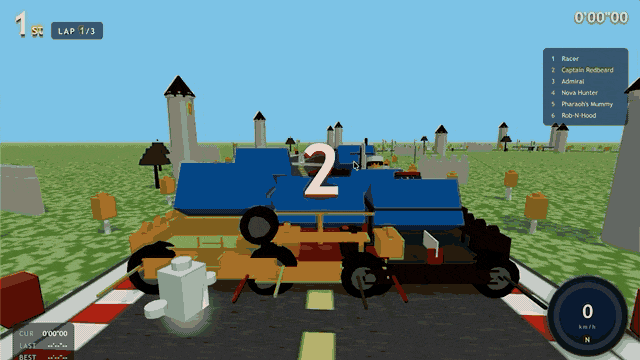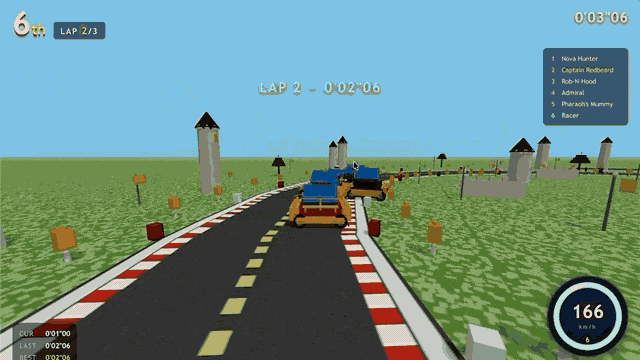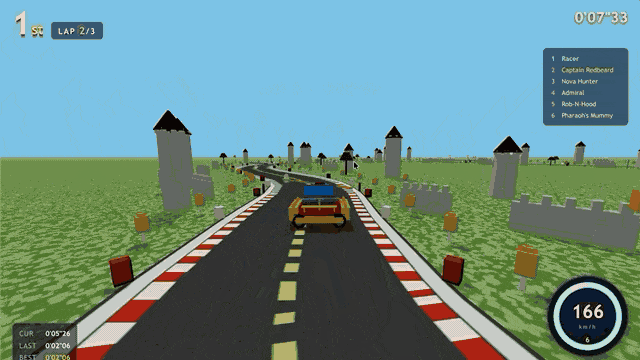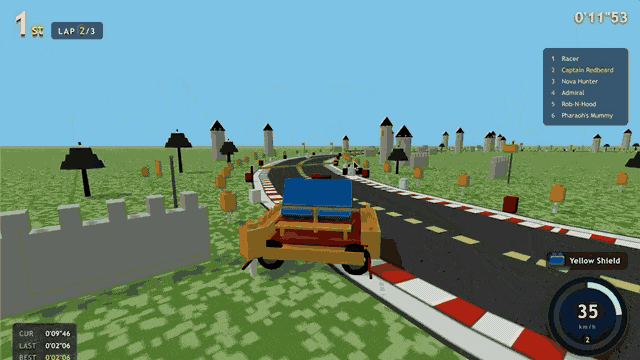
第二个任务轻松点:照着 1999 年的《LEGO Racers》搓一个乐高赛车小游戏。这次它也交出了完整方案——赛道、可操控的赛车、三个 AI 车手、实时排名板,甚至发动机的轰鸣声和漂移音效都安排了。
我玩了几圈,手感意外地流畅。唯一问题是赛道修得太窄,我这种菜鸡经常一脚油门就撞上路障,连 AI 车手都超不过。不过这也侧面说明,它对游戏机制的理解是连贯的:知道要有对手、有胜负判定、有反馈音效,而不是只堆砌静态元素。
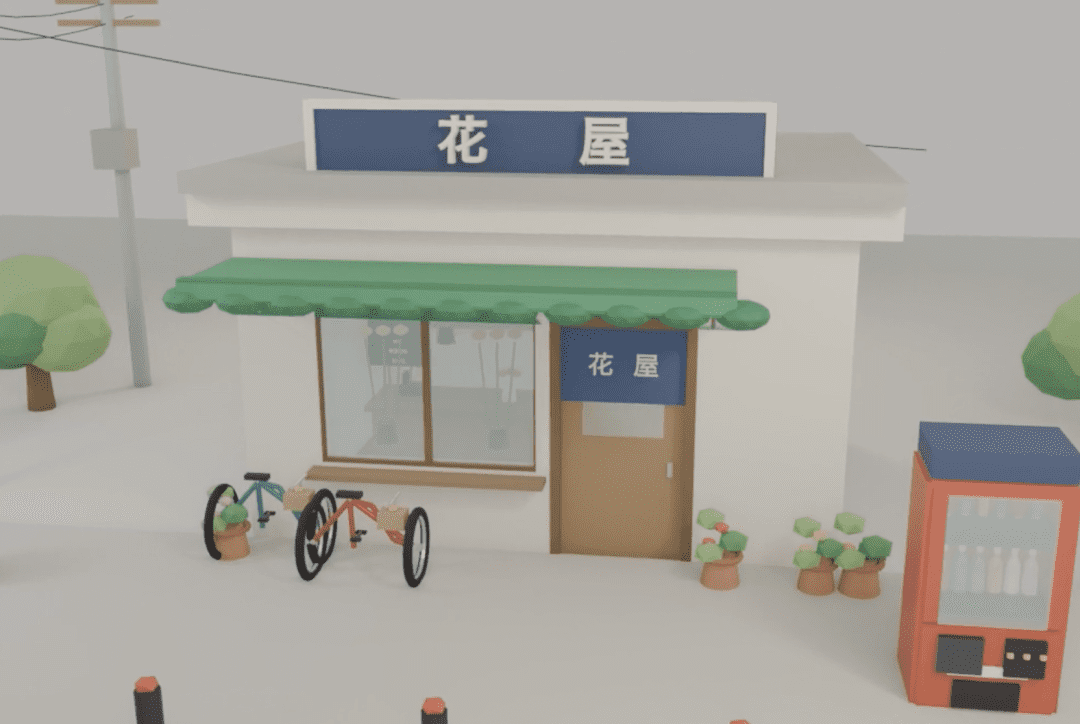
玩完这两个 3D demo,我差点在工位上吐出来——本人重度晕 3D,实在扛不住了。于是第三个任务换成 2D:建一个《花屋》场景。这次它用 Blender 做了个带玻璃温室、藤蔓和花卉的静帧,光影层次很到位,至少能当概念图用了。
2D任务更稳,审美终于在线
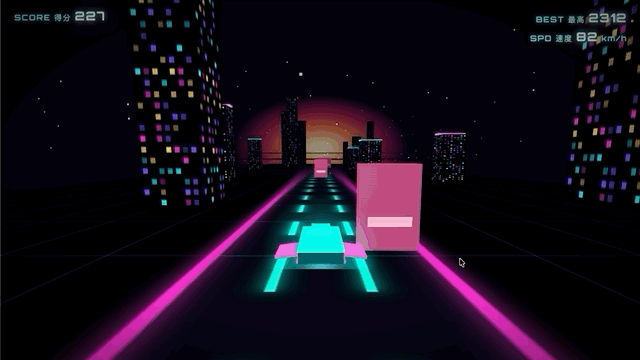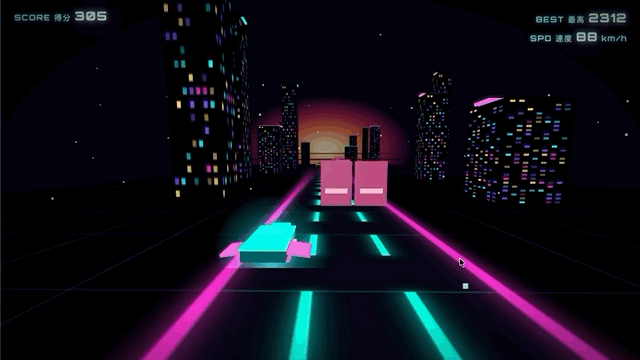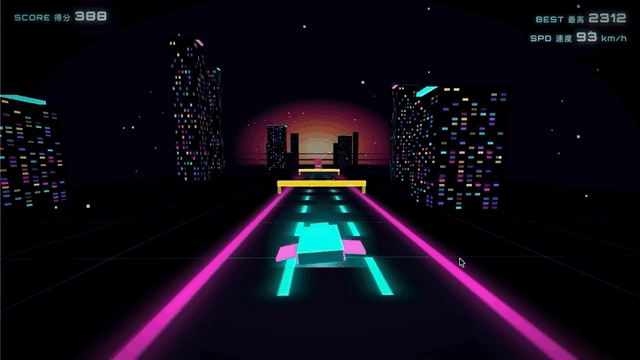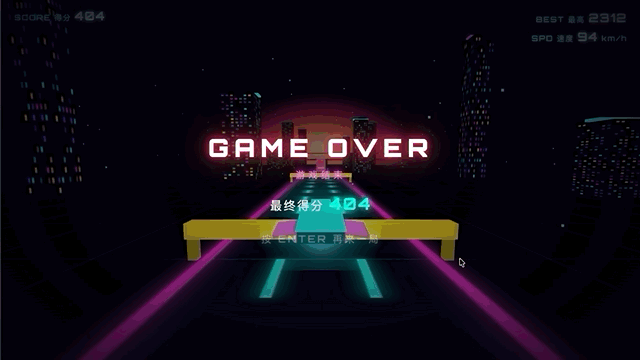
接着试了两个轻量级项目。第一个是霓虹跑酷小游戏。我特意用了和阶跃上一代官网 demo 类似的 prompt,结果差距很明显:道路两旁多了高楼剪影,背景有动态粒子,Game Over 时整个边框会变红闪烁。很多 prompt 里没写的细节,它自己脑补并实现了。
第二个是做个写作网站。这里必须单独夸一句:终于不往东坡肉里塞番茄炒蛋了。界面干净、配色协调、功能分区清晰,从导航栏到编辑器再到发布按钮,一套流程走下来毫无违和感。基本能直接拿去当 MVP 用,不用大改。
当然,也不是完美无缺。比如写作网站的侧边栏偶尔会溢出屏幕,跑酷游戏的角色碰撞体有点飘。但这些问题通常指出两三轮,它自己就能修好,最终达到可用状态。比起 Astra 那种“瘫软级”的惊艳,Step 5 Preview 更像是个靠谱的实习生——需要 review,但改得快、能交付。
为什么 Agent 能力突然猛增?
这就引出一个关键问题:阶跃前两代主推 Flash 系列,定位性价比,怎么到 Step 5 Preview,Agent 能力突然跳这么高?
答案藏在它的技术路线上。过去几年,行业迷信“Scaling Law”——更多参数、更多数据、更多算力。这招确实有效,比如 Fable 就靠堆规模让 Agent 涌现出新技能。但代价是贵,贵到普通人根本用不起。
阶跃没走这条路。他们选了“Narrow but Deep”(窄但深)的设计:92 层的 Transformer,在控制激活参数规模的同时,让信息经过更多层连续变换。这对 Agent 至关重要。复杂任务里经常有大量 multi-hop 依赖——比如先查资料、再写代码、最后部署,中间每一步都依赖前几步的结果。网络更深,相当于给这些信息留出了更长的传播和推理路径。
但更深的网络带来另一个问题:上下文爆炸。几十轮工具调用后,上下文轻松突破百万 token。如果每层都重新扫一遍全部历史,计算量会指数级增长。
所以团队做了第二件事:稀疏化。Sparse MoE、Hybrid Sparse、Sparse GQA……这些技术本质上都是为了在长上下文中节省算力。但算法写个“Sparse”不等于 GPU 真的少干活——索引、访存、调度没优化好,省下的算力全浪费在数据搬运上。
Step 5 Preview 在硬件层下了功夫,通过底层算子和内存访问优化,让理论上的稀疏真正转化为实际吞吐。有了这套软硬件基座,训练目标就清晰了:让模型的基本单位从“回答”变成“Loop”。
从“回答”到“Loop”的转变
现在的 Agent 工作流是这样的:规划任务 → 执行 → 调用工具 → 查看结果 → 发现不对 → 修正 → 继续 Loop。这个过程可能重复几十轮。关键在于,模型得在长程任务中始终记得“自己到底要干嘛”。
阶跃用 Long-horizon RL(长程强化学习)和 Context Compaction(上下文压缩)等方法,解决了这个问题。比如在建后室时,它先拉出基础结构,再逐个添加灯光和材质,最后统一加后期——每一步都基于前一步的结果调整,而不是从头开始。
这种设计思路很“阶跃”:从 Step 3.5 Flash 到 Step 3.7 Flash,再到今天的 Step 5 Preview,核心逻辑没变——把有限的计算预算,精准花在真正影响 Agent 能力的地方。不盲目堆参数,而是优化信息流动效率。
在拥挤的 Frontier 里找自己的位置
大模型竞赛打到现在,战场瞬息万变。Stanford 2026 AI Index 有个数据很有意思:截至 2026 年 3 月,Anthropic、xAI、Google 和 OpenAI 四家最顶尖模型在 Arena 上的 Elo 分差已缩到 25 以内。要知道,GPT-4 刚发布时,这个差距可是上百点。
这意味着 Frontier(前沿)内部越来越拥挤,单纯刷某个 benchmark 第一,已经很难定义一家公司的长期价值。现在的问题更复杂:能力有没有差异化?成本能不能压下来?benchmark 上的智能,能不能迁移到真实世界的长程任务里?
各家都在疯狂点自己的技能树。K3 死磕前端开发,把网页生成做到极致;V4 Flash 打爆性价比,把 Flash 级模型做成白菜价;Astra 则聚焦 Computer Use,让用户相信“AI 能操作电脑”。
阶跃这次给出的答案很清晰:向上,用旗舰基座杀回全球第一梯队;向下,靠效率和成本让 Agent 进入大众生活。Step 5 Preview 就是这个策略的产物——不是最强的模型,但在“性能×成本”的甜蜜点上卡得很准。
技术路线不会这么快收敛
我一直觉得,大模型层更像一片参差不齐的竹林。每个方向都是 trade-off:更强的推理 vs 更低的延迟,更长的上下文 vs 更少的激活,更好的多模态 vs 更稳的 Agent 能力……至少在短期内,不可能有哪家模型把所有技能点全拉满。
所以技术路线也不会快速收敛。只要能找到合适的切口——比如阶跃这次押注“窄但深”+稀疏化+硬件协同——新模型、新公司依然有机会找到自己的生态位。
AGI 这场马拉松,远没到最后一公里。阶跃回来了,而且带着更务实的打法。