Google 推出 Gemini 4 Argon:单次输出上限达百万 Token,聚焦企业级复杂任务
单次输出上限拉到 100 万 Token
Google 最新发布的 Gemini 4 Argon 模型,最引人注目的变化是把单次输出上限从 6.4 万 Token 提升到了 100 万 Token。这个数字不是上下文窗口,而是模型一次能生成的内容长度。
这意味着什么?简单说,Argon 能在一条任务链里持续输出几十万甚至上百万字的内容,而不用分多次请求。这种能力对大型代码库迁移、深度技术报告生成或多步骤自动化流程特别有用。
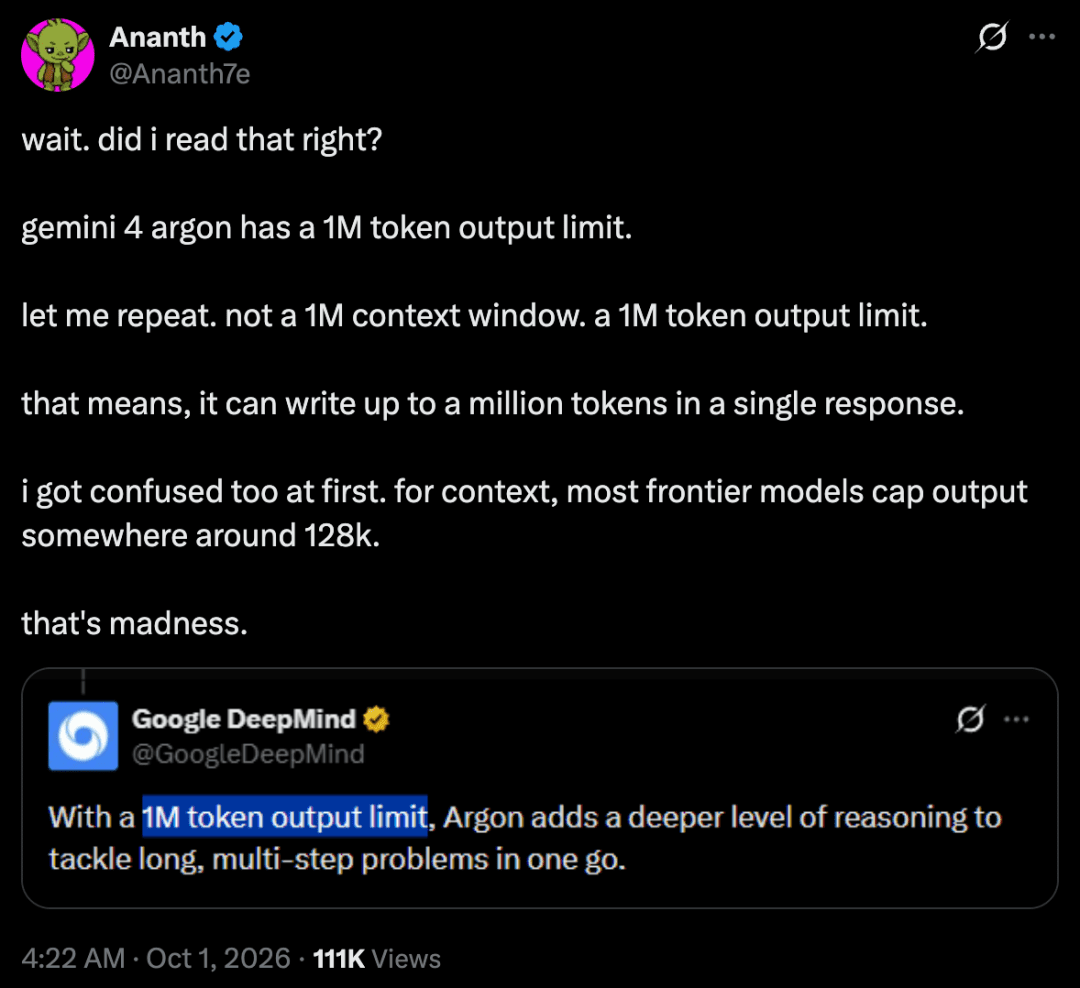
目前大多数前沿模型的输出上限在 12.8 万 Token 左右。Argon 的 100 万确实是个跳跃。不过要注意,这不等于它能“记住”100 万 Token 的上下文——输入窗口仍是另一个指标。
定位明确:专攻企业知识工作
和过去直接向公众开放不同,Argon 这次走的是分阶段、定向发布路线。Google 把它定位为“面向复杂、长周期工作流”的模型,重点覆盖软件工程、法律、金融这类需要深度推理的企业场景,以及网络安全防御。
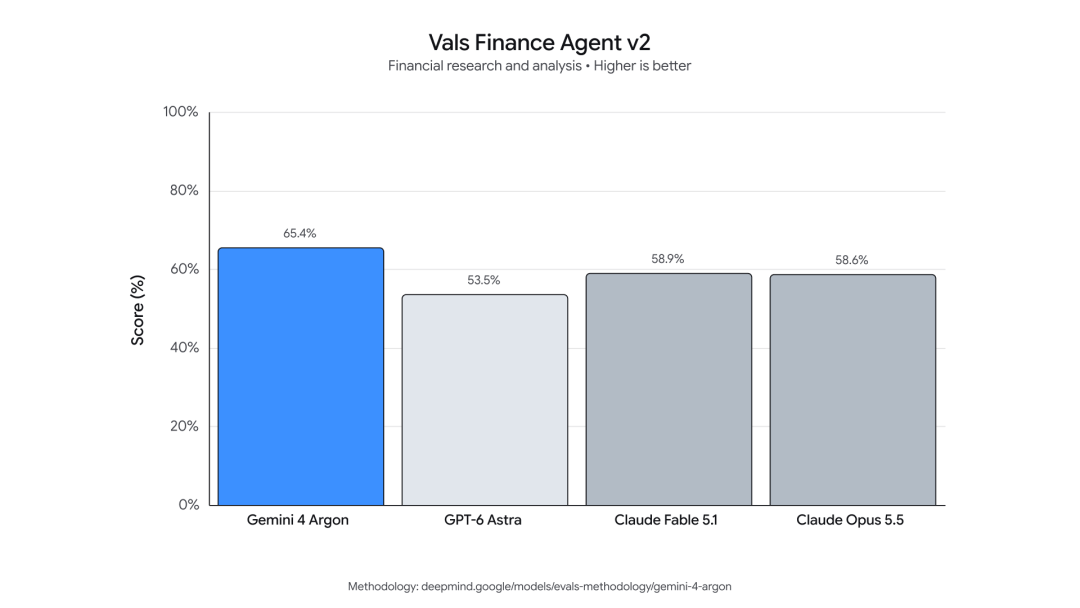
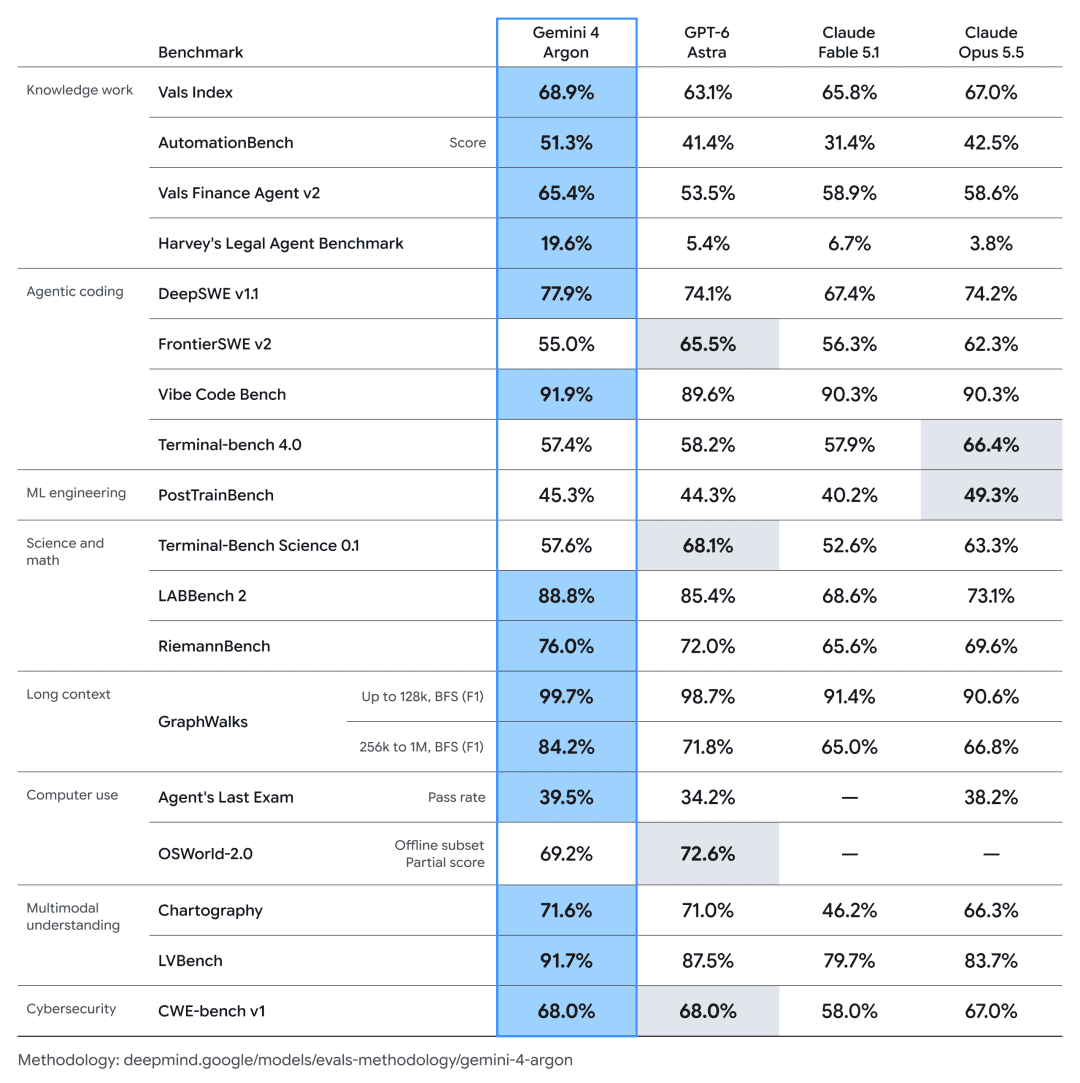
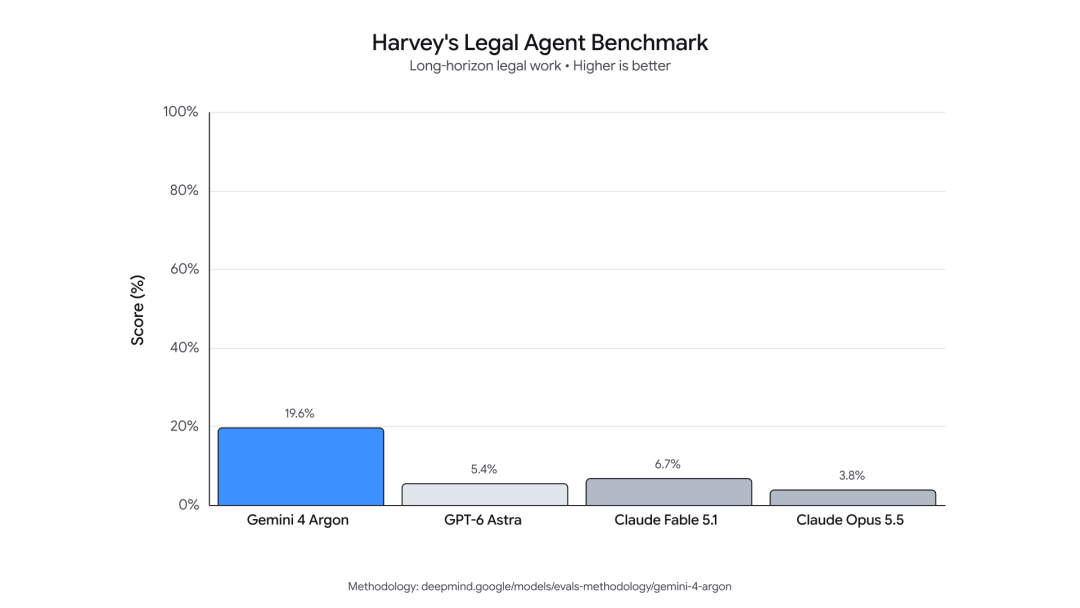
在多个专业评测中,Argon 表现突出:
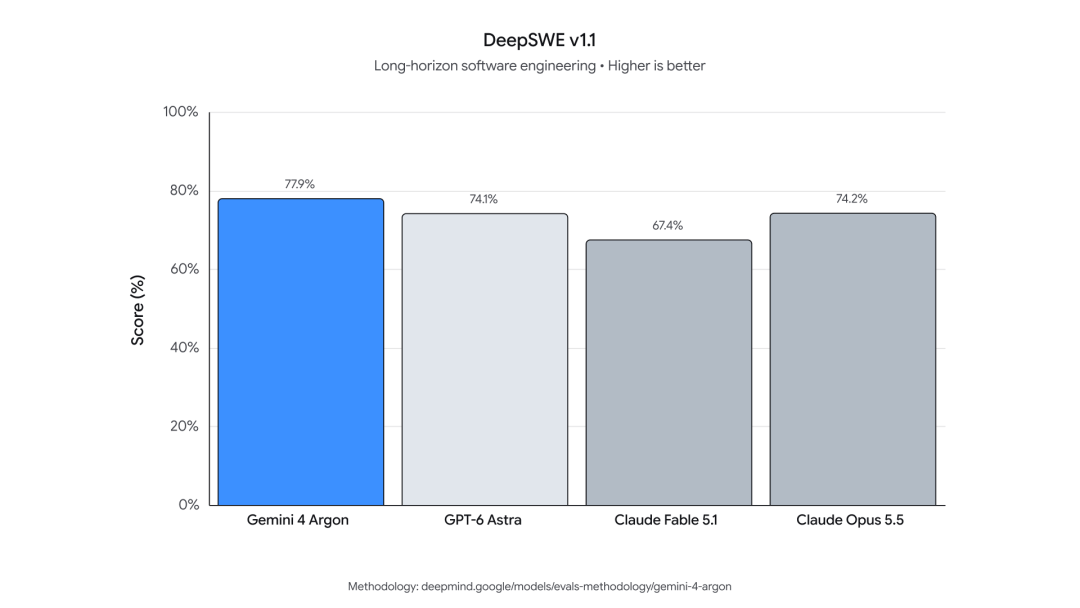
- DeepSWE v1.1(软件工程):得分 77.9%,当前最高
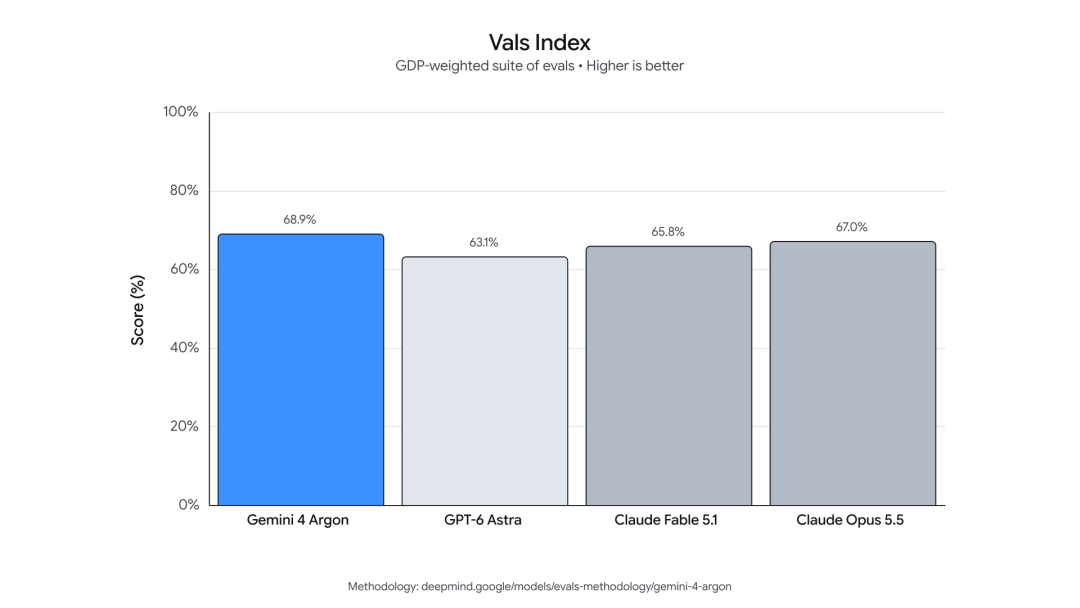
- Vals Index(加权金融、编程、法律、税务):排名第一
- AutomationBench(Zapier 的自动化任务):得分 51.3%
- Harvey Legal Agent Benchmark:领先
- Vals Finance Agent v2:领先
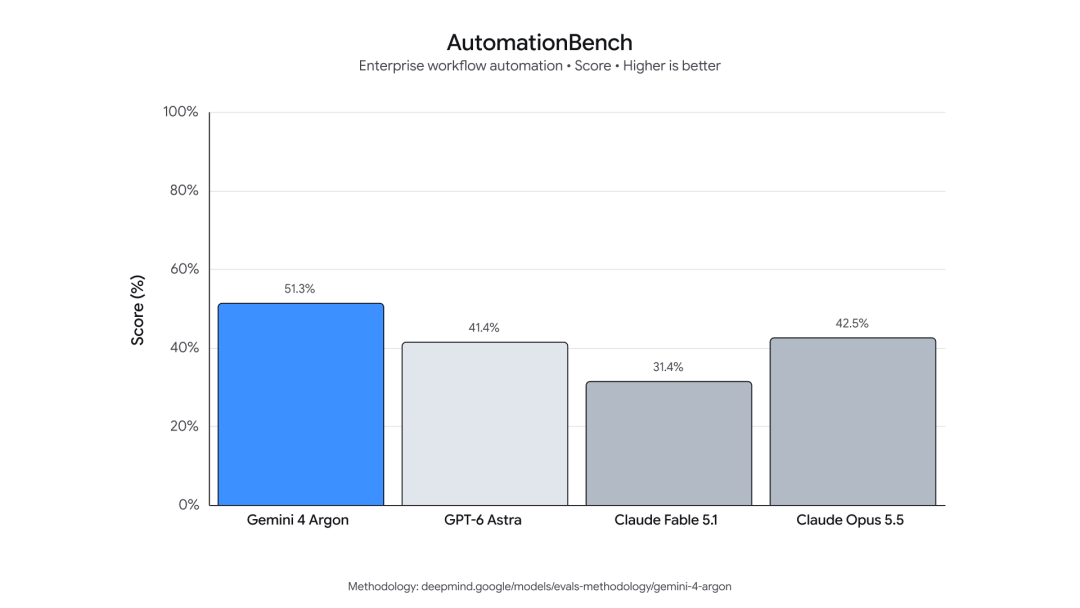
这些评测都强调模型在真实业务环境中的多步推理和执行能力,而不是简单的问答。
视觉理解也不含糊
除了文本,Argon 还强化了视觉理解。Google 称它能分析专业图表、理解长视频,并基于多份文档采取行动。在 LVBench(长视频理解评测)中,它拿到了 91.7% 的分数。
这对需要处理财报图表、监控录像或技术图纸的企业用户来说,是个实用功能。不过具体支持哪些格式、响应速度如何,官方还没细说。
已跑在 Google 自家系统里
Argon 不只是纸面模型。Google 表示,已有数千名员工在日常工作中使用它,主要场景包括代码调试、算法设计和大型代码库迁移。
几个具体案例:
- 量子计算:Argon 帮研究人员优化量子算法的时空资源(量子比特数 × 门操作数)。在一项测试中,几分钟内就把已发表的基准结果提升了 40%。
- 数据中心内存优化:Argon 代理分析全网性能数据,自动识别并实施优化方案。上线后已释放超 300 TiB 内存,预计总节省量达 500 TiB 到 1 PiB。
- C/C++ 向 Rust 迁移:参与 re2、libgav1 等核心库的重写,并延伸至 Fuchsia Zircon 内核(超 80 万行代码)。所有改动仍需经过自动化审计、人工评审和仿真测试。
在开源视频解码器 libgav1 项目中,Argon 重写了约 3.2 万行 SIMD 代码。新 Rust 版本在保持视频输出一致的前提下,运行速度达到原 Rust 版的 2.7 倍。
网络安全:首批落地场景
网络安全是 Argon 首批重点落地的领域。Google 称,该模型能自主发现、验证并修复关键软件漏洞。
网络安全公司 Wiz 已通过「Scan for Good」计划使用 Argon,为公共基础设施免费排查高风险暴露面。其中一个案例是:Argon 发现了一个影响全球医院医疗软件的严重漏洞,可能泄露患者敏感信息——而此前的前沿模型都没识别出这个风险。
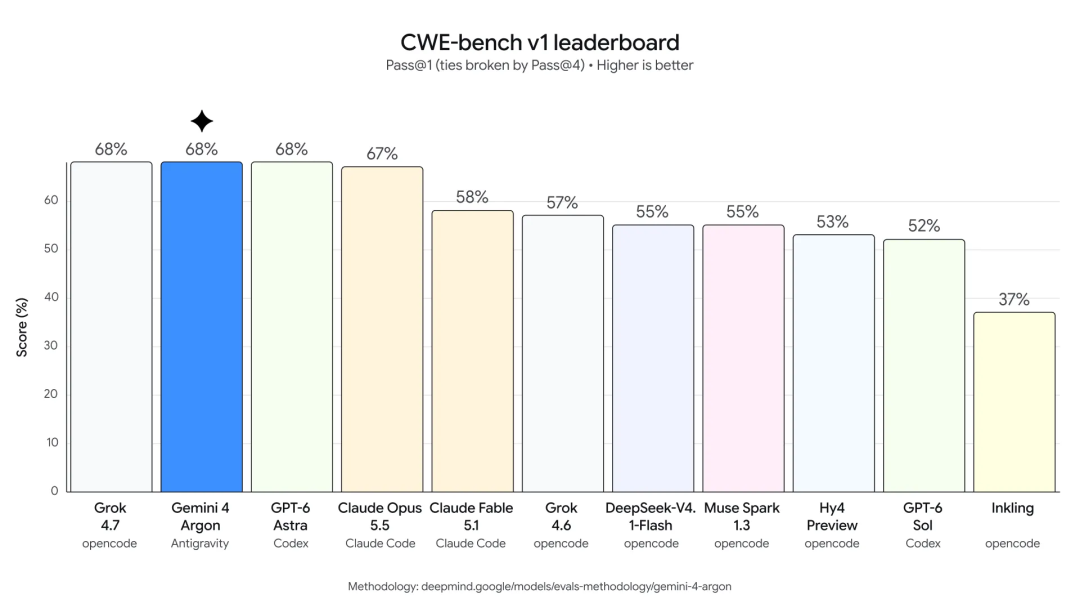
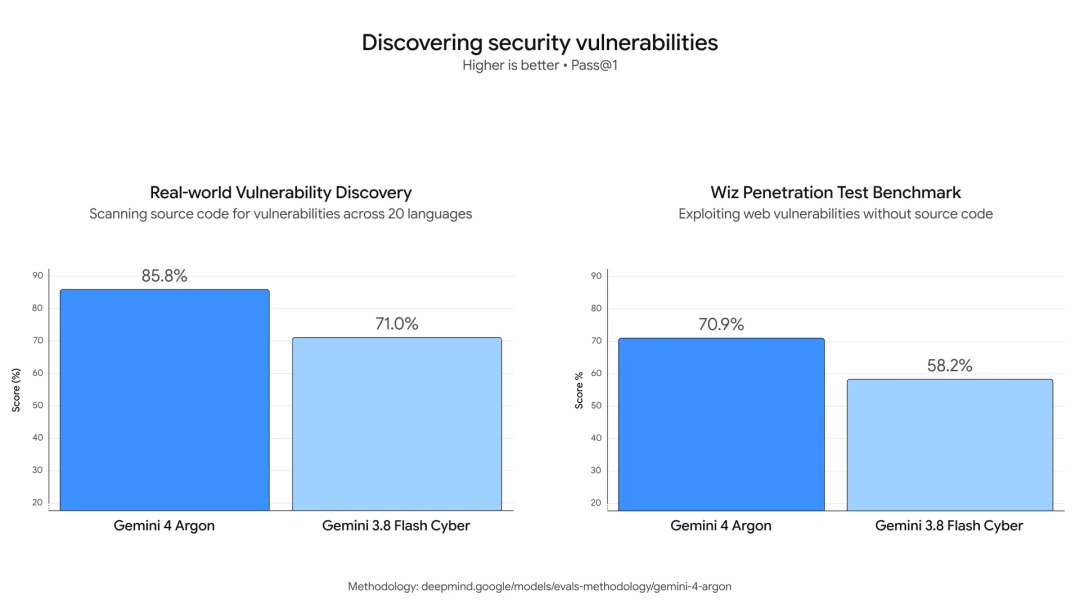
在 CWE-bench v1(漏洞修复评测)中,Argon 以 68% 的成绩并列第一。在 Google 内部覆盖 20 种语言的漏洞测试,以及无源码的黑盒渗透测试中,它也优于上一代 Gemini 3.8 Flash Cyber。
安全机制同步升级
随着能力变强,滥用风险也在上升。Google 对 Argon 增加了多层防护:
- 明确限制网络攻击、化学、生物、放射性和核相关请求
- 通过内部激活监测、自动化红队测试和人工评估识别潜在风险
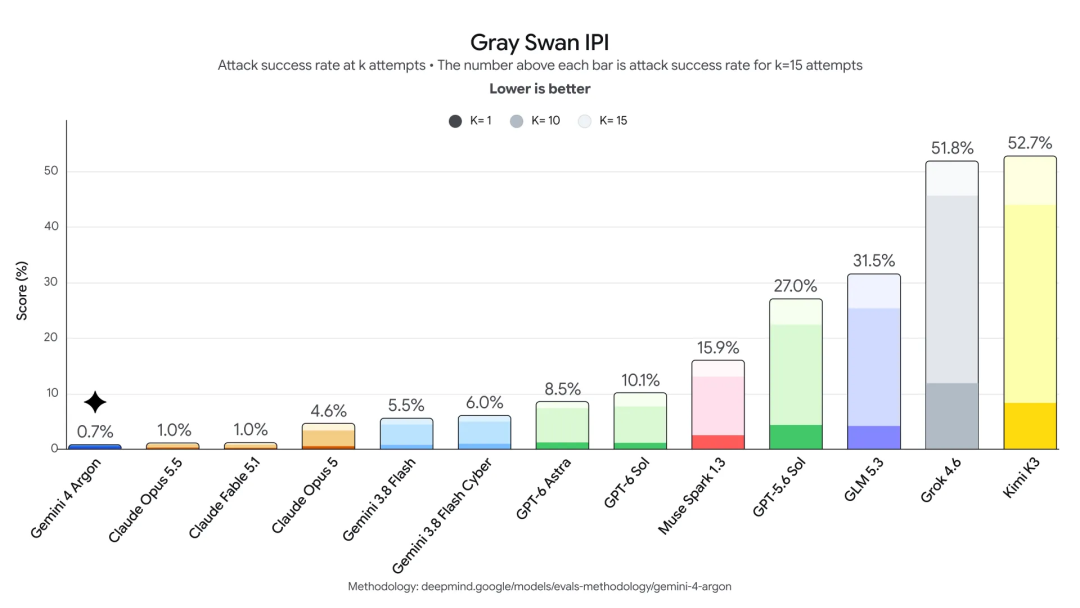
- 针对间接提示注入攻击,采用对抗训练和自动化测试提升鲁棒性
- 部署模型失配监控,跟踪推理过程与行动轨迹,必要时中止任务
- 对高风险训练和评测环境进行隔离
这些措施说明 Google 意识到,越强大的模型越需要精细的安全控制。
内部质疑:评测高分 ≠ 实战好用
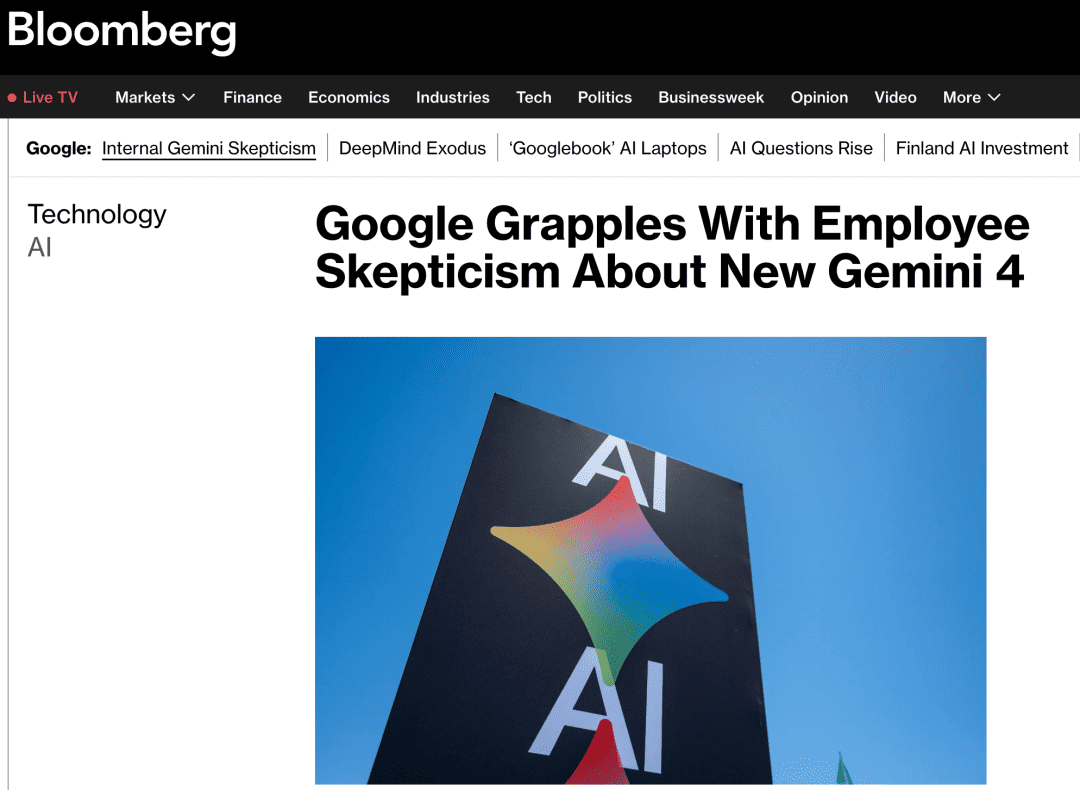
但高分不代表一切。彭博社援引知情人士称,Google 内部对 Gemini 4 在编码等关键任务中的实际表现仍有疑问。
有员工反馈,尽管模型在行业基准测试中亮眼,但在真实开发环境中,部分编码任务依然难以稳定完成。比如生成的代码可能逻辑正确但性能差,或者在复杂依赖下出错。
这其实不意外。评测往往基于标准化任务,而现实工程充满模糊需求、历史债务和非结构化上下文。Argon 能否真正扛起“长周期复杂工作流”的大旗,还得看更多真实场景的反馈。
分阶段开放:先给可信伙伴
Argon 不会立刻全面开放。Google 将通过 Fairwind Program,首批提供给受信任的网络安全防御者。这些早期用户将帮助评估模型表现,并完善安全机制。
Google 还表示,公司正在参与美国政府推动的模型预发布自愿流程,配合监管审查。
完成早期测试后,Argon 将逐步向三类用户开放:
- 付费 API 客户
- Google AI Ultra 订阅者
- 最终可能面向普通消费者(时间未定)
定价策略:缓存输入便宜 95%
API 定价方面,Argon 初始价格为:
- 输入:每百万 Token 2 美元
- 输出:每百万 Token 10 美元
值得注意的是,缓存输入 Token 的价格比标准输入低 95%。这意味着如果用户重复提交相同或相似的上下文(比如在迭代调试时),成本会大幅下降。这对企业级长周期任务是个利好。
真正的考验才刚开始
Gemini 4 Argon 的技术参数确实亮眼,尤其是 100 万 Token 输出上限和多项专业评测第一。它已经在 Google 内部承担起量子计算优化、内存节省和代码迁移等硬核任务,证明了一定的实用性。
但彭博社报道的内部质疑也提醒我们:模型在实验室和在真实工作流中的表现,可能隔着一条鸿沟。企业用户要的不是“能生成百万字”,而是“能可靠地完成一个复杂任务而不翻车”。
Argon 能否跨越这条鸿沟,Fairwind Program 的早期反馈将是关键信号。对开发者和企业来说,不妨保持关注,但别急着押注——毕竟,再强的模型,也得经得起每天八小时的真实折腾。