国产AI Agent为何被指\'差口气\'?从技术代差到商业闭环的深度复盘
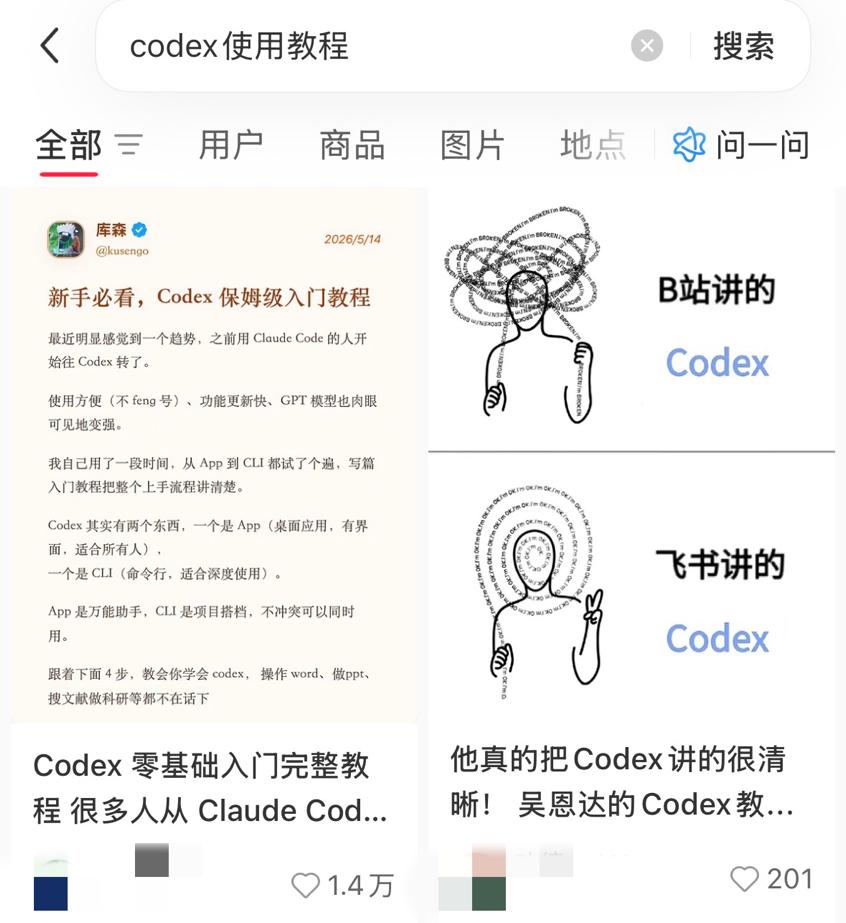
当社交媒体上充斥着“Codex保姆级教程”或“Claude Code环境配置”的热搜时,一个看似悖论的市场现象赫然显现:在国内大模型内卷激烈、用户日活数亿、API调用价格低至“白菜价”的背景下,大量中国用户依然愿意承担高昂的时间成本和网络门槛,甚至支付不菲的订阅费,去追逐海外的AI Agent产品。这种隐秘而庞大的流量外溢,迫使我们要冷静审视一个核心问题:在大模型迈向Agent(智能体)的深水区,国产AI究竟“差”在哪里?是刻板印象,还是确实存在难以忽视的代差?
要回答这个问题,首先必须客观承认,过去三年国产大模型并非全面落后,而是在特定维度实现了强势超车。语言不仅是符号,更是文化、思维与商业逻辑的载体。在处理中文语境时,GPT-5或Claude Opus等海外顶尖模型虽能流利对话,但在深度创作、职场人情世故或本土化商业文案中,往往暴露出“翻译腔”和线性叙事的不适感。相比之下,得益于海量本土高质量语料的喂养和互联网生态的深度融合,国产模型在拿捏微妙的语感、网络热梗及复杂中文逻辑上,拥有得天独厚的优势。
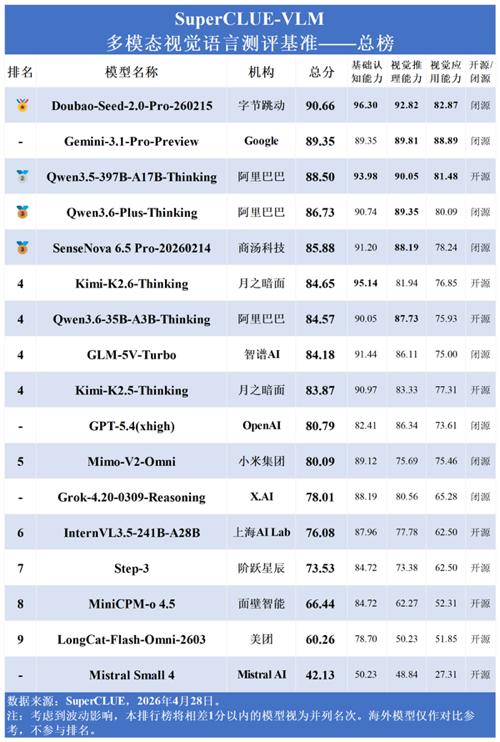
在SuperCLUE-VML等权威评测中,字节跳动、阿里Qwen3.5、商汤SenseNova及智谱GLM等国产模型在中文多模态视觉语言理解上频频登顶,超越部分海外知名模型。此外,在超长文本处理和代码推理等硬核能力上,国产基座同样具备强劲竞争力。Kimi将无损上下文解析推至200万字级别,通义千问Qwen3-Max更达到1000万字,能够一次性吞吐数十页深度研报或法律卷宗并进行精准信息抽取。而在代码领域,DeepSeek V4 Pro、豆包2.1 Pro等国产势力在Terminal Bench、SWE-Pro等九大权威评测中,多项指标已超越Anthropic的Claude Opus 4.7,全面进入第一梯队。
然而,当AI Agent的边界从纯文本向物理世界和多媒体视觉延伸时,国产模型的短板便暴露无遗。多模态能力的“偏科”成为了用户感知落差的第一层。今年4月,OpenAI发布的GPT Image 2在文生图排行榜以碾压级优势领先,其不仅画面质感出色,更能自主进行任务拆解、布局规划及自我复核,甚至直接生成准确的中文排版。反观国内主流模型,在画面物理规律模拟、空间一致性上仍存在明显缺陷。对于旨在接管复杂工作流的未来Agent而言,视觉皮层和物理常识的缺失,意味着其在理解图形用户界面、处理跨软件视觉输入及驱动具身智能时,将面临根本性障碍。
除了底层技术的长短板,海内外大厂在推动AI落地时的战略路线分野,更造就了截然不同的用户体感。海外巨头如OpenAI和Anthropic,其愿景始终指向通用人工智能(AGI)。在他们的蓝图中,Agent不仅是网页里的问答机器人,更是具备高度自主思考能力、能使用人类一切数字工具的“硅基协同者”。
以Codex为例,它不再依赖API接口,而是通过强大的视觉多模态能力直接“看懂”屏幕像素,像人类一样移动鼠标、点击图标、输入指令。当用户下达涵盖数据整理、分析及发送文档的复杂指令时,Codex会在桌面上自动开启软件、调取数据、处理信息并发送邮件,实现端到端的全自动闭环。这种路线让用户感知到的是能探讨底层架构、自主规划链路甚至拥有独立反思纠错能力的“数字协作者”。OpenRouter数据显示,2026年5月,具备自我反思机制的Hermes Agent单日Token消耗量高达2910亿,证明大量用户正在深度使用这类能执行深链路任务的Agent。
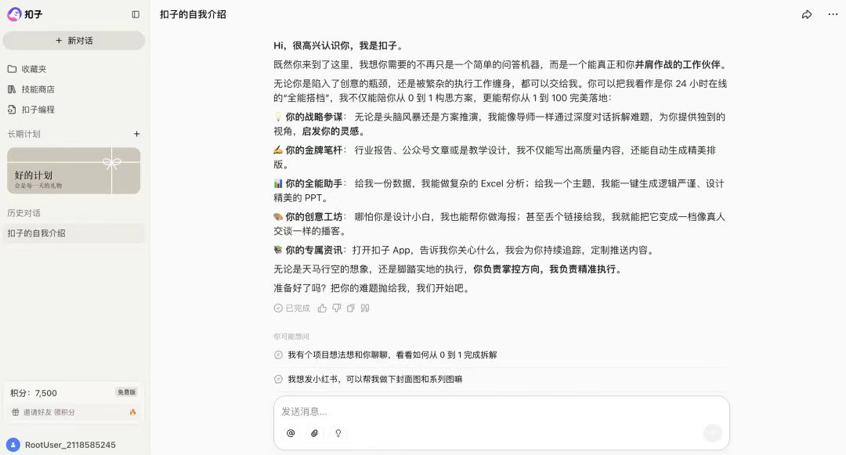
反观国内,大厂依托微信、飞书、抖音等独特生态,从一开始就将Agent定位聚焦于商业化效率工具。字节跳动的扣子拥有超2000个官方插件,可视化工作流极佳,让零基础用户也能搭建Bot;腾讯WorkBuddy接入8万+技能包,深度打通企业微信与腾讯文档。这些产品在电商、营销、公文写作等ToB场景下,能将重复性劳动力压缩到极致。但其产品形态仍未脱离聊天框范畴,面对跨越多个本地软件的复杂系统级任务时,无法像Codex那样直接接管鼠标执行,仅提供建议或代码支持。用户期待的是能完成繁杂底层操作的“深度合伙人”,得到的却是只能在特定网页里读文档的“实习生助理”。
技术和路线的差异,最终需在商业世界中进行结算。决定Agent智能上限的终极因素,隐藏在服务器的算力账单中。一个成熟的Agent后台至少包含任务规划、执行、状态与上下文记忆、校验与回滚四个层级,每运转一次都消耗海量Token。看似简单的代码除错,后台可能已进行数十次自我博弈和API调用。
在算力疯狂消耗的前提下,海外成熟的软件付费生态成为支撑Agent“深思熟虑”的底气。C端ChatGPT Plus和Claude Pro订阅费高达20美元/月,仍吸引大量用户,截至2026年3月,ChatGPT周活跃用户破9亿,付费用户约5000万。Anthropic年化运行收入较2025年底增长近五倍,核心驱动力正是Claude Code及企业端需求。高客单价让厂商敢于敞开供应算力,保障长程记忆管理和多轮纠错的高稳定性。
而国内为了争夺C端流量,头部大厂Agent应用几乎清一色采用免费或低价模式。2026年4月,DeepSeek将V4-Pro输入价格打至3元/百万Token,输出仅为6元/百万Token,约为GPT-4o价格的十二分之一。即便推进收费的豆包专业版,月费也仅为68元,学生价更是低至38元。
产品客单价被极限压低,甚至无法覆盖Agent推理成本,迫使国内厂商在后台进行工程上的算力妥协,大幅缩减中长期记忆保留轮次。缺乏后台验证纠错机制的Agent,面对错误代码或数据时,不再反复重试,而是用笃定语气输出错误结论,甚至胡言乱语。
因此,进入Agent时代,国内产品的口碑落差并非纯粹的算法局限,而是交织着技术偏向、路线局限及商业模式限制的系统性问题。斯坦福大学《2025人工智能指数报告》指出,中美顶尖大模型性能差距已由2024年1月的9.3%收窄至2025年2月的1.7%。技术硬件上的差距正在缩小,但软件生态与商业模式的鸿沟依然宽阔。
未来,国产Agent若想真正抹平这“最后一公里”的体验代差,关键在于探索从业务流到商业闭环的重构路径。建立健康的商业模式以支撑巨大的算力消耗,让国产AI Agent挣脱低价甚至免费的桎梏,蜕变为真正的“数字合伙人”,而非仅仅是廉价的效率插件。这不仅是技术的胜利,更是商业逻辑的重塑。只有在尊重算力成本、鼓励深度付费的生态中,国产AI才能激发出真正的智能潜能,实现从“能用”到“好用”、从“工具”到“伙伴”的跨越。