具身智能数据泡沫真相:融资狂欢背后的三重错位与洗牌前夜
在2026年的科技版图中,具身智能(Embodied AI)正站在聚光灯的中心。然而,与春晚舞台上翩翩起舞的机器人或实验室里叠衣如飞的机械臂相比,真实应用场景下的频频翻车,暴露出一个被长期忽视的核心痛点:数据荒漠。LLM(大语言模型)拥有数十万亿Token的预训练语料,自动驾驶积累百亿小时的路测数据,而具身智能领域,公开可用的操作数据仅停留在几十万小时的匮乏阶段。这种巨大的反差,不仅催生了独立的“数据基建”赛道,更引发了一场资本密集涌入却暗藏巨大泡沫的行业狂欢。
当前,具身智能的数据供给已成为制约本体出货与模型泛化的最大瓶颈。投资人天机辩指出,VLA(Vision-Language-Action)大模型的泛化能力已触及天花板,数据质量成为决定机器人“大脑”上限的关键变量。与此同时,本体厂商的出货节奏意外加速,导致数据需求从早期的研发探索阶段,迅速跃升为量产必备的生产要素。过去半年,光轮智能估值突破20亿美元,简智机器人获得蚂蚁、滴滴等巨头投资,觅蜂科技从智元孵化后迅速融资数亿元,这些现象标志着数据已从训练环节的辅助变量,跃升为具有极高商业价值的独立资产。
具身智能数据的稀缺性,根源在于其“动作闭环”的复杂性。与大模型只需处理文本或图像不同,机器人需要掌握“看到什么-做什么-力度多大-关节如何运动”的完整物理交互信息。互联网上几乎不存在此类结构化数据,必须通过特定手段“制造”。目前行业形成了四条主要的数据采集路线,各自在成本、保真度与规模化潜力上各有优劣,头部玩家通常采取多线并行的策略以规避单一技术风险。
真机采集被视为数据质量的黄金标准。通过操作员佩戴VR/AR头显同步视觉画面,直接控制机器人本体动作,这种方式产出的数据可直接用于训练高精度VLA模型。智元、优必选等头部厂商及灵御智能均押注此路线。然而,高昂的成本是其主要障碍。以特斯拉Optimus为例,数据采集员时薪高达25-48美元。此外,长时间佩戴VR设备导致的高晕眩率,以及操作员对空间距离判断的主观误差,使得废片率居高不下,数据普遍利用率仅在60%-70%之间。尽管国内部分企业尝试“人臂同构”设计以降低门槛,但这种妥协牺牲了机器人的超人性能,导致数据难以覆盖狭缝钻探等复杂场景。
无本体采集路线则试图通过“动作重定向”来降低成本。代表方案包括UMI通用操纵接口和动作捕捉设备。前者通过手持特制夹爪记录轨迹,后者穿戴动捕设备记录全身运动。觅蜂科技、简智机器人等公司在此领域表现活跃。该路线成本约为真机遥操的一半,但其局限性同样显著:人手无法感知力矩变化,导致模型在面对拧瓶盖、插USB等需要精细力度控制的场景时,往往出现“动作正确但力度失衡”的现象。同时,人类动作向机器人关节空间的映射存在大量信息丢失,影响了数据的泛化能力。
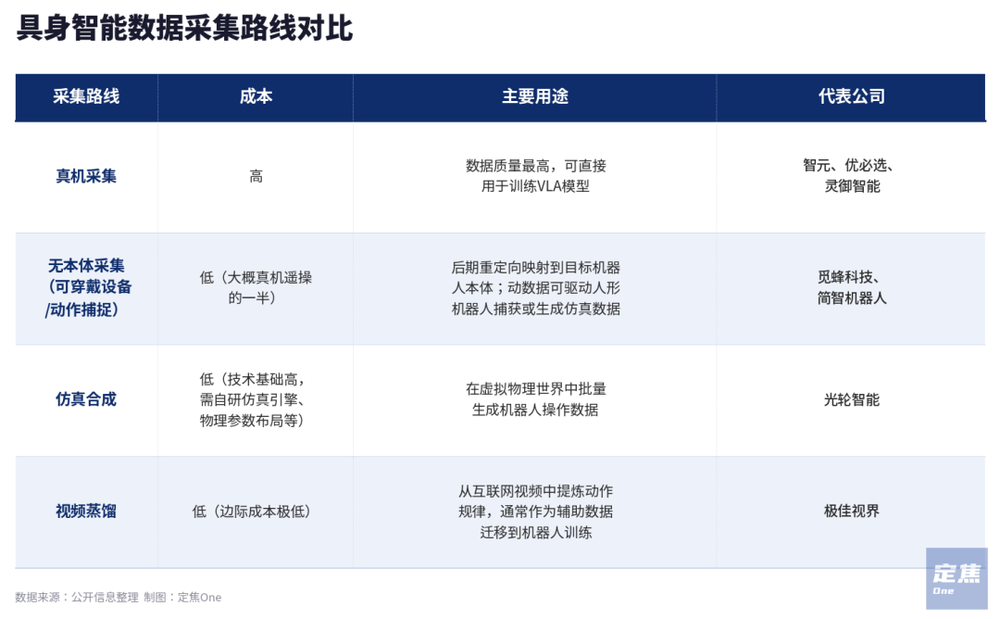
仿真合成数据近年来受到资本青睐,特别是像光轮智能这样自研仿真引擎的企业。通过模拟虚拟物理世界,可以批量生成海量操作数据。光轮智能累计交付超100万小时人类行为数据,复售率超过10倍,确立了其在仿真领域的规模优势。然而,仿真与现实之间的“Reality Gap”仍是难以逾越的鸿沟。真实世界中物体的重量、摩擦系数、表面湿度等变量极其复杂,固定参数的仿真模型难以完全复现这些细微变化,导致训练出的模型在真实环境中容易失效。因此,仿真数据目前更多扮演辅助角色,需配合真机数据进行校准。
视频蒸馏作为一种新兴路线,正迅速崛起。极佳视界等公司利用世界模型技术,从Ego4D、YouTube等互联网视频源中提取第一人称或第三人称操作视频,反推结构化动作数据。这种方式边际成本极低,数据量极大,且能提炼出通用操作规律。例如,从拧瓶盖视频中提炼出“特定角度施加特定力矩”的通用法则。尽管视频缺乏关节角度等底层动作细节,且人手与机械臂结构差异巨大,无法直接用于端到端训练,但其作为辅助数据的价值日益凸显。近期极佳视界数月内融资35亿元,估值达百亿级别,正是市场对这一技术路线看好的体现。
尽管数据生产路线日益多元化,但商业变现之路却充满不确定性。据天机辩调研,国内具备持续采购能力的客户寥寥无几,主要集中在机器人本体厂商、具身模型团队及科研机构。更严峻的是,客户付费意愿极不稳定。本体厂商采购外部数据多出于“自救”心态,一旦内部采集体系跑通,外部采购需求将大幅收缩。
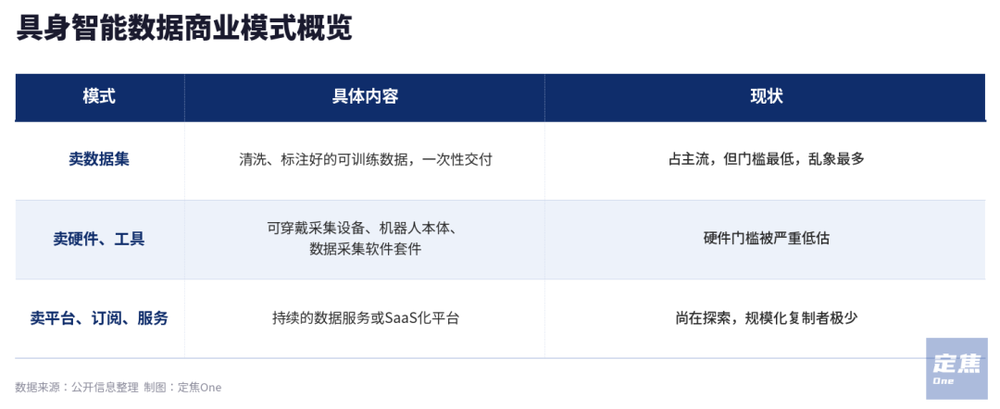
目前的数据商业模式主要分为三类,且护城河各异。一次性买断数据集仍是主流,但这种模式门槛低、易复制,导致小团队通过低成本改装设备涌入市场,数据质量参差不齐,行业陷入低价内卷。卖硬件模式虽然壁垒较高,但面临客户“买后自用”的风险。卖平台与订阅服务壁垒最高,但依赖于客户形成规模化数据消耗习惯,目前市场尚未成熟,仅有少数公司在探索。形芯智能副总裁朱军透露,行业最大成本在于人力而非算力,毛利率普遍不高,长期目标是通过绑定客户迭代需求,从一次性销售转向持续服务。
在这种背景下,数据公司的估值却呈现出非理性的飙升。光轮智能单季度新增订单5.5亿元,成为行业定价的风向标。投资人不再关注传统的PE或PS指标,而是基于“单客户价值×潜在客户数×数据壁垒系数”进行估值。这种逻辑导致部分年收入仅几百万的公司估值达到数亿,形成了明显的估值泡沫。
行业共识的缺失进一步加剧了市场的不确定性。与自动驾驶在2018年确立激光雷达+摄像头融合主流方向不同,具身智能在采集路线、数据格式上缺乏统一标准。不同本体的关节配置、传感器布局差异巨大,导致训练好的模型难以跨本体迁移。虽然海外的Skild AI和国内的蚂蚁灵波都在推动跨本体通用模型,但实际落地仍需针对具体机型进行微调,技术门槛依然高企。
头部数据公司正试图通过制定规则来确立地位。光轮智能推出RoboFinals评测平台,觅蜂科技主推MEgo硬件与全范式平台,简智机器人聚焦工业级数据格式。然而,规则制定的本质是利益分配。本体厂商不愿将生态“收费站”交给第三方,担心形成依赖;而第三方公司若无法获得广泛认可,其制定的标准将沦为孤岛。
具身智能数据行业目前正经历三重错位的冲击。第一,行业高喊数据为核心,但客户普遍压低预算,不愿为高质量真机数据支付溢价。第二,赛道玩家扎堆做同质化的仿真数据,依赖低价内卷维持生存。第三,资本疯狂追捧,但行业整体复购率偏低,多数团队仅靠融资输血,缺乏稳定的商业化订单。
回顾自动驾驶的发展轨迹,两者均经历了“先有标注公司、后有数据平台、最后内化”的过程。但具身智能的场景更为碎片化,工厂、家庭、手术室的数据分布差异极大,数据稀缺性将比自动驾驶更持久。同时,由于机器人出货量尚未达到爆发规模,独立数据公司的窗口期虽长,但商业化节奏更慢。
未来一年,行业将从“拼融资”转向“拼客户”。那些只有概念、没有订单、无法解决跨本体迁移难题的数据公司将被迅速淘汰。真正具备数据生产闭环能力、掌握客户资源并能在标准化进程中占据话语权的玩家,有望成为物理AI时代的“数据基础设施”。这场从资本泡沫到商业实质的回归,将是具身智能走向成熟必过的炼狱。