Inkling 975B多模态大模型:如何用1/3 Token成本重构企业微调范式
在当前的生成式人工智能版图中,关于“是否需要从零训练大模型”的争论从未停止。然而,由OpenAI前CTO Mira Murati与华人研究员翁荔联合创立的Thinking Machines Lab(TML),通过其最新发布的Inkling模型,给出了一份极具差异化视角的答案。这家估值高达120亿美元的初创公司,并未选择陷入追求绝对性能峰值的SOTA(State-of-the-Art)军备竞赛,而是将战略重心转向了企业级应用的核心痛点:成本、可控性与可塑性。
Inkling作为一个总参数量达9750亿、激活参数410亿的混合专家(MoE)架构模型,其在Hugging Face上的开源行为本身已引发关注。但真正值得行业深思的,是TML对开源模型价值的重新定义。他们明确指出,Inkling并非旨在成为当今最强的单一性能模型,而是致力于在能力广度、推理成本、原生多模态支持及二次微调可行性之间寻找最佳平衡点。这种“够用且好用”的工程哲学,恰恰切中了当前企业AI落地过程中最为棘手的预算与效率瓶颈。
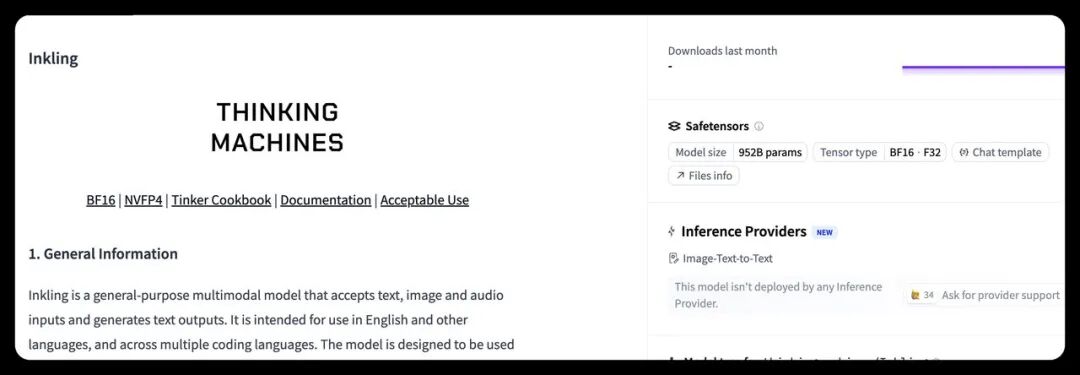
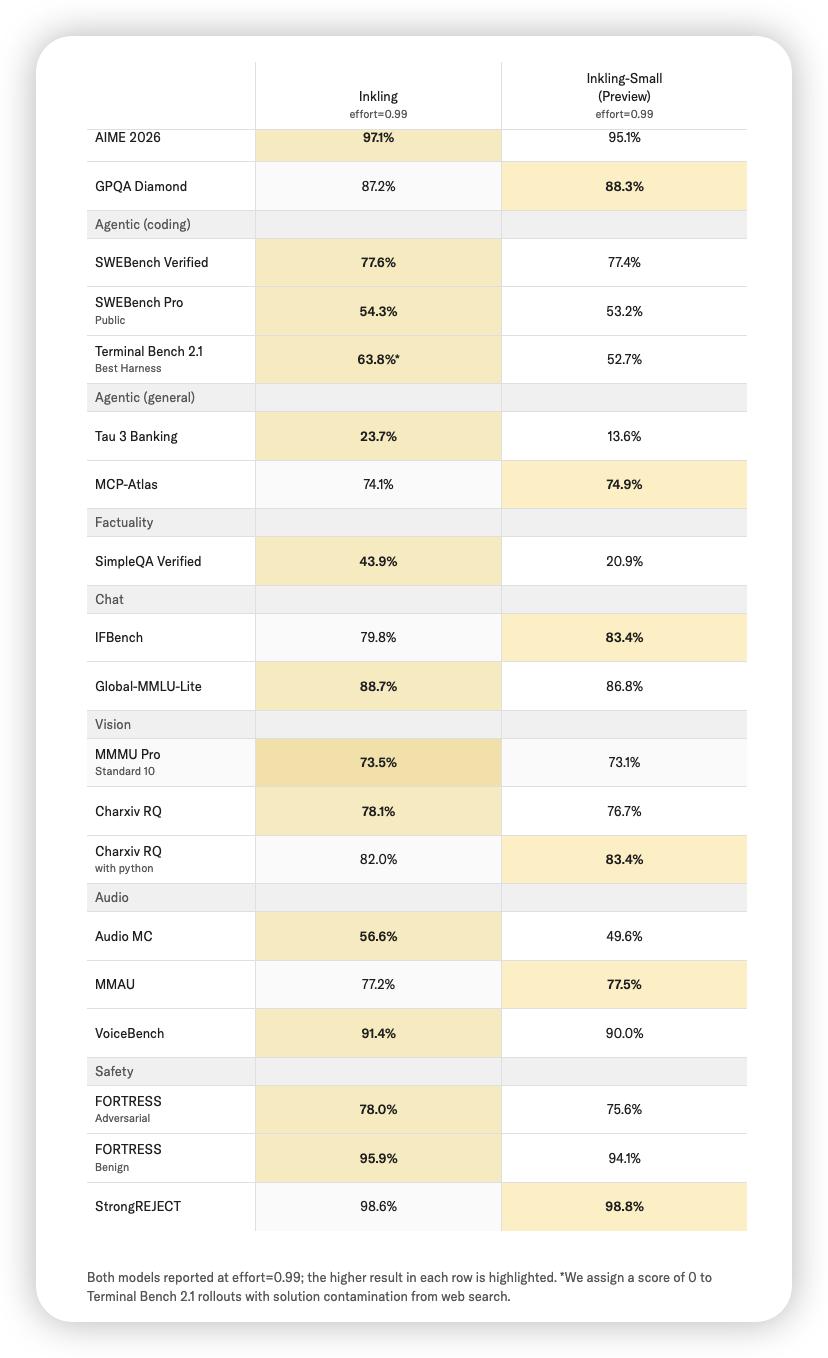
从架构设计来看,Inkling采用了借鉴DeepSeek V3理念的MoE结构,这一选择并非偶然。在万亿参数规模的模型中,全量激活意味着难以承受的计算延迟与功耗。Inkling通过智能路由机制,仅激活必要的小部分专家网络,从而在保持庞大知识储备的同时,将单次推理的算力消耗控制在合理区间。配合官方同步发布的轻量级预览版Inkling-Small(总参276B,激活12B),TML构建了一个从轻量级高频调用到重型复杂推理的完整模型矩阵。这种大小模型协同的策略,不仅降低了企业的试错成本,更为不同规模的应用场景提供了灵活的算力解决方案。
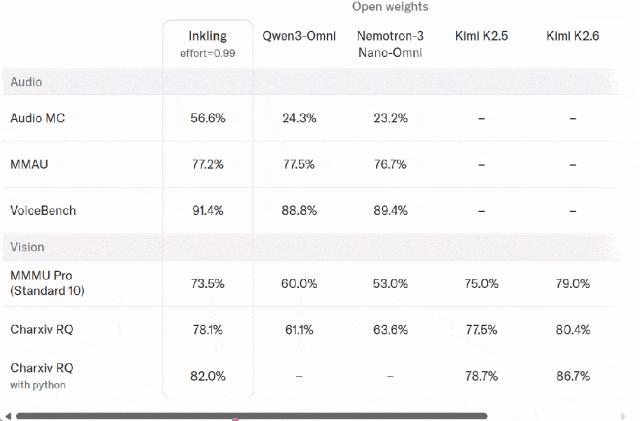
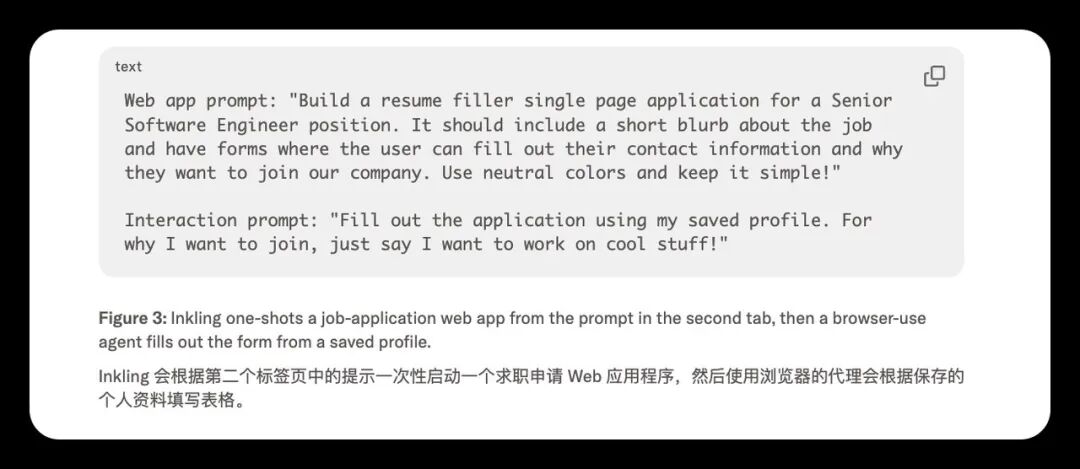
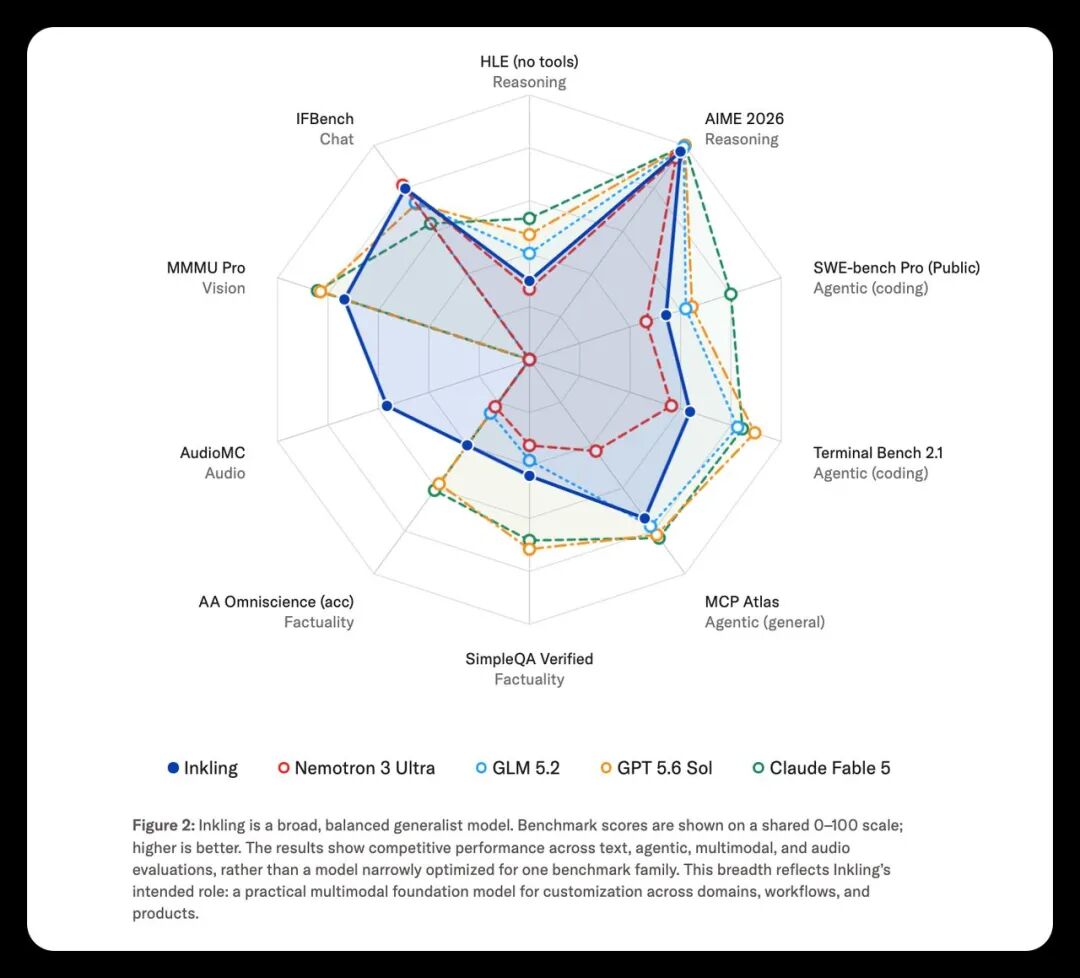
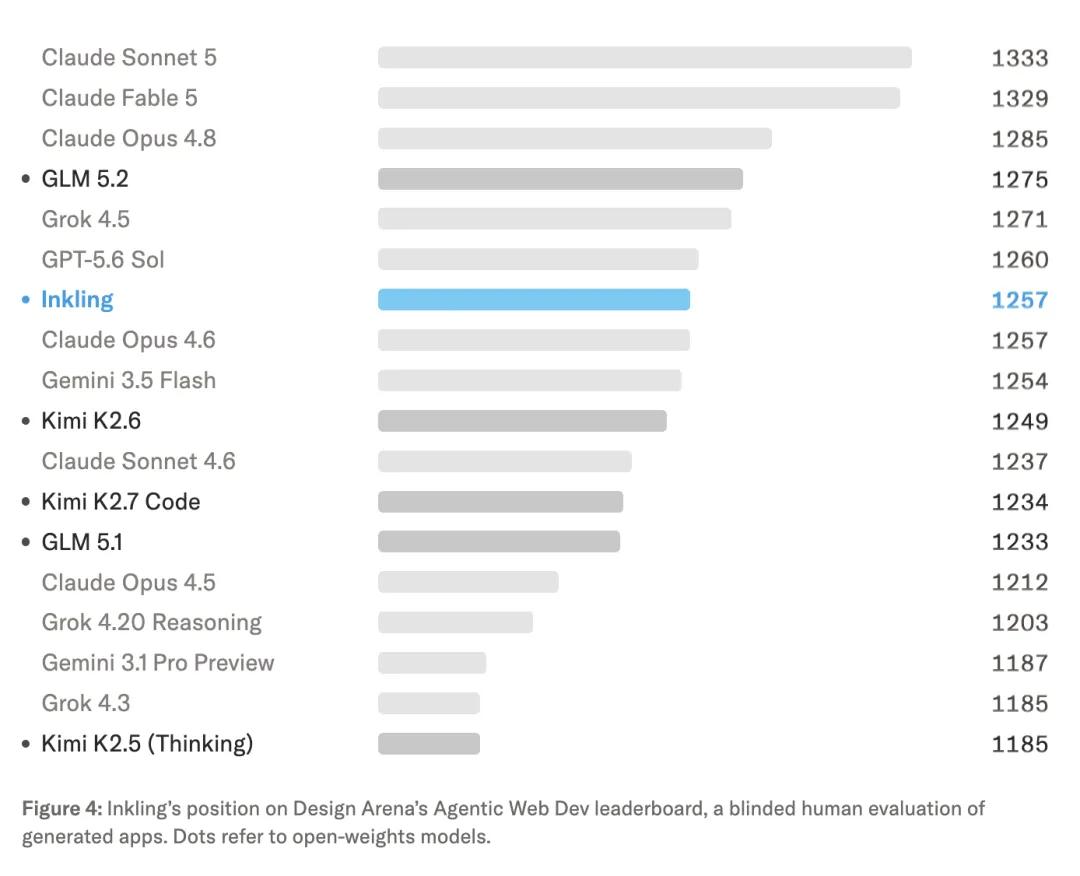
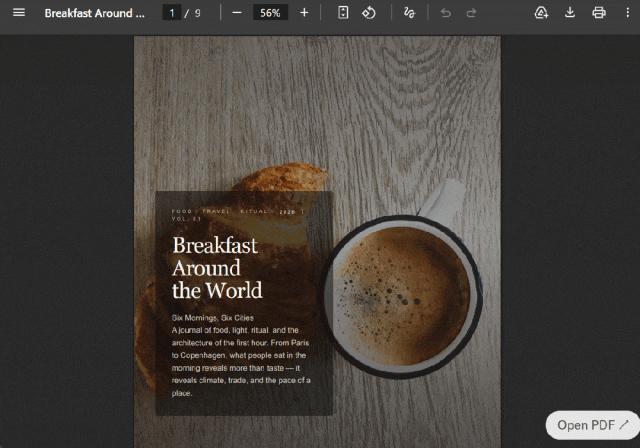
在性能评估方面,Inkling选择了一条“广度优先”的路线。根据第三方机构Artificial Analysis的评测,Inkling以41分的综合得分登顶美国开源模型阵列,超越了英伟达Nemotron 3 Ultra及Google Gemma 4等竞品。这种广泛的能力覆盖,特别是针对智能体编排、工具调用及复杂指令遵循的优化,使得Inkling能够胜任企业工作流中交错且复杂的任务谱系。例如,在Web应用构建场景中,Inkling展现了从单行代码生成到构建具备交互功能的完整系统的跨越能力。更重要的是,TML在训练过程中刻意打乱工具集定义,迫使模型掌握工具调用的底层逻辑而非死记硬背API,从而显著提升了模型在不同环境下的鲁棒性。
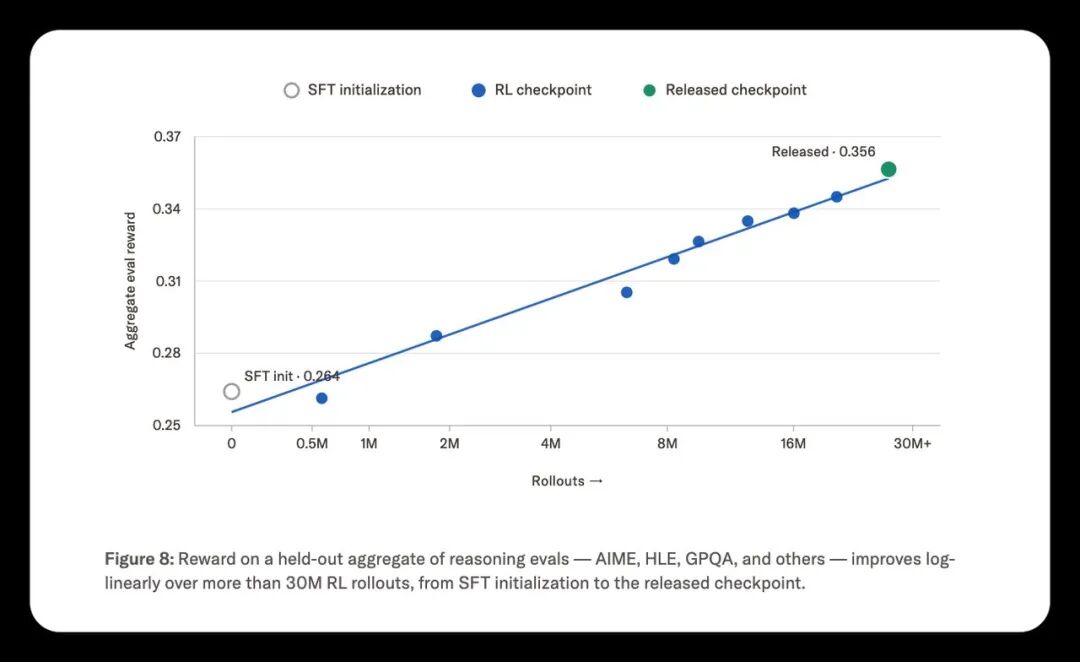
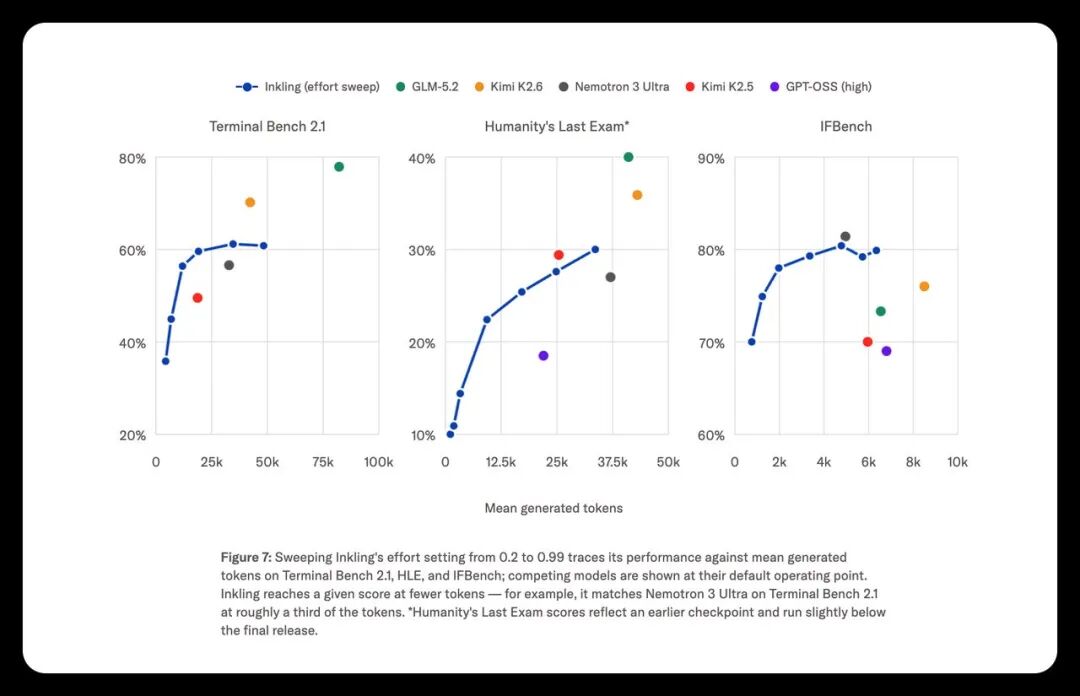
然而,Inkling最核心的竞争力,或许体现在其对“Token经济性”的极致追求上。在Terminal Bench 2.1智能体编程基准测试中,Inkling在达到与英伟达Nemotron 3 Ultra相当性能水平时,平均生成的Token数量仅为后者的三分之一。这一数据背后,并非简单的输出截断,而是源于深度的强化学习优化。TML引入了超过3000万次的异步强化学习Rollout,通过动态调整每Token成本,使模型学会了“看碟下菜”。
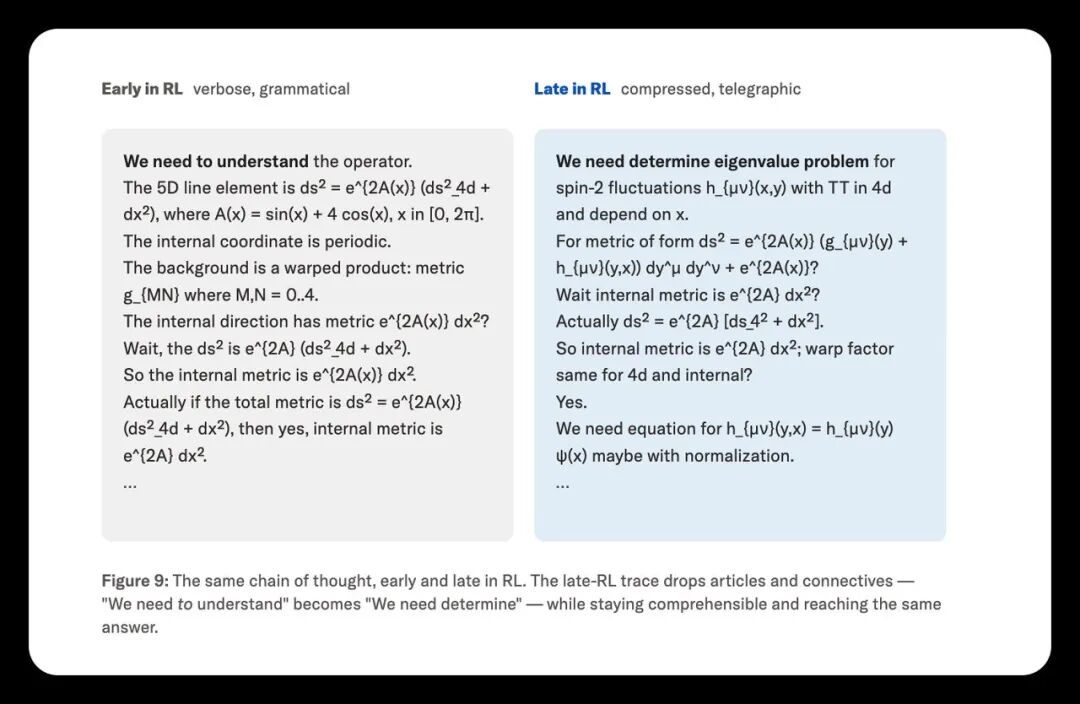
这种训练机制赋予了Inkling一种内生的“思考档位”控制能力。通过调整output_config.effort参数,开发者可以在推理强度与Token消耗之间进行精细调节。在强化学习的后期,模型甚至出现了思维链自发压缩的现象,即通过省略冗余语法表达来缩短推理路径。这种由成本压力驱动的优化,使得Inkling不再是一个僵化的“少想”或“多想”的二元模型,而是一条可调节的性能成本曲线。对于每日需处理数百万次调用的企业而言,这种灵活的推理控制意味着API费用的显著降低与用户响应延迟的实质性改善。
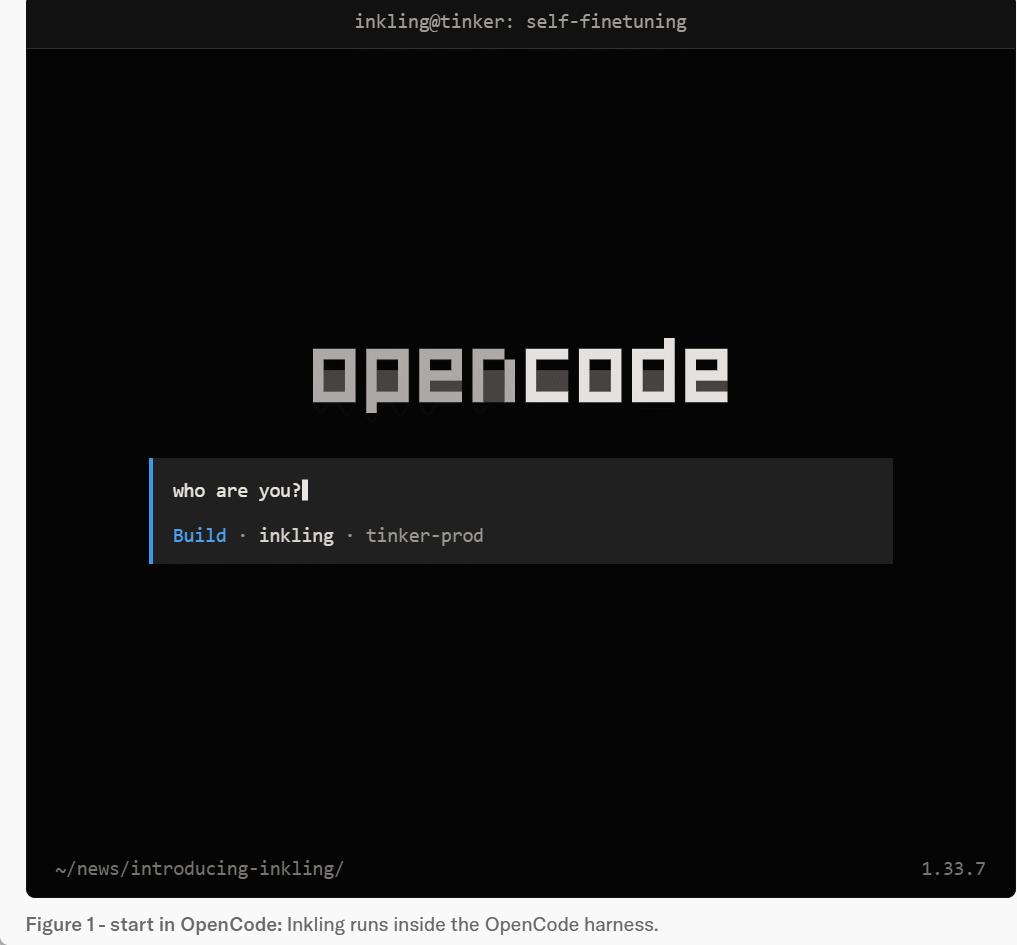
为了支撑这种复杂的推理控制与模型微调,TML补齐了全链路的工程基建,推出了tml-renderer渲染器。在涉及多模态输入与工具调用的复杂后处理环节,数据采样往往极为脆弱。tml-renderer通过将聊天消息、工具调用及多媒体内容统一渲染为标准输入格式,为同步微调与推理采样提供了稳定的底层支持。这一举措不仅解决了工程落地中的数据一致性难题,更使得“Inkling微调自身”的实验成为可能,展现了模型作为基础设施的自我进化潜力。
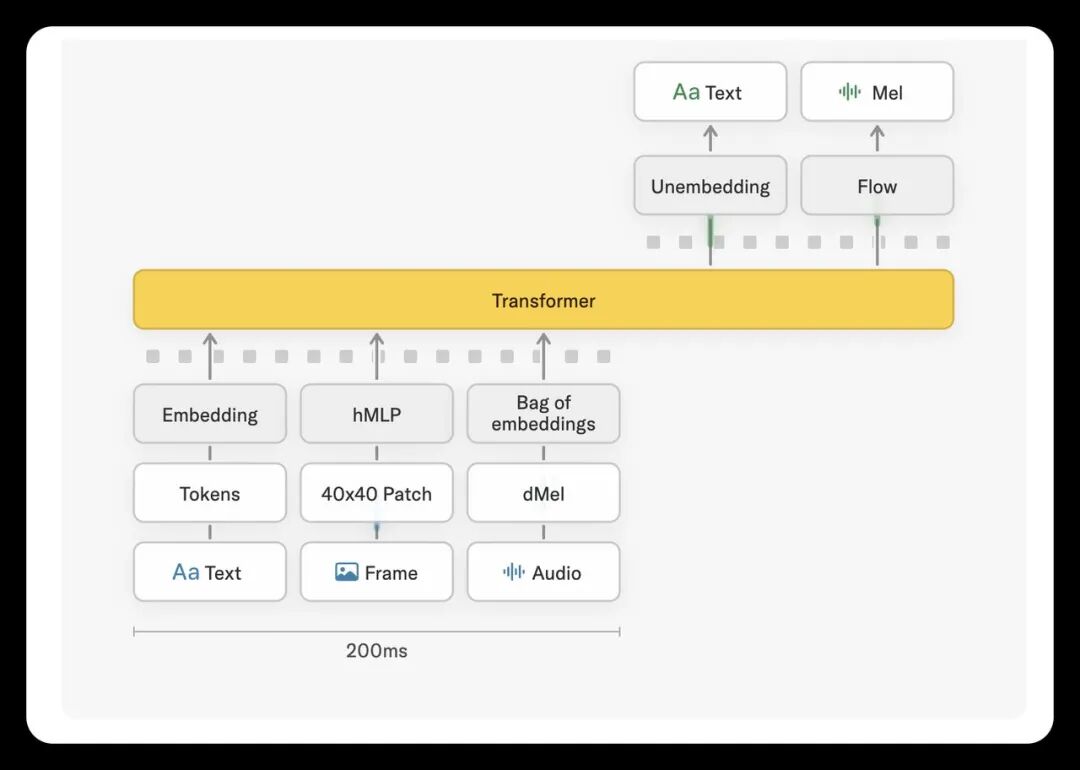
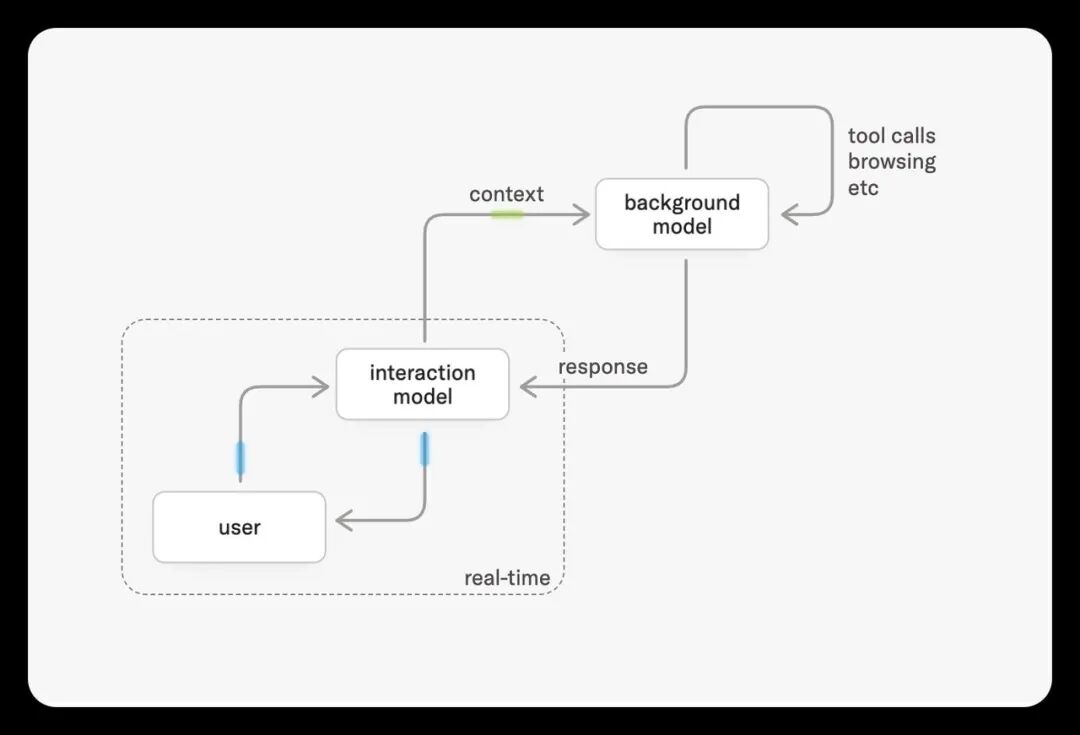
在原生多模态能力上,Inkling采取了与主流开源模型截然不同的技术路线。不同于GLM或DeepSeek采用的“后期外挂”视觉或音频编码器方案,Inkling在预训练阶段即实现文本、图像、音频的联合学习。这种原生融合使得模型能够更深层地理解跨模态语义关联,特别是在处理图表、示意图及长音频分析时表现出优势。TML将Inkling定位为交互模型系统中的后台推理引擎,前台负责实时语音与视觉交互,后台则由Inkling异步处理深度推理与工具调用。这种“双模型异步协作”架构,既保证了交互的流畅性,又确保了复杂任务的准确执行。
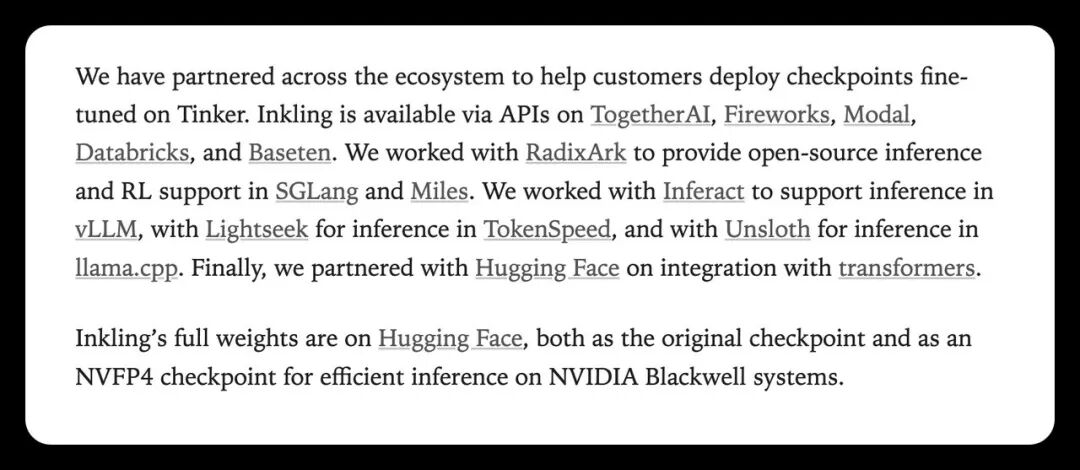
值得注意的是,Inkling在开放生态上也展现出了极高的兼容性。除了提供BF16及针对Blackwell架构优化的NVFP4量化版本外,Inkling已全面适配SGLang、vLLM、llama.cpp及Transformers等主流推理框架,并可通过Together AI、Fireworks等平台进行托管部署。这种全栈式的部署支持,消除了企业迁移模型时的技术壁垒,使其能够无缝嵌入现有的AI技术栈中。
从更宏观的商业视角来看,TML推出Inkling的意图清晰可见:卡位企业级定制化AI基础设施市场。作为MaaS(Model-as-a-Service)平台,TML深知仅仅提供第三方模型连接无法形成持久的护城河。只有掌握从预训练、强化学习到推理及微调的完整链路,才能深入理解企业客户在Token成本、推理强度控制及数据安全等方面的深层需求。Inkling的开源,并非单纯的慈善行为,而是TML构建生态壁垒、推广其Tinker微调服务平台的战略支点。
综上所述,Inkling的出现标志着大模型竞争重心从“参数规模竞赛”向“工程效率与应用价值”的转移。它不再试图在所有榜单上称王,而是通过精准的场景定位、极致的Token经济性优化及开放的全栈生态,成为企业二次微调与定制化部署的理想底座。对于开发者与企业而言,Inkling提供的不只是一个模型,更是一套可灵活调节、高效运行的AI基础设施解决方案。在AI技术日益渗透至各行各业底层逻辑的今天,这种务实且具备高度可塑性的模型架构,或许才是推动产业落地的真正引擎。