从Zig到Rust狂飙百万行:AI重写底层代码的成本与效率革命
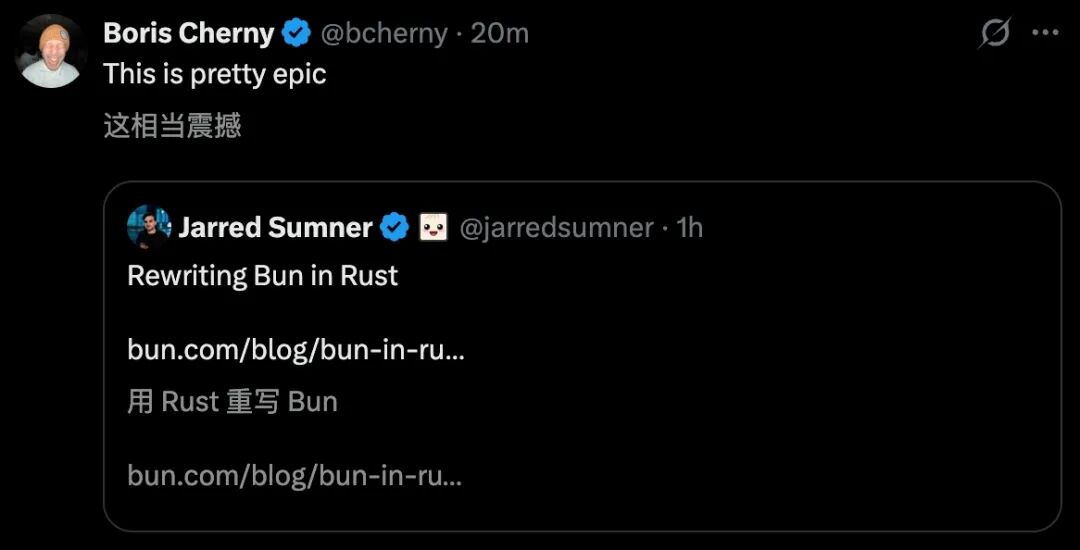
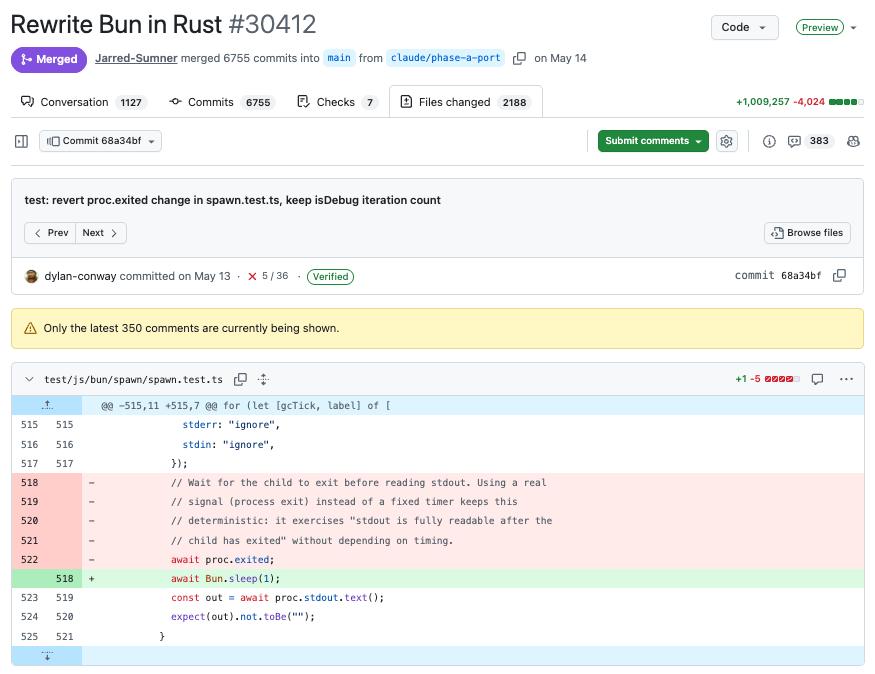
在软件工程的漫长历史中,底层语言的重构往往被视为开发者心中难以逾越的“天堑”。这不仅是因为底层代码的复杂性,更因为其牵一发而动全身的风险性。然而,2026年的今天,这种认知正在被大语言模型(LLM)迅速重塑。Bun项目的创始人Jarred Sumner近期完成了一项令人震惊的工程壮举:利用Anthropic的Claude Code,在短短两周内,将Bun运行时的核心部分从Zig语言彻底迁移至Rust,生成了超过一百万行的新代码。这一过程不仅颠覆了传统开发周期的预期,更以仅16.5万美元的API成本,对比此前四年、300万美元的人工投入,展示了AI在大规模代码重构中的压倒性优势。
技术债的偿还与架构演进的必然
Jarred Sumner在早期选择Zig语言作为Bun的底层实现,初衷极为纯粹:追求极致的简洁性,以榨取媲美C语言的性能。这种策略在Bun发展的初期阶段,确实帮助这位独立创始人在资源有限的情况下,快速构建出比Node.js更快的JavaScript运行时。然而,随着Bun生态的爆发式增长,其CLI月下载量突破1000万大关,甚至成为Claude Code底层的重度依赖组件,早期为了简洁而埋下的技术隐患逐渐显现。
内存安全性是Zig与Rust之争的核心议题。随着用户规模的扩大,潜在的内存错误带来的安全风险和维护成本呈指数级上升。对于一家高速发展的项目而言,不再仅仅追求“快”,更需确保“稳”。于是,将底层迁移至具备内存安全保证的Rust,成为必须偿还的“技术债”。这一决策在传统开发模式下,意味着至少需要数年时间、庞大的工程团队以及极高的试错成本。但在AI工具的介入下,这一过程被压缩至两周以内,且合并前通过所有原有测试用例,合并后修复的19个回归问题也迅速解决,最终随Claude Code一同悄悄上线。
六步框架:从“修代码”到“修流程”
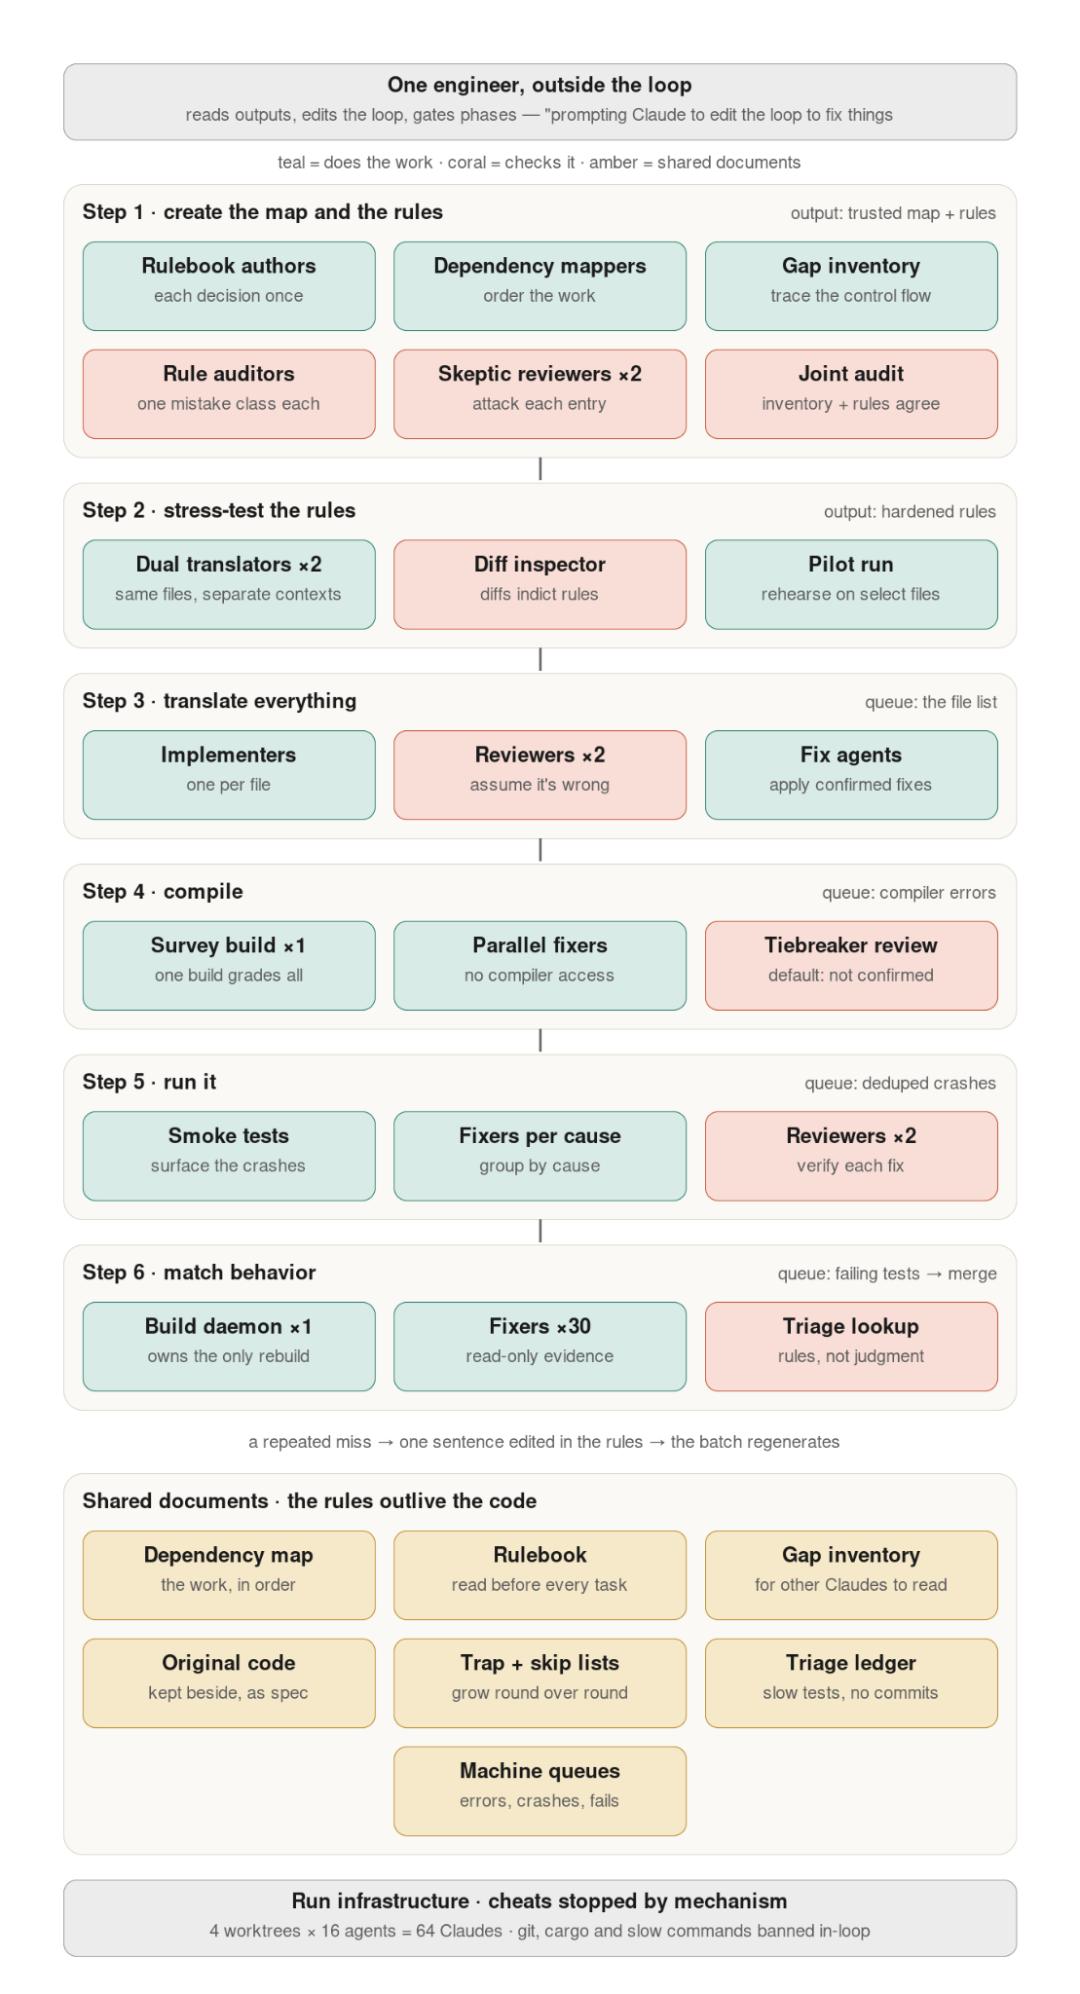
此次迁移成功的关键,并非单纯依赖模型的智能,而在于Anthropic提出的一套可复用的“六步核心框架”。这套框架的核心理念是:不要试图让AI手动修补每一行代码,而是要优化产出代码的工作流(Loop)。大型迁移任务天然适合AI介入,因为工作具有高度并行性,旧代码本身提供了最准确的规范,而测试套件则充当了客观的裁判。
第一步是建立“裁判”机制。这包括编写详细的规则手册,明确代码风格的转换标准、API的映射关系以及安全约束。第二步是绘制依赖图,清晰梳理模块间的耦合关系,确保重构不会破坏现有的功能链路。第三步是列出缺口清单,识别新旧语言之间的语义差异,特别是那些容易出错的边界情况。
第四步则是关键的“试航”阶段。通过小规模样本进行压测,验证规则手册的有效性,提前暴露可能导致大规模失败的逻辑漏洞。第五步进入全量翻译与多智能体循环。在此阶段,多个智能体并行工作,分别负责实现、评审和修复。每当评审员发现一个错误,规则手册就会立即更新,受影响的文件会自动重新生成,形成闭环迭代。最后一步是编译与行为一致性校验,将新代码的输出与旧版本逐一比对,任何细微的行为偏差都被视为Bug并即时修复。
经济账与效率账:AI重构的商业价值
除了技术层面的突破,这次迁移的经济账同样令人深思。16.5万美元的API调用成本,看似不菲,但若将其分摊到两年的开发周期中,且对比此前300万美元的人力成本,其性价比显而易见。更重要的是时间成本的节约。Jarred Sumner团队原本可能需要花费四年时间,现在仅需两周。这种效率提升对于初创公司和快速迭代的科技公司而言,意味着更长的窗口期来应对市场变化。
Instagram联合创始人Mike Krieger的案例进一步佐证了这一点。他利用一个周末,将一套Python代码库迁移为16.5万行TypeScript,消耗约2700万Token。通过数百个智能体和三轮对抗式评审,不仅完成了语言转换,还解决了跨平台编译效率低下的痛点。迁移前,每个平台编译需8分钟,发布需半小时;迁移后,编译仅需2秒,二进制启动速度提升6倍,同时退役了整条复杂的部署流水线。
这些案例表明,AI重写代码不仅仅是语言层面的转换,更是软件构建体系的优化。通过引入AI,开发者可以将精力从繁琐的语法转换中解放出来,转而专注于架构设计、性能优化和业务逻辑创新。
未来展望:智能重构的新范式
Anthropic的这次公开,实际上宣告了软件工程中一个新范式的诞生。过去,代码迁移被视为高风险、低回报的工程,许多团队选择“如果不坏,就不要修”的策略,导致技术债务不断累积。现在,这种观念正在被颠覆。只要测试套件健全、规则定义清晰,AI就有能力处理极其复杂的迁移任务。
对于开发者而言,这意味着需要重新定义自己的角色。未来的软件工程师,可能更多时候扮演的是“规则制定者”和“系统审计员”,而非单纯的“代码编写者”。如何设计有效的提示词(Prompt),如何构建鲁棒的测试框架,如何定义跨语言的语义映射,将成为核心竞争力。
此外,这也引发了关于代码知识产权和模型训练数据的深层讨论。当代码由AI生成,且基于大量旧代码进行迁移时,如何确保新代码的原创性和合法性,将是行业需要面对的新课题。但无论如何,Bun的案例已经证明,利用LLM进行大规模代码重构,不仅在技术上是可行的,在经济上也是高效的。
随着更多类似工具的涌现和模型能力的提升,我们有理由相信,未来的软件开发将更加模块化、自动化和智能化。代码库的演进速度将不再受限于人力,而是取决于模型的处理能力和开发者的架构设计能力。在这场由AI驱动的效率革命中,率先掌握“修流程”而非仅“修代码”思维的组织,将占据显著的竞争优势。