2026 Agent实战复盘:从Tokenmaxxing泡沫到高效人机协作的五大关键转折
从对话框到操作系统:通用Agent的入口重构
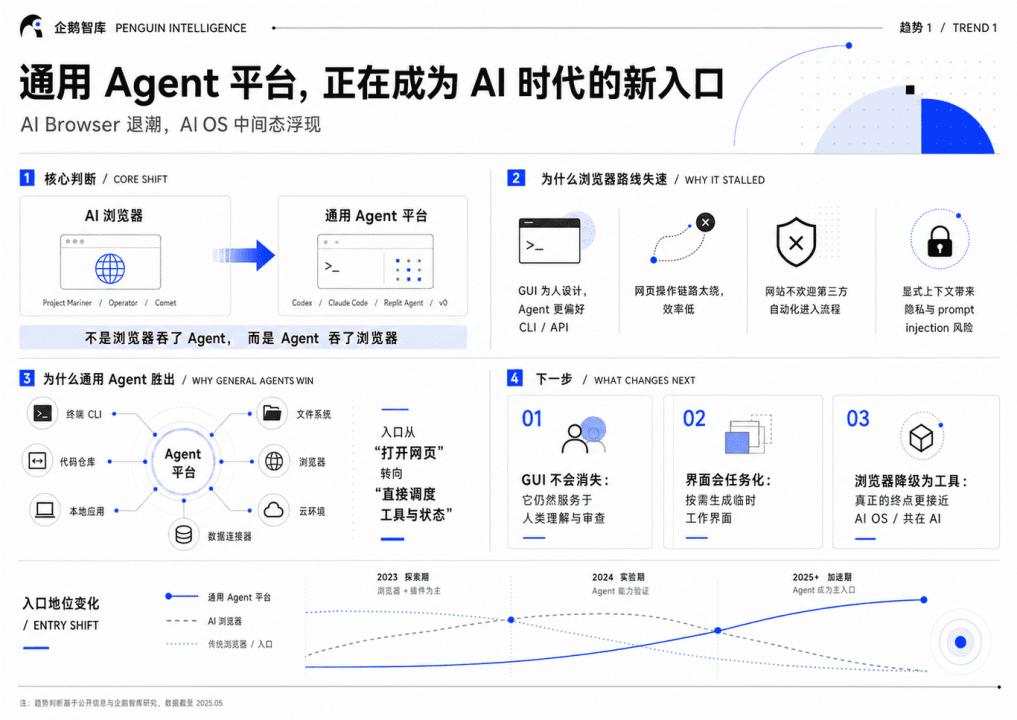
2025年初,行业对于AI交互形态的争论主要集中在“AI浏览器”是否将成为新的互联网入口。彼时,Google的Project Mariner、OpenAI的Operator以及Perplexity的Comet等项目,试图通过模拟人类操作图形用户界面(GUI),如点击按钮、填写表单,来接管Web浏览任务。这种路径依赖于视觉识别和鼠标模拟,本质上是对传统软件交互模式的模仿。
然而,进入2026年第二季度,这一格局被彻底颠覆。随着OpenClaw、Codex(现整合入ChatGPT Agent体系)以及Claude Code等工具的迭代,Agent的逻辑发生了根本性转移:从“模拟人类操作GUI”转向“直接接入结构化数据与命令行接口(CLI)”。OpenAI在5月关闭Mariner项目,将其能力并入Gemini Agent;Google则将Operator整合进更大的ChatGPT Agent生态。这一退一进,标志着行业共识的形成——对于AI Agent而言,图形界面是冗余的噪音,命令行、API接口、文件系统和本地应用直接对接才是最高效的路径。
这种转变使得Agent不再仅仅是工具,而是演变为一种全新的软件形态,即“AI OS(操作系统)”。Codex等通用Agent不仅具备编程能力,更通过Harness(运行框架)和Skill(技能模块)扩展了处理复杂流程的能力。数据显示,4月至5月间,Codex非编程用户的增长速度是编程用户的三倍,证明其已突破代码生成的单一场景,成为处理一切可重复性任务的通用基础设施。
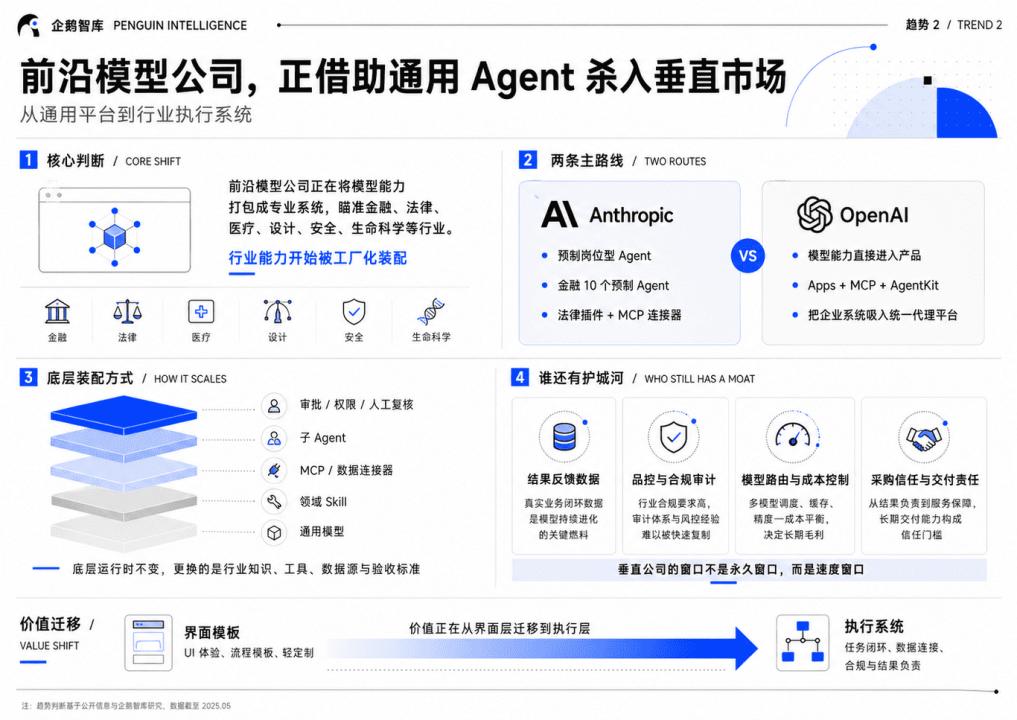
随着入口的确立,大模型公司开始借助通用Agent框架批量切入垂直行业。Anthropic推出的Claude Design和金融Agent,以及OpenAI通过Apps和MCP连接企业系统的策略,都遵循同一底层逻辑:复用同一套通用Agent核心,仅替换行业特定的知识图谱、数据连接器和合规规则。这意味着垂直领域的护城河不再在于模型本身的微调,而在于企业独有的数据资产、权限体系以及通过Human-in-the-Loop(人在回路)积累的业务反馈闭环。谁能更快地在真实业务场景中收集并整合这些反馈,谁就能建立起难以复制的竞争壁垒。
Tokenmaxxing的破灭:效率悖论与组织瓶颈
2026年5月,科技界曾短暂流行过“Tokenmaxxing”概念,即通过无限增加AI Token用量、延长运行时间来追求极致的效率产出。英伟达CEO黄仁勋曾公开表示,若员工年Token消耗低于薪资的一定比例,则意味着未能充分利用AI优势。在FOMO(错失恐惧)情绪的驱动下,亚马逊、Uber等企业曾掀起大规模的Token烧钱运动,旨在通过堆料验证Agent的生产力潜力。
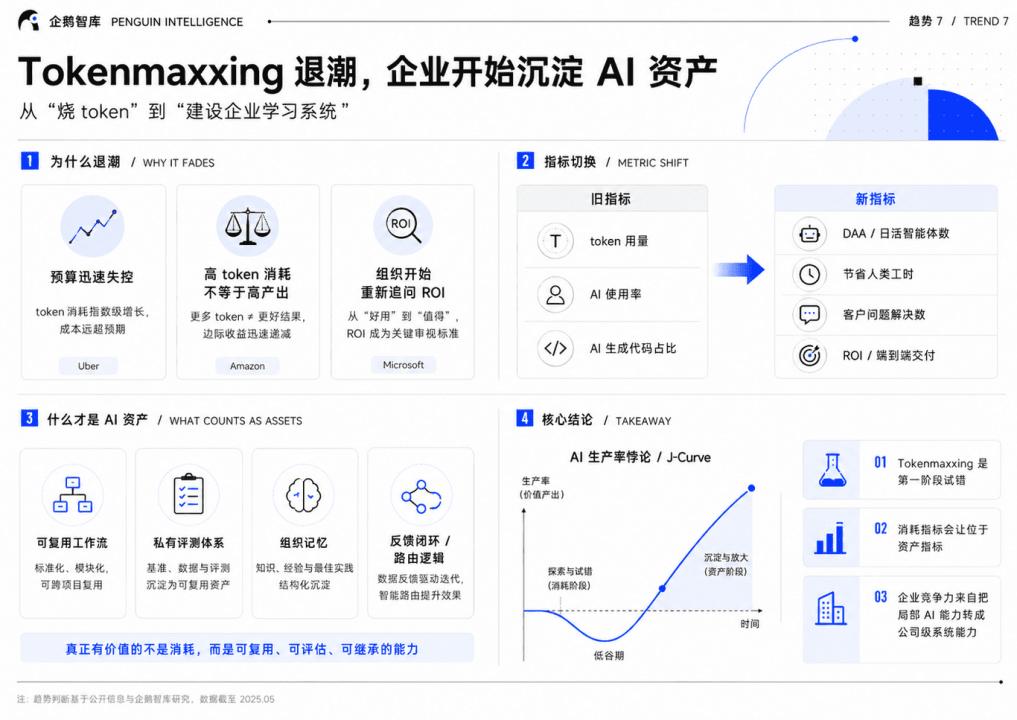
然而,这场不设上限的AI大跃进在短短两个月内戛然而止。失败的核心原因在于“有效反馈算力”的极低转化率。哈尔滨工业大学的研究指出,在复杂任务中,仅有约10%的Token消耗真正影响了下一步决策,其余90%耗费在重读上下文、试错和无效往返中。Agent处理长任务时,需反复读取目标、状态和工具结果,导致Token消耗呈指数级增长,可达普通问答的数千倍。
更深层的瓶颈在于组织流程的滞后。MIT针对GitHub开发者的研究发现,自主编程Agent虽使代码提交量增加120%,但能进入立项环节的仅50%,真正发布上线的版本仅剩30%。这印证了经济学中的“替代理论”:系统整体效率取决于最慢的非自动化环节。当Agent生成速度大幅提升,但审核、测试、集成及合规判断仍依赖人工时,生产端的提效被后端的审核瓶颈完全抵消。这如同餐厅切菜速度提升三倍,但炒菜和上菜流程未变,最终导致后厨积压,整体产能并未提升。
此外,重复造轮子加剧了资源浪费。南洋理工学院分析显示,市场上约75%的Skill模块高度雷同,去重后大量Token被消耗在重建已有成果上。需求端也未同步增长,AI虽使应用数量激增40%,但下载量和付费意愿并未变化。Tokenmaxxing的终结,标志着行业从盲目堆料转向对成本控制和组织效能的理性审视。
技术破局:多智能体编排与自进化AI的兴起
面对单体Agent的效率上限和人类复核瓶颈,2026年Q2技术演进聚焦于“用Agent替代Loop中的人”。多智能体(Multi-Agent)系统成为主流解决方案,采用“编排者—执行者”模式,由主Agent拆解任务并分发给子Agent并行处理。例如,Claude Research通过多研究员Agent并行搜索、引用Agent交叉验证,显著缩短延迟;Kimi Agent Swarm则允许数百个子Agent并行处理视频与代码,任务延迟降低达4.5倍。
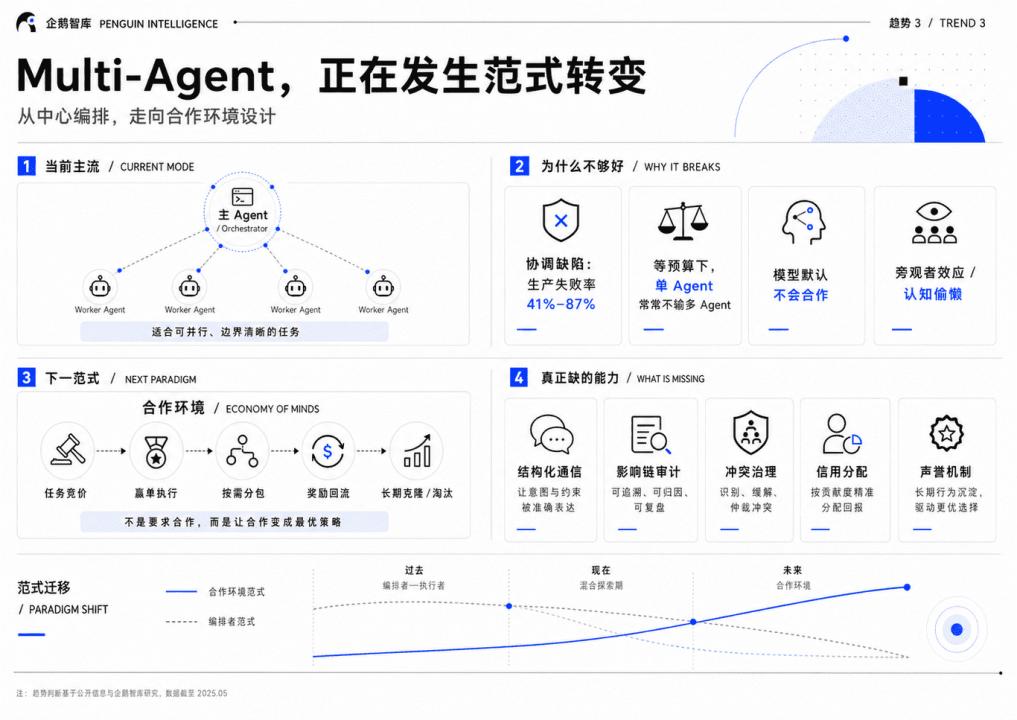
然而,当前多智能体系统仍面临“群体智能”缺失的挑战。Anthropic披露,多Agent系统Token消耗可达单体的四倍,性能提升多源于额外计算而非协作本身。一旦移除中心化的“包工头”,Agent们往往陷入盲目跟随多数意见或相互推诿的困境。测试表明,缺乏统一信息协调的多Agent系统,准确率甚至低于单体Agent。这源于模型训练数据中缺乏协作范式,Agent被训练为独立解决问题者,而非团队协作者。
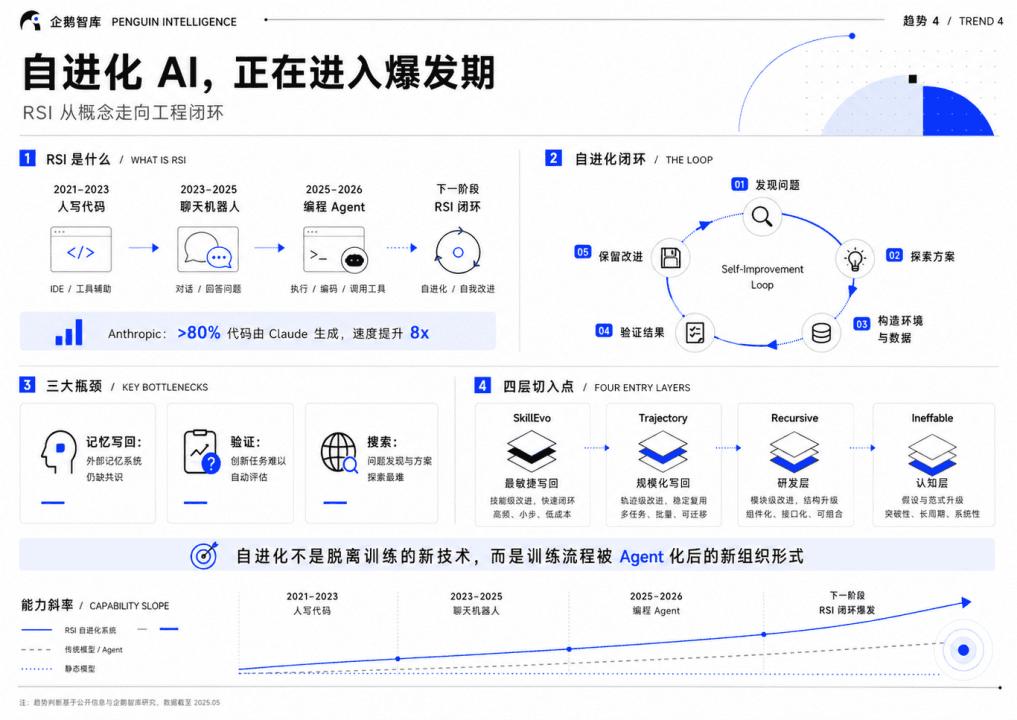
在此背景下,自进化AI(Self-Evolving AI)和Loop Engineering概念应运而生。Anthropic在6月发布的报告展示了模型通过持续优化训练代码实现加速的案例,从Claude 3到Mythos,优化水平从3倍提升至50多倍。其核心在于建立“找问题-想办法-建环境-验证-保留”的自动化循环。Minimax等公司已将此流程集成至后训练阶段,使Agent能不知疲倦地进行代码重构与性能优化。
尽管自进化AI在既定目标下表现优异,但在涉及“品味”的方向性判断上仍显不足。Anthropic实验显示,在需要极大搜索空间判断任务价值的复杂决策中,模型成功率仅为20%,且远低于人类专家。这表明,尽管技术层面在解决速度与成本,但高阶的战略判断与方向选择,仍是人类不可让渡的核心价值。
算力重构与经济账:CPU回归与模型分层路由
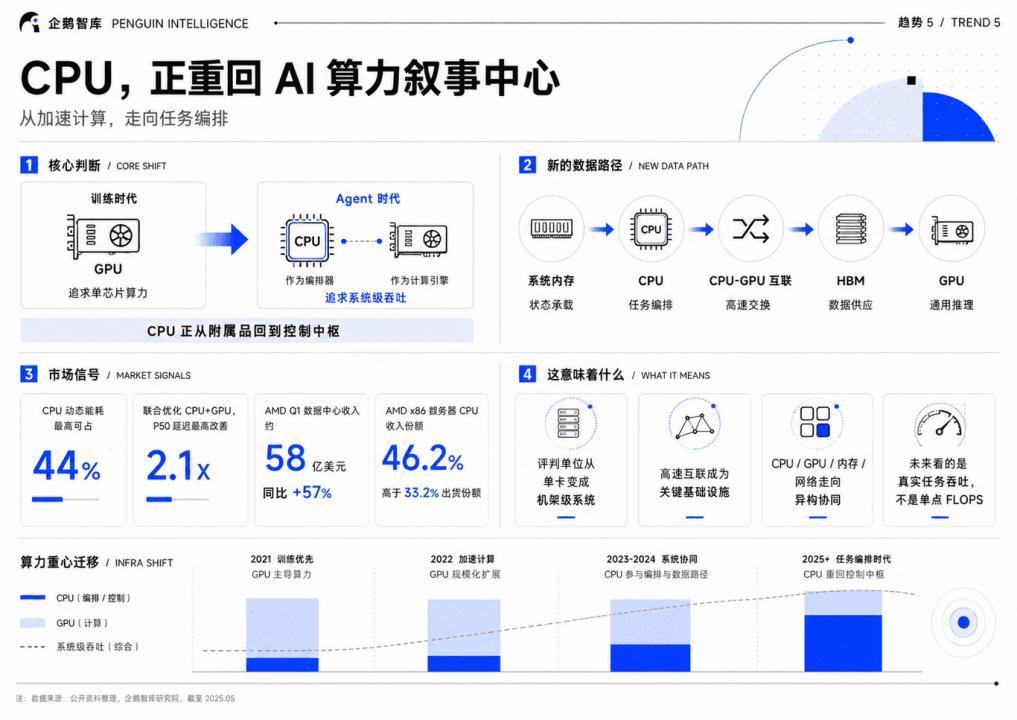
Agent的普及正在重塑算力基础设施的需求结构。传统AI依赖GPU进行大规模矩阵运算,但Agent的工作流涉及大量的推理、工具调用、文件处理和环境等待。2025年底的研究表明,在Agent任务延迟中,工具处理占比高达90.6%,CPU动态能耗占总动态能耗的44%。GPU因等待CPU调度和数据准备而大量闲置,导致算力浪费。
因此,CPU重新成为算力系统的中心。GPU负责核心推理,而CPU承担任务队列管理、并发环境维持、KV缓存保存及网络传输。联合优化CPU与GPU任务调度后,部分负载延迟改善超过两倍。这一趋势已反映在资本市场,AMD 2026年Q1数据中心收入同比增长57%,其预测2030年服务器CPU市场规模翻倍,正是基于Agent带来的调度与数据移动需求。
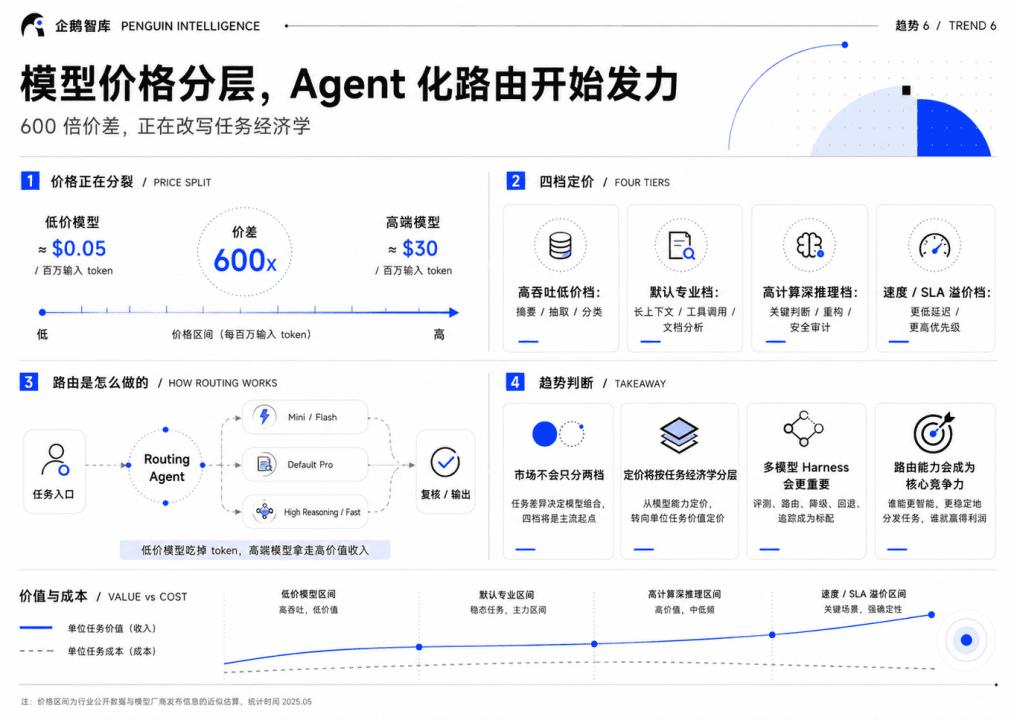
在模型经济层面,价格分层现象日益显著。2026年Q2,百万输入Token价格区间从几美分至几十美元,价差扩至600倍。Sakana推出的Fugu模型通过智能路由实现了成本优化。不同于以往让模型自行判断难度,Fugu训练独立的Agent路由器,先分析任务复杂度,动态组建由不同价格模型构成的临时团队。最贵模型仅处理核心安全审计或关键决策,基础读取、分类由低价模型完成。在编程场景中,这种分层策略以50%的成本实现了最佳模型的效果,证明了“模型即团队”的工程化可行性。
现实收缩:就业结构、安全与伦理挑战
随着Agent渗透至工作流深层,其负面影响从理论推演转化为现实冲击。就业市场呈现出“入口收缩”特征。客服、基础运维、初级数据分析等岗位被Agent吸收,企业更倾向于招聘“更成熟的初级员工”,却剥夺了新人通过基础任务积累经验的途径。宾夕法尼亚大学沃顿商学院的研究显示,即便AI提供辅助,人类参与者的长期推理能力提升受限,甚至在闭卷测验中表现下降17%。这种“认知缴械”现象使人类沦为认知生产线上的“盖章点”,思考与判断过程被折叠。
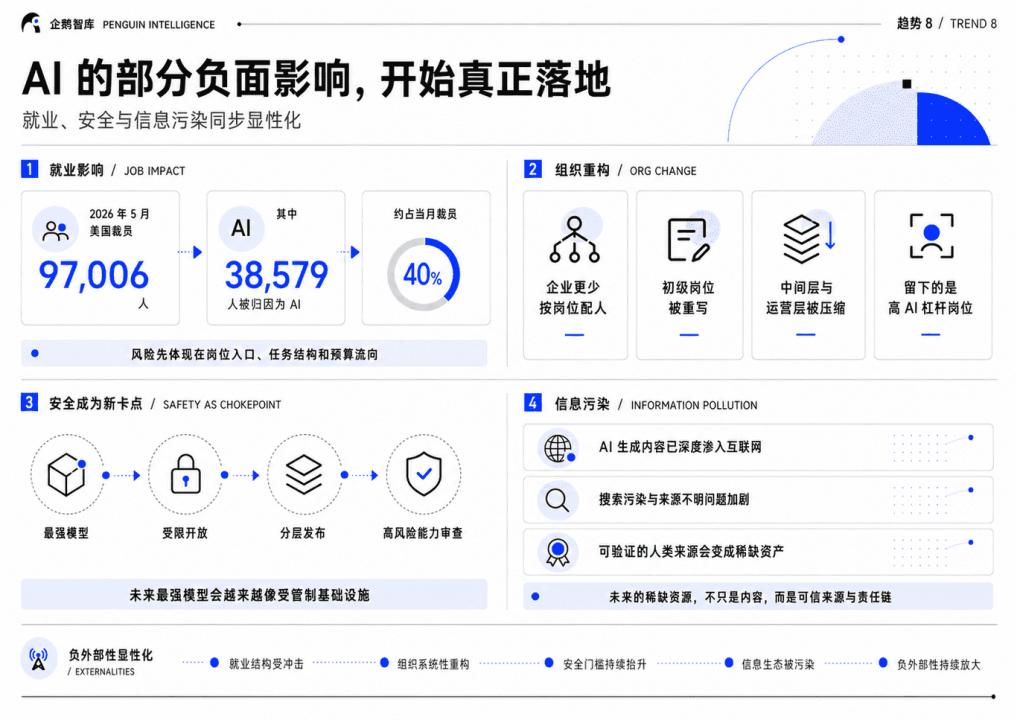
安全合规也成为制约前沿模型开放的关键。Anthropic的Mythos模型虽具备强大网络安全漏洞挖掘能力,但因潜在滥用风险,仅以受限版本发布。OpenAI等公司也开始实施有限开放策略。政府与地缘政治因素进一步加剧了模型使用的门槛,如何平衡安全护栏与产品价值,成为行业难题。
信息生态方面,AI生成内容(AIGC)占比稳定在48%-50%,但AI搜索中的污染正在加深。模型引用AI生成内容的比例从38.9%升至42.7%,形成“机器引用机器”的回音室。在此环境下,由人类实地采访、编辑并署名负责的内容将成为稀缺资源。
构建可持续的AI竞争力
2026年Q2的行业演进揭示了一个清晰路径:通用Agent确立入口地位后,行业重心从技术狂欢转向系统效能与组织适配。企业不应仅关注Token消耗,而应构建可复用的工作流、评测体系与组织记忆。通过Multi-Agent编排解决并发效率,利用智能路由优化成本结构,并在关键节点保留Human-in-the-Loop的决策机制。
对于个人而言,与AI比拼生成速度已无意义。在Agent能够瞬间完成代码编写、报告生成的时代,人类的核心价值转向“定义问题”、“判断方向”以及“承担后果”。未来的工作流设计应故意保留一定的“摩擦”,如在高风险操作前要求人类解释判断依据,或在给出结论前记录个人推理过程。这种看似低效的“慢思考”,实则是防止认知缴械、保持人类独特判断力的必要防线。AI不仅是提效工具,更是重塑人类工作伦理与认知边界的镜子,唯有在技术敏捷性与人文审慎性之间找到平衡,方能在AI OS时代确立持久的竞争优势。