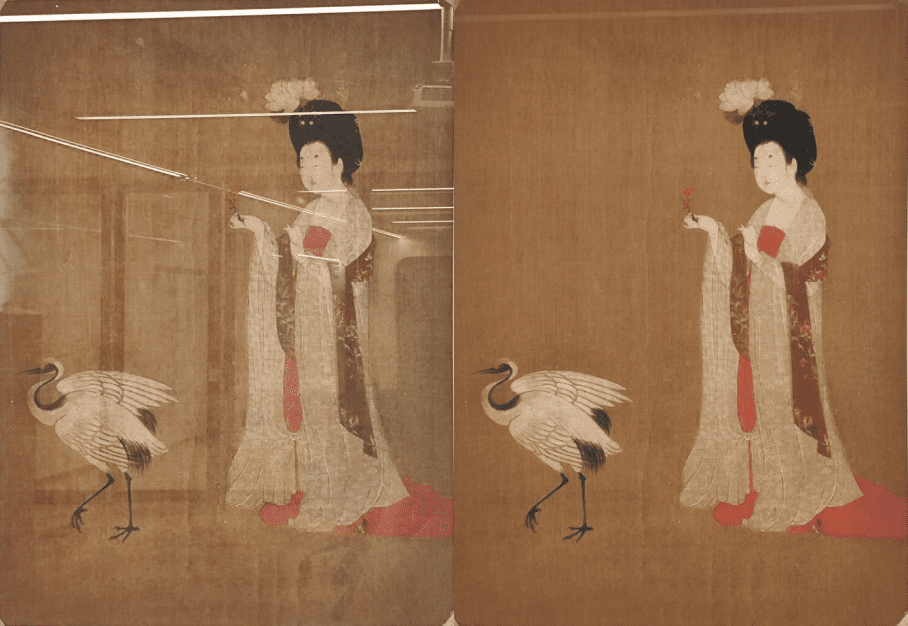
AI鉴伪新范式:跨模态检测与去反光如何重构数据可信度
在生成式人工智能全面渗透数字生活的当下,内容创作的门槛被前所未有地降低。从逼真的虚拟人物到以假乱真的票据截图,AI生成的内容正以前所未有的速度涌入社交网络、电商平台以及企业核心业务流程。过去,伪造一份转账记录或修改一张商品破损图需要专业的图像处理技能,而如今,借助先进的扩散模型和大语言工具,普通用户仅需简单的提示词即可完成高保真的内容篡改。更令人担忧的是,这些经过二次压缩、裁剪和转发的内容,其原有的生成痕迹往往被进一步抹平,使得传统依靠肉眼观察细节瑕疵的鉴别方式彻底失效。
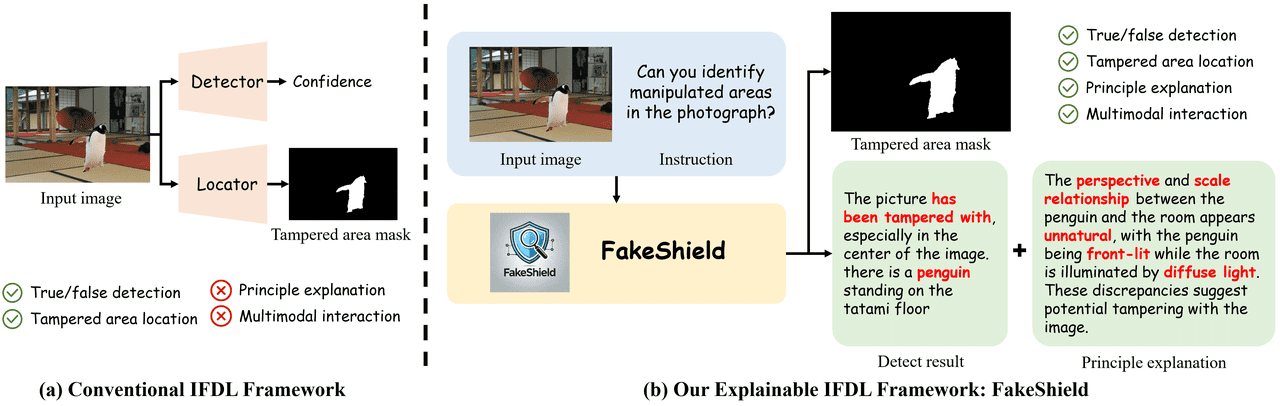
当AI生成内容从娱乐领域跨越至交易验证、保险理赔及法律证据提交等严肃场景时,真假判断不再仅仅是技术层面的识别问题,而是直接关乎资金安全、平台公信力乃至司法公正的核心议题。市场亟需的不再是基于经验的主观猜测,而是一套能够精准捕捉微观生成痕迹、识别局部篡改并量化风险等级的自动化系统。这一需求催生了两个关键的技术方向:一是如何精准判定内容是否由AI生成或经过恶意篡改;二是如何消除因拍摄环境导致的反光、倒影等干扰,恢复图像的原始信息完整性。
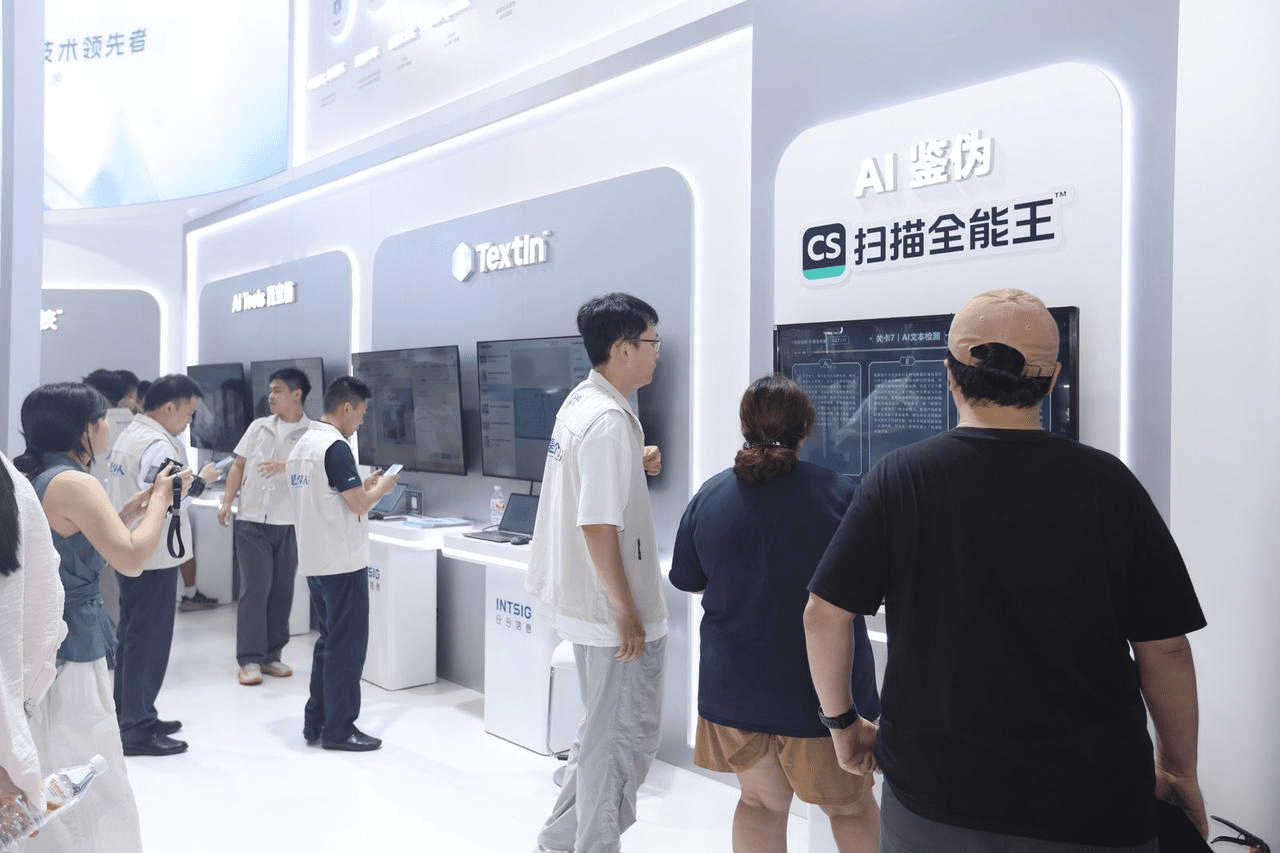
在近期的行业技术展示中,跨模态鉴伪技术与智能去反光算法成为了焦点。前者致力于构建一道前置的风控防线,后者则专注于提升数据采集的质量。这两项技术共同构成了面向真实业务的“可信输入基础设施”,确保进入后端大模型或业务系统的数据是真实且完整的。对于依赖数据驱动决策的现代企业而言,理解并应用这些技术,已成为构建稳健数字化体系的必要前提。
人眼在判断图像真伪时,往往依赖于高层语义逻辑,例如场景是否符合常识、界面布局是否熟悉、事件发展是否合理。然而,现代AI伪造技术恰恰避开了这些明显的逻辑漏洞,转而采用“局部微调”的策略。一张看似正常的支付截图,可能仅替换了金额数字和时间戳,其余部分的像素分布、噪声特征及压缩痕迹均保持原样。这种“整体真实、局部伪造”的手法,极大地迷惑了人类观察者,因为我们的视觉系统倾向于关注整体结构的合理性,而忽略微观层面的统计异常。
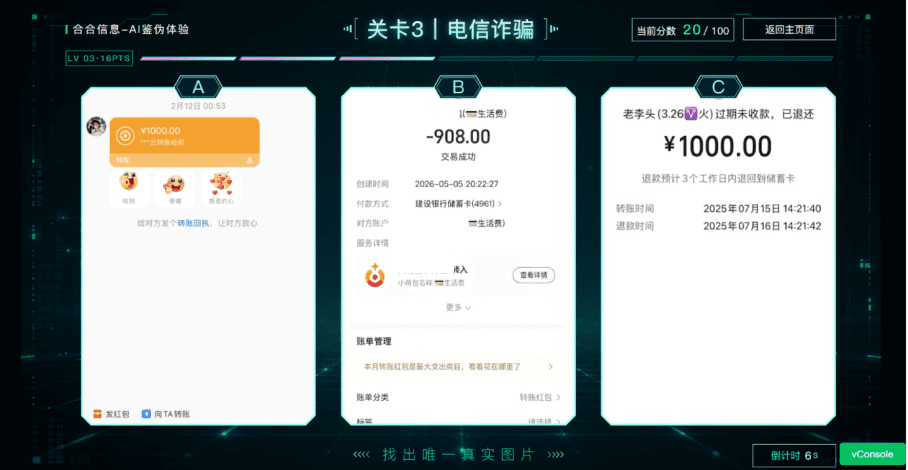
相比之下,AI鉴伪模型的工作机制截然不同。它不依赖于对画面内容的语义理解,而是深入到底层的信号处理层面,分析图像的频域分布、噪声残差、边缘融合特征以及光影一致性。例如,真实相机成像过程中,传感器噪声、镜头光学特性及ISP处理流程会留下特定的统计指纹。而AI生成或局部重绘的区域,由于合成算法的差异,其噪声分布往往与周围背景存在细微的不连续。鉴伪系统正是通过捕捉这些肉眼不可见的“统计异常”,来判定图像的真实性。这种从“找明显错误”到“检测统计异常”的转变,标志着数字取证技术进入了新的阶段。
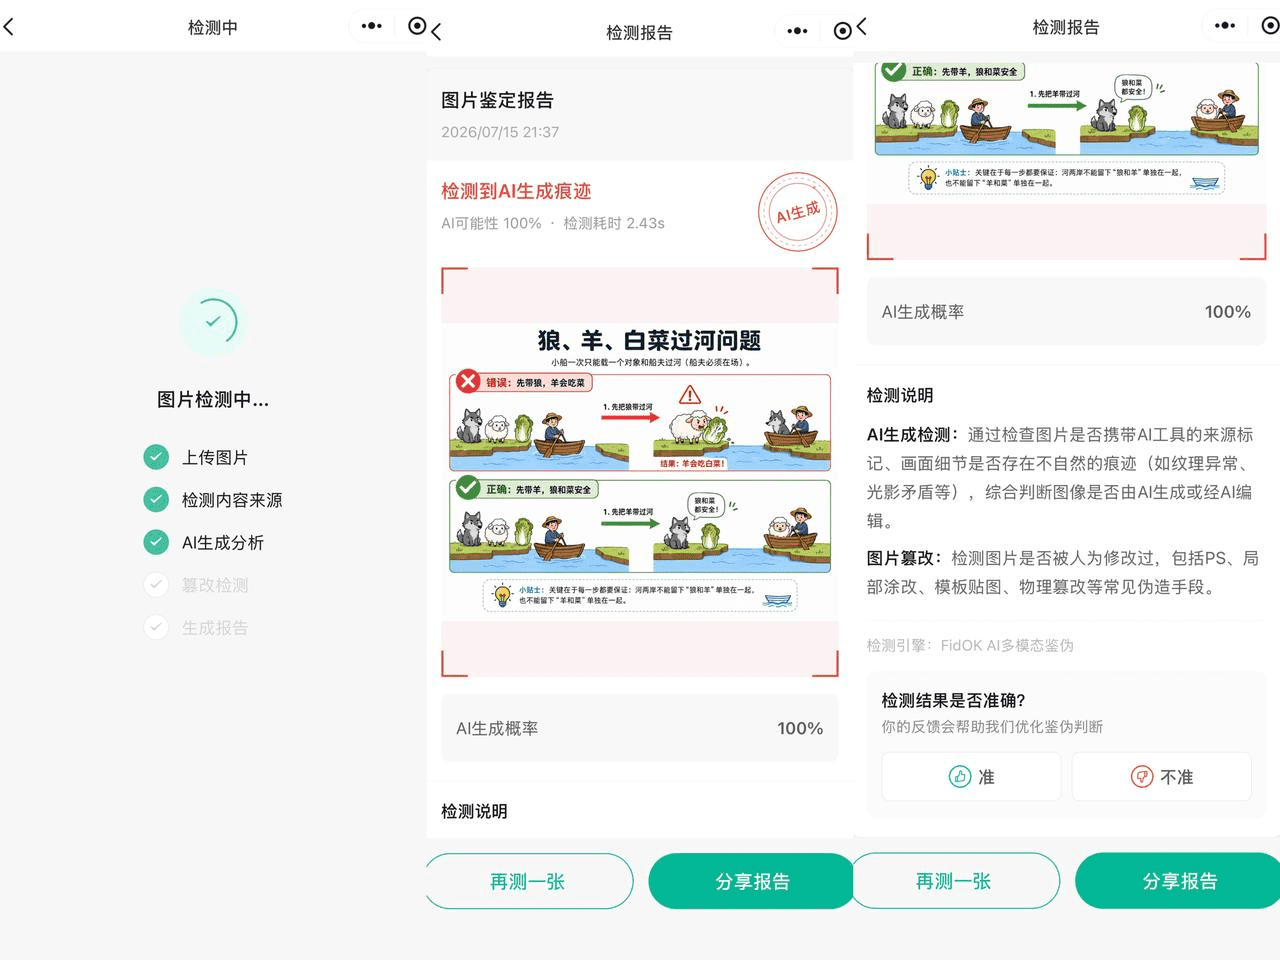
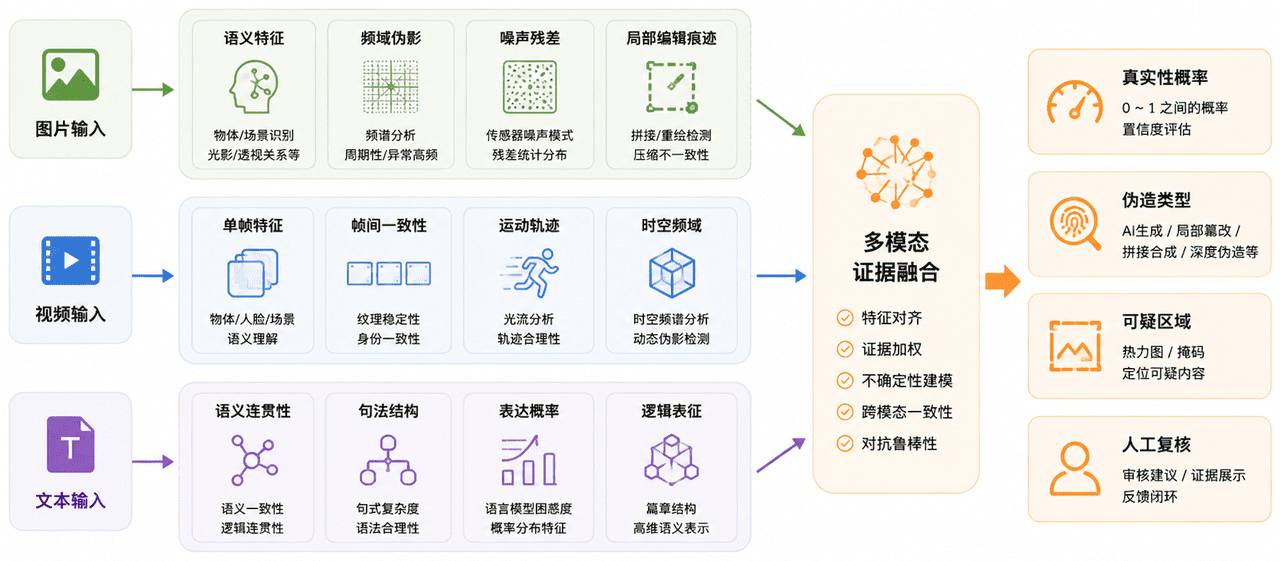
在实际应用中,跨模态鉴伪并非单一维度的检测,而是针对图片、视频和文本不同介质特性的差异化处理路径。对于静态图片,系统不仅分析语义层面的结构合理性,更重点考察频域伪影和噪声模式。生成模型在上采样和去噪过程中,往往会在高频区域留下不同于自然图像的周期性痕迹。通过傅里叶变换等数学工具,可以将图像从空间域转换到频域,从而更容易地捕捉这些隐藏的特征。同时,噪声残差分析能够揭示图像各部分是否源自同一条成像链路,任何局部的拼接或重绘都会破坏噪声的全局一致性。
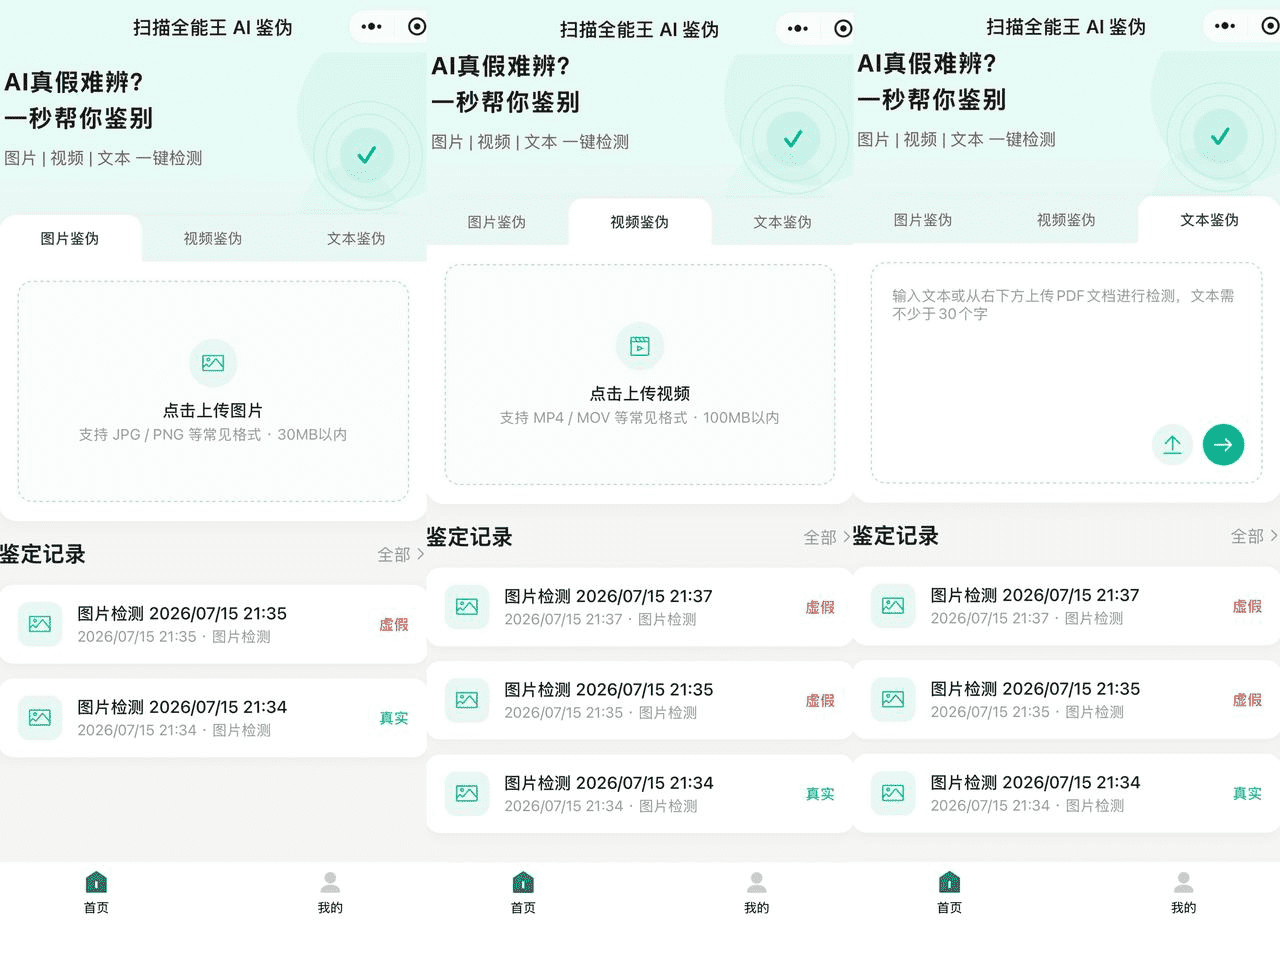
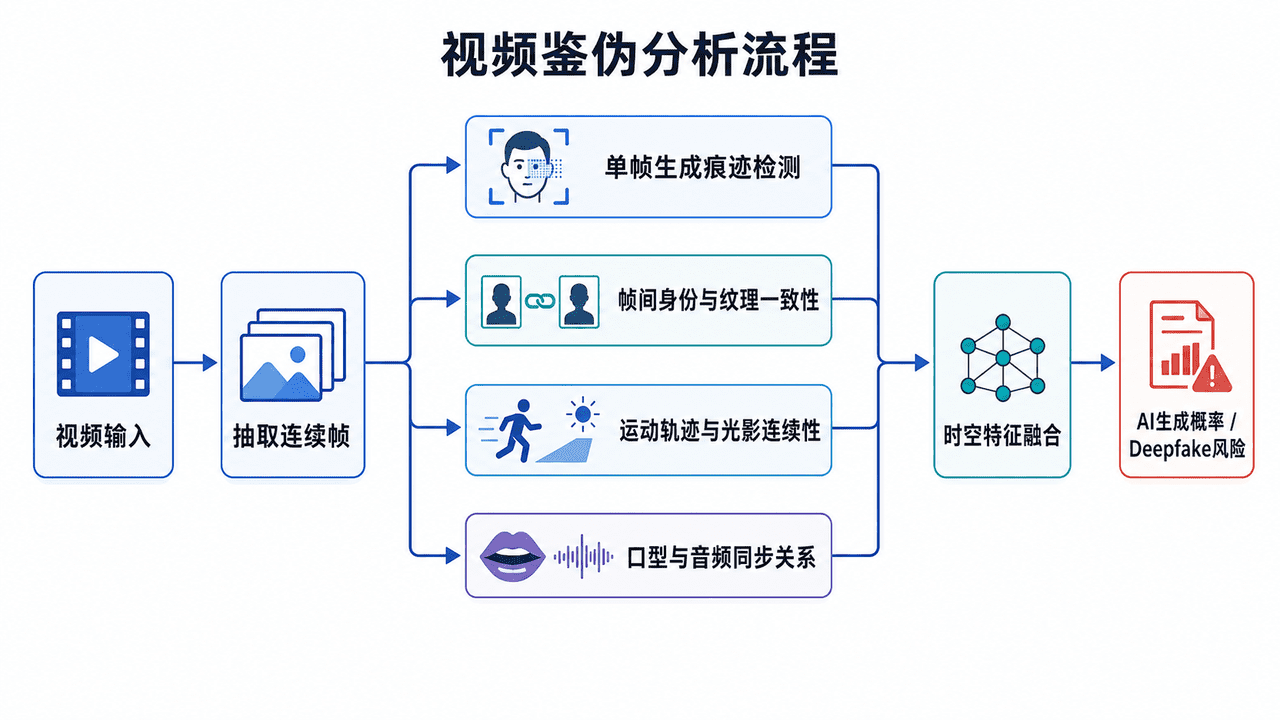
视频鉴伪则引入了时间维度的复杂性。许多深度伪造视频在单帧画面中几乎无懈可击,但在连续播放时,人物面部轮廓的微小抖动、首饰的忽隐忽现、背景文字的漂移以及口型与声音的非同步性,都会暴露出合成的痕迹。因此,视频检测系统必须同时处理空间维度的帧内特征和时间维度的帧间一致性。通过分析运动轨迹的光滑度、光照变化的连续性以及身份特征的稳定性,系统能够识别出那些仅在特定时间段或特定角度下出现的伪造片段。这种时空联合分析机制,有效弥补了单帧检测的盲区,提升了针对复杂Deepfake攻击的防御能力。
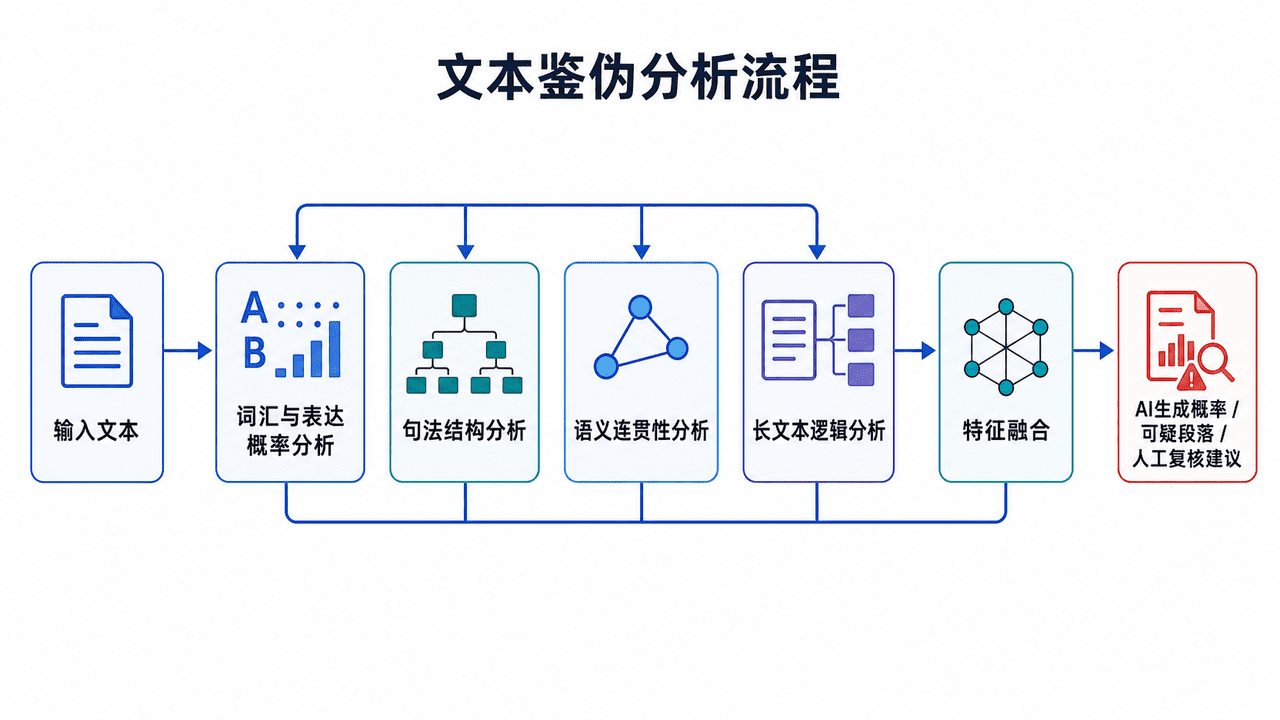
文本鉴伪同样面临着从表层统计向深层语义演进的趋势。早期的检测方法主要依赖词频、句长和困惑度等统计特征,但这些指标极易通过人工润色或简单的后处理进行规避。当前的先进模型开始关注词汇选择的概率分布、句法结构的多样性、语义推进的逻辑性以及篇章结构的连贯性。大模型生成的文本往往表现出过度的平滑性和均匀的信息密度,缺乏人类写作中特有的跳跃性思维和个性化表达。通过多维度的语言特征提取与融合,鉴伪系统能够识别出那些虽然语法正确但缺乏真实来源支撑的生成文本,甚至能定位到文章中由AI续写或改写的具体段落。
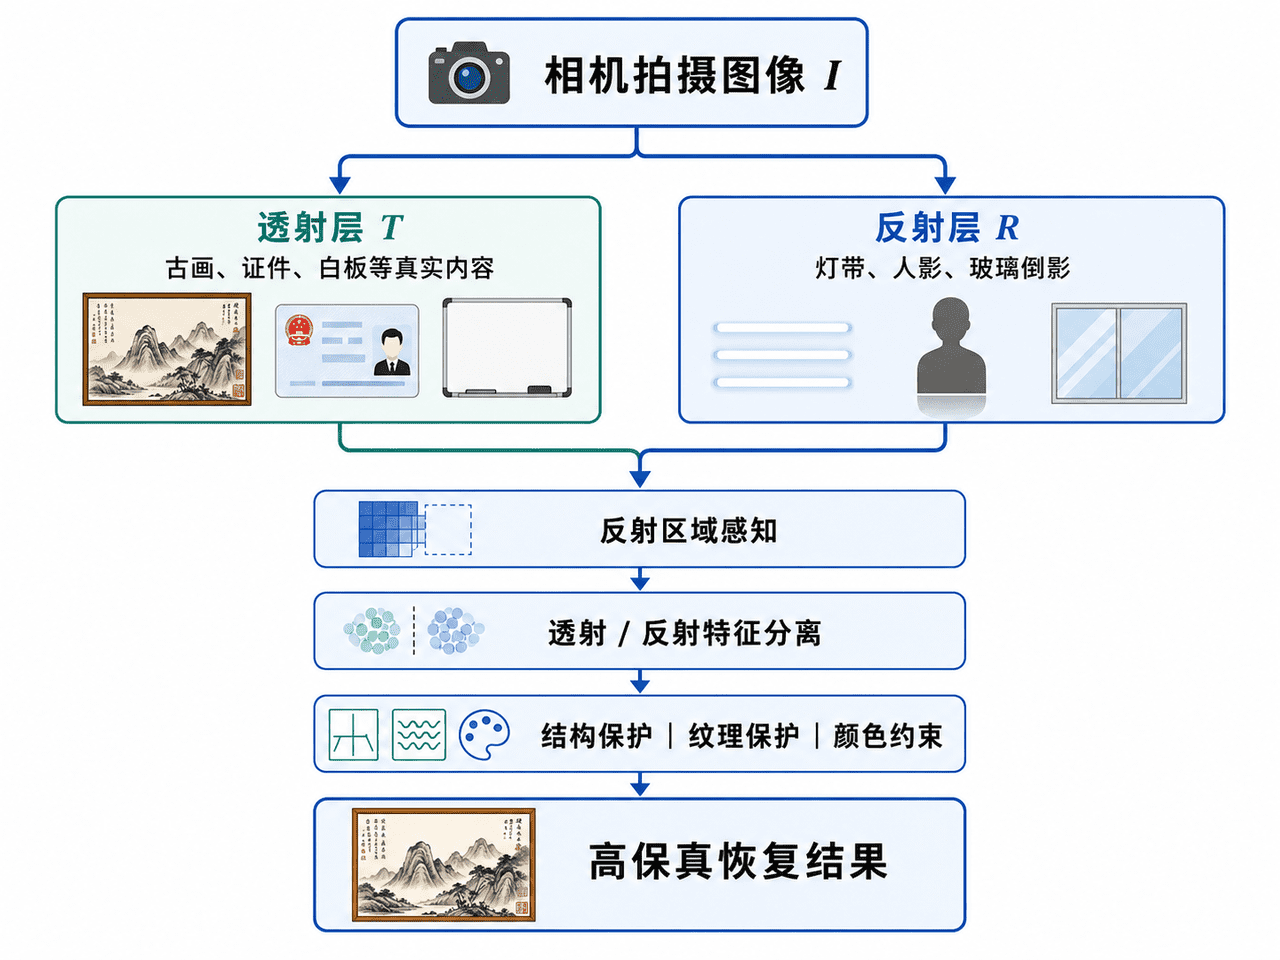
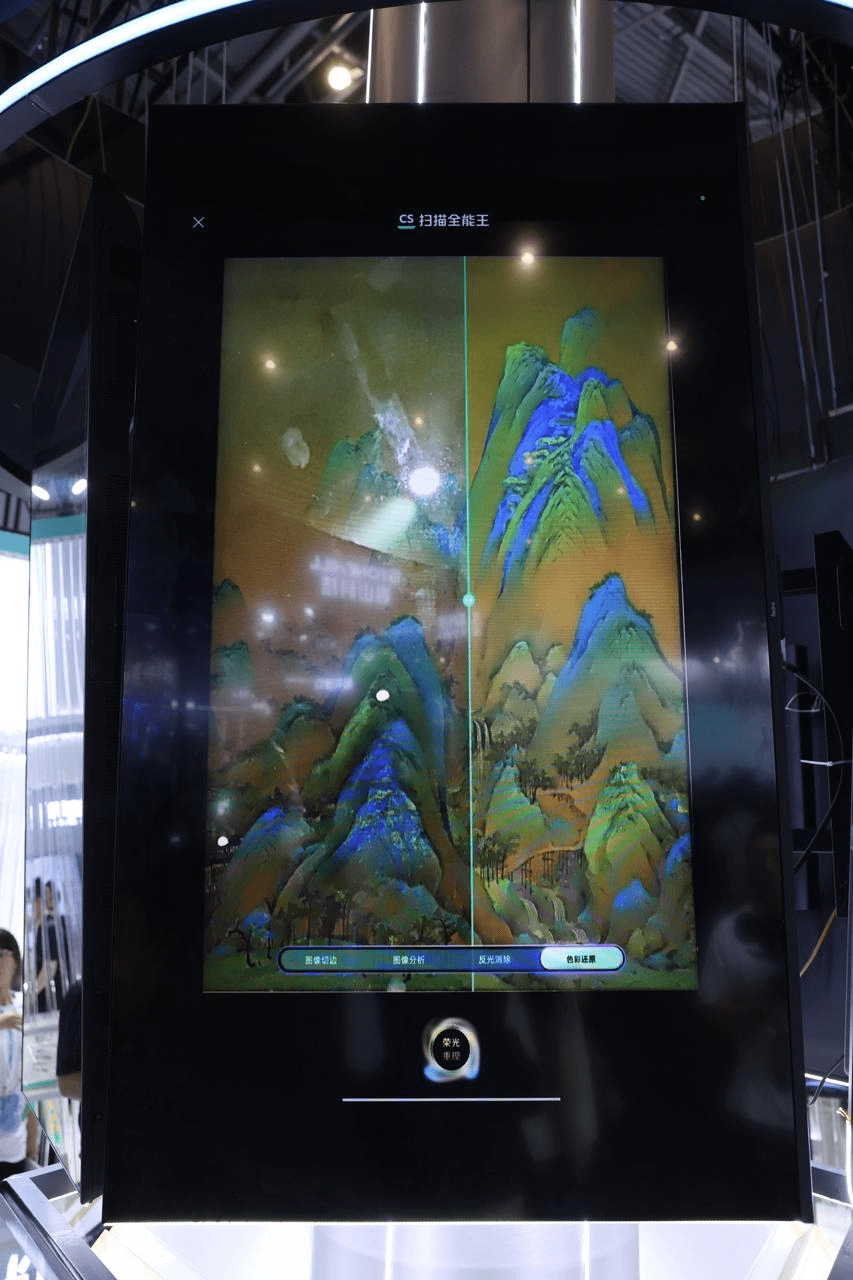
除了内容的真实性鉴别,图像采集过程中的质量干扰也是影响业务效率的重要因素。其中,玻璃反光是最常见且难以处理的问题之一。在拍摄证件、白板、展柜商品或屏幕内容时,环境光的反射往往会遮挡关键信息,导致后续的OCR识别失败或误判。传统的去反光方法通常采用简单的亮度调整或滤波处理,但这往往会导致图像细节丢失或引入新的伪影。智能去反光技术则采用了更为复杂的物理模型,将拍摄到的图像分解为透射层(目标内容)和反射层(环境倒影)。
这一过程并非简单的图像修复,而是基于对光线传播物理规律的深刻理解。算法需要精确区分哪些高亮区域来自物体本身的材质反光,哪些来自玻璃表面的环境反射。特别是在强反光导致像素饱和的情况下,原始信息已经部分丢失,模型必须在约束条件下进行合理的推断与恢复,避免凭空生成不存在的细节。最新的去反光算法通过在大规模真实场景数据上的训练,学会了保留目标物体的纹理结构和色彩基调,同时有效抑制环境倒影的干扰。这种“高保真还原”能力,确保了处理后图像的真实性和可用性,为后续的文档解析和信息提取奠定了坚实基础。
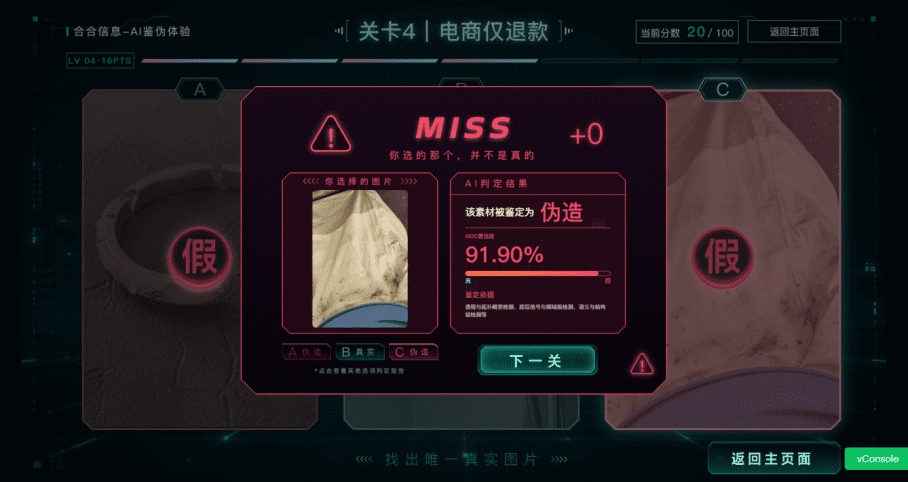
将鉴伪与去反光技术整合到业务流程中,能够显著提升企业的风险控制能力和运营效率。在金融和保险领域,前置的鉴伪筛查可以自动拦截高风险的伪造材料,减少人工审核的工作量并降低误判率。在电商场景中,去反光技术能够提高商品图片和退货凭证的识别准确率,加速退款和理赔流程。更重要的是,这些技术为大模型和智能代理提供了高质量的输入数据。如果输入数据本身存在虚假或残缺,再强大的推理模型也无法输出正确的结果。因此,构建一个包含数据清洗、真实性验证和质量增强的预处理 pipeline,是实现AI可靠落地的关键步骤。
未来,随着生成技术的不断迭代,鉴伪与反鉴伪之间的博弈将更加激烈。攻击者可能会使用更先进的对抗样本技术来逃避检测,而防御者则需要不断更新特征库和算法模型。在这场持续的军备竞赛中,多模态融合、自监督学习以及可解释性AI将成为重要的发展方向。通过结合多种模态的证据,系统能够做出更鲁棒的判断;通过自监督学习,模型能够从海量未标注数据中挖掘新的鉴别特征;而可解释性则有助于用户理解系统的决策依据,增强信任度。
综上所述,AI鉴伪与去反光技术不仅是工具层面的创新,更是数据治理理念的升级。它们强调了在AI应用链条前端保障数据真实性与完整性的重要性。只有建立起坚固的“可信输入基础设施”,才能确保人工智能在赋能各行各业时,始终基于真实的世界做出负责任的决策。对于企业和开发者而言,尽早布局并集成这些能力,将是应对未来数字信任危机的最佳策略。