Gemini 3.6 Flash降价65%?谷歌三连发背后,Agent成本革命真的来了
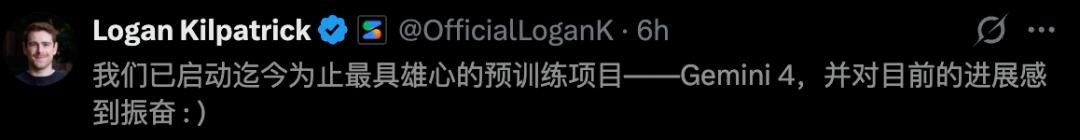
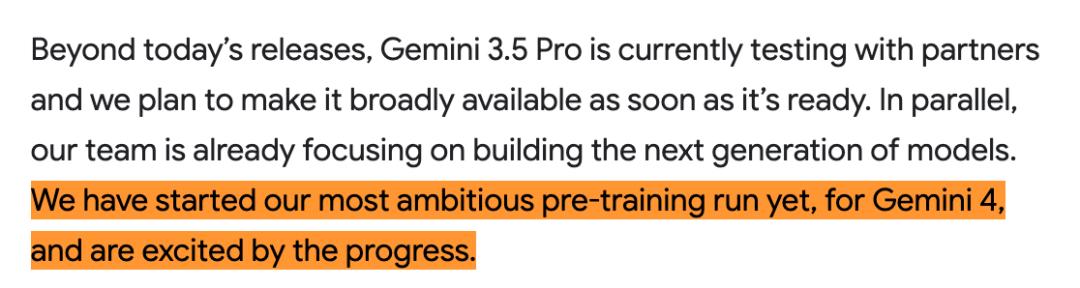
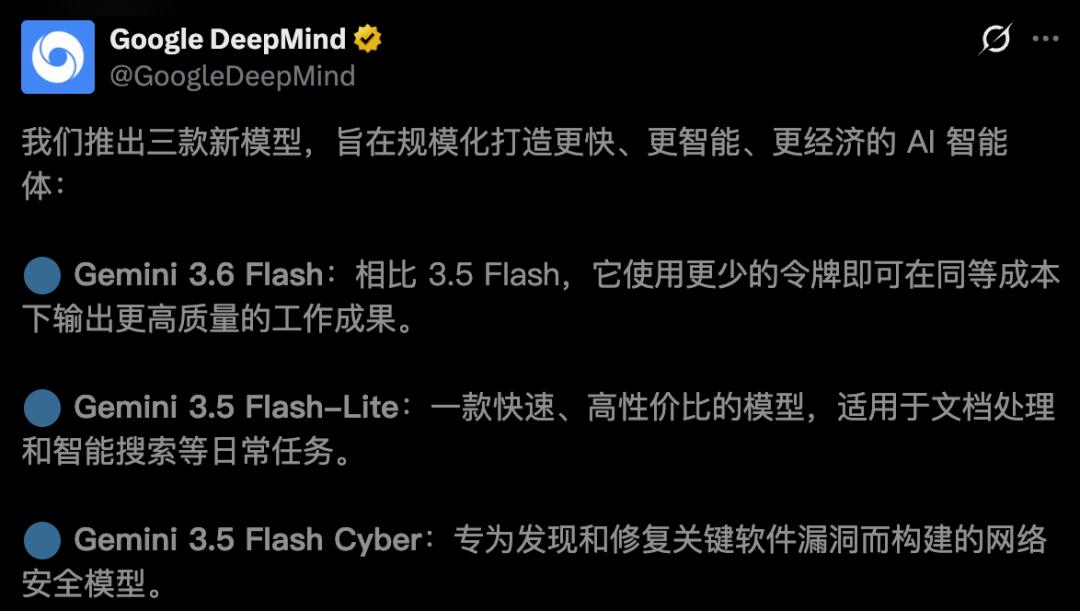
人工智能领域的竞争格局正在经历一场深刻的重塑,这种重塑不再仅仅体现为模型参数量的无限膨胀,而是转向了对效率、成本与应用落地场景的极致打磨。就在近期,谷歌DeepMind通过一场高密度的产品发布,向市场传递了明确信号:AI进入“精耕细作”时代。本次发布不仅涵盖了针对主力应用、轻量级高并发场景以及垂直安全领域的三款新模型,更披露了下一代Gemini 4的激进预训练计划。这一系列动作的核心逻辑,在于通过技术迭代显著降低Token消耗与推理成本,从而推动AI Agent在生产环境中的规模化部署。
主力军迭代:Gemini 3.6 Flash的“降本增效”革命
在此次发布的三款模型中,Gemini 3.6 Flash无疑承担了主力军的角色。对于从事大模型应用开发的企业而言,Token成本一直是制约业务规模化扩张的关键瓶颈。Gemini 3.6 Flash的出现,直击这一痛点,其最引人注目的特性是对Token消耗的极致压缩。
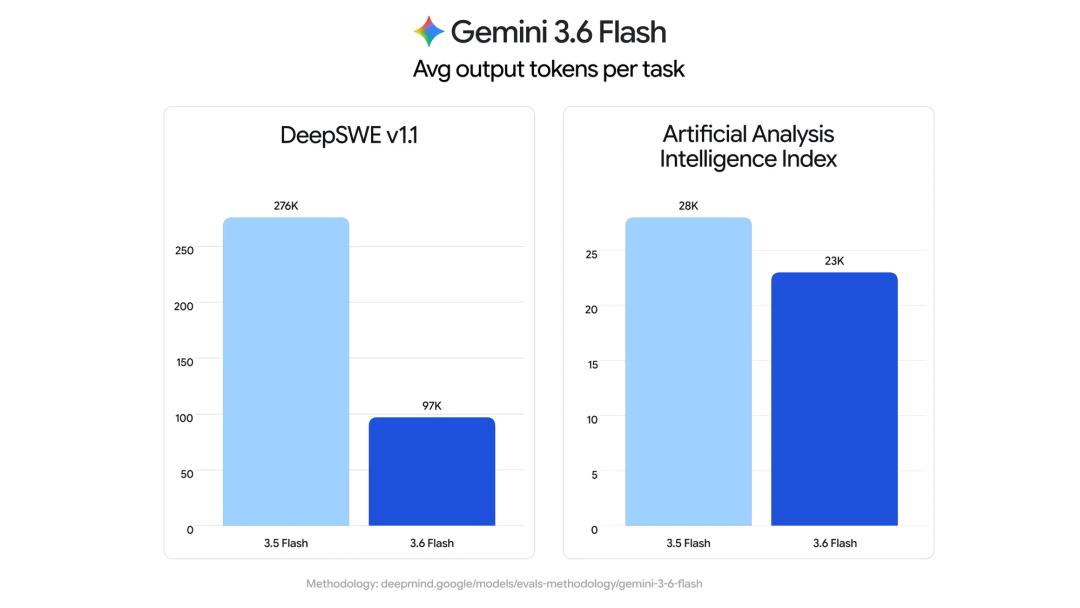
根据第三方权威机构Artificial Analysis Index的测算,相较于上一代Gemini 3.5 Flash,3.6 Flash在输出端能够减少约17%的Token用量。这一数据在通用场景下或许显得温和,但在复杂的编码与逻辑推理任务中,其优势则被显著放大。在DeepSWE等编程基准测试中,3.6 Flash的最高Token节省比例达到了惊人的65%。这意味着,在处理相同的代码迁移或重构任务时,企业所需的算力成本大幅降低,而响应速度并未因此受损。
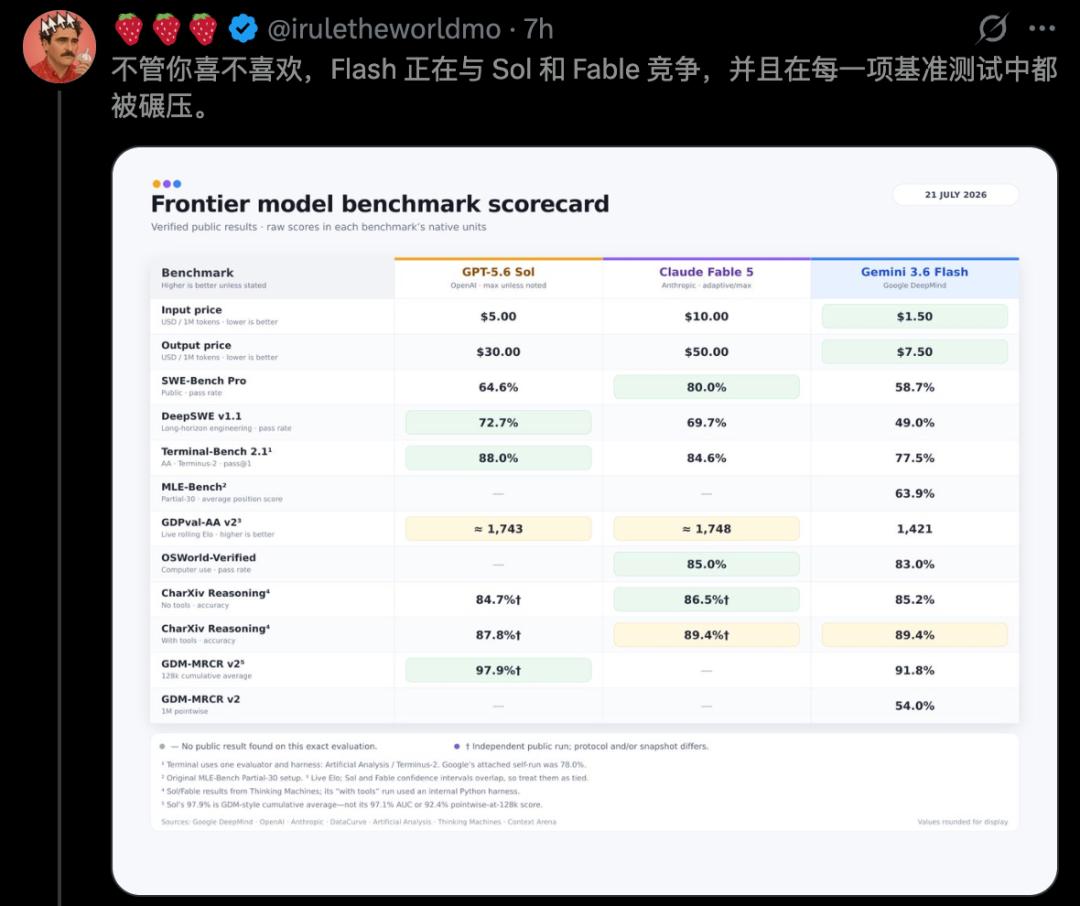
这种“省时省力”的背后,是模型推理路径的优化。3.6 Flash在完成多步任务时,所需的推理步骤和工具调用次数均有所减少。换言之,模型在解决问题时更少地“走弯路”,直接通过更高效的逻辑链条达成目标。这种效率提升直接转化为经济价值:3.6 Flash的定价策略同样极具侵略性,输入价格为每百万Token 1.5美元,输出为7.5美元,较前代产品进一步下探。
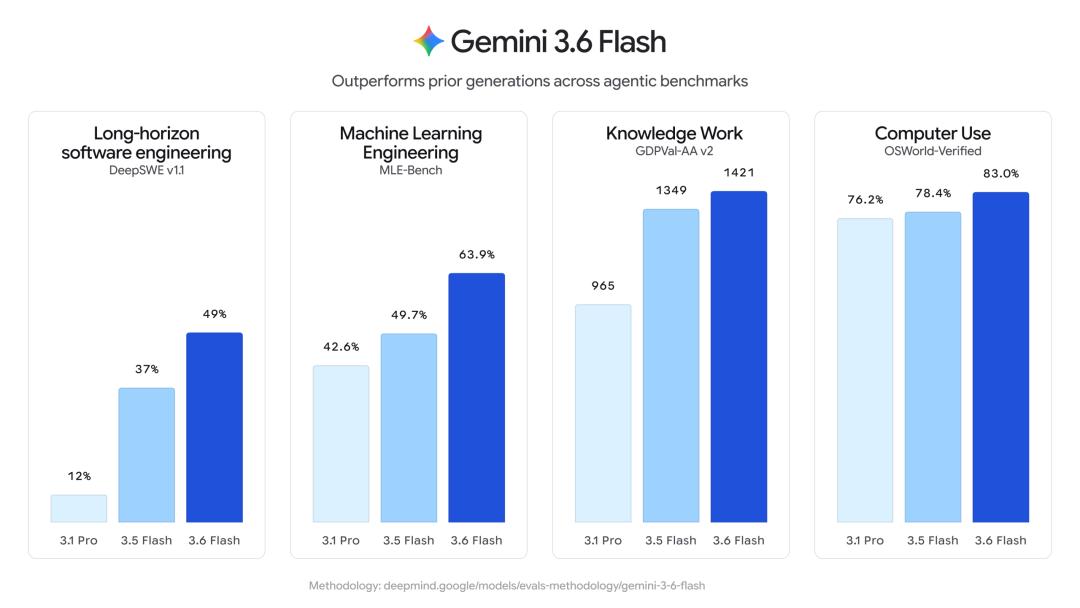
性能与成本的双优表现,使得3.6 Flash在多项关键基准测试中实现了对前代的超越。在DeepSWE编程测试中,得分从37%跃升至49%;在MLE Bench机器学习研究测试中,从49.7%提升至63.9%;在OSWorld-Verified操作系统控制测试中,从78.4%提升至83%。此外,在GDPVal-AA v2知识型工作任务中,其处理能力覆盖了1421份任务,得分比上一代高出70多分。
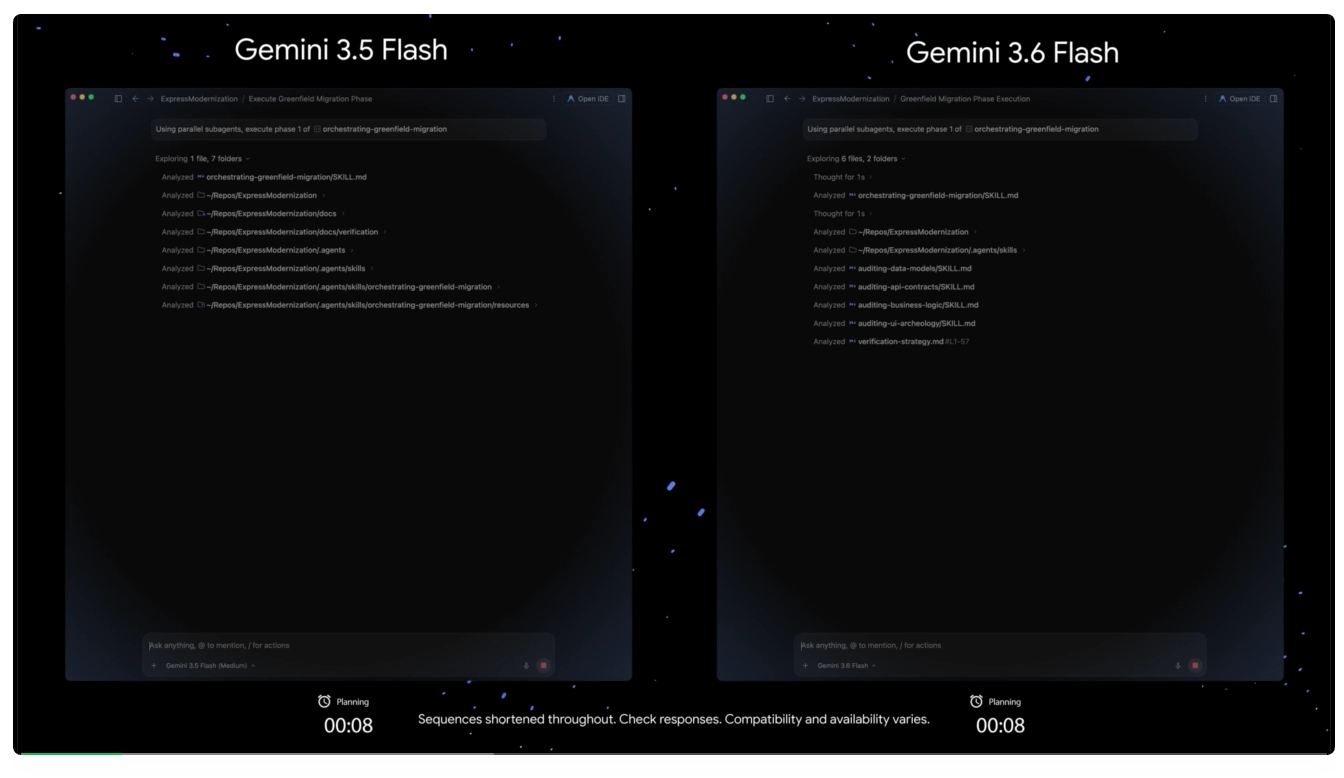
在实际应用场景中,3.6 Flash展现出强大的多智能体编排能力。例如,在复杂的代码迁移任务中,它不仅能轻松完成任务分解与执行,还在响应速度和代码质量上对旧版模型形成了降维打击。借助Gemini Canvas,它还打通了3D工作流,能够快速构建专业的摄影级纹理提取工具,甚至化身交互设计师,生成沉浸式主题工作室。这种从底层代码优化到上层创意生成的全方位能力提升,标志着Gemini 3.6 Flash已成为当前生产力型AI应用的强力引擎。
轻量级突围:Flash-Lite的高并发与反直觉胜利
如果说Gemini 3.6 Flash是追求极致性能的“主力大脑”,那么Gemini 3.5 Flash-Lite则专为海量数据处理和高并发场景而生。该模型主打两个关键词:极速与低价。其输出速度高达每秒350个Token,是Gemini 3.5系列中最快的模型。同时,其定价低至每百万Token输入0.3美元、输出2.5美元,这一价格门槛使得在大规模文档处理、实时搜索辅助等高频场景中部署AI Agent成为可能。
值得注意的是,Flash-Lite在性能表现上呈现出一种“反直觉”的胜利。在多项编程和Agent测试基准中,这个体量较小的轻量级模型竟然跑赢了体量更大的Gemini 3 Flash。例如,在SWE-Bench Pro测试中,Flash-Lite得分54.2%,高于3 Flash的49.6%;在OSWorld-Verified测试中,得分达到74.0%,远超3 Flash的65.1%。
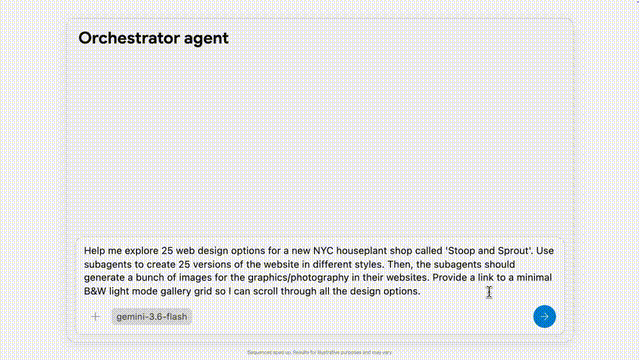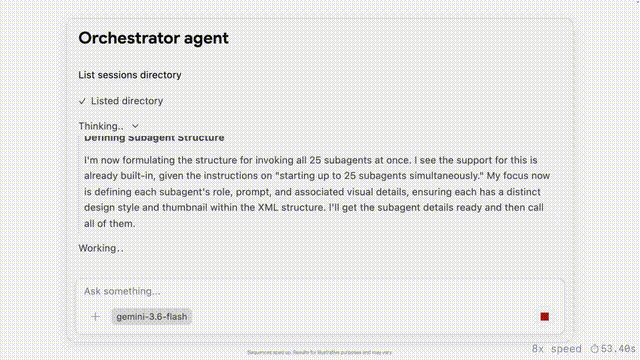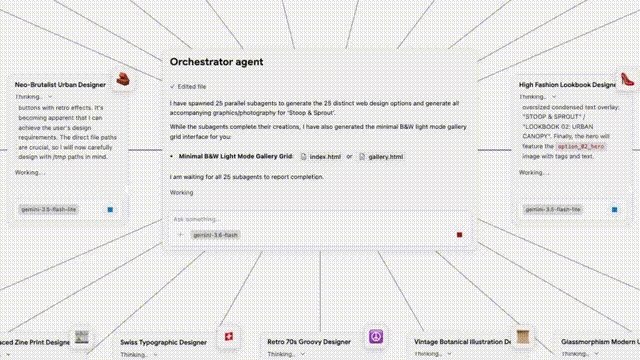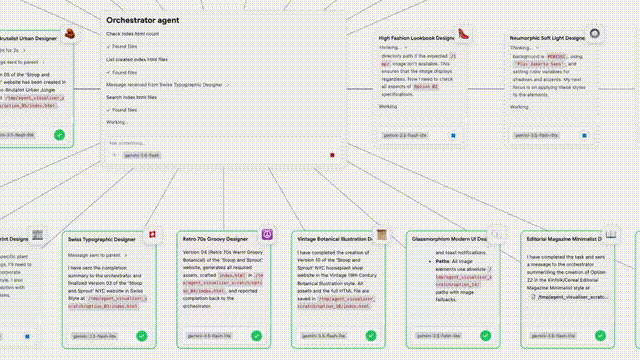
这一现象揭示了当前AI模型架构演进的一个重要趋势:模型的绝对体量并不总是与性能划等号,针对性的架构优化和数据质量提升往往能带来更显著的效率增益。Flash-Lite的成功,为那些需要处理大规模并发请求的场景提供了新的解题思路。在实际演示中,Flash-Lite能够一口气直出25套高可用网页设计方案,速度快到近乎“即时生成”。
这种“主脑+分身”的协作模式正在成为Agent开发的新范式。Gemini 3.6 Flash作为“主脑”,负责复杂任务的拆解与规划;而多个Flash-Lite作为“分身”,批量执行具体的子任务。这种分工协作不仅有效抹平了高并发带来的压力,还通过规模化部署大幅降低了单次调用的边际成本。目前,Flash-Lite已上线Gemini App,并计划逐步融入谷歌搜索体系,进一步拓展其应用边界。
垂直领域深耕:Flash Cyber的安全防线构建
在追求速度与效率的同时,AI的安全性始终是行业不可忽视的议题。Gemini 3.5 Flash Cyber正是为此而生,它是一款专攻网络安全的硬核模型,专注于代码漏洞的发现与修复。
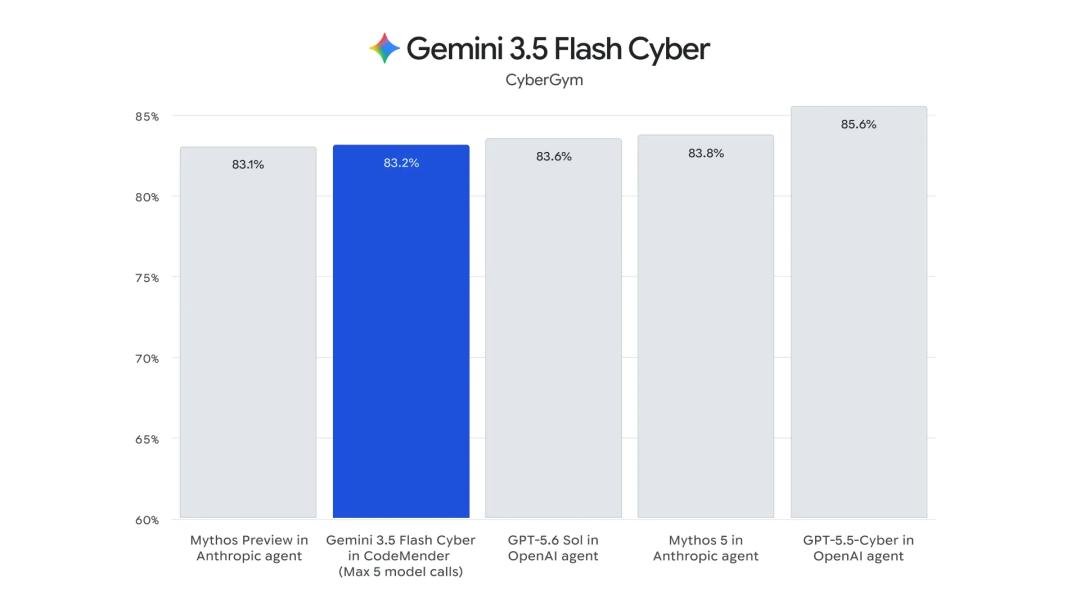
当前,AI辅助找漏洞的速度已经快于现有系统修复漏洞的速度,这一“安全剪刀差”给企业带来了巨大的风险敞口。谷歌通过将Flash Cyber集成到代码安全智能体CodeMender中,构建了多智能体协同作战的安全防御体系。在CyberGym安全基准测试中,该模型刷新了SOTA记录,且其运行成本低于更大规模的通用模型。
Flash Cyber的设计理念是用更轻量的模型处理最需要高精度的安全任务。虽然该模型目前暂不对普通用户开放,但其技术验证了专用小模型在垂直领域超越通用大模型的可行性。随着AI在代码生成和系统集成中的深度渗透,自动化漏洞扫描与修复将成为基础设施的一部分,Flash Cyber的发布预示着AI在网络安全领域的角色从“辅助工具”向“核心防御力量”转变。
未来展望:Gemini 4与AI应用的成本革命
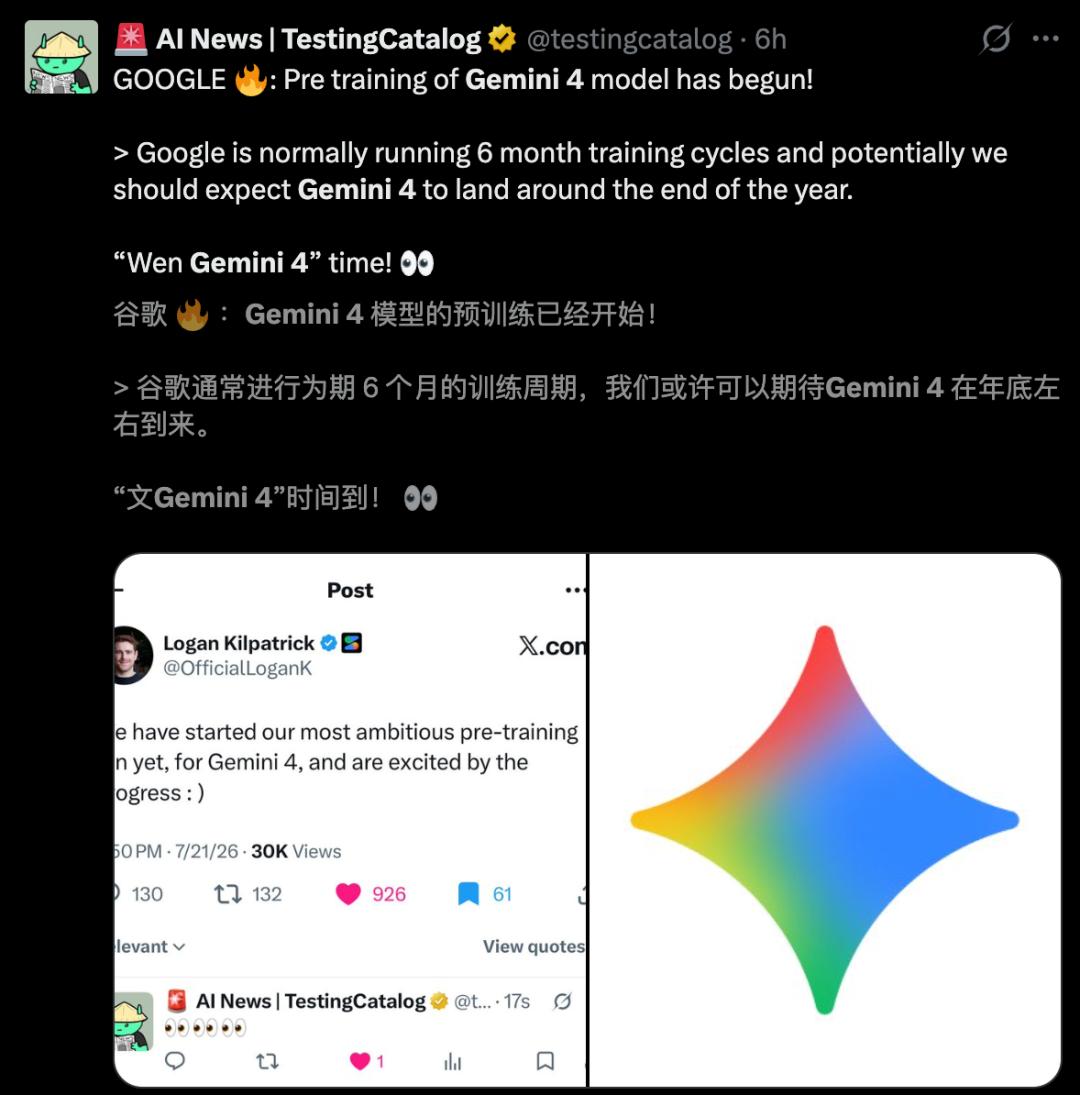
尽管Gemini 3.5系列尚未全面普及,谷歌已确认启动了“史上最激进”的预训练计划,目标直指下一代Gemini 4。按照常规的六个月训练节奏,业界预计Gemini 4有望在年底亮相。这一消息无疑为市场注入了强心剂,表明谷歌在模型能力上的竞赛并未放缓,反而正在加速。
然而,对于当前的开发者与企业而言,真正的红利并非来自遥远的“期货”,而是今日即可落地的Gemini 3.6 Flash、Flash-Lite等产品。本次发布的核心理念可以用一个字概括:“降”。价格下降、Token消耗降低、Agent运行成本下降。这一趋势将直接利好那些真金白银投入AI基础设施建设的团队。
AI Agent的商业化落地,长期以来受限于高昂的推理成本。当单次调用的成本显著降低,且处理效率大幅提升时,AI应用的边界将被无限拓展。从简单的问答机器人到复杂的自动化工作流,从实时数据分析到多模态创意生成,更低成本的算力支持将使得大规模部署成为常态。
谷歌此次“三连发”策略,清晰地展示了其市场竞争逻辑:通过细分场景覆盖不同需求,通过极致优化降低门槛,通过持续迭代保持领先。对于行业而言,这不仅是一次产品的更新,更是AI应用开发范式的一次转折。未来,衡量AI价值的标准,将不再仅仅是模型的智商高低,更是其在实际生产环境中的经济性、稳定性与安全性。
随着Gemini 4预训练的开启,我们可以预见,下一阶段的竞争将更加激烈。但对于开发者来说,当下的机遇已经明朗:利用现有的高效、低成本模型,快速构建并验证Agent应用,将是抢占市场先机的关键。AI这场终极牌局,好戏才刚刚开场,而成本的降低,正是让这场游戏走向全民参与的门票。