真实工作流数据:AI训练新范式与企业自研模型的战略抉择
在人工智能发展的宏大叙事中,我们正站在一个关键的转折点上。过去几年,大语言模型的进步主要依赖于对互联网公开海量数据的吞噬与消化,然而,这座矿藏并非取之不尽。当通用语料被挖掘殆尽,行业目光开始转向一处尚未被充分开采的金矿——企业真实工作流中产生的数据,即Real-world Data。这不仅是数据来源的简单切换,更是AI训练范式的一次深刻重构。
这一趋势背后隐藏着供需结构的巨大错位。头部模型实验室往往拥有顶尖的机器学习工程师团队,却极度缺乏高质量、特定领域的真实场景数据;反之,大型企业坐拥丰富的业务流程数据和领域知识,却缺乏将其转化为模型可理解、可训练格式的技术能力。这种结构性矛盾催生了两类新兴市场主体:一类是专注于为模型实验室提供高质量人类数据的服务商,另一类则是为企业提供RLaaS(强化学习即服务)的公司,它们通过外包MLE咨询、搭建Agent系统及提供后训练服务,帮助企业将业务流程转化为可训练的模型环境。
数据市场的本质是一场永不停歇的冲浪运动。每当模型的能力瓶颈被突破,最有价值的数据形态就会发生演变。早期,Scale AI等公司凭借自动驾驶和基础LLM的数据标注崛起;随后,Mercor、Surge AI等抓住了专家数据浪潮。如今,随着Long Horizon(长程任务)成为模型进化的关键主线,任务单位从单行代码扩展至整个项目,人工构建沙盒环境的难度呈指数级上升。真实项目中复杂的历史状态、工具依赖和组织规则,无法靠专家凭空编造,这使得源自真实工作流的Type 1数据变得前所未有的珍贵。
当前市场上的数据大致可分为两类:Type 1是从真实工作中捕获的“过程录像”,如GitHub上的Commit message、Issue解决记录等,它不仅记录动作,更还原了意图与决策路径;Type 2则是人为构造的数据,由专家在预设环境中完成任务。虽然Type 2适合预训练阶段,但在处理高经济价值的长链路任务时,Type 1数据的优势无可替代。然而,纯粹的Type 1数据获取难度极大,因此,具备工程化能力的中间形态Type 1.5成为主流选择。这要求数据供应商不仅要绑定高质量专家,更要建立多层级的自动化QA体系,防止人类标注员的Reward Hacking行为,并通过异常检测和贡献者行为分析,将质量控制嵌入生产流程。
在设计训练数据时,Hillclimbability(爬坡能力)是核心考量指标。许多供应商误以为设计出模型无法完成的任务就能证明价值,实则不然。真正有价值的任务应卡在模型能力的边界上,即模型在少量尝试后有一定概率成功,而非完全不可解。例如,若模型在32次尝试中有30%的成功率,说明其已触及成功路径,具备通过训练进一步优化的潜力;若256次尝试仍全败,则任务可能过于偏门或远超当前能力,不具备训练价值。此外,数据失真、Eval失真以及QA不可规模化是当前市场的三大痛点,唯有具备Data Taste、Research Taste和Scalability三重能力的供应商,才能赢得模型实验室的信任。
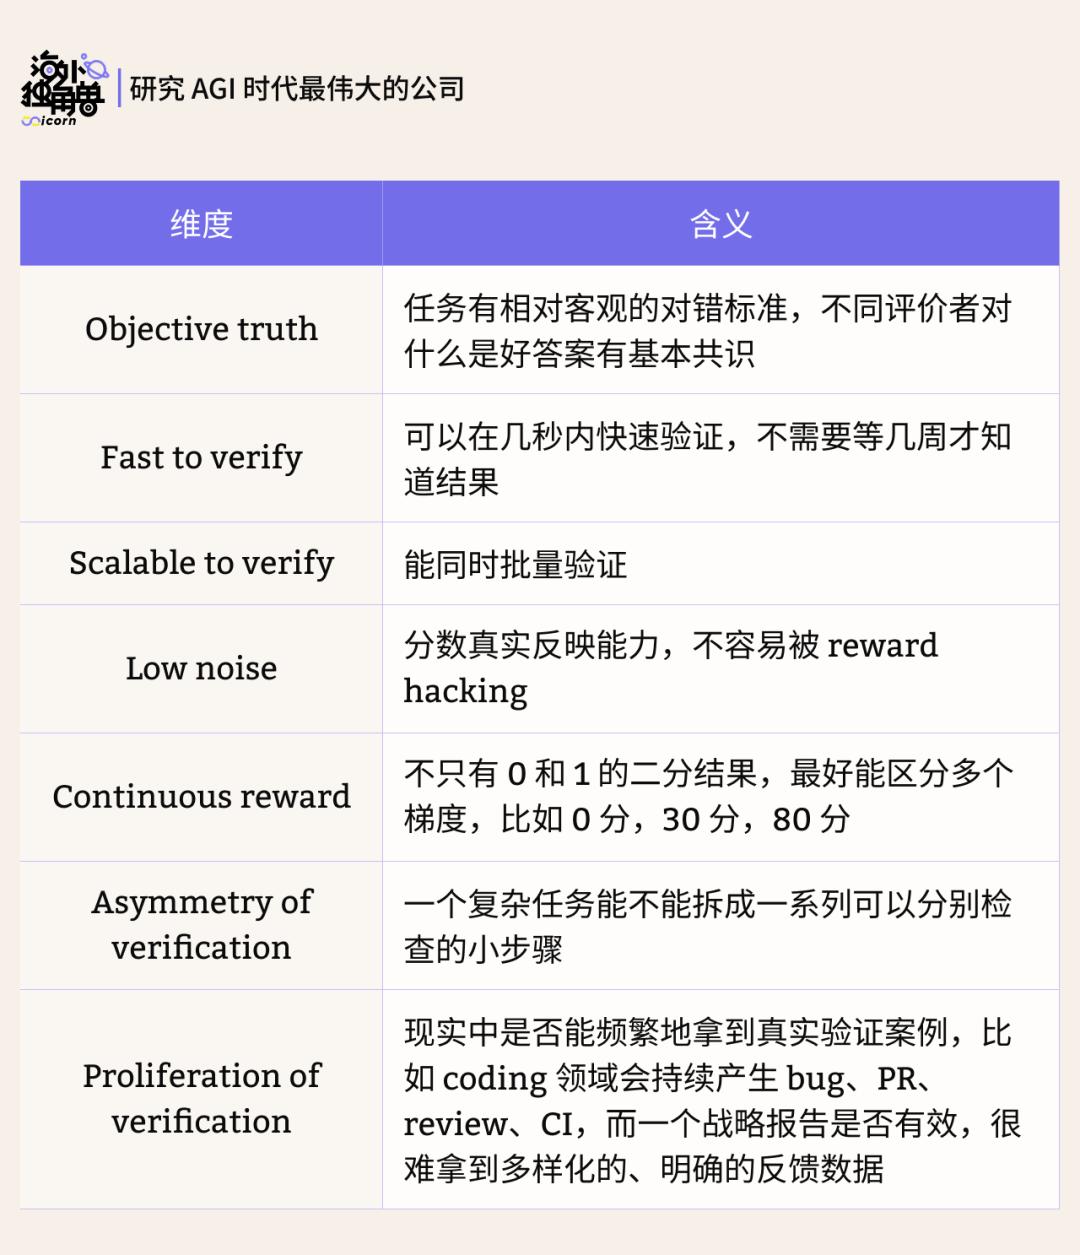
随着Agent系统的普及,RL环境的复杂度也在急剧提升。未来的Agent不再局限于单一沙盒,而是穿梭于多个环境之间,调用不确定性的工具,并由多个Sub-agent协同完成复杂任务。Jason Wei提出的Verifier's Law指出,任务的可验证性决定了训练的效率。代码之所以适合强化学习,是因为环境易于复制、并行和重置,模型可以通过海量试错堆叠能力。然而,真实世界缺乏这样的“存档点”,如销售、法律等领域反馈稀疏且因果模糊,难以通过暴力刷题提升性能。因此,提高Sample Efficiency(样本效率)成为关键。
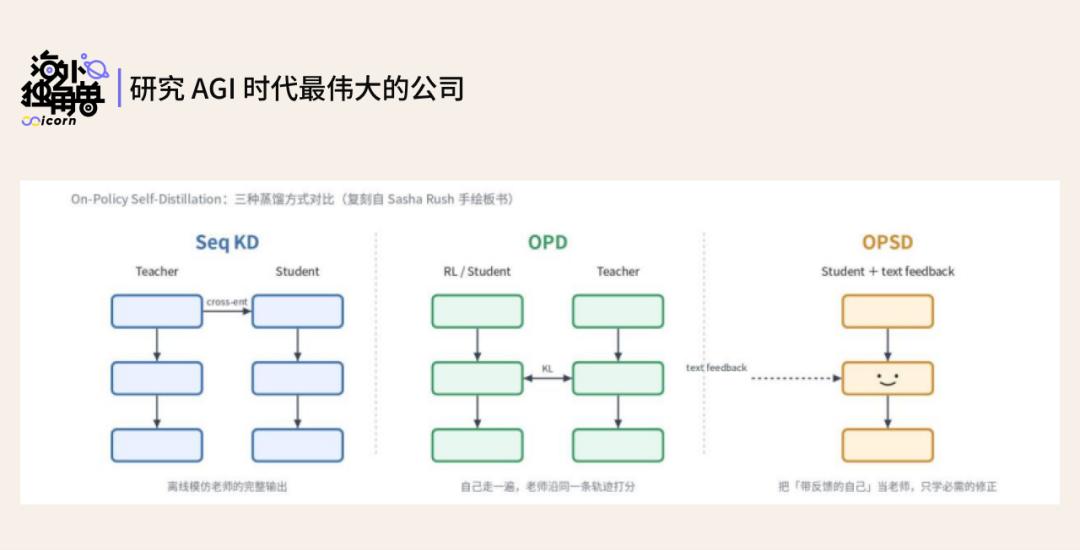
为解决这一问题,业界提出了两种前沿思路:OPSD(On-Policy Self-Distillation)和Dreaming。OPSD是一种经验压缩机制,让熟悉业务上下文的“老员工模型”作为Teacher,指导基础模型学习决策策略,从而将稀疏的现实反馈转化为密集的训练信号。Dreaming则类似于人类的复盘与想象,模型基于内部World Model进行模拟推演,在虚拟环境中反复练习不同策略,从而在有限的真实交互中提取更多规律。这两种方法有望在Pre-training和RL之外,开辟出一条新的Scaling路径。
面对这一变革,企业是否应该自建Post-training流程?这本质上是用Capex(资本支出)换取Opex(运营支出)的战略抉择。判断这一投资是否成立,需考量四个乘数:数据独特性、Eval清晰度、任务频率和单次改善价值。以DoorDash为例,其菜单录入任务具有极高的内部规则独特性和高频次特征,通过自研小模型结合内部数据进行RL训练,显著降低了对外部API的依赖并提升了准确率。同样,Cursor通过自研模型,不仅避免了向竞争对手支付高昂的API费用,还实现了针对Coding场景的专项优化,避免了通用模型在多任务平衡中的能力退化。
应用公司自建模型的最大优势在于占据了真实用户的工作流入口,天然拥有高质量的Agentic Trajectory Data。这些数据在外部市场极其昂贵,且包含了用户隐性的偏好信息,如接受或拒绝结果、修改幅度等,可转化为DPO等训练方法所需的Preference Pair。对于垂直领域AI公司而言,利用这些独家数据进行Post-training,不仅能构建深厚的护城河,还能在特定场景下实现超越通用大模型的性能表现。
综上所述,Real-world Data正在重塑AI产业的底层逻辑。从数据供应商的工程化转型,到RL环境的技术突破,再到企业自研模型的战略布局,每一个环节都蕴含着巨大的创新机会。未来,那些能够高效捕获、清洗并利用真实工作流数据,并将其转化为模型智能的企业,将在新一轮的AI竞争中占据主导地位。这不仅是一场技术的竞赛,更是一场关于数据资产化认知与执行力的较量。