27B模型装入手机:PrismML如何用1-bit技术重构AI智能密度?
在人工智能发展的前半程,行业共识几乎被“Scaling Law”所垄断:更多的参数、更大的数据集、更强的算力,必然带来更智能的模型。然而,当这一逻辑延伸至物理世界时,其局限性暴露无遗。对于机器人、自动驾驶汽车、智能手机以及物联网设备而言,庞大的模型体积意味着难以接受的延迟、昂贵的能耗以及无法规避的隐私风险。AI的下一轮进化,或许不再取决于“大”,而在于“精”。
近期,由加州理工学院(Caltech)教授Babak Hassibi创立的初创公司PrismML,正试图打破这一僵局。该公司提出的核心概念——“智能密度”(Intelligence Density),标志着AI模型优化方向从单纯的规模扩张转向了对单位资源下智能产出的极致追求。通过将大模型无损压缩,PrismML不仅让27B参数规模的模型得以在iPhone上流畅运行,更展示了AI从云端走向边缘的完整路径。
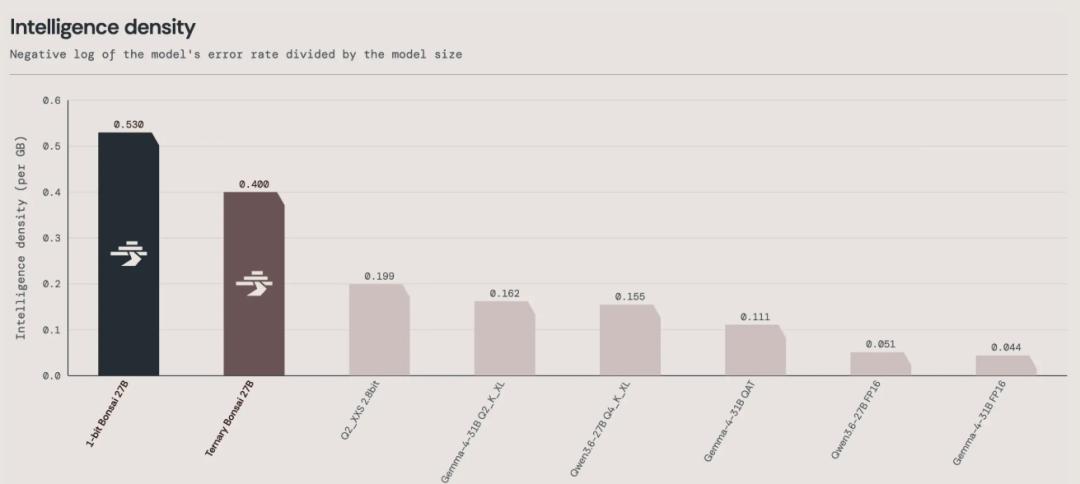
从Scaling Law到“智能密度”:范式的必然转向
过去五年,大语言模型(LLM)的性能提升主要依赖于参数量级的指数级增长。虽然这种方法在基准测试中屡创佳绩,但其部署成本高昂,严重依赖数据中心基础设施。对于实时性要求极高的应用场景,如自动驾驶或即时翻译,云端部署带来的网络延迟和数据传输风险往往是致命伤。
PrismML的切入点并非继续优化算法架构,而是重新审视模型权重的表示方式。传统模型通常使用16位浮点数(FP16)存储权重,而PrismML则探索了极致的量化路径:二值(1-bit)与三值(约1.71-bit)模型。
在这个框架下,权重不再是精确的浮点数值,而是被压缩为简单的正、负状态(1-bit)或正、负、零状态(3-value)。这种压缩并非简单的粗暴截断,而是通过特定的缩放系数保持模型的表达能力。据PrismML披露,其1-bit模型每个权重的实际平均占用仅为1.125 bit。这种极致的压缩使得模型体积大幅缩减,同时因数据移动量的减少,显著降低了内存带宽压力和推理能耗。
技术内核:端到端的原生量化
PrismML的技术壁垒在于其“端到端原生1-bit”设计。不同于其他公司采用的训练后量化(PTQ)或仅对部分层进行微调的方案,PrismML从嵌入层(Embeddings)、注意力层(Attention)、多层感知机(MLP)到输出层,全部采用二值或三值权重。
这种全链路压缩要求模型在训练阶段就适应低精度表示。PrismML研发了专用的推理内核,直接在压缩格式上进行计算,无需在运行时将数据解包为FP16。这一架构优势显而易见:它不仅缩小了模型体积,更消除了“解包-计算-打包”过程中的数据搬运开销,从而实现了推理速度的倍增。
Babak Hassibi作为联合创始人及首席技术顾问,其背景为这一技术路线提供了坚实的理论支撑。作为信息论与控制领域的专家,他早在1990年代便参与了神经网络剪枝方法Optimal Brain Surgeon的开发,擅长利用二阶信息识别并移除冗余参数。这种深厚的学术积淀,使得PrismML能够在不显著损失性能的前提下,将模型压缩至极小体积。
实战验证:27B模型“塞进”手机的可行性
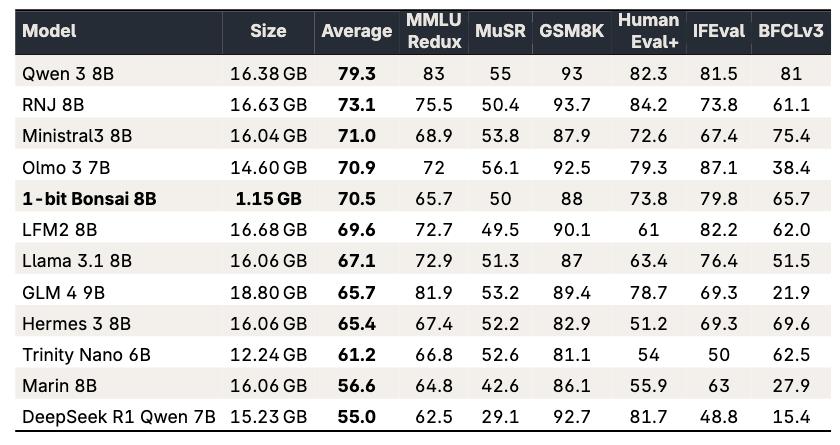
PrismML的成果已通过多款标杆产品得到验证。其推出的Bonsai 8B模型,体积仅为1.15 GB,比同参数规模的Llama 3 8B缩小了14倍,推理速度提升8倍,能效提高4-5倍。这一体积足以轻松容纳在iPhone 17 Pro中,并在本地实现实时推理。
更具突破性的是Bonsai 27B模型的发布。基于Qwen3.6 27B架构打造,这是首款在同等能力级别下可在手机上运行的27B规模模型。27B参数通常被认为是进入“复杂推理”门槛的关键节点,能够处理多步推理、结构化工具调用以及复杂的视觉任务。
测试数据显示,在GeForce RTX 5090上,Bonsai 27B的1-bit版本推理速度高达163 tokens/秒;在搭载M5 Max芯片的Mac上,速度可达87 tokens/秒;即便是在iPhone 17 Pro Max上,也能保持约44 tokens/秒的流畅体验。这一性能表现彻底颠覆了“大模型必须上云”的传统认知。
此外,Bonsai 27B支持通过MLX在苹果生态原生运行,也兼容NVIDIA的CUDA架构,展现了极高的跨平台兼容性。这种灵活性对于希望在不同硬件环境中部署AI的企业而言,极具吸引力。
混合部署架构:重塑AI成本与体验
PrismML带来的不仅是模型变小,更是系统架构的重构。随着本地模型能力的增强,一种“混合部署”(Hybrid Deployment)模式应运而生。在这种模式下,非极限、隐私敏感型或高频重复的任务由本地模型处理,而云端保留最强大的前沿模型用于处理极端复杂或需要最新知识的任务。
这种架构的优势是断崖式的成本下降与体验提升。首先,本地推理消除了数据传输带宽需求,降低了网络成本;其次,数据无需离开设备,从根本上解决了隐私合规问题;最后,本地响应的即时性提升了用户交互的自然度。
对于企业级应用而言,这意味着可以构建全天候运行的端侧智能体、实时响应的机器人以及离线可用的企业Copilot。特别是在带宽受限、功耗敏感或存在严格数据合规要求的场景下(如军事、医疗、工业控制),本地化部署成为唯一可行的解决方案。
结语:智能分布化的未来
PrismML的实践表明,AI模型的进化正从“追求绝对规模”转向“提升智能密度”。未来的竞争焦点,将是谁能以更低的资源代价,将更强的智能带入更广阔的物理世界。
这不仅是技术的胜利,更是AI落地逻辑的根本转变。当27B模型能够像文本文件一样轻松存储在移动端时,AI将不再局限于服务器机房,而是嵌入到每一个角落。从个人助理到工业机器人,从可穿戴设备到自动驾驶系统,智能密度将成为衡量下一代AI竞争力的核心指标。
随着PrismML等团队的推进,我们有望看到AI真正融入物理世界的每一个角落,实现从“云端智能”到“分布智能”的跨越。这一过程并非替代,而是互补:云端负责知识的广度与深度,边缘负责感知的速度与隐私,共同构成一个高效、安全、普惠的智能网络。