360六篇顶会论文背后的产业AI逻辑:为何安全基因重塑基座模型?
重新审视AI基座模型的价值坐标
在人工智能技术迭代日新月异的当下,公众对AI的关注往往聚焦于对话机器人的幽默感、图像生成的艺术性或大语言模型的创意广度。然而,当一家拥有深厚安全背景的企业切入基座模型研发时,其技术路线的指向性便呈现出截然不同的特征。2026年上半年,360人工智能研究院在ICLR、CVPR、ICML、ECCV等顶级学术会议上集中亮相的六篇论文,并非孤立的学术成果展示,而是映射出一条以“安全基因”为内核的产业AI演进路径。
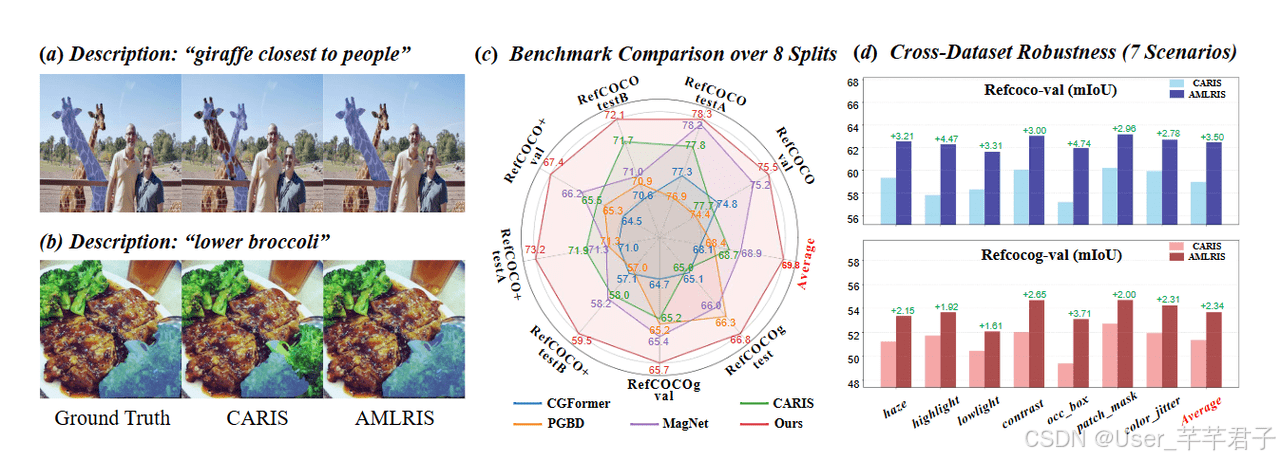
这种差异并非源于技术能力的优劣,而是源于应用场景的根本不同。消费级AI追求的是惊艳的用户体验和无限的创意边界,而产业级AI,特别是那些处于关键业务环节的AI系统,首要任务是确保在极端、复杂且充满噪声的真实环境中依然能够稳定、可靠、可控地运行。安全公司对鲁棒性、精确性和可解释性的极致追求,恰好与产业AI对Agent执行力和生产环境适应性的核心需求高度契合。这不仅是技术路线的选择,更是商业逻辑的自然延伸。
多模态理解的深化:从“看得清”到“定得准”
在视觉感知层面,消费级模型往往满足于整体语义的通识性理解,而在产业应用中,细微的差别往往决定成败。360在FG-CLIP 2和AML两项研究中的突破,正是为了解决这一“最后一公里”的精度问题。
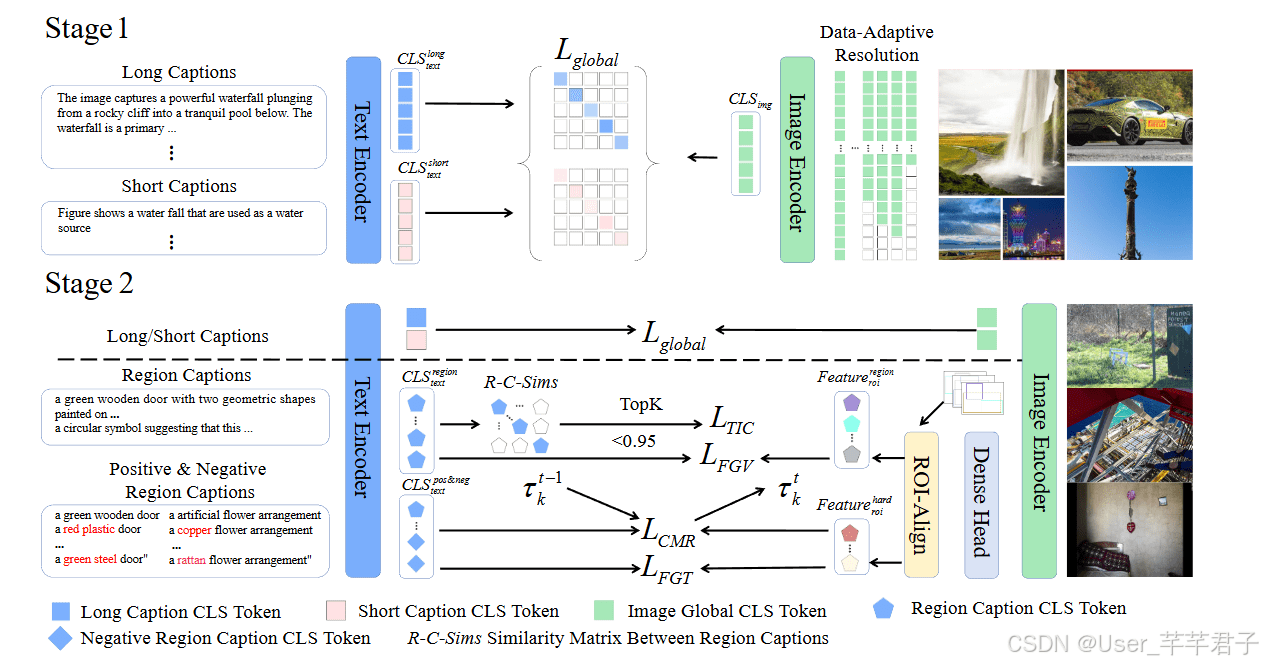
FG-CLIP 2针对的是传统多模态检索模型中存在的“近视”现象。在电商检索、云盘文件查找或企业知识库搜索中,仅仅识别出“这是一只狗”是远远不够的,系统需要区分“戴红项圈的棕色小狗”和“戴蓝项圈的白色大狗”。FG-CLIP 2通过双阶段层次化训练架构,引入了全局对齐、细粒度视觉与文本学习以及全新的文本模态内对比损失。特别是其发布的FineRegion-CN数据集,包含1200万张中文区域-文本对,填补了业界在中文细粒度视觉语言对齐上的数据空白。这种对细微差异的捕捉能力,使得模型在面对语义相近但实体不同的对象时,能够实现真正的精准匹配,而非模糊的相关性排序。
如果说FG-CLIP 2解决了“是什么”的问题,那么AML(Alignment-Aware Masked Learning)则解决了“在哪里”以及“在干扰下是否依然准确”的问题。在GUI Agent、自动化办公等场景中,界面元素常被遮挡、光照条件多变或存在大量视觉噪声。传统的方法在此类OOD(分布外)场景下极易失效。AML通过引入PatchMax Matching Evaluation量化对齐质量,并利用Alignment-aware Filtering Mask屏蔽低置信度区域,确保模型只在高质量对齐的特征上进行梯度更新。更重要的是,这一改进在不增加推理开销的前提下,显著提升了模型在遮挡、强光、雾化等7种扰动场景下的鲁棒性。对于需要在真实物理世界和数字界面中持续运行的Agent而言,这种在扰动中保持定位准确的能力,是区分实验室Demo与工业级产品的关键分水岭。
可控生成工程化:让AI从“创作”走向“修改”
生成式AI在产业界的落地,难点不在于从零生成一张完美的图片,而在于如何对已有内容进行精准、可控的修改。消费级应用容忍一定的随机性和不可控性,但商业设计、电商展示和视频后期制作要求严格的确定性。
RevealLayer的研究直击图像编辑中的痛点:将RGB图像分解为可独立编辑的RGBA图层。传统的多阶段级联方法(如先分割再抠图最后补全)会导致误差累积,而端到端方法往往缺乏显式的控制接口。RevealLayer通过Region-Aware Attention约束跨区域交互,利用Occlusion-Guided Adapter补全被遮挡内容,并结合复合损失函数将边界精度提升至像素级。这一技术使得用户能够通过简单的框选操作,将图像中复杂的前景、背景及被遮挡部分分离为独立图层。对于营销创意、商业视觉设计等领域,这意味着AI不再只是一个黑盒生成器,而是一个具备层级化管理能力的编辑工具,极大地降低了专业内容生产的门槛。
在垂直领域的应用上,RefTON针对虚拟试衣中的材质还原难题提出了创新方案。现有方法多依赖姿态估计、图像分割等多个外部模型,流程冗长且难以还原透明蕾丝、复杂纹理等细节。RefTON借鉴人类购物的视觉参考逻辑,引入“上身参考图”作为指引,无需任何辅助模型即可实现高精度的虚拟试衣。这不仅简化了部署流程,更关键的是解决了电商场景中直接影响转化率材质细节模糊的问题,填补了“看起来像”与“穿起来真”之间的产业鸿沟。
架构优化与端侧落地:打破算力与精度的零和博弈
大模型在云端展示强大能力的同时,也面临着高昂的算力成本和巨大的推理延迟,这限制了其在移动端、IoT设备和车机系统中的普及。NAMI的研究旨在打破高分辨率图像生成中“效果”与“速度”的二元对立。
NAMI采用了一种桥接渐进式Rectified Flow架构,将生成过程按分辨率拆分为低分辨率的轮廓搭建阶段和高分辨率的细节打磨阶段。其核心创新在于BridgeFlow模块,它确保了不同分辨率阶段之间的流能够精准对齐,避免了生成过程中的断层现象。结果显示,在保持与国际顶尖模型相当的画质和文本语义对齐能力的前提下,NAMI将1024×1024分辨率图像的推理时间降低了64%。这一突破对于边缘计算场景意义重大,它使得高质量的多模态AI能力能够下沉至资源受限的终端设备,实现了算力效率与用户体验的双赢。
无监督范式的突破:MoSA与数据的可持续性
除了针对具体任务的优化,360在基础模型训练范式上的探索同样值得关注。ECCV 2026收录的MoSA(Motion-Grounded Segment Anything)论文,提出了一种仅通过观察运动即可无监督学习物体概念的新路径。
传统的视觉基础模型如SAM,严重依赖大规模人工标注数据(如SA-1B),这构成了模型持续扩展的根本瓶颈。MoSA基于格式塔理论中的运动线索驱动原理,设计了多粒度运动分割、知觉分组模型和自适应迁移三个步骤。通过在近1万小时无标注视频上的训练,MoSA能够自动生成超过2100万个高质量伪标签,并在多个零样本基准上超越现有无监督方法,性能甚至接近完全监督的SAM。
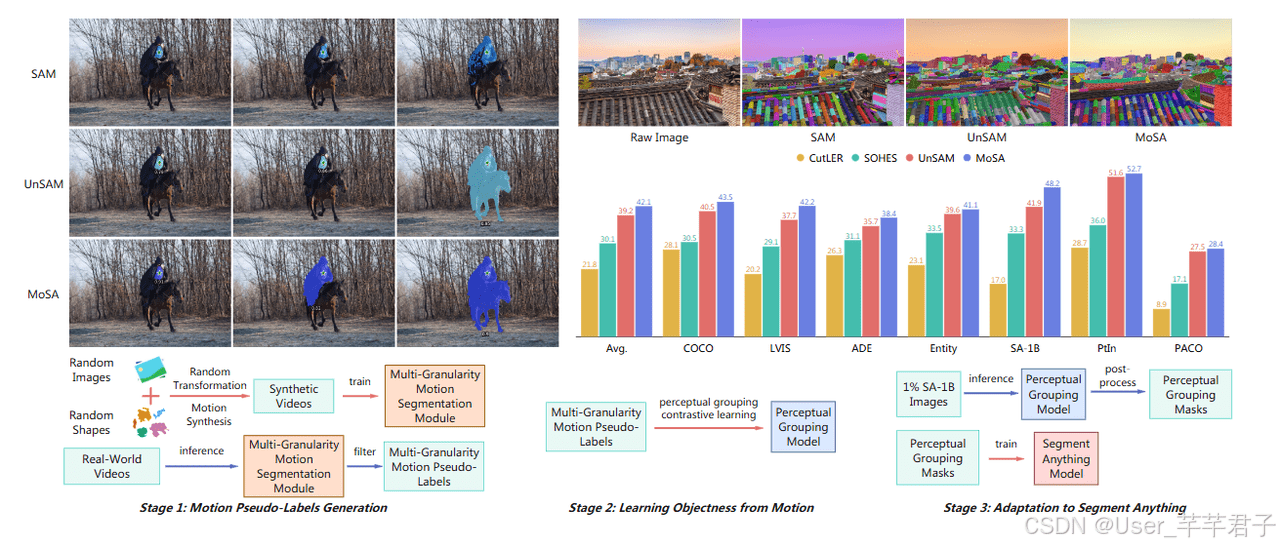
MoSA的意义在于探索了降低数据依赖、追求长期可扩展性的训练路径。在产业应用中,面对无限延伸的新物体和新场景,依靠人工标注是不现实的。MoSA所代表的无监督、自监督学习范式,让模型具备了在开放世界中自主发现结构和定义物体的能力,这是Agent在动态环境中持续运行和自我进化的前提。
从论文到产品:构建真实的产业闭环
评判一条AI研究路线是否有生命力,最终标准在于其能否转化为真实的业务价值。360的技术路线之所以具备独特的说服力,是因为它实现了“业务需求驱动研究-研究成果反哺产品”的完整闭环。
FG-CLIP 2并非先有论文再有产品,而是早在2025年就已上线并应用于360云盘、亿方云等内部核心业务。在实际的高并发检索场景中,其细粒度匹配能力得到了充分验证,随后才整理成学术论文发表。这种“实战检验-学术提炼-模型迭代”的工程节奏,是典型的技术实战派特征。同样,RevealLayer也在2026年6月作为SaaS平台的核心能力上线,直接服务于营销创意和视频制作行业。
这种闭环模式揭示了360作为安全公司的独特优势:拥有大量真实的复杂场景数据和高标准的可用性要求。这些第一手的需求反馈,使得其研发方向始终紧扣产业痛点,而非仅仅追逐学术界的热点指标。
结语:中国AI的差异化竞争路径
在全球AI竞争格局中,当基础模型的参数规模竞赛进入深水区,单纯追求规模扩张的红利正在递减。360通过六篇顶会论文展现出的技术图景,为中国AI提供了一条差异化的竞争路径:不单纯拼算力和数据规模,而是深耕端侧部署、产业闭环和真实需求驱动。
安全基因赋予了对鲁棒性、可控性和复杂环境适应性的极致追求,这正是产业AI时代最稀缺的能力。未来,谁能让AI在光照变化、网络干扰、资源受限的真实世界中稳定工作,谁就能掌握产业数字化的入场券。360的探索证明,AI的价值不仅在于创造新的可能性,更在于以可靠、可控的方式解决现有的复杂问题。这种由安全逻辑塑造的产业AI路线,或许正是中国AI在下一轮全球竞争中实现弯道超车的真正底气。