2026端侧AI破局:为何内存不是瓶颈,三大困局才是关键?
技术曲线的历史性交汇
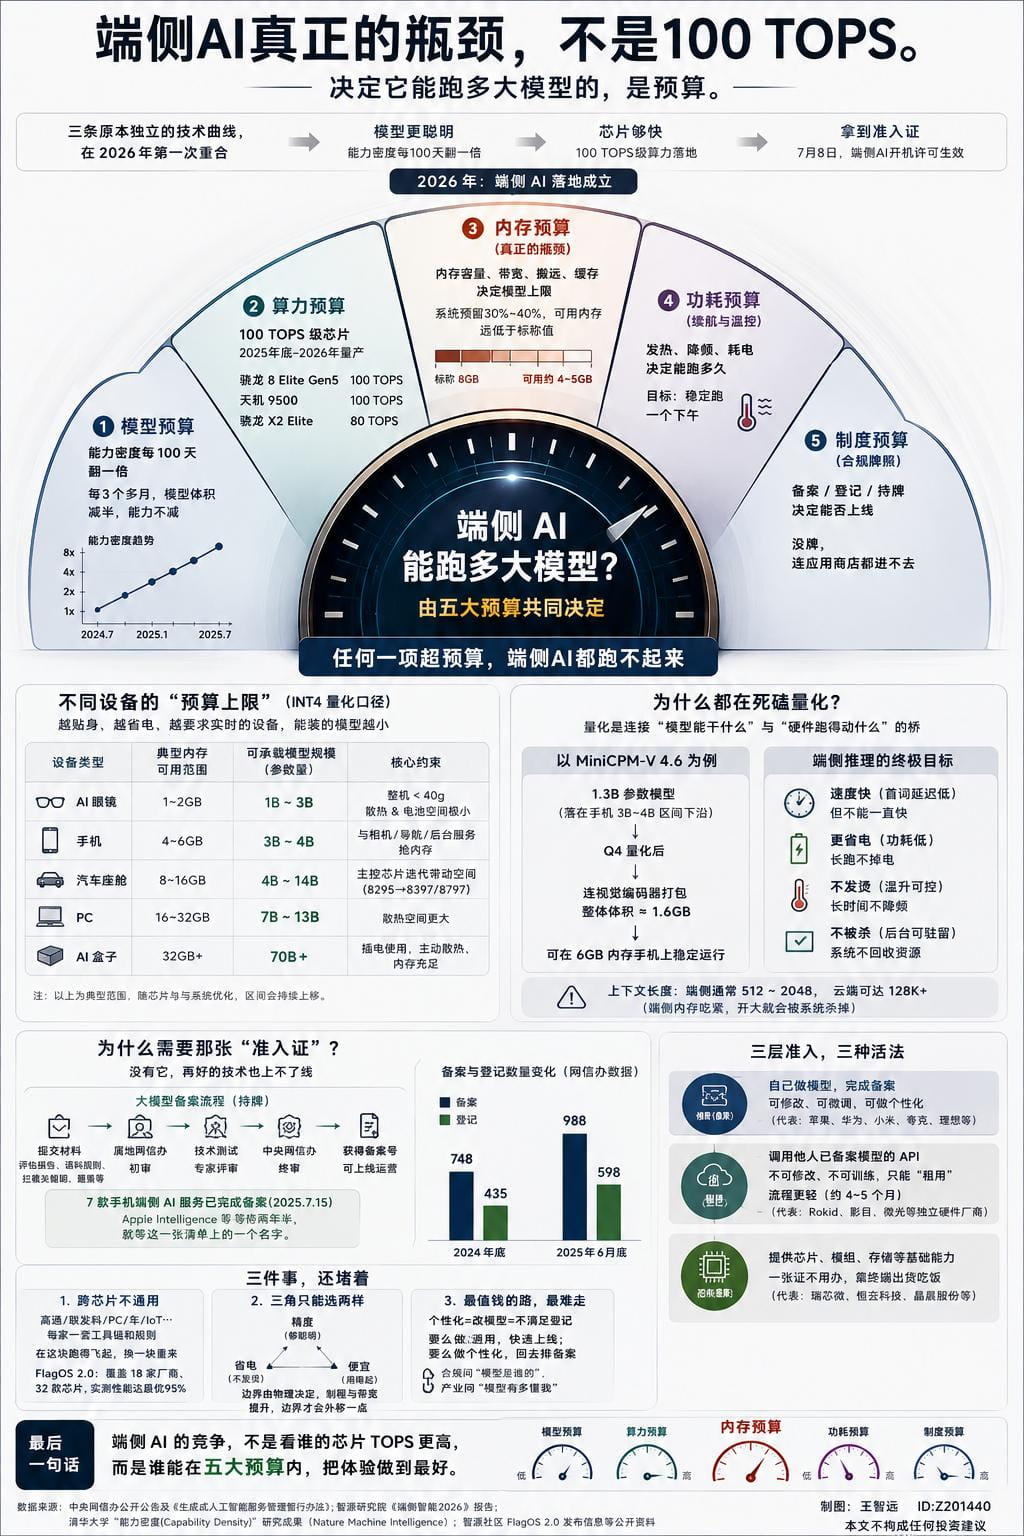
2026年,人工智能的战场发生了肉眼可见的转移。当我们谈论新发布的智能手机、AI眼镜或汽车座舱时,厂商们不再单纯炫耀云端的强大算力,而是反复强调一个核心卖点:大模型本地运行,无需联网。这种转变并非营销噱头,而是三条曾经独立演进的技术曲线,在2026年首次汇聚于同一节点的结果。
第一条曲线是模型能力的“浓缩”。清华大学与开源社区提出的“能力密度”概念揭示了一个惊人趋势:大模型每100天的能力密度翻一倍。这意味着,只需一半的参数规模,即可达到此前最强模型的效果。与此同时,芯片算力遵循摩尔定律,约每两年翻倍。这一快一慢的节奏,决定了端侧设备能容纳多少智能。
第二条曲线是硬件算力的实质性突破。2026年量产的高端移动芯片,如高通骁龙8 Elite Gen5和联发科天玑9500,其AI算力峰值均达到100 TOPS,且功耗大幅降低。更重要的是,这些芯片支持低比特推理技术,为本地运行大模型提供了物理基础。
第三条曲线则是合规准入的落地。随着国家网信办发布手机端侧AI服务备案清单,包括苹果等在内的科技巨头终于拿到了“合法开机”的许可。这不仅是法律层面的解禁,更是系统级权限开放的前提,使得AI智能体能够跨越应用边界,深度融入操作系统。
被误读的算力瓶颈:内存与带宽的真相
尽管100 TOPS的纸面算力令人瞩目,但端侧部署工程师普遍认为,这个数字对实际体验的参考价值有限。真正卡住端侧AI脖子的,不是计算速度,而是内存容量、内存带宽以及数据搬运效率。
在端侧设备上,内存不仅是存储模型参数的容器,更是数据流动的通道。如果带宽过窄,即便算力再强,数据也无法及时送达计算单元。这种现象在iOS和Android系统中体现得尤为明显。例如,iOS的Jetsam机制和Android的LMK(Low Memory Killer)会在内存超限时直接杀死应用。因此,手机标称的8GB内存中,往往只有60%至70%可供AI模型调用。
这种物理约束导致了不同设备间巨大的模型承载差异。智源研究院的报告指出,越贴身、越省电的设备,能容纳的模型越小。AI眼镜由于重量限制在40克以内,留给内存和散热的空间仅如指甲盖大小,因此通常仅支持1B至3B参数的模型。相比之下,AI盒子拥有充足的电源和散热空间,能够承载70B以上的参数模型。
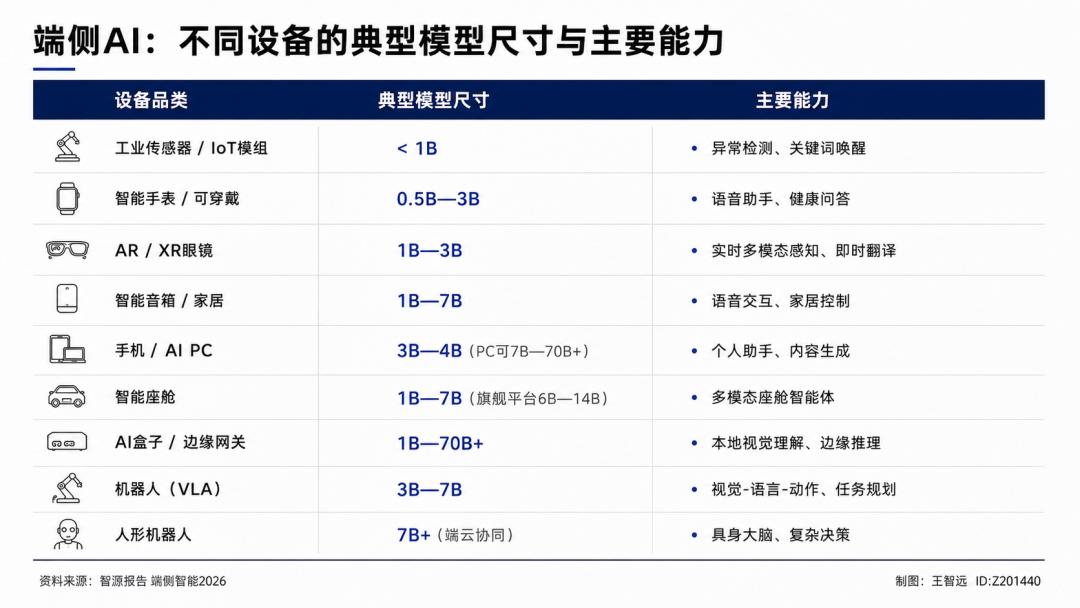
手机处于中间地带,通常支持3B至4B参数模型。这一规模的限制不仅来自内存,更来自多任务并行时的资源竞争。当相机、导航和后台服务共享同一块内存时,AI模型必须学会“精打细算”。
量化的艺术:在精度、功耗与成本间走钢丝
为了在有限的硬件条件下运行大模型,量化技术成为了连接模型能力与硬件限制的关键桥梁。目前,主流端侧模型普遍采用INT4甚至更低精度的量化方案。例如,面壁的MiniCPM-V 4.6在经过Q4量化后,整体部署体积仅约1.6GB,能够在6GB内存的手机上流畅运行。
量化技术的核心挑战在于平衡。工程师必须在模型精度、推理速度和能耗之间寻找最优解。过度量化会导致模型“变傻”,无法处理复杂任务;而保留过高精度则会加剧发热和耗电。对于手机而言,持续高负载运行导致的降频和电量焦虑,比首次响应速度更为致命。
此外,上下文长度的限制也是量化策略的重要考量。端侧模型的上下文长度通常被限制在512至2044 tokens之间,远低于云端的128K。这是因为长上下文会线性增加内存占用,一旦超过系统阈值,应用将被强制关闭。这种设计虽然牺牲了部分能力,却保证了系统的稳定性和续航。
合规分层:牌照背后的生态博弈
2026年的端侧AI生态呈现出鲜明的分层结构,核心差异在于合规身份的获取方式。这一结构由《生成式人工智能服务管理暂行办法》及后续的备案、登记制度塑造。
第一层是“持牌方”。华为、苹果、小米等头部厂商通过完成中央网信办的备案,获得了系统级权限。他们可以自由微调模型,利用用户私有数据训练专属智能体,实现“越用越懂你”的个性化体验。这种深度定制化能力,是端侧AI的核心价值所在。
第二层是“租牌方”。大量中小硬件厂商选择调用已备案大厂的API,通过省级网信办的登记程序上线。这一路径成本低、速度快,但代价明显:无法修改模型底层参数,失去了个性化训练的能力。同时,由于必须公示调用的模型来源,厂商在品牌独立性上受到限制。
数据显示,2026年上半年,登记数量增速远超备案数量,反映出中小厂商在合规压力下的生存策略。然而,这种策略也导致了产品同质化,缺乏核心竞争力的厂商难以建立用户粘性。
第三层是“芯片厂商”。瑞芯微、恒玄科技等硬件提供商不涉及直接面向公众的AI服务,因此无需办理任何牌照。他们的盈利模式依赖于终端出货量的增长。随着AI眼镜、智能手表等设备的放量,存储芯片和算力芯片的需求激增,构成了产业链中相对独立且受益的一环。
难以逾越的三大现实困局
尽管技术正在进步,但端侧AI的规模化落地仍面临三道难以逾越的鸿沟。
首先是跨平台适配的复杂性。云端开发主要围绕英伟达GPU和CUDA生态展开,而端侧芯片架构五花八门。高通、联发科、高通、瑞芯微等各家都有独立的工具链和指令集。导致一个模型在A芯片上运行完美,迁移到B芯片上可能需要重新优化。虽然FlagOS等统一算子库试图解决这一问题,但要覆盖数十种芯片并达到最优性能,仍需漫长的磨合期。
其次是“不可能三角”的物理约束。在端侧设备上,精度、功耗和成本三者相互制约。提高精度需要更大模型和更高算力,导致功耗激增和成本上升;降低功耗则需要牺牲精度或缩小模型规模;降低成本则意味着使用低端芯片,进一步限制模型能力。模型密度定律虽然推动了边界外扩,但在任何特定时间点,开发者仍必须在三者中做出取舍。
最后是个性化需求与合规流程的冲突。端侧AI最大的优势在于数据隐私和本地个性化,但这恰恰与合规要求相悖。根据规定,模型一旦进行微调或引入私有数据训练,原有的登记资格即告失效,必须重新走漫长的备案流程。这使得“租牌方”陷入两难:要么提供通用但平庸的服务以维持快速上线,要么放弃合规捷径,投身耗时数月的备案流程。这种制度性摩擦,实际上将个性化能力垄断在了头部持牌厂商手中。
未来展望:从单点突破到系统协同
2026年是端侧AI从技术演示走向大规模商用的一年。然而,真正的挑战才刚刚开始。未来的竞争将不再局限于单一模型的大小或算力的峰值,而是转向系统级的优化能力。
这包括操作系统层面的内存调度优化、异构计算的无缝协同,以及算法与硬件的深度耦合。同时,合规制度的进一步细化和标准化,也将为行业提供明确的预期。对于开发者而言,理解这些底层约束,在限制中寻找创新空间,将是制胜的关键。端侧AI并非要取代云端,而是与云端形成互补,构建一个更加智能、私密且高效的下一代计算范式。