推理成本成AI最大瓶颈?2026年大模型厂商自研芯片破局之路
价格战转向:从参数竞赛到成本博弈
2026年对于中国人工智能大模型产业而言,是一个从“性能狂飙”转向“成本极化”的转折点。随着技术红利的逐渐消退,单纯依靠提升模型参数规模来构建护城河的时代正在结束,取而代之的是对每一笔算力支出的极致计算。在这个背景下,推理成本(Inference Cost)正式取代训练成本,成为制约AI大规模商业落地的核心变量。
近期,DeepSeek创始人在投资会上的一句感慨引发了行业震动:“买一批设备回来,10个月收回成本就够了,希望能以合理价格买到芯片。”这句话背后,折射出的是主打低价策略的大模型厂商在算力供应链上的深层焦虑。尽管DeepSeek此前以低价格策略席卷市场,但随着Token调用量的指数级增长,曾经被视为“边缘成本”的推理环节,如今已演变成吞噬利润的黑洞。
这种焦虑并非孤例。随着AI应用从娱乐、辅助工具向金融、医疗、工业控制等高精度场景渗透,用户对于响应速度和成本的双重敏感度达到了前所未有的高度。当模型的基础能力趋于同质化,谁能在保证稳定性的前提下,将单次调用的边际成本降至最低,谁就掌握了下一阶段的生存权。这不仅仅是商业策略的调整,更是整个AI产业底层逻辑的重构。
降价潮背后的双引擎:算法与硬件的共振
回顾2026年上半年的市场动态,一场由头部厂商主导的“降价海啸”彻底重塑了用户的心智。5月23日,DeepSeek宣布将V4-Pro模型的API价格永久降至2.5折,并引入类似电力行业的峰谷定价机制。紧接着,小米旗下MiMo-V2.5全系列接口资费下调,部分场景降幅逼近99%。腾讯、MiniMax等平台也纷纷跟进,最高降幅达到97.5%。
这种断崖式的降价并非单纯的营销手段,其背后有着坚实的工程与技术支撑。数据表明,DeepSeek的专业版百万Tokens价格已降至0.025元,仅为部分竞争对手的5.8%。OpenRouter的数据显示,降价后DeepSeek-V4-Flash模型登顶全球调用榜,这证明了在大多数应用场景中,性价比远胜于极致的性能参数。
深入剖析其低成本逻辑,主要得益于两大核心驱动力的协同作用:
首先是软件层面的极致优化。DeepSeek等厂商通过精妙的算法架构调整,大幅压缩了算力消耗。例如,在处理百万级Token的长上下文时,V4系列的算力消耗仅为上一代产品的27%。此外,缓存机制的优化使得重复请求的处理成本降低了10%,真题训练成本也下降了10%。这种“软件定义算力”的能力,使得厂商在不增加硬件投入的情况下,显著提升了吞吐量。
其次是硬件供应链的多元化布局。摆脱对单一供应商的依赖,转而采购性价比更高的国产算力芯片,成为降低硬件采购成本的关键。华为昇腾等国产节点已全面支持DeepSeek V4系列模型,这种“软硬结合”的策略不仅规避了地缘政治带来的供应链风险,更通过规模化采购压低了整体TCO(总拥有成本)。
推理芯片:被低估的“成本黑洞”
尽管降价潮掩盖了部分成本压力,但行业内部对“推理芯片成本”的担忧却在不断加剧。在传统的AI计算范式下,训练阶段占据了绝大部分算力资源,而推理阶段往往被视为轻量级的任务。然而,随着AI应用的泛化和用户基数的爆发式增长,这一比例正在发生根本性的倒置。
阿里云在“2026年算力倍增计划”中明确指出,其AI资本开支中,推理芯片的采购预算占比已达到60%。Meta则计划年底前建立等效60万张GPU算力的推理集群,占比高达55%。联想集团董事长杨元庆在业绩发布会上预测,未来用于推理的AI算力将占总算力的70%以上。
这一趋势的背后,是推理场景特殊性的体现。与训练芯片“一次性投入、长期复用”不同,推理芯片需要实时响应用户的每一次提问,其成本产生是持续的、线性的,且随着用户规模的扩大而无限延伸。据行业数据显示,在生产环境中,推理芯片的投入占大模型全生命周期计算成本的80%至90%。
这意味着,推理芯片成为了AI商业化落地时代最沉重的成本枷锁。如果无法打破这一瓶颈,大模型厂商将陷入“叫得越多,亏得越多”的困境。对于DeepSeek这类走低价路线的企业而言,推理芯片的成本控制能力,直接决定了其商业模式的可持续性。这不再仅仅是技术问题,而是关乎生死存亡的经济命题。
自研芯片:看似光明实则荆棘密布的破局之路
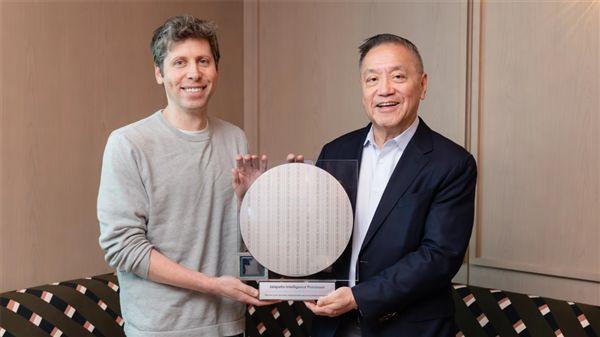
n面对高昂的推理成本,自研芯片似乎成为了解决问题的终极方案。事实上,行业巨头们已经纷纷入局。DeepSeek在完成510亿元融资后,明确表示将资金用于自研AI推理芯片。OpenAI与博通联合开发了定制芯片Jalapeño,旨在替换英伟达芯片以降低约50%的推理成本。Anthropic也从OpenAI挖来了自研芯片团队的核心成员,加速推进硬件自研进程。
然而,自研芯片并非万能药,其背后的难度被严重低估。首先是大厂的技术跨界壁垒。AI大模型厂商擅长算法架构和软件生态,而芯片设计涉及物理、材料、制造等复杂的硬件学科。从软件跨界到硬件,需要重新积累庞大的人才团队和技术储备,这种“换道超车”的难度不亚于从零开始。
其次是迭代速度的错位风险。芯片厂商如华为昇腾、寒武纪、英伟达等,拥有深厚的技术积淀和成熟的制造渠道,能够根据整个行业的通用需求快速迭代产品。而大模型厂商的自研芯片往往仅针对自身特定需求定制,研发周期长、试错成本高。一旦出厂,可能因为模型架构的快速演变而面临“即落后”的风险,导致投入产出比失衡。
最致命的挑战在于生态系统的缺失。英伟达之所以能占据主导地位,不仅因为其算力领先,更因为其拥有超过400万开发者的CUDA生态。这个庞大的开发者网络愿意为英伟达的硬件框架进行适配,形成了一种自我强化的正反馈循环:用户多->开发者多->生态完善->采购量增加->成本降低。相比之下,智普AI、DeepSeek等厂商自研的芯片缺乏外部生态支持,只能内部闭环使用。无法依靠外部销量来摊薄高昂的研发成本,导致单颗芯片的成本居高不下,难以实现真正的规模化经济效应。
从产品思维到基础设施思维的转型
2026年的AI行业,标志着从“工程师文化”向“工业文化”的深刻转型。在工程师时代,核心目标是“做出好用的模型”;而在工业时代,核心目标变成了“以极低的成本大规模交付模型”。这一转变要求大模型厂商必须重新审视自己在产业链中的定位。
能否推出并使用自研推理芯片,不再仅仅是一个技术选择,而是决定了企业属性的关键分水岭。如果无法解决算法迭代、芯片流片、产能排期以及用户生态这四大难题,企业将始终被困在“组装厂”的角色中,利润空间被上游硬件厂商挤压殆尽。只有具备底层硬件创新能力,才能真正成为AI时代的基础设施提供商。
对于DeepSeek等厂商而言,自研芯片的最终目标不仅是降低每百万Token的推理成本,更是构建一种难以复制的垂直整合优势。这种优势将体现在对算力资源的绝对控制权上,从而在激烈的市场竞争中建立起坚实的护城河。这是一场关于耐力、资本和技术深度的马拉松,只有那些能够平衡短期成本压力与长期技术投入的企业,才能最终穿越周期,赢得下半场。
综上所述,AI大模型的价格战下半场,实质上是算力效率与供应链能力的终极较量。推理芯片的成本突破,需要软件优化、硬件创新与生态建设的三轮驱动。虽然自研之路充满荆棘,但这已成为行业不可逆转的趋势。未来,掌握核心算力命脉的企业,将在AI的工业化进程中占据制高点。