2.8万亿参数引爆开源战局:硅谷为何集体转向开放生态?
开源模型的“Kubernetes时刻”已至
2026年7月24日,英伟达创始人黄仁勋在社交媒体X上转发了一封题为《开放权重与美国AI领导力》的公开信,这一举动看似平常,实则标志着全球人工智能产业格局的一次深刻重构。这封公开信最初由英伟达、微软、Meta、IBM等25家机构联署,随后迅速扩展至约50家,包括OpenAI、谷歌、AMD、思科、Cloudflare和GitHub等科技巨头纷纷加入。值得注意的是,在主要前沿模型公司中,Anthropic成为唯一未签署的企业。黄仁勋在配文中仅用一句话概括了这一立场的核心:“世界既需要前沿闭源模型,也需要前沿开放模型。”
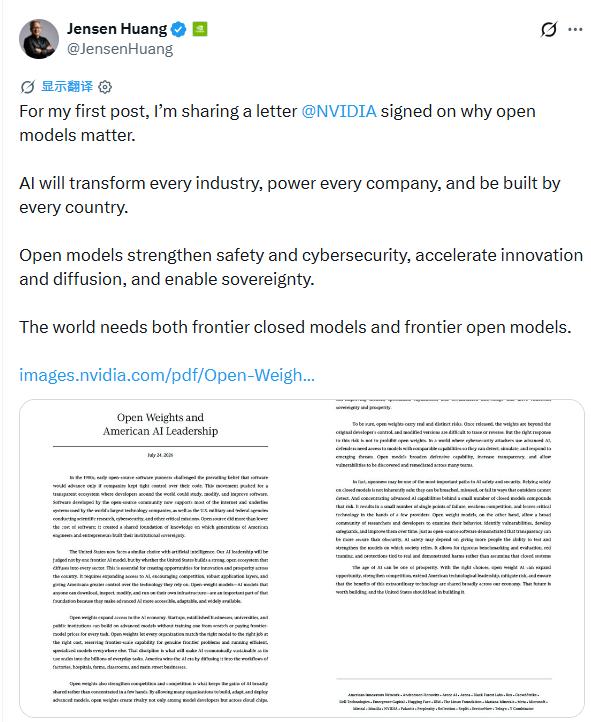
这一集体表态并非偶然,而是发生在月之暗面发布Kimi K3之后的关键节点。7月中旬,Kimi K3以2.8万亿总参数、896个专家模块的混合专家架构亮相,每个Token仅激活16个专家,并支持高达100万Token的上下文窗口。这款模型不仅在智能体、编程和前端开发等多项评测中进入全球第一梯队,更因其可下载、可部署的特性,迅速进入全球开发者视野。它打破了长期以来“开源即低能”的刻板印象,迫使美国科技界重新审视模型壁垒、开放生态竞争力以及华盛顿对技术扩散的政策边界。
开放模型进入前沿能力区:技术突破与成本重构
长期以来,开放权重模型被视为闭源旗舰模型的补充方案,其优势在于价格低廉和部署灵活,但在综合能力上往往存在明显差距。Kimi K3的出现彻底改变了这一局面。2.8万亿参数并不意味着每次推理都要调用如此庞大的计算量,混合专家架构通过任务选择少量专家参与运算,在扩大模型知识容量的同时,有效控制了单次推理成本。
7月27日,月之暗面正式公开了K3的完整技术报告和模型权重,揭示了其背后的技术细节。KDA(Kimi Delta Attention)以3:1的比例混合线性注意力与完整注意力层,前者负责高效处理长序列,后者在关键位置保持精度,这种分工类似于视频编码中关键帧与差分帧的配合。此外,Attention Residuals在网络层之间建立直连通道,补偿线性注意力带来的信息损失;Stable LatentMoE则用统计方法平衡896个专家的训练负载,使极端稀疏的架构得以稳定收敛。
报告还公开了三项训练基础设施:专家通信库MoonEP、高性能算子FlashKDA、以及支持百万Token级强化学习的智能体沙箱AgentEnv。月之暗面称,这套架构使同等算力下模型的智能水平提升约2.5倍。这也是为什么K3虽拥有2.8万亿总参数,实际推理成本却被控制在企业可接受的范围内。
Kimi K3真正具有行业意义的地方,在于大规模开放模型开始同时满足三个条件:性能接近前沿闭源模型,权重可以下载和修改,推理成本可被控制在企业可以承受的范围内。这使企业获得了新的选择。一般办公、内容生成和编码任务可以继续调用闭源API;涉及内部数据、核心代码、网络安全和合规要求时,企业可以将开放模型部署在自己的服务器或云环境中,自主控制数据流向、访问权限和模型版本。
有报道称,微软正在评估将Kimi K3用于Azure及部分Copilot场景,以降低对高价闭源模型的依赖。外部流传的“每年最多节省6亿美元”尚未得到微软公开确认,但已经反映出一个趋势:开放模型开始成为大型科技公司控制推理成本、增强供应商议价能力的工具。开放权重模型由此从低成本“平替”方案,进入能够影响企业技术架构和采购决策的前沿能力区。
硅谷围绕开源模型重新站队:利益博弈与政策分歧
Kimi K3发布后,美国围绕开源模型的争论迅速升温。支持限制的一方担忧,先进模型权重广泛传播后,可能被用于网络攻击、生物研究等高风险用途。美国政府同时关注,中国模型是否通过蒸馏获得美国模型能力,以及相关公司是否使用了受出口管制的先进芯片。OpenAI和Anthropic此前都曾向华盛顿警告,中国开源模型正在威胁美国的AI领先地位,并呼吁政府加强对模型蒸馏、芯片使用和技术扩散的监管。
支持开源的一方则认为,模型来源和部署方式需要分别讨论。企业将模型权重下载至本地运行,可以隔离外部连接、控制访问权限并保留数据。对于网络安全、金融、医疗和政府等高敏感场景,模型能否私有部署、审计和修改,本身就是安全能力的一部分。近200家美国初创企业此前也曾致信政府,反对全面禁止中国开源模型。它们担心,过度限制会抬高创业公司的模型成本,进一步强化少数美国闭源模型供应商的垄断地位。
硅谷由此形成了新的利益结构。英伟达销售GPU和整套AI基础设施,开源模型越丰富,企业部署模型的需求越强;微软需要同时经营云计算、模型API和应用产品,引入更多模型有助于降低成本并增强议价能力;Meta长期依靠开放生态扩大自身在全球开发者中的影响力;IBM、思科和Cloudflare等公司,更加关注私有部署、混合云和网络安全市场。开源模型扩大了整个AI市场的参与者数量,也扩大了基础设施供应商的潜在客户群。
Anthropic的立场明显不同。在联名公开信中,Anthropic持续缺席。他们长期将前沿模型安全作为核心战略,并警告开放先进模型权重可能降低危险的扩散门槛。这种选择与Anthropic的品牌定位和闭源商业模式高度一致。开放权重模型越强,企业对高价闭源API的依赖越低,Anthropic赖以建立差异化竞争的安全叙事和模型服务也会面临更大压力。一场围绕开源与闭源的技术路线争论,其实背后是更为复杂的产业利益和政策边界的谈判。
黄仁勋真正捍卫的是算力市场:杰文斯悖论的AI演绎
黄仁勋支持开源模型,有着清晰的商业逻辑。模型供给越丰富、使用成本越低,进入AI市场的人和企业就越多,最终产生的Token数量和算力需求也会越大。2025年DeepSeek发布后,市场一度担心高效模型会削弱GPU需求。黄仁勋多次回应,模型效率提升会扩大使用范围:单次推理变便宜后,开发者会调用更多模型、运行更长时间,并将AI引入更多任务。
这符合杰文斯悖论。当一种资源的使用效率提高、单位成本下降,总需求可能随之增长。AI计算需求也已经超越单纯的预训练。模型还需要经历监督微调、强化学习、长时间推理以及智能体执行。一个智能体完成复杂任务,可能需要连续调用模型、搜索资料、操作工具、验证结果,并根据反馈重新规划。每个环节都在消耗Token。
黄仁勋因此将数据中心描述为“AI工厂”:输入电力和数据,输出Token。GPU、网络、存储、电力和数据中心构成一套工业化计算系统。在这套逻辑中,模型公司的商业模式可以不断变化,算力依然是共同底座。闭源模型依靠API、订阅和企业服务获得收入;开源模型依靠云部署、微调、托管和行业解决方案形成商业生态。两条路径都需要训练集群、推理服务器、高速互联和软件工具链。
开源模型还会把更多中小企业带进这个市场。企业可能从一个开源模型开始试验,随后购买云算力、模型托管、安全服务和更稳定的商业方案。随着模型进入生产环境,可靠性、延迟、并发、权限和运维都会产生新的基础设施需求。黄仁勋看重的,正是这个不断扩大的市场基数。
2.8万亿参数之后,竞争转向系统能力
Kimi K3将开放模型推向2.8万亿参数,但混合专家架构使总参数与实际计算量逐渐分离。模型拥有多少参数,只能反映系统容量的一部分。激活参数、训练数据、后训练方法、推理效率、工具使用能力和部署成本,正在共同决定模型的商业价值。下一阶段的竞争将集中在三个层面。
首先是效率。企业关心的核心指标,是完成一项任务需要多少Token、多少轮调用和多少算力。模型在评测中取得高分,并不代表实际使用成本一定更低。能力、速度和成本需要同时衡量。
其次是软件生态。围绕开放模型,开发者正在建设量化工具、推理框架、芯片适配、专业微调、模型融合和智能体系统。Hugging Face已经托管超过200万个公开模型,单一模型之间的竞争,正在演变成模型家族和生态系统之间的竞争。
最后是部署控制权。越来越多国家和企业希望拥有自己的模型、数据和算力基础设施。开放权重模型可以被本地化、修改并运行在不同芯片上,因此成为主权AI和企业私有部署的重要技术基础。
有人将这一阶段称为开放模型的“Kubernetes时刻”。Kubernetes最初由谷歌开源,随后在开发者、云厂商和企业共同推动下,逐渐成为云计算基础设施的重要标准。开放模型也可能沿着类似路径演进:模型权重成为基础层,周围生长出推理框架、云服务、硬件适配和行业应用。开放生态能否形成类似Kubernetes的统一标准,目前仍有很大不确定性。模型架构、许可证、推理框架和硬件平台依然高度分散。
但方向已经逐渐清晰,当开放模型进入前沿能力区,闭源公司的竞争壁垒将更多转向产品体验、数据闭环、服务稳定性和专业场景;开放模型则依靠成本、控制权和生态创新扩大市场。黄仁勋的表态并不是力挺“中国开源模型”。无论最终胜出的是美国闭源模型、中国开源模型,还是企业自行微调的行业模型,只要AI应用继续扩张,更多系统开始持续生成Token,英伟达就仍然站在产业增长最稳定的环节上。从这个角度看,黄仁勋的第一条X帖子,也是一封写给华盛顿的商业意见书。他所捍卫的,是一个模型供给更加多元、开发者数量更多、算力需求持续扩张的AI市场。