英伟达AI鉴伪实测:92%准确率背后,为何仍难阻深度伪造泛滥?
深度伪造时代的信任危机与技术突围
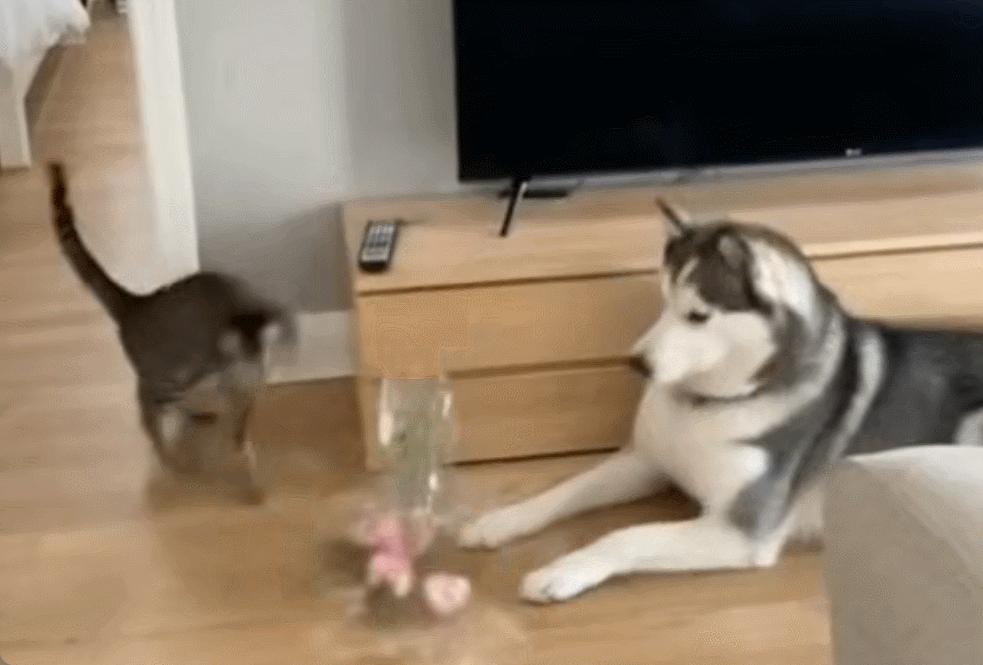
当一只猫碰碎花瓶后惊慌逃窜,旁边的狗子挥舞爪子极力撇清关系的视频在社交网络疯传时,大多数观众的第一反应是捧腹大笑。然而,这并非真实发生的家庭趣事,而是由先进生成式AI模型合成的数字幻象。随着Sora、Kling以及Seedance等视频生成技术的迭代,以往依靠“六根手指”、“嘴型错位”或“物理逻辑崩坏”来识别假视频的简易法则已彻底失效。现代AI生成的视频不仅在光影渲染上逼近真实,更在运动连贯性与细节纹理上达到了以假乱真的境界。
这种技术飞跃带来的直接后果是公众信任体系的崩塌。对于缺乏技术背景的普通用户,尤其是老年群体而言,区分现实与虚拟的边界变得日益模糊。解铃还须系铃人,面对AI制造的混乱,科技巨头们开始尝试用AI来对抗AI。英伟达近期推出的Synthetic Video Detector NIM(以下简称SVD NIM)便是这一趋势下的代表性产物。它不再局限于表面像素的比对,而是深入到底层统计特征与频域痕迹的分析中,试图在数字信号的微观层面捕捉生成模型留下的“指纹”。
英伟达SVD NIM的技术逻辑与局限
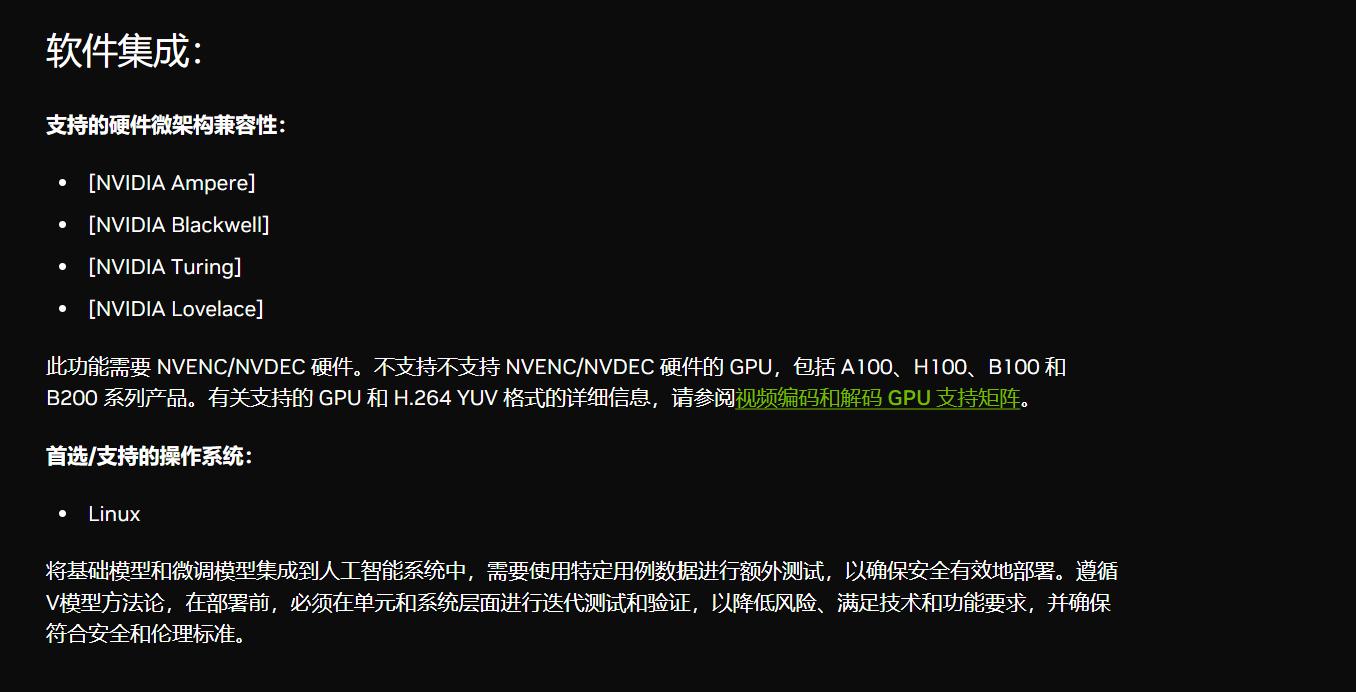
英伟达此次发布的SVD NIM并非一款面向大众的消费级应用,而是基于NVIDIA Inference Microservices架构的企业级推理微服务。其核心逻辑在于将复杂的检测模型、推理引擎及运行环境打包,供开发者在本地服务器部署。从技术原理来看,SVD NIM首先将H.264编码的MP4视频拆解为独立帧,随后利用DINOv2和DINOv3视觉模型对每一帧进行深度特征提取。
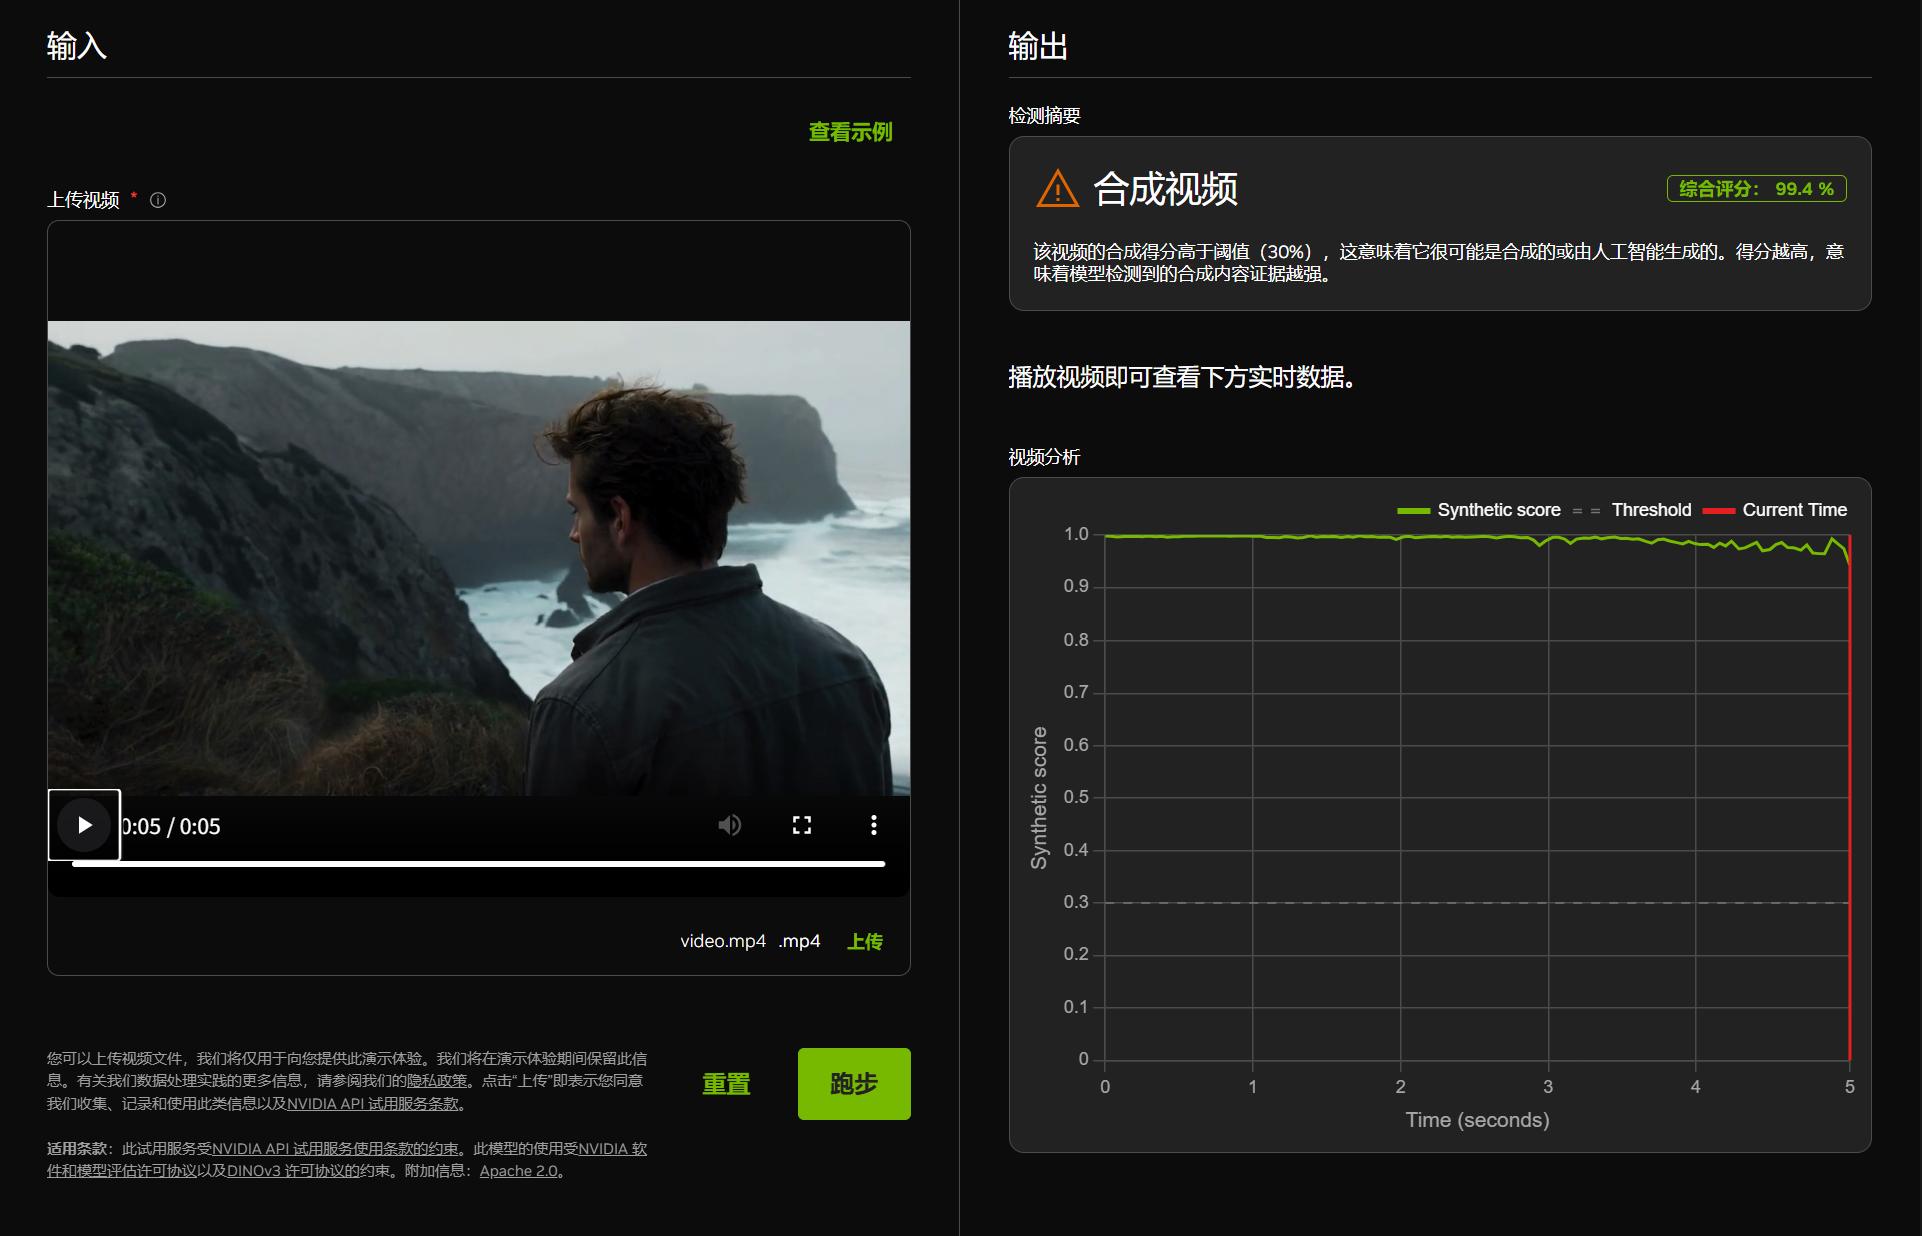
与传统检测工具不同,SVD NIM不关注明显的视觉瑕疵,而是聚焦于生成过程中不可避免的统计异常。扩散模型在去噪生成图像时,会在像素分布和频率域留下特定的规律,这些规律与人眼相机拍摄的自然噪声分布存在本质差异。即便视频经过压缩或重新编码,这些底层的统计特征依然具有一定的残留性。官方数据显示,在未压缩视频测试集中,SVD NIM的准确率高达92%,综合测试集成功率也达到85.64%。
然而,这一亮眼数据的背后隐藏着严苛的前提条件。高准确率依赖于偏严格的阈值采样,这意味着在实际应用中,为了降低漏报率,系统可能会产生大量的误报。此外,该检测能力高度依赖原始视频格式,任何涉及转码、压缩或社交平台二次分发的操作,都会显著削弱其特征信号,导致检测性能大幅下降。对于需要处理海量用户上传内容的平台而言,SVD NIM更适合作为初筛工具,而非最终判决者,人工复核依然是不可或缺的环节。
主流鉴伪工具的实地横评:理想与现实的落差
为了验证当前AI鉴伪技术的真实可用性,我们选取了英伟达SVD NIM、腾讯朱雀AI检测助手以及国家反诈中心APP内的“AI内容鉴定”功能进行横向对比测试。测试素材涵盖了高质量AI生成视频、真实Vlog片段、经过微信压缩的图片以及原生实拍照片,旨在模拟真实网络环境中的复杂场景。
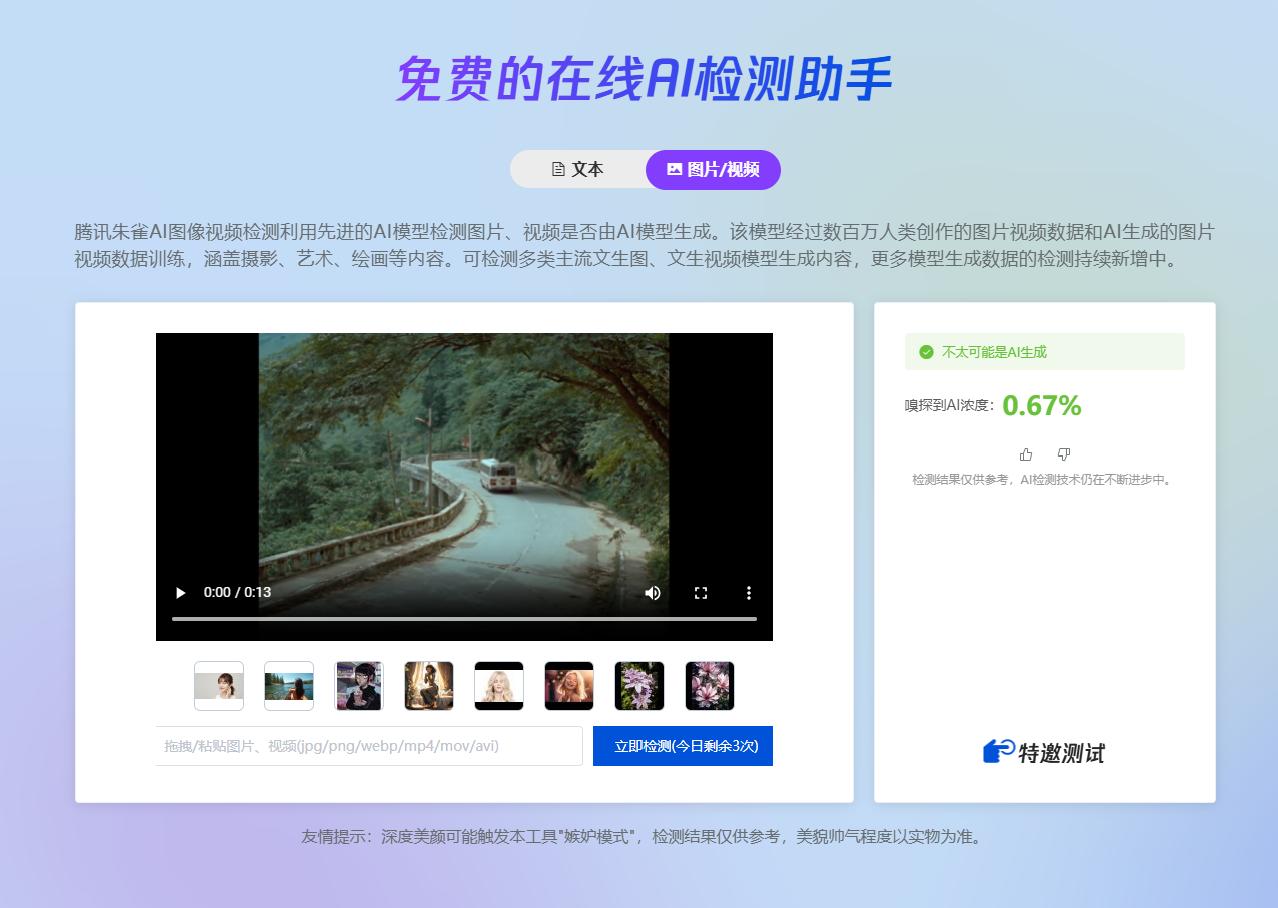
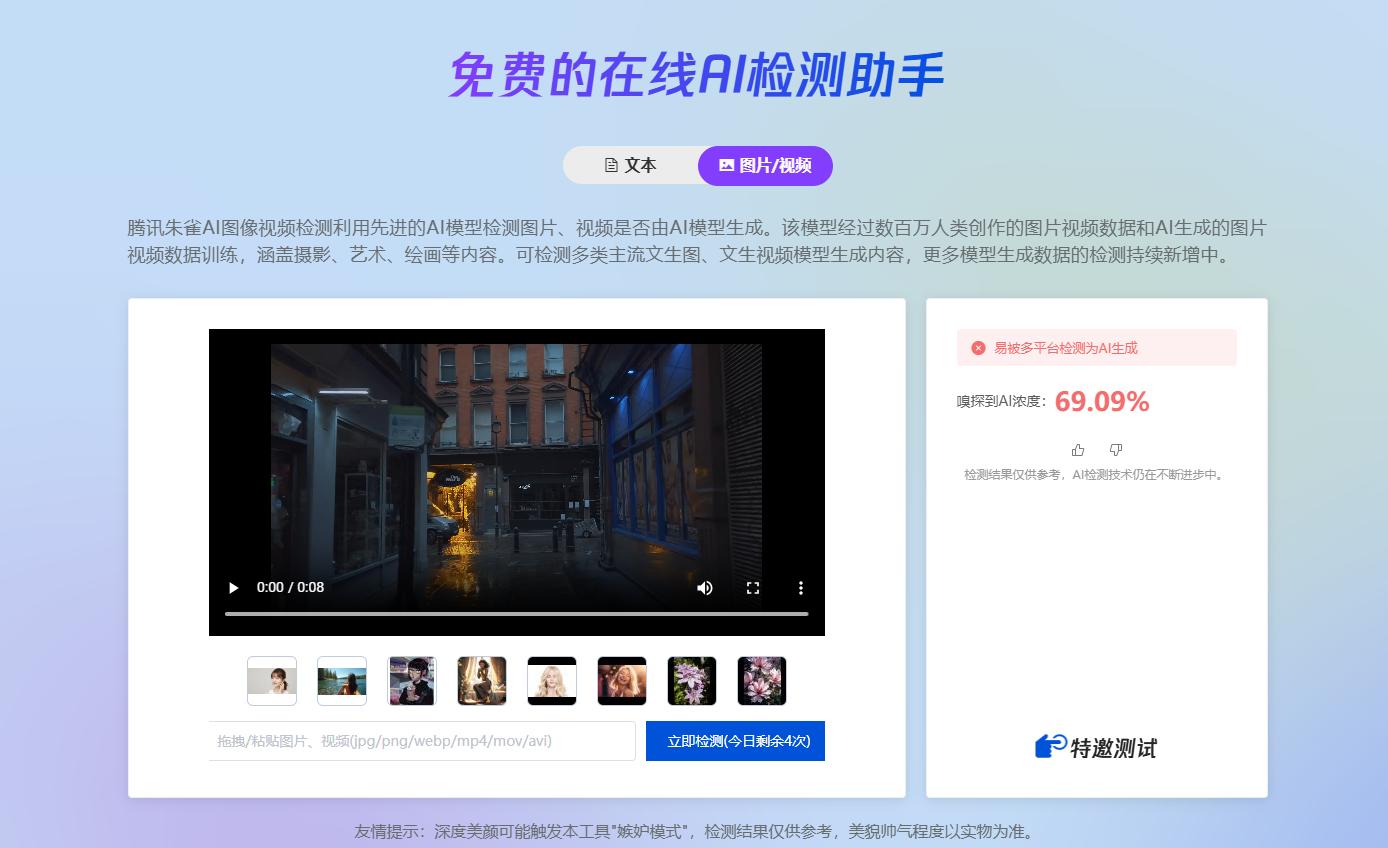
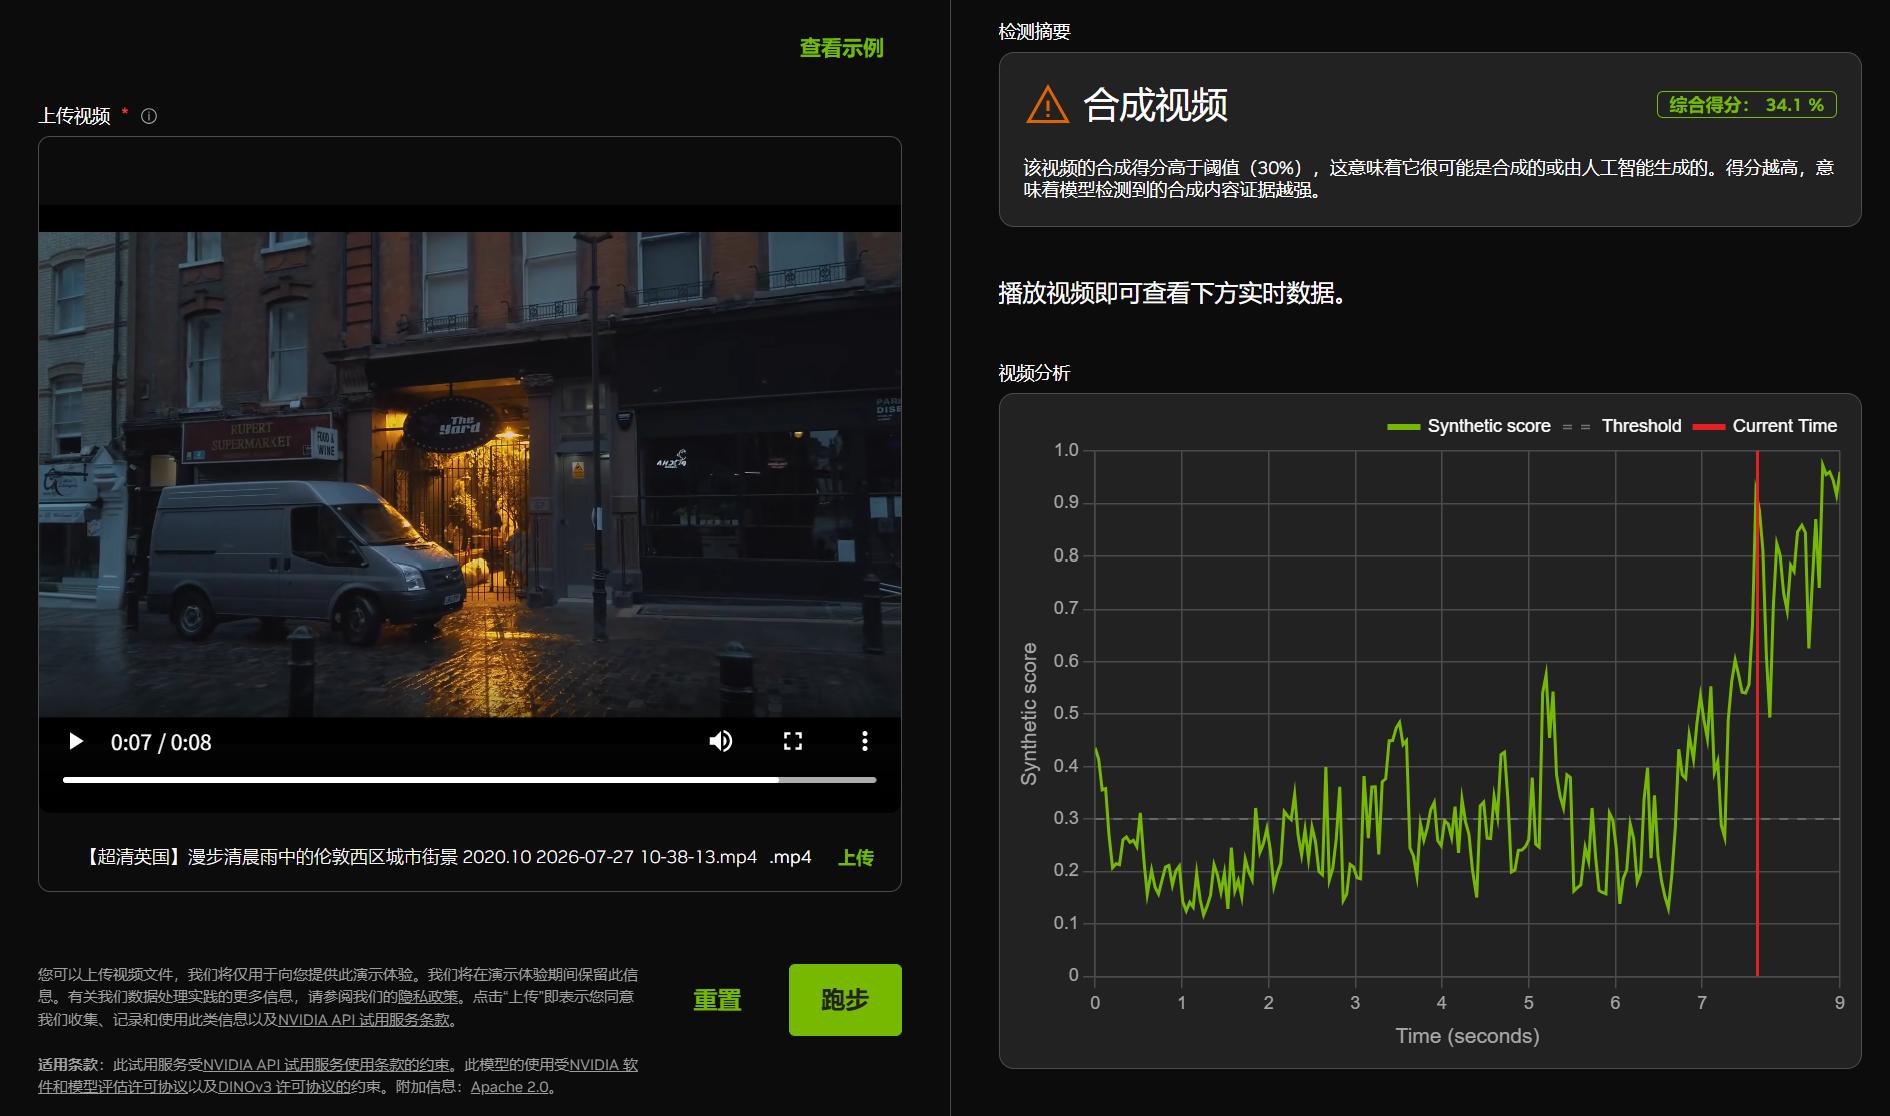
在视频检测环节,一段由Seedance生成、具有老电影质感的AI视频成为了试金石。这段视频刻意保留了轻微的镜头晃动和模糊分辨率,极具迷惑性。腾讯朱雀在此轮测试中表现失常,未能识别出明显的合成痕迹,甚至给出了较低的疑似度评分。相比之下,通过特定渠道接入的SVD NIM则精准地给出了93%的高置信度得分,并在逐帧分析中标注出了频域异常的坐标点。尽管其检测耗时较长,13秒的视频需处理两分钟,但其技术深度显然优于前者。
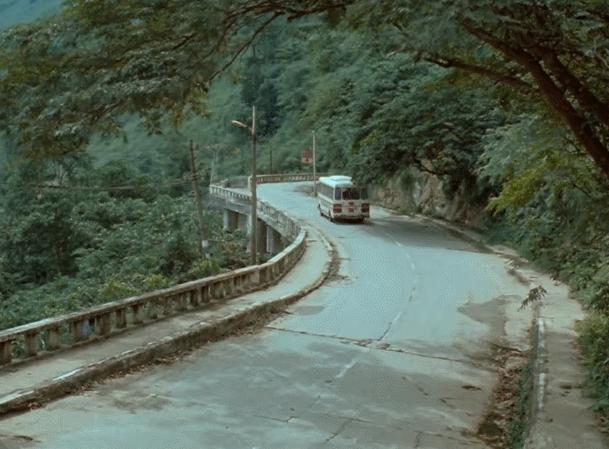
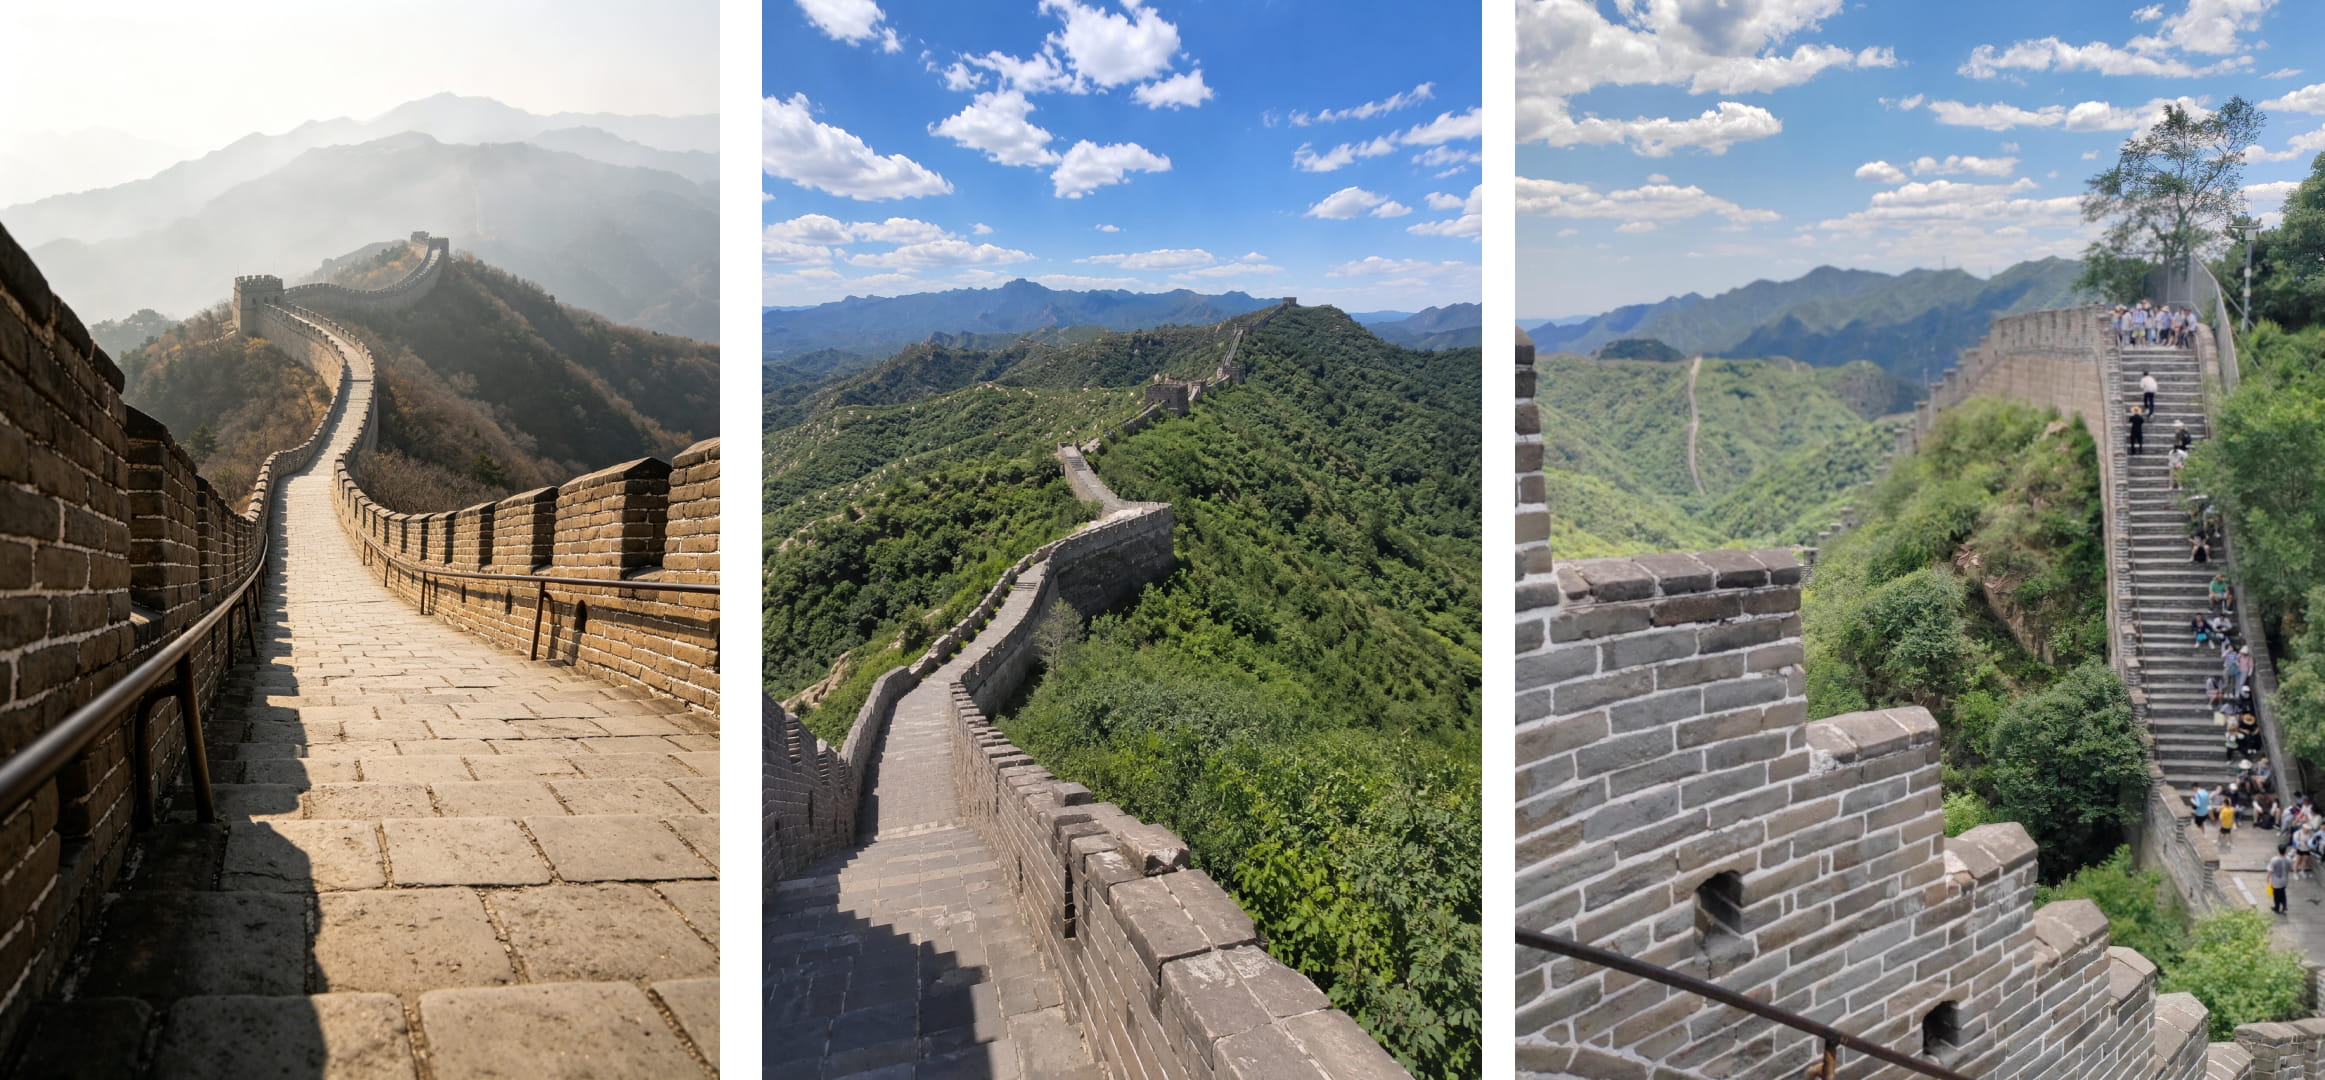
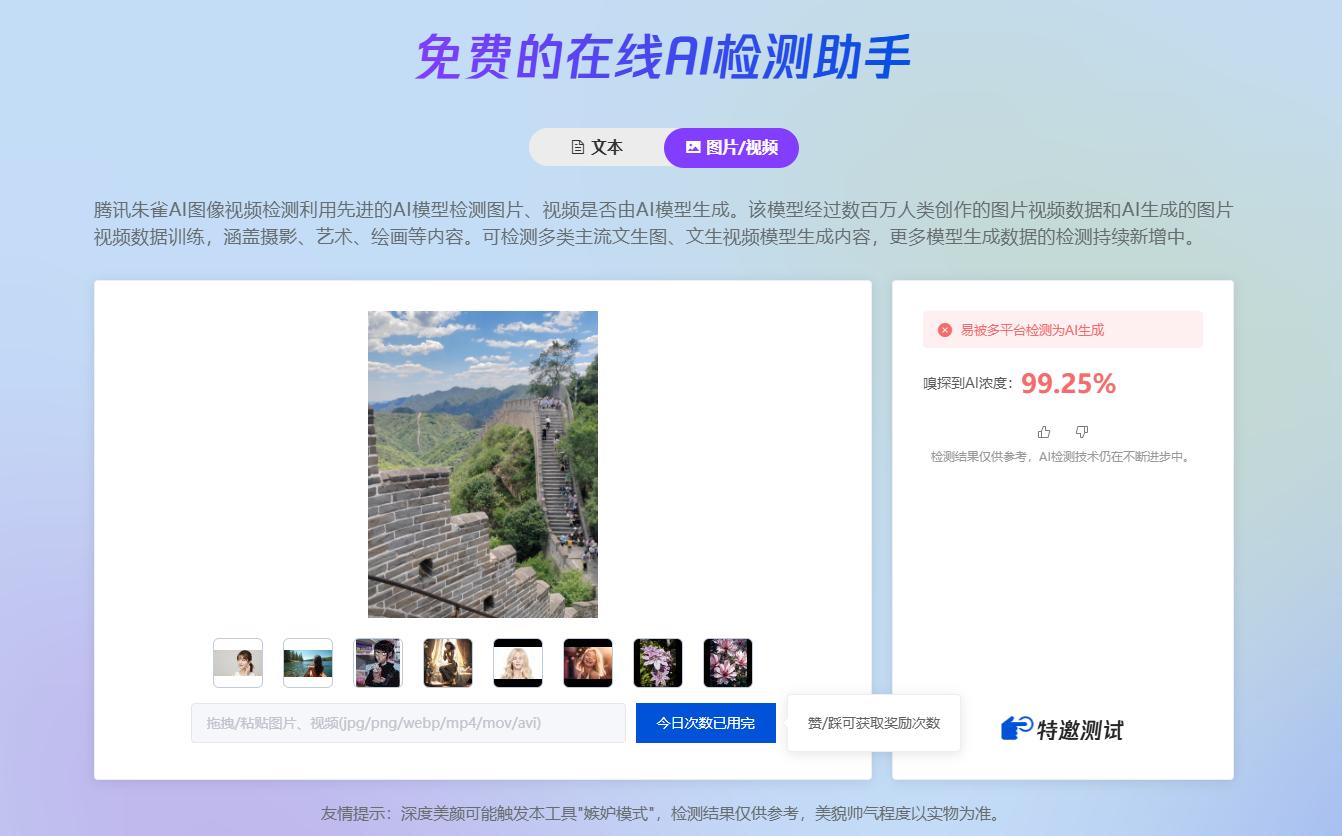
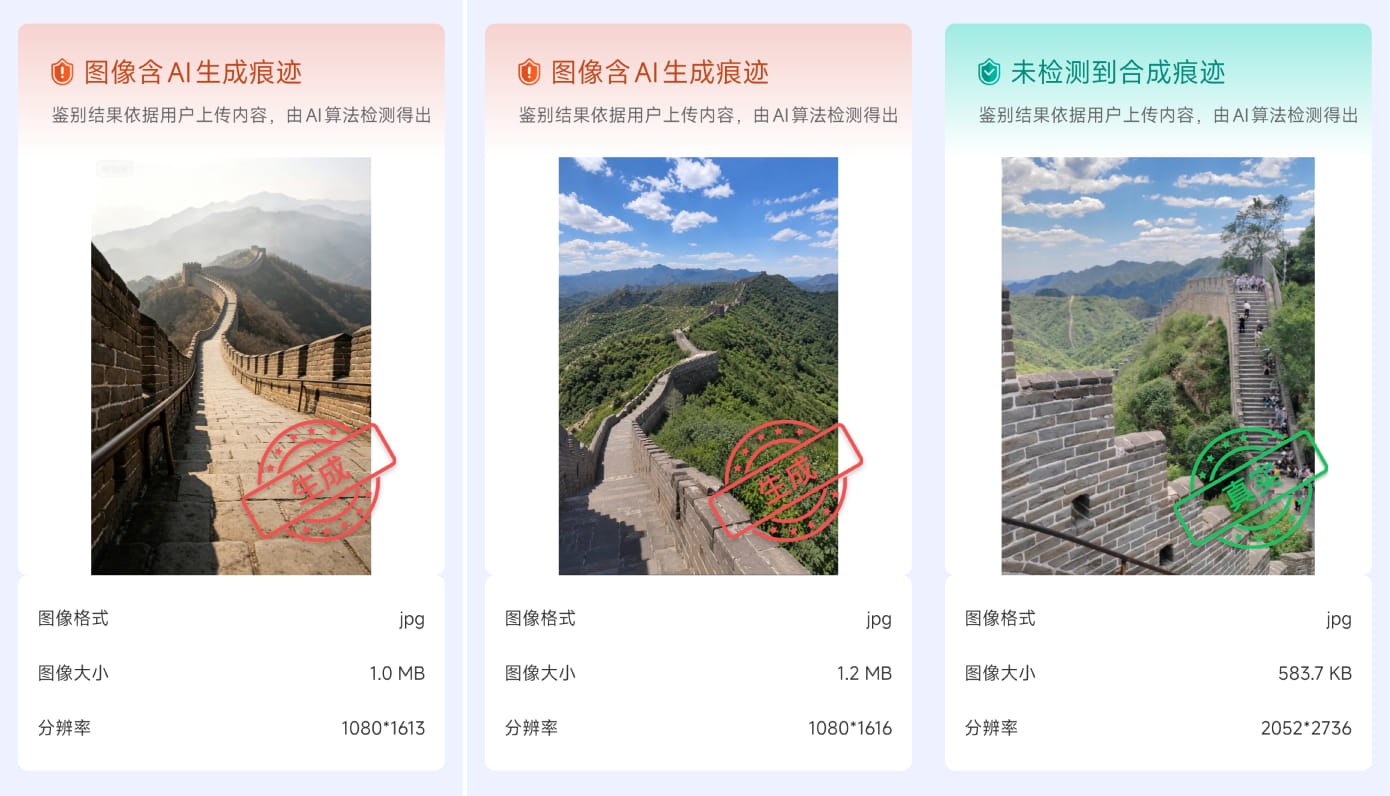
令人意外的是,国家反诈中心APP在视频上传环节遭遇了严重的稳定性问题,多次尝试均无法完成提交,这使得其在视频鉴伪领域的实用性大打折扣。而在图片检测环节,情况发生了反转。腾讯朱雀虽然成功识别了部分AI生成图片,但却将一张真实的手机实拍照片误判为AI合成,出现了典型的“假阳性”错误。反观反诈中心APP,在图片检测上表现出了较高的准确性,成功区分了经过后期抹除水印的AI图与真实照片,显示出其在特定垂直领域算法优化的优势。
技术博弈中的结构性困境
此次实测暴露出当前AI鉴伪领域存在的几个核心痛点。首先是鲁棒性不足,检测工具对输入数据的质量极其敏感。一旦视频经过社交平台的压缩算法处理,或者图片被截图转发,原有的元数据和微观特征便会大量丢失,导致检测模型失效。其次是误报与漏报的两难选择,为了提高安全性而调高敏感度,必然会导致正常内容被误伤,影响用户体验;反之,则可能放过精心伪造的深度伪造内容。
更为严峻的是,目前的鉴伪体系处于一种“各自为战”的状态。不同厂商开发的检测模型基于不同的训练数据和特征提取逻辑,彼此之间缺乏互通性。开源模型的普及使得任何人都可以生成无水印的虚假内容,而平台间的壁垒又阻碍了数字签名和溯源信息的跨平台流转。这种碎片化的生态让恶意使用者有了可乘之机,他们可以通过多次转码、混合编辑等手段,轻易绕过单一检测工具的防线。
此外,计算资源的消耗也是制约大规模应用的重要因素。像SVD NIM这样基于深层视觉模型的分析工具,对算力要求极高,难以在移动端或低配置设备上实时运行。这导致高精度的检测服务往往只能局限于云端或企业级应用,普通用户难以触达,形成了技术防护上的“贫富差距”。
从“事后检测”转向“源头治理”
鉴于事后检测技术的局限性,行业共识正逐渐从单纯的“抓假”转向“证真”。谷歌推出的SynthID技术通过在生成内容中嵌入不可见的数字水印,即使经过裁剪、压缩或滤镜处理,依然能够被识别。Adobe主导的C2PA(内容来源和真实性联盟)标准则致力于建立一套完整的元数据记录体系,追踪文件从创建、编辑到分发的全生命周期。
国内监管层面也在积极推动这一进程。网信办明确要求AI生成内容必须进行显著标识,腾讯、阿里、字节等头部平台也在加紧布局数字签名和内容溯源技术。这种“源头打标”的策略,本质上是将信任建立在 cryptographic(密码学)证明之上,而非依赖概率性的模式识别。只有当生成端、传播端和消费端都遵循统一的标准协议,形成闭环的信任链,才能从根本上遏制深度伪造的泛滥。
然而,标准的统一并非一朝一夕之功。目前,开源社区生成的内容往往缺乏合规的水印,而不同商业平台之间的数据孤岛效应也阻碍了互认机制的建立。在这一过渡期内,技术手段的完善必须与法律监管、公众教育同步推进。平台方应承担起更多的审核责任,优化检测算法以适应复杂的网络传输环境;监管部门需加大对恶意伪造行为的打击力度,提高违法成本。
构建个人的数字防御机制
在技术体系完全打通之前,普通用户并非完全无能为力。面对日益逼真的AI内容,保持适度的怀疑态度是第一道防线。对于来源不明、情绪煽动性强或违背常识的视频和图片,不应轻信并急于传播。可以尝试通过多源验证的方式,查找同一事件的其他报道或原始素材,交叉比对信息的一致性。
同时,关注内容的元数据信息也是一种有效的辅助手段。虽然普通用户无法进行专业的频域分析,但查看文件的属性、拍摄设备信息以及修改历史,有时能发现蛛丝马迹。此外,利用现有的免费检测工具进行初步筛查,尽管它们存在局限,但仍能提供一定的参考依据。重要的是,要意识到这些工具的结果并非绝对真理,而是概率性的提示。
最终,应对AI伪造的挑战是一场长期的技术与社会博弈。英伟达的SVD NIM或许并不完美,但它代表了行业向深层技术防御迈进的重要一步。随着算法的迭代、标准的统一以及用户媒介素养的提升,我们有望在一个更加透明和可信的数字环境中,重新找回对视觉内容的信任。在此之前,保持警惕、理性判断,是我们每个人在数字洪流中应有的生存智慧。