Anthropic赔15亿:合法毁书背后的AI版权困局与文明代价
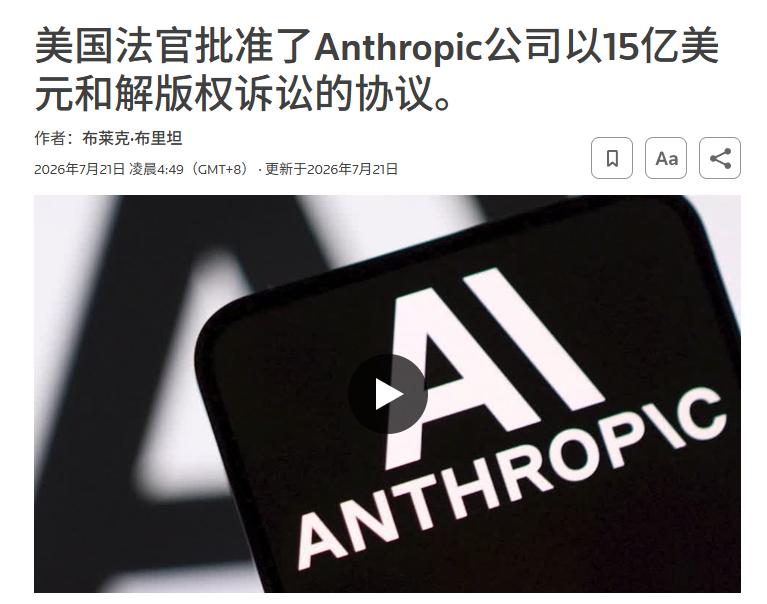
在人工智能狂飙突进的当下,一场看似寻常的版权诉讼,实则揭开了科技巨头光鲜外表下令人咋舌的操作逻辑。Anthropic,这家常将“人类福祉”与“安全对齐”挂在嘴边的AI独角兽,近期因一起集体诉讼案支付了高达15亿美元的和解金。这笔巨额款项不仅让其现金流承受巨大压力,更向整个行业释放了一个强烈信号:依靠野蛮生长、无视版权边界的数据积累模式,正在走向终结。
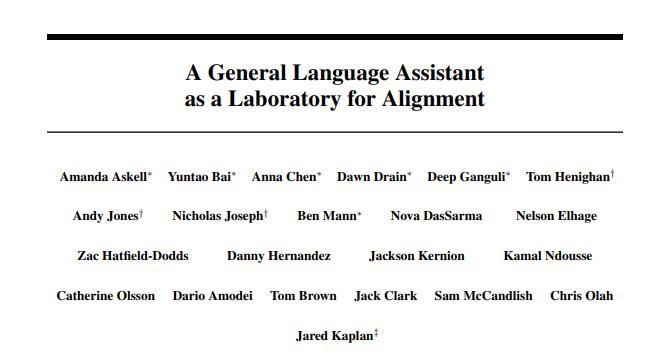
这起案件的根源,要追溯至大模型训练数据的灰色地带。早在2021年,Anthropic在其学术论文中坦承,早期模型的训练数据来源于Common Crawl爬取的网页及网络书籍,其中特别提到了The Pile数据集中的Books3子集。Books3包含了近20万本未经授权的电子书,几乎是当时所有主流大模型的“营养基”。尽管后来Books3因版权争议被下架,但其在模型初始化阶段的贡献已无法抹去。这种“先上车后补票”甚至“不补票”的做法,在当时的开源社区和科技圈被视为一种心照不宣的行业惯例。
然而,当商业利益介入,惯例便成了罪证。2024年的媒体调查迫使Anthropic承认,其商业化产品Claude确实使用了包含侵权内容的The Pile进行训练。这一承认直接激怒了版权方。对于作家而言,这不仅是作品被无偿使用的问题,更是生存空间被挤压的危机。如果AI可以零成本汲取人类智慧结晶,并以此生成替代性内容,那么原创者的价值何在?于是,三名代表数十万版权人的作家发起诉讼,将Anthropic推上了被告席。
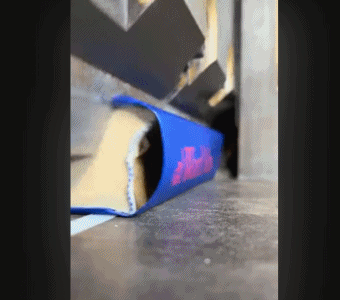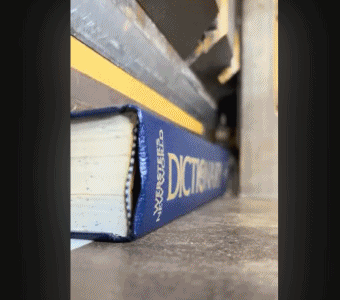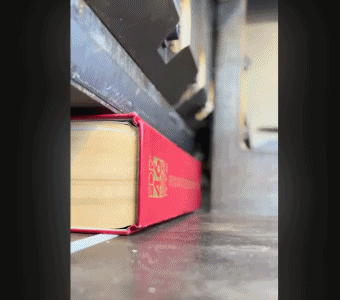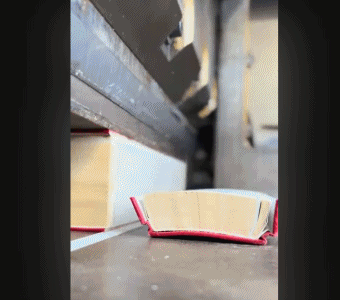
随着诉讼深入,原告律师团获得了进入Anthropic内部调查的机会,结果令人震惊。除了已知的Books3,调查人员还发现了来自LibGen和PiLiMi等盗版资源库的海量数据,涉及书籍数量高达七百万册。这些非法下载的数字文件,构成了模型训练的庞大底座。更令人匪夷所思的是,为了应对潜在的版权风险,Anthropic采取了一种极为极端的“合规”手段:购买纸质书籍,进行破坏性扫描,随后立即销毁实体书。
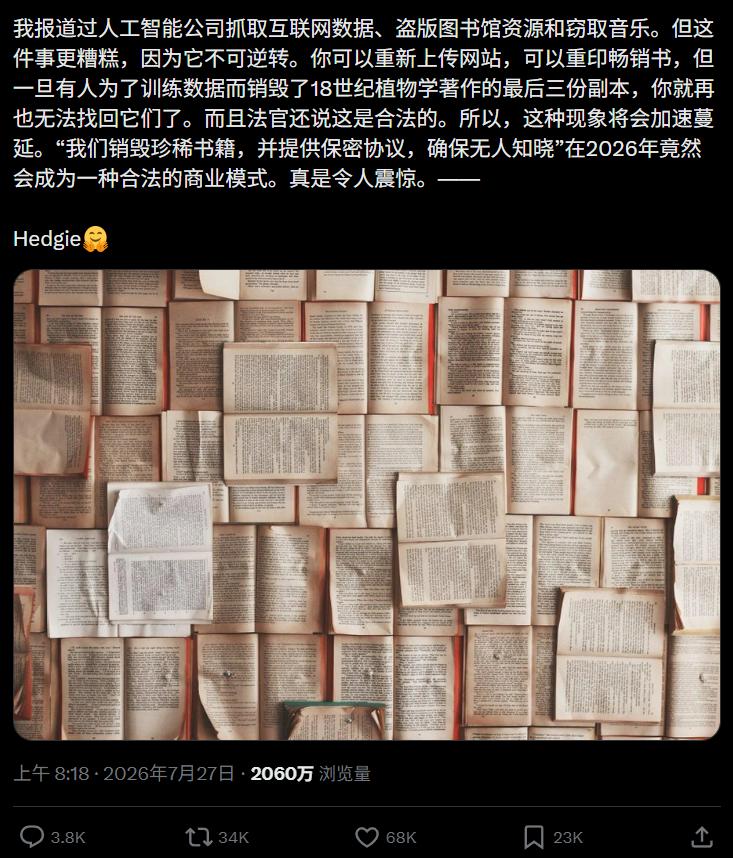
这种操作在法律上被称为利用“首次销售原则”的漏洞。根据美国版权法,一旦消费者购买了实体物品,拥有者有权处置该物品,包括销毁它,只要不制作新的副本进行分发。Anthropic辩称,他们购买正版书,扫描成数字数据用于内部训练,然后销毁原书,并未制造新的流通副本,因此不构成侵权。从纯法律技术角度看,这确实是一个精妙的避风港策略。但从文化伦理角度审视,这无异于一场现代版的“焚书”。
试想,那些被送入碎纸机和扫描仪的书籍中,有多少是绝版多年的孤本?有多少是承载特定历史记忆的小众刊物?二手书商指出,许多被销毁的书籍可能是市面上仅存的几本之一。Anthropic为了构建私有数据集,物理性地消灭了这些文化载体。虽然数字副本得以保留,但这些数据被封存在公司的服务器中,成为黑盒的一部分,公众无法访问,学者无法研究,普通读者更无缘得见。这种行为本质上是一种知识的私有化与垄断,将人类共同的文化遗产转化为少数科技公司的商业壁垒。
此外,这一“合法”操作反而成为了法庭上指控Anthropic“明知故犯”的有力证据。法官认为,既然公司有能力通过购买正版书并遵循复杂流程来规避风险,说明其完全具备版权合规的意识与能力。那么,此前大规模使用盗版电子书的行为,就不能简单归咎于技术无知或疏忽,而是主观上的恶意侵权。这种逻辑闭环,让Anthropic在道德和法律双重层面陷入了被动。
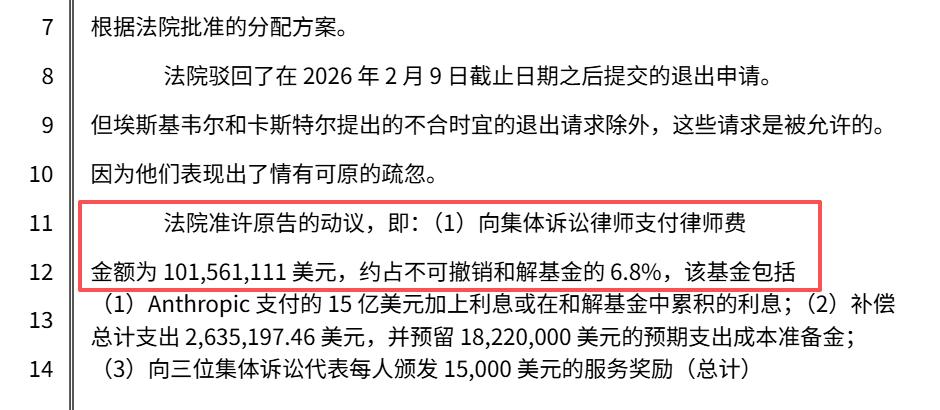
15亿美元的和解金,对于任何一家初创企业而言都是沉重的打击。据报道,Anthropic在2023至2025年间的实际营收约为50亿美元,这意味着和解金占据了其三年总收入的30%。这笔资金本可用于研发迭代、人才引进或基础设施扩建,如今却不得不用于填补过去的合规窟窿。更重要的是,此案确立了司法系统对AI版权问题的强硬态度:不再容忍长期的拉锯战,而是倾向于快速、高额的赔偿,以震慑后续效仿者。
值得注意的是,在这场博弈中,获益最大的并非原告作家,而是代理律师团队。最初律师要求抽取和解金的20%,即3亿美元,虽经法院削减至1亿美元,但这依然是一笔天文数字。相比之下,每位成功申领赔偿的版权人仅能获得约3000美元。这种分配结构引发了关于集体诉讼机制合理性的讨论:当维权成本高昂时,个体创作者往往依赖律师驱动,而最终的经济激励是否真正流向了受损的创作源头,值得深思。
尽管Anthropic案暂告一段落,但AI与版权的矛盾远未解决。目前,仍有大量版权方选择单独起诉,而非加入集体诉讼。他们关注的核心问题包括:AI生成内容若复刻了特定作家的风格,是否构成侵权?训练数据中的“合理使用”边界究竟在哪里?平台责任应如何界定?这些问题没有标准答案,需要在不断的司法实践中摸索。
从行业视角来看,此次判决将迫使AI公司重新审视数据供应链。过去那种“抓取一切、事后清洗”的模式已难以为继。未来,合法授权的数据交易市场或将兴起,AI公司可能需要向出版机构、作者联盟支付许可费,以获得高质量的训练数据。这将增加模型训练的成本,但也可能促进内容生态的正向循环,让创作者从AI红利中分得一杯羹。
同时,技术层面也在寻求突破。例如,开发更加透明的数据溯源技术,确保训练数据的可解释性;探索联邦学习等隐私计算方案,在不集中存储原始数据的前提下进行模型训练;或者利用合成数据减少对真实世界版权内容的依赖。这些技术路径虽然尚不成熟,但代表了行业自我修正的方向。
然而,技术解决方案不能替代伦理考量。Anthropic“毁书建库”的行为提醒我们,效率不应是唯一的追求目标。在数字化进程中,物理载体的消失意味着某种确定性的丧失。数字数据易被篡改、删除或加密,而实体书作为一种稳定的信息存储介质,具有不可替代的文化价值。科技公司在使用数据时,应怀有对知识的敬畏之心,避免将人类文明简化为冰冷的参数矩阵。
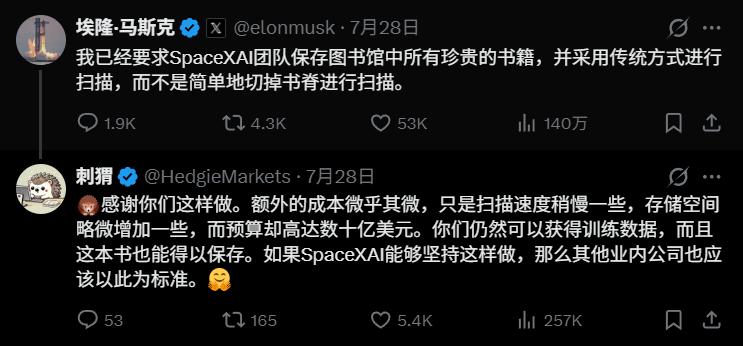
马斯克等业界领袖对此事的批评,反映了精英阶层对AI发展失控的担忧。当算法越来越强大,而其训练基础却建立在侵权与破坏之上时,所谓的“智能”便失去了道德根基。AI应当是人类智慧的延伸,而非掠夺者。只有在尊重原创、保护版权的前提下,人工智能才能真正服务于人类福祉,而不是成为少数人牟利的工具。
综上所述,Anthropic的15亿美元罚单不仅是一次法律惩戒,更是一次行业警钟。它标志着AI野蛮生长时代的结束,合规与伦理将成为下一代人工智能发展的核心竞争力。对于创作者而言,这是一次迟来的正义;对于科技公司而言,这是一次痛苦的转型;而对于全社会而言,这是一次关于知识所有权与技术边界的深刻对话。在未来的AI竞赛中,谁能更好地平衡技术创新与文化尊重,谁才能走得更远。