超越UVR?PYMSS如何以300+模型重塑AI音频分离与修复新标准
音频处理范式的迭代:从单一工具到生态平台
在数字内容创作日益精细化的今天,音频处理已成为视频剪辑、音乐制作及AI生成内容(AIGC)链条中不可或缺的一环。长期以来,Ultimate Vocal Remover (UVR) 凭借其开源特性占据了市场主导地位。然而,随着深度学习模型的快速迭代,UVR 5.6版本在模型适配速度与新算法集成上已显露出滞后性。面对日益复杂的音频分离需求——如高保真伴奏提取、多乐器独立分离以及老歌修复——行业亟需一种更具扩展性和集成度的解决方案。
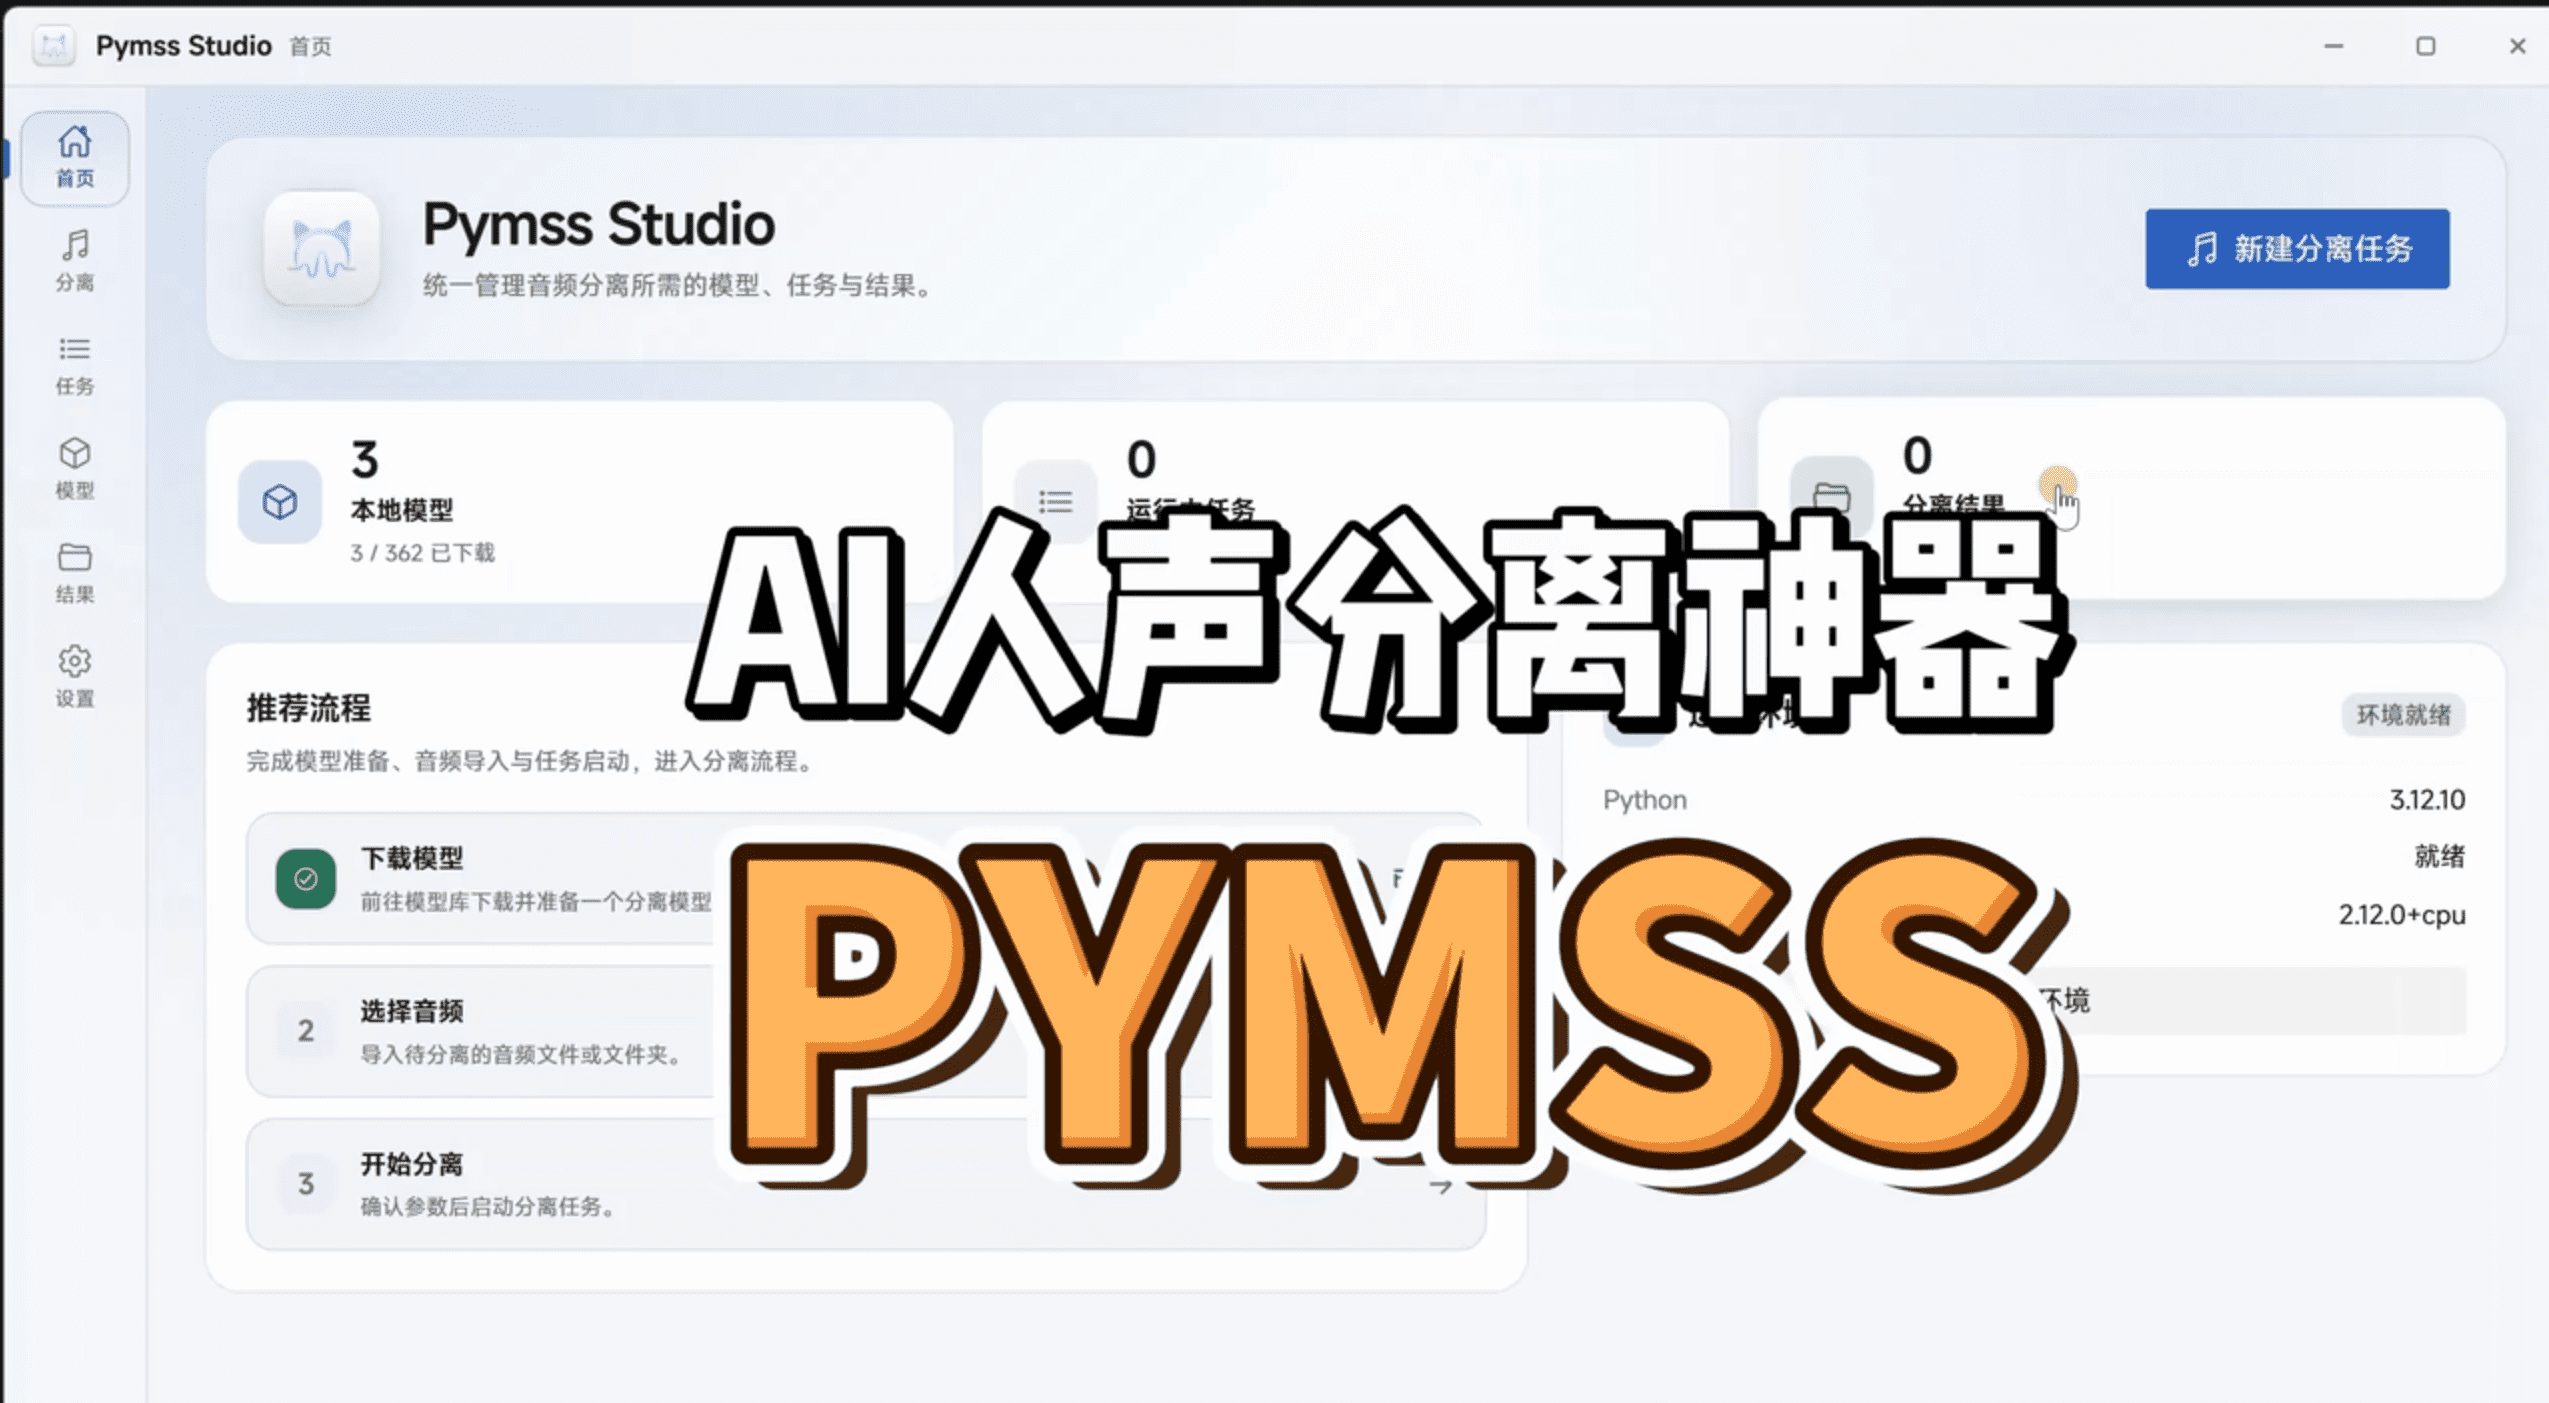
PYMSS(Python Music Source Separation)的出现,标志着音频分离工具从“单一功能软件”向“模型聚合平台”的范式转变。它不再仅仅是一个执行分离任务的终端,而是一个集成了300多种前沿AI模型的调度中心。这种架构设计不仅解决了模型更新滞后的痛点,更通过标准化的接口实现了不同算法间的无缝切换。对于专业创作者而言,这意味着无需在多个软件间反复横跳,即可在同一界面下调用最适合当前场景的算法模型。
核心架构解析:模型即服务(MaaS)的音频实践
理解PYMSS的关键在于厘清其“平台”与“模型”的关系。PYMSS本身并不生产底层的分离算法,而是作为上层应用,负责模型的管理、下载、推理加速及结果后处理。这种解耦设计带来了显著的优势:当学术界或工业界发布新的分离模型(如基于Transformer架构的Roformer变体)时,PYMSS可以通过后台更新迅速集成,而用户无需重新安装庞大的软件包。
目前,PYMSS主要提供两种交互形态,分别对应不同层级的用户需求。
Studio安装版:低门槛的图形化体验
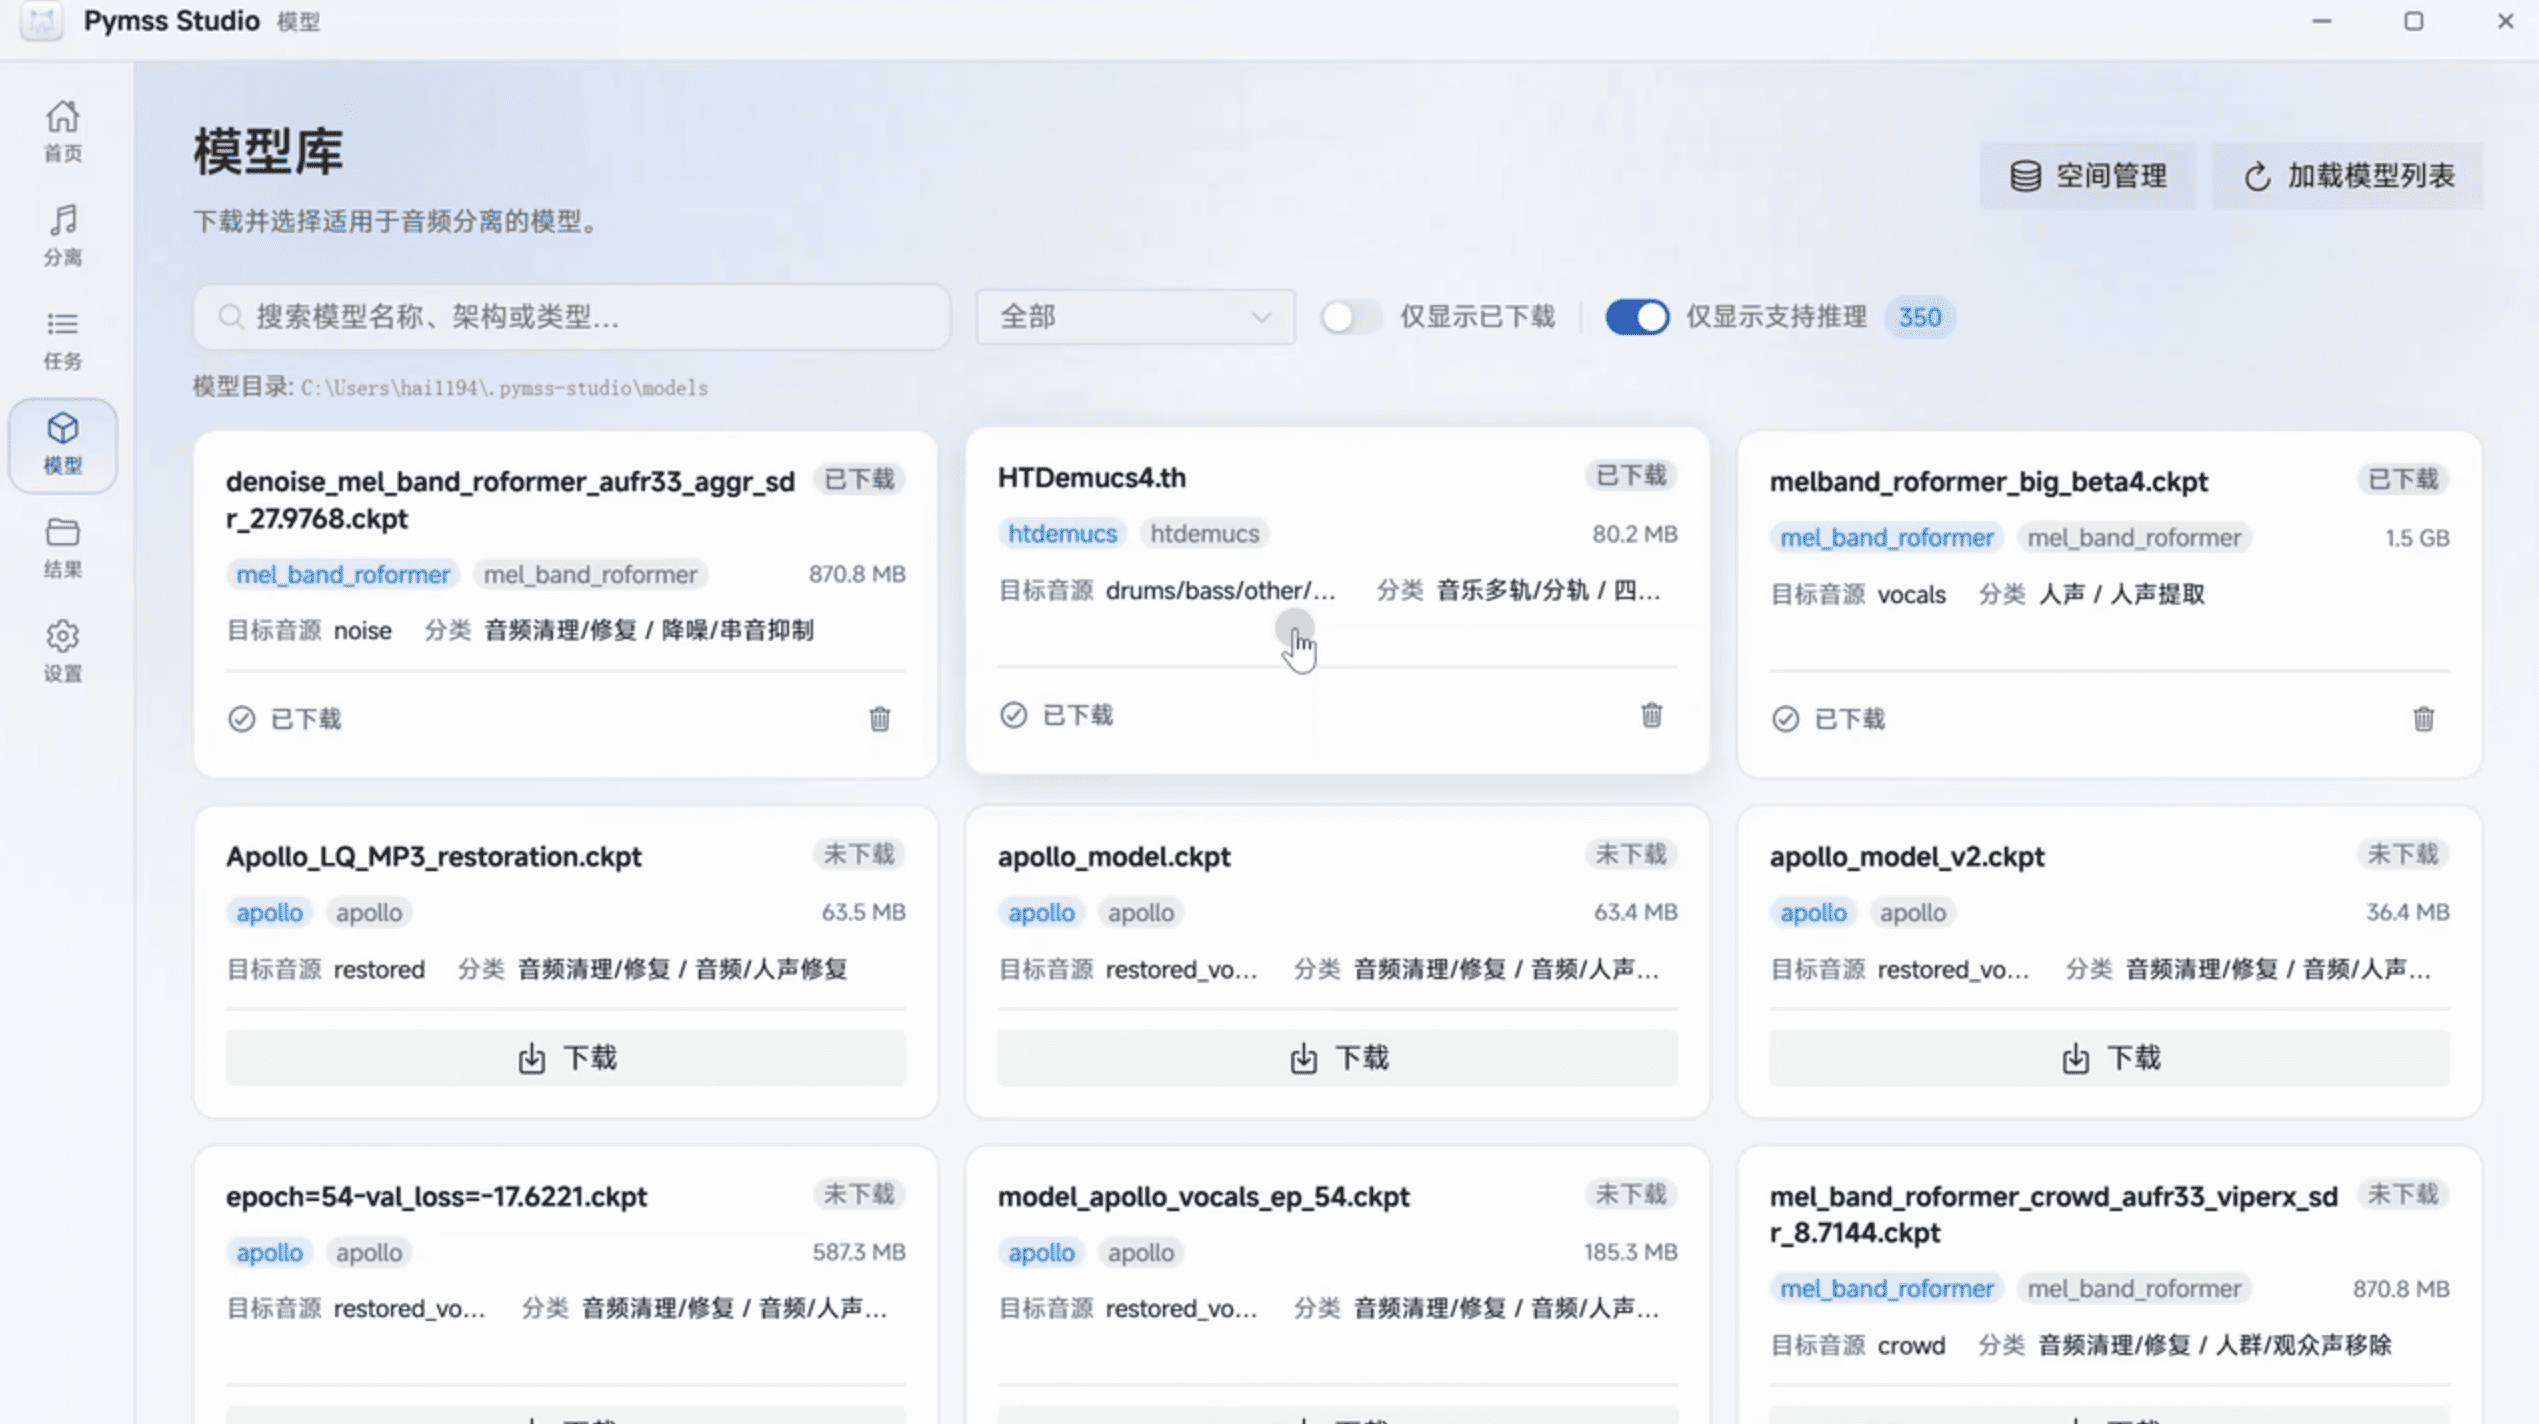
对于大多数非技术背景的用户,PYMSS Studio提供了开箱即用的体验。其图形用户界面(GUI)直观地展示了模型列表、参数设置及输出路径。用户只需导入音频文件,选择目标模型(如MelBand Roformer),点击运行即可。这种模式极大地降低了AI音频处理的技术门槛,使得普通创作者也能享受到深度学习带来的音质提升。
ComfyUI工作流版:自动化与批量处理的利器
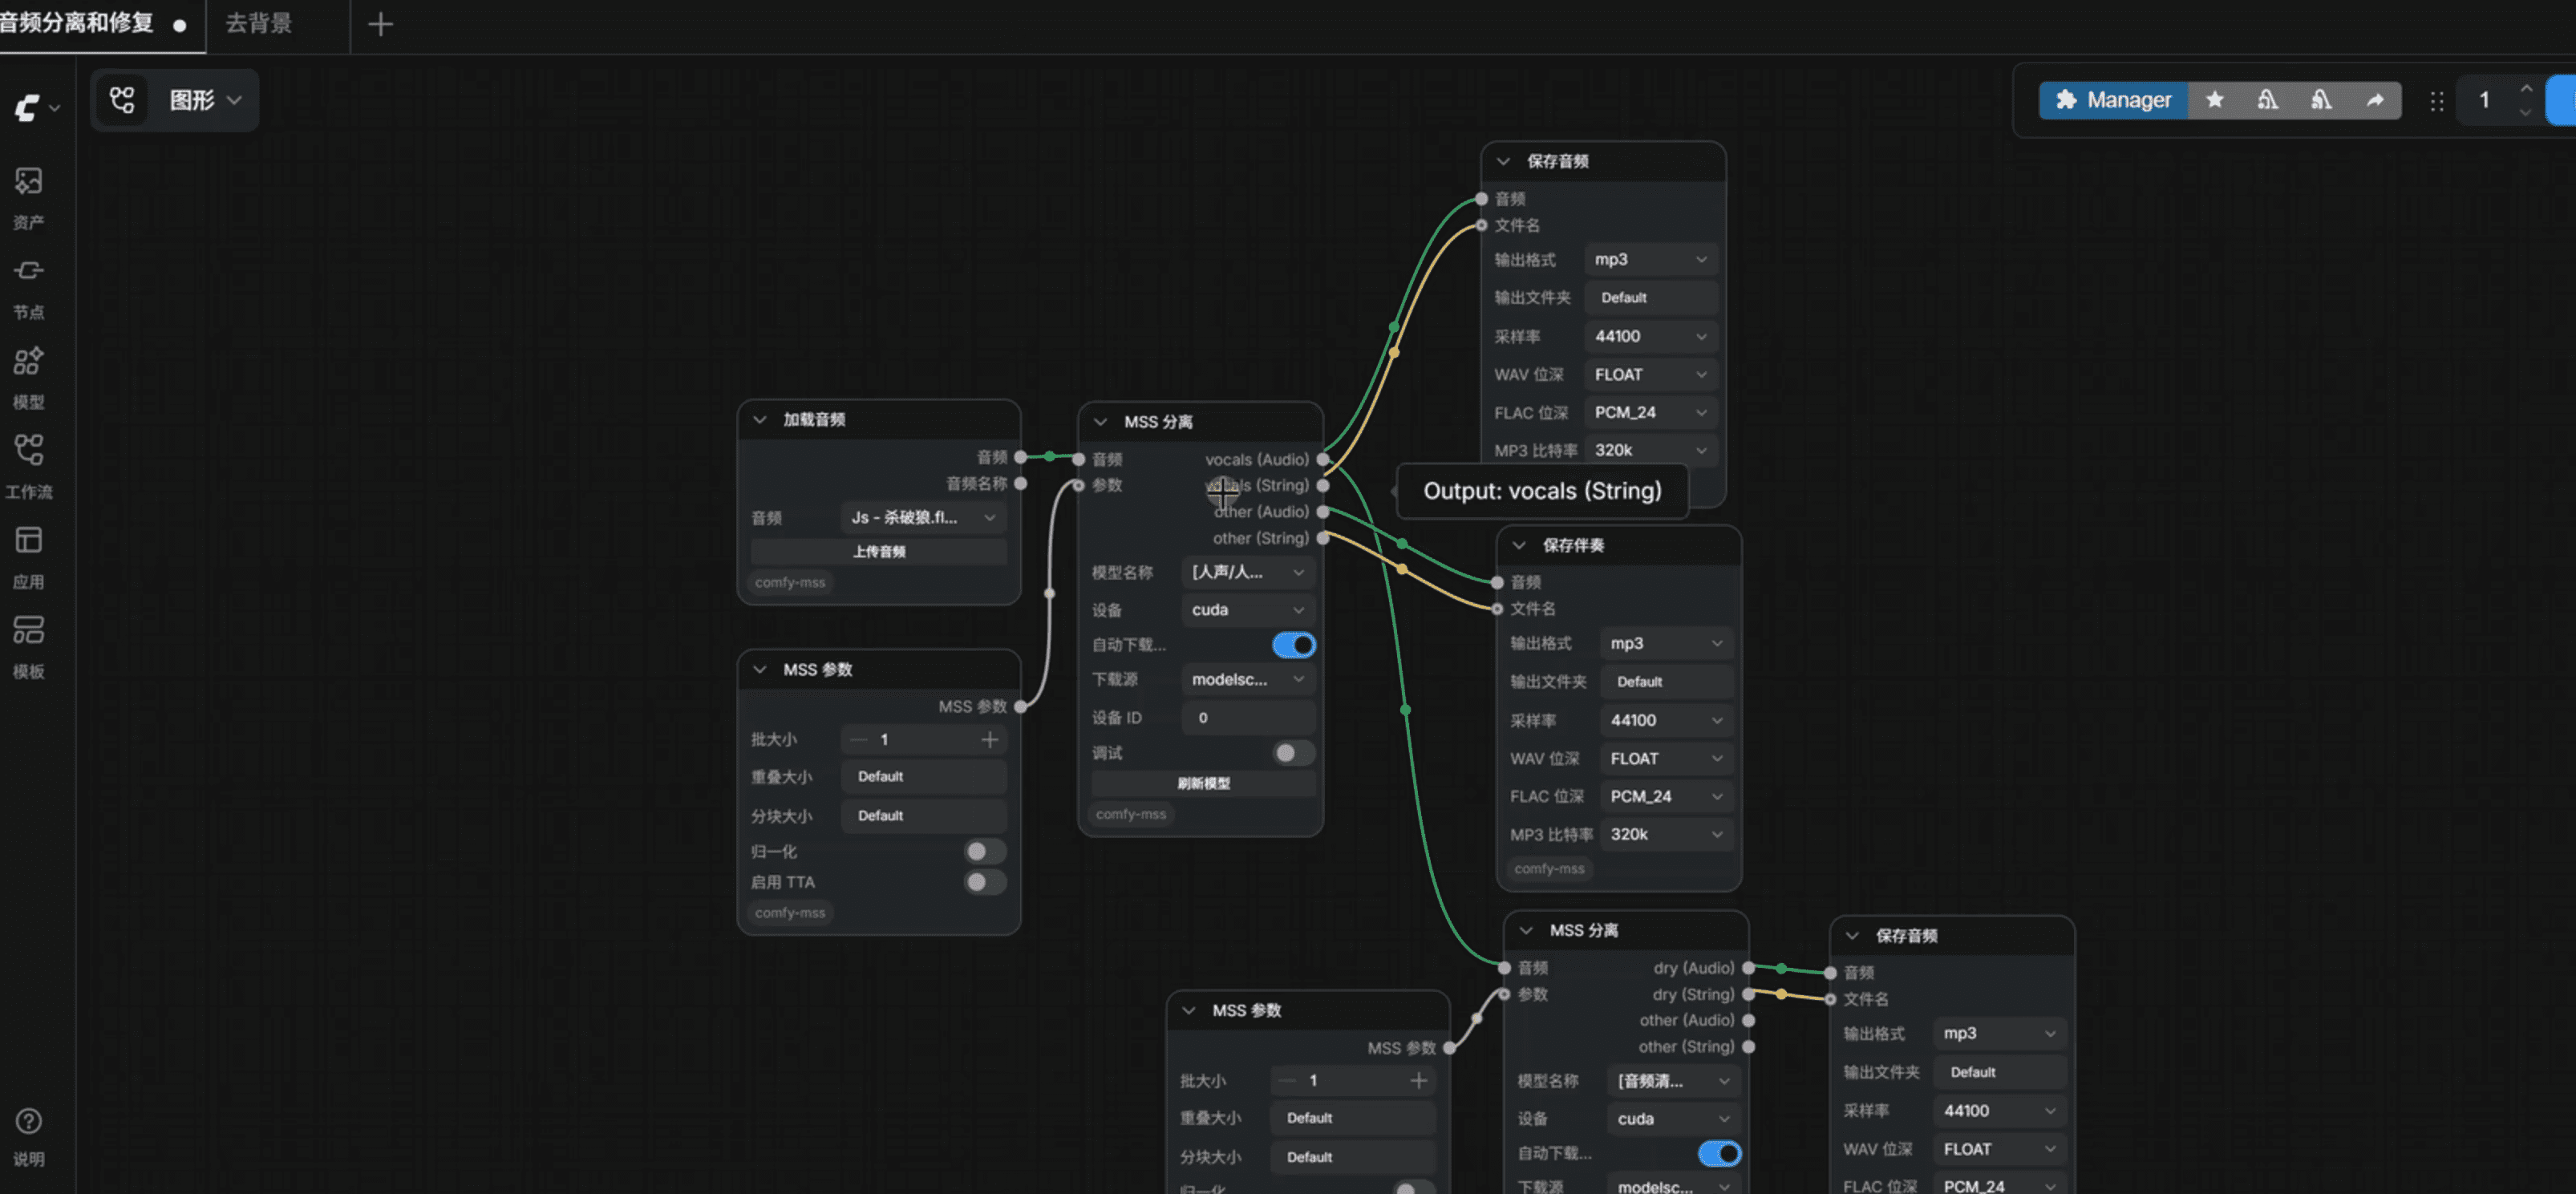
对于追求极致效率的专业用户,基于ComfyUI的工作流模式则展现了强大的生产力。通过节点化的连接,用户可以将“音频加载”、“人声分离”、“音频修复”、“降噪处理”等步骤串联成自动化流水线。例如,在处理一批短视频素材时,工作流可以自动完成从原始音频提取人声、去除背景噪音到最终格式转换的全过程。这种批量处理能力不仅节省了时间,更保证了处理标准的一致性,是规模化内容生产的理想选择。
主流模型深度评测:精度与效率的平衡术
PYMSS的核心竞争力在于其丰富的模型库。经过大量实测,以下几类模型在特定场景下表现尤为突出,值得创作者重点关注。
人声分离:MelBand Roformer与BigShifts的较量
在纯人声提取任务中,MelBand Roformer模型因其卓越的高频保留能力而备受推崇。传统模型在处理复杂编曲时,往往会在人声边缘产生明显的“伪影”或“泄漏”现象,导致伴奏听起来不自然。MelBand Roformer通过改进的频带划分策略,显著减少了此类伪影,使得分离后的人声更加干净、通透。这对于AI翻唱(AI Cover)项目至关重要,因为干净的人声干音是后续音色转换的基础。
相比之下,BigShifts系列模型则侧重于速度与稳定性的平衡。作为大参数量的模型,它在处理流行歌曲时表现出极高的兼容性,分离速度快且资源占用相对可控。对于需要快速产出内容的短视频创作者而言,BigShifts是一个兼顾效率与质量的稳妥选择。
乐器分离:HT Demucs 4的多轨解析能力
当需求从“人声vs伴奏”升级为“多乐器独立分离”时,HT Demucs 4模型展现了其统治力。该模型能够同时分离出人声、鼓组、贝斯、吉他、钢琴等多个音轨。这一功能在音乐制作和编曲学习中具有极高价值。例如,音乐人可以通过分离出的纯鼓点轨道进行节奏分析,或提取贝斯线进行和声重构。HT Demucs 4的优势在于其多任务学习架构,使得各乐器间的干扰最小化,导出的多轨音频具有较高的独立可用性。
音频修复:分离后的精细化打磨
分离并非终点,而是起点。PYMSS集成的MelBand Roformer修复模型,专门用于处理分离后的人声。在分离过程中,由于频谱掩蔽效应,人声往往会出现细微的失真或高频缺失。修复模型通过逆向神经网络,对分离后的人声进行“去卷积”处理,恢复其原始动态范围并消除分离伪影。实测表明,经过修复的人声在听感上更加饱满,细节表现力显著提升,尤其适用于老歌修复及低质量录音的后期优化。
硬件门槛与性能优化:亲民配置下的强大性能
许多用户担心AI音频处理对显卡(GPU)的高要求。事实上,PYMSS在显存优化方面做得相当出色。根据实测数据:
- 4GB显存:可运行部分轻量级模型,适合基础的人声分离任务。
- 6GB显存:基本满足大多数主流模型(如MelBand Roformer)的运行需求,是性价比最高的入门配置。
- 8GB显存:推荐配置,能够流畅处理HT Demucs 4等较大模型,并支持一定的批量处理。
- 12GB及以上:适合处理超大模型或进行长时间的高并发工作流处理。
这意味着,即使是配备RTX 3060等主流游戏显卡的用户,也能在PYMSS中获得流畅的体验。此外,PYMSS支持CPU fallback模式,在显存不足时可自动切换至CPU推理,虽然速度较慢,但保证了任务的最终完成。
工作流实战:从原始音频到成品输出的全链路
为了更直观地展示PYMSS的价值,以下是一个典型的专业工作流案例:
- 音频导入:加载原始混音音频文件。
- 初步分离:使用MelBand Roformer模型,将音频分离为人声干音和伴奏轨道。此时,人声中可能仍残留少量背景噪声。
- 精细化修复:将分离出的人声输入至MelBand Roformer修复模型,消除分离伪影,提升清晰度。
- 降噪处理:若伴奏轨道存在底噪,可接入专门的降噪模型进行二次处理。
- 结果导出:系统自动输出优化后的人声、纯伴奏及修复后的人声文件。
这一流程在ComfyUI中可通过简单的节点连接实现自动化。相比手动使用多个软件分别处理,PYMSS的工作流不仅减少了文件传输和格式转换的时间损耗,更通过算法间的协同作用,提升了最终音频的整体质量。
行业影响与未来展望
PYMSS的崛起反映了AI音频处理领域的一个趋势:工具的平台化与生态化。随着300+模型的接入,PYMSS实际上构建了一个音频AI的“应用商店”。创作者可以根据项目需求,灵活选择最适合的模型,而非被单一软件的功能所限制。
对于音乐产业而言,这种工具的低门槛化将加速AI辅助创作(AI-Assisted Creation)的普及。无论是独立音乐人快速提取伴奏进行Remix,还是短视频博主高效获取背景音乐,PYMSS都提供了标准化的解决方案。未来,随着模型精度的进一步提升和工作流自动化的深化,音频分离将从“后期处理手段”转变为“内容创作的基础设施”。
综上所述,PYMSS凭借其丰富的模型库、灵活的交互方式及高效的性能优化,已成为当前AI音频分离领域的标杆工具。对于追求高品质音频处理的创作者而言,掌握PYMSS的使用技巧,尤其是合理搭配MelBand Roformer与HT Demucs 4等模型,将显著提升内容创作的效率与质感。