通用大模型能否替代专业蛋白预测?哈佛PG-LLM基准揭示性能边界与融合新路径
在人工智能浪潮席卷全球的当下,通用大语言模型(LLM)展现出了令人惊叹的多模态处理能力,从代码编写到创意写作,其边界似乎在不断拓展。然而,当我们将目光投向知识壁垒极高、数据极度专业的蛋白质工程领域时,一个核心问题浮出水面:这些“博学”的通用助手,是否真的具备解决复杂生物科学问题的能力?特别是在蛋白质突变效应预测这一关键环节,通用模型的表现究竟如何?
近期,哈佛大学与Capable研究团队联合提出了一项名为PG-LLM的标准化评测基准,旨在回答这一疑问。该研究依托权威的ProteinGym数据集,首次在完全公平的统一评价维度中,对13款主流通用语言模型和95种专业蛋白质预测工具进行了大规模横向对比。这一举措不仅填补了该领域评估标准的空白,更清晰地划定了通用模型与专用模型的能力边界,为未来的技术融合提供了坚实的数据支撑。
构建公平竞技场:PG-LLM基准的设计逻辑
要准确评估模型能力,首先必须建立一个公正且严谨的测试环境。PG-LLM基准基于ProteinGym v1.3版本构建,涵盖了186种不同蛋白质及217组实验测定数据。这些数据包括148组单位点突变和69组多位点复合突变,确保了测试样本的多样性和代表性。
为了消除采样偏差,研究团队采用了分层抽样策略。所有突变依据实测功能值被均等划分为10个区间,并从各区间抽取近似等量的样本,从而保证候选集均衡覆盖低、中、高不同功能水平的突变体。此外,为降低随机误差,每组实验构建了三套独立的候选突变子集,最终得分取三次评测的平均值。这种严谨的设计使得PG-LLM成为目前最具公信力的蛋白突变排序评测工具之一。
在任务设定上,PG-LLM对通用语言模型提出了极具挑战性的“零样本”要求。模型仅能接收蛋白序列和实验描述,严禁使用多序列比对(MSA)或蛋白质三维结构信息。这意味着模型必须完全依靠其预训练阶段获得的生物知识储备和推理能力,对打乱顺序的突变蛋白进行功能优劣排序。相比之下,专业预测模型则允许使用其原生的配套输入,如MSA和结构信息,以发挥其最大潜能。这种不对等的输入条件,恰恰真实反映了两类模型在实际应用场景中的典型工作状态。
性能大比拼:通用模型的惊喜与局限
评测结果揭示了令人瞩目的现象。在包含50个突变的候选集测试中,Claude Opus 5以斯皮尔曼等级相关系数ρ=0.406的成绩,位居通用语言模型榜首,GPT-5.6 Sol紧随其后。值得注意的是,虽然Claude Opus 5在整体平均分上略胜一筹,但在两者都能完成的180个共享评估指标中,GPT-5.6 Sol以0.409对0.400实现了反超。这表明不同模型在特定任务类型上各有千秋,不存在绝对的单一霸主。
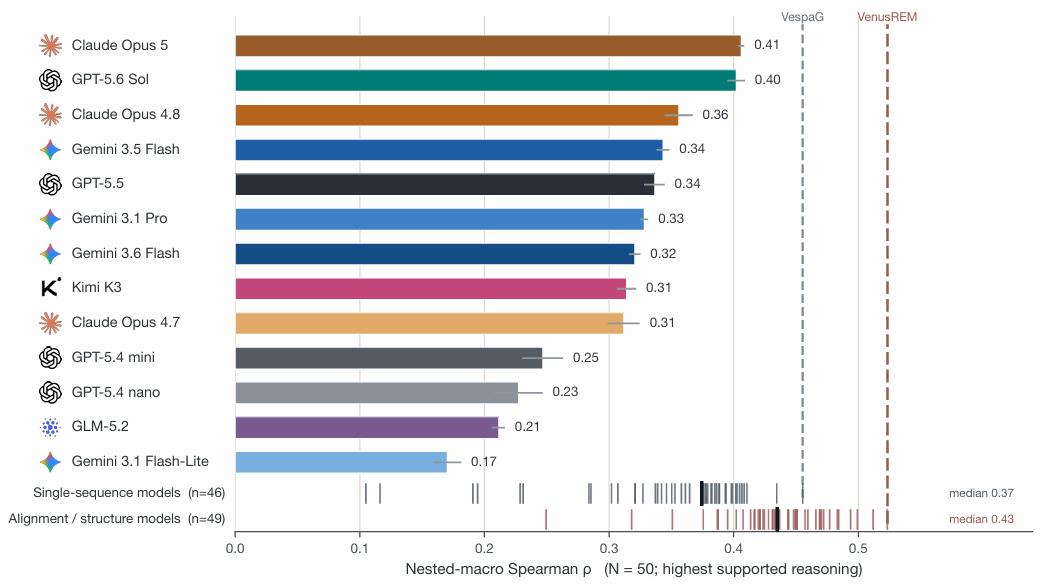
更具参考意义的是通用模型与专业工具的对比。Claude Opus 5的表现超过了95种专业方法中的49种,其中包括46种纯序列方法中的41种。其得分高于纯序列方法的中位数(ρ=0.374),并接近于专用蛋白大模型ESM2-650M的水平(ρ=0.411)。这一结果有力证明了通用语言模型在蛋白质突变筛选中已具备高度的实用价值,不再是仅仅停留在理论层面的“玩具”。
然而,天花板依然明显。尽管通用模型表现不俗,但与当前最先进的专业预测工具相比,仍有显著差距。例如,由天鹜科技AI Lab研发的VenusREM模型,凭借其在检索增强和结构信息融合上的优势,取得了ρ=0.523的优异成绩,大幅领先于所有参测的通用模型。这说明在需要极高精度的科研场景中,专用模型依然不可替代。
机制差异探究:推理资源与数据依赖的深度解析
为何通用模型无法通过简单的资源堆叠来追平专用模型?研究团队通过多维度实验揭示了背后的机制差异。
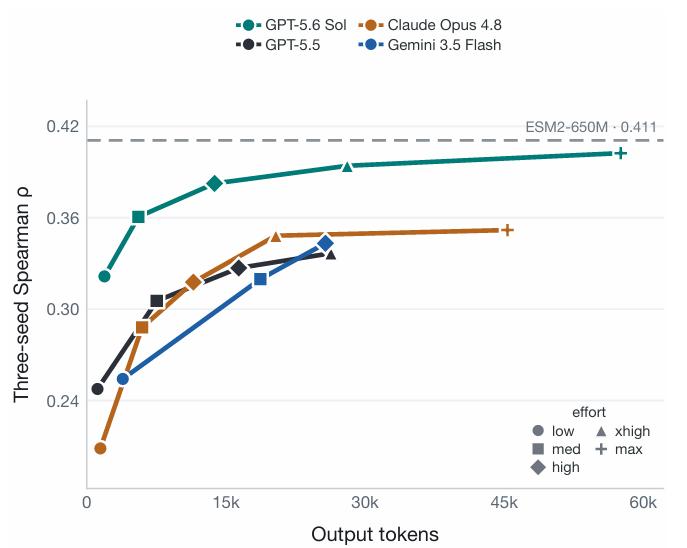
首先,关于推理资源的投入。实验显示,增加模型的思考时间和输出长度,确实能提升GPT、Claude和Gemini等模型的排名准确率。然而,这种增益存在边际效应递减规律,当达到一定阈值后,性能提升趋于平缓,始终无法突破专用模型的性能上限。这表明通用模型在生物领域的知识深度存在本质瓶颈,单纯的推理增强无法弥补专业知识的缺失。
其次,候选集规模的影响呈现出截然不同的趋势。对于通用模型而言,随着候选突变数量从10增加到100,其性能反而出现下降。例如,GPT-5.6 Sol的得分从0.423降至0.375。这是因为通用模型在处理长上下文和复杂排序任务时,容易受到注意力分散和噪声干扰的影响。相反,ESM2和VenusREM等垂类模型几乎不受候选集规模变化的影响,展现出极强的鲁棒性。
最后,对进化信息的依赖程度也是关键差异点。纯序列预测工具的性能随MSA深度的增加而显著提升,高低深度组的性能差值达+0.102。这是因为它们高度依赖同源序列提供的进化保守性信息。而通用语言模型的性能在不同MSA深度下基本保持稳定,差值仅为-0.002。这说明通用模型主要依靠内部参数化的知识进行判断,而非动态提取外部进化信息,这也解释了其在面对罕见蛋白或缺乏同源序列时的局限性。
未来路径:从竞争走向融合的协同范式
PG-LLM的研究结论并非为了证明某一方优于另一方,而是为了探索更优的合作模式。通用语言模型擅长理解复杂的自然语言指令、整合多源信息并进行逻辑推理,而专业预测模型则在特定领域的数值计算和特征提取上拥有无可比拟的精度。
在此背景下,“人机回环”与“模型协同”成为新的突破口。正如VenusREM研发者谭扬博士所言,理想的蛋白质设计流程应是:利用通用大模型作为交互接口,解析科研人员的复杂需求,生成初步的实验方案或候选序列;随后,调用如VenusREM这样的专用模型进行精准的功能评分和结构验证;最后,再由通用模型汇总结果并提供可解释的分析报告。
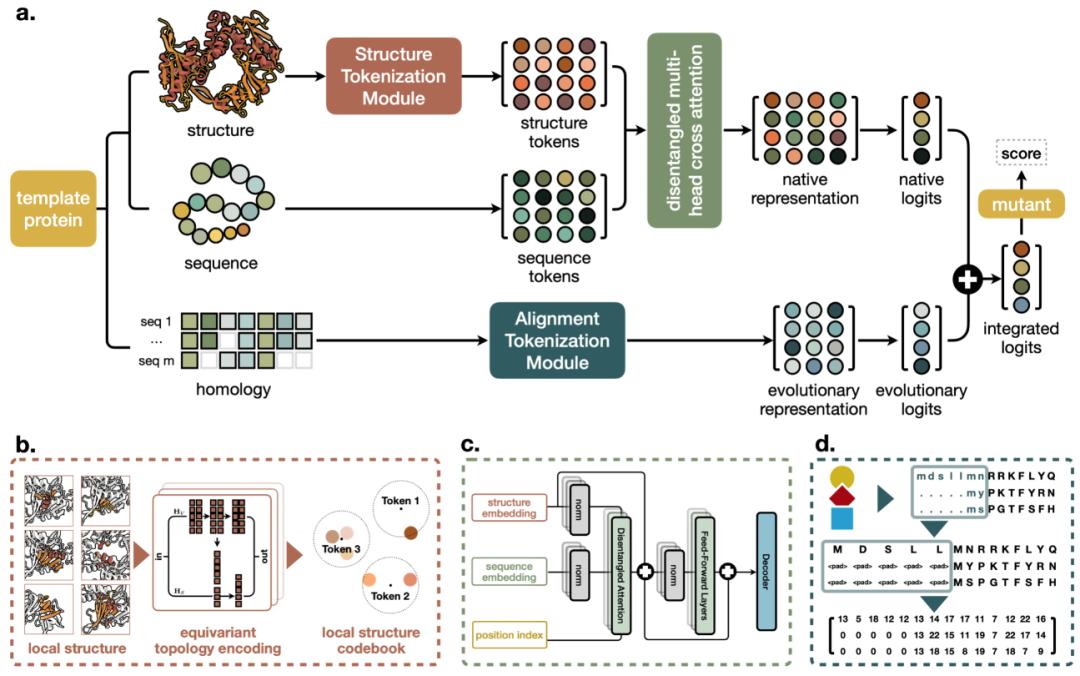
VenusREM本身的技术架构也体现了这种融合思维。它不仅编码氨基酸序列,还将局部三维空间环境离散化为结构词元,并通过解耦多头交叉注意力机制联合建模序列与结构特征。更重要的是,其引入的检索增强模块能够从数据库中搜索同源序列,提取进化保守性信息,实现了序列、结构与进化信息的三维融合。这种设计使其在零样本条件下也能实现高精度的突变效应预测。
基于VenusREM开发的对话式蛋白质研发智能体MatwingsVenus™,正是这一理念的落地实践。它让科研人员无需编写代码,仅通过自然语言对话即可完成从设计到验证的全流程,极大地降低了AI辅助研发门槛。在2026世界人工智能大会上,该产品荣获“镇馆之宝”殊荣,标志着科学智能正从实验室走向产业化应用。
综上所述,PG-LLM基准的建立不仅是一次技术评测,更是对AI for Science发展路径的一次深刻反思。通用模型与专用模型并非零和博弈,而是互补共生的关系。未来,随着两者在架构层面的进一步融合,我们有理由期待一个更加高效、精准且易用的蛋白质工程设计新时代的到来。对于科研机构和企业而言,合理配置这两类工具,构建混合智能工作流,将是提升研发效率的关键所在。