静态嵌入模型极限探索:8MB模型7分钟嵌入维基百科
静态嵌入模型的复兴:从8MB模型到7分钟嵌入维基百科
在自然语言处理领域,基于Transformer的嵌入模型长期占据主导地位,但它们的计算开销和存储需求也带来了不小的挑战。近年来,静态嵌入模型——仅通过查找表和平均池化生成文本表示——重新引起了研究者的关注。这类模型虽然无法捕捉词序和上下文,但在特定场景下展现出惊人的效率和实用性。
本文记录了一次完整的实验:从大规模数据训练、量化压缩到CPU推理优化,最终实现了一个仅8MB的静态检索模型,能够在7分钟内嵌入整个英文维基百科。这个结果不仅验证了静态模型的潜力,也为资源受限环境下的检索系统提供了新的思路。
静态嵌入模型的工作原理
静态嵌入模型的核心思想极其简单:每个词元对应一个固定向量,文本的嵌入就是所有词元向量的平均值,再进行L2归一化。整个过程没有注意力机制,没有上下文交互,也没有深层网络。
以"hello world"为例,假设词表中有两个词元,每个词元对应一个8维向量。模型会查找这两个词元的向量,计算它们的均值,然后归一化得到最终的文本嵌入。这个过程的计算量远小于任何Transformer模型,但代价是无法区分"bank"在"river bank"和"bank account"中的不同含义。
尽管存在这些局限,静态模型在以下场景中依然具有独特价值:
- 大规模语料的去重和聚类
- 训练更大模型时的硬负样本挖掘
- 重排序前的第一轮候选生成
- 设备端和浏览器端的轻量级应用
训练数据扩展:660M对带来的提升
本项目的起点是复现并超越现有的静态检索模型。参考模型sentence-transformers/static-retrieval-mrl-en-v1使用了约8000万对训练数据,而本项目使用了LightOn提供的6.6亿对精选数据,是前者的八倍多。
为了高效处理如此大规模的数据,我设计了一套预分词和内存映射的数据加载方案。所有文本在训练前被转换为词元ID,并存储为连续的二进制文件,配合偏移量索引,使得训练时只需简单的切片操作即可获取任意样本。这种设计充分利用了操作系统的页缓存,避免了重复解析和内存分配的开销。
训练采用了两阶段策略:第一阶段在全部6.6亿对数据上进行对比学习,第二阶段使用硬负样本进行微调。模型架构与参考模型完全一致:一个30522×1024的嵌入矩阵,使用BERT词表,平均池化,以及多维度Matryoshka训练。
实验结果显示,数据规模带来的提升是显著的。在NanoBEIR基准上,模型从100M对时的0.5035提升到660M对时的0.5212,而在去污染的BEIR基准上,12个任务的平均NDCG@10从0.4334提升到0.4581。值得注意的是,性能曲线尚未完全饱和,这意味着进一步增加数据可能还会带来更多收益。
硬负样本微调:静态模型的意外收获
硬负样本微调通常用于训练精细的语义区分能力,但静态模型缺乏注意力机制,理论上难以从这种训练中获益。然而,实验结果表明,即使是最简单的平均池化模型,也能从硬负样本中学到一些东西。
在LightOn的微调数据集上进行了10轮训练后,模型在去污染的BEIR基准上提升了0.0168,在域内留出集上提升了0.0252。虽然这个提升幅度远小于Transformer模型(如DenseOn的+0.0715),但证明了静态模型并非完全无法从困难样本中学习。
值得注意的是,微调数据与BEIR基准存在重叠,因此绝对分数不能直接作为泛化能力的证据。为此,我采用了去污染的评估方案,移除了与训练数据重叠的文档和查询,确保结果的可靠性。
量化:静态模型的天然优势
静态模型的结构简单性使其成为量化压缩的理想对象。由于没有深层网络和中间激活,量化误差只引入一次,且平均池化可以抑制部分噪声。实验发现,静态模型在量化时表现出惊人的鲁棒性。
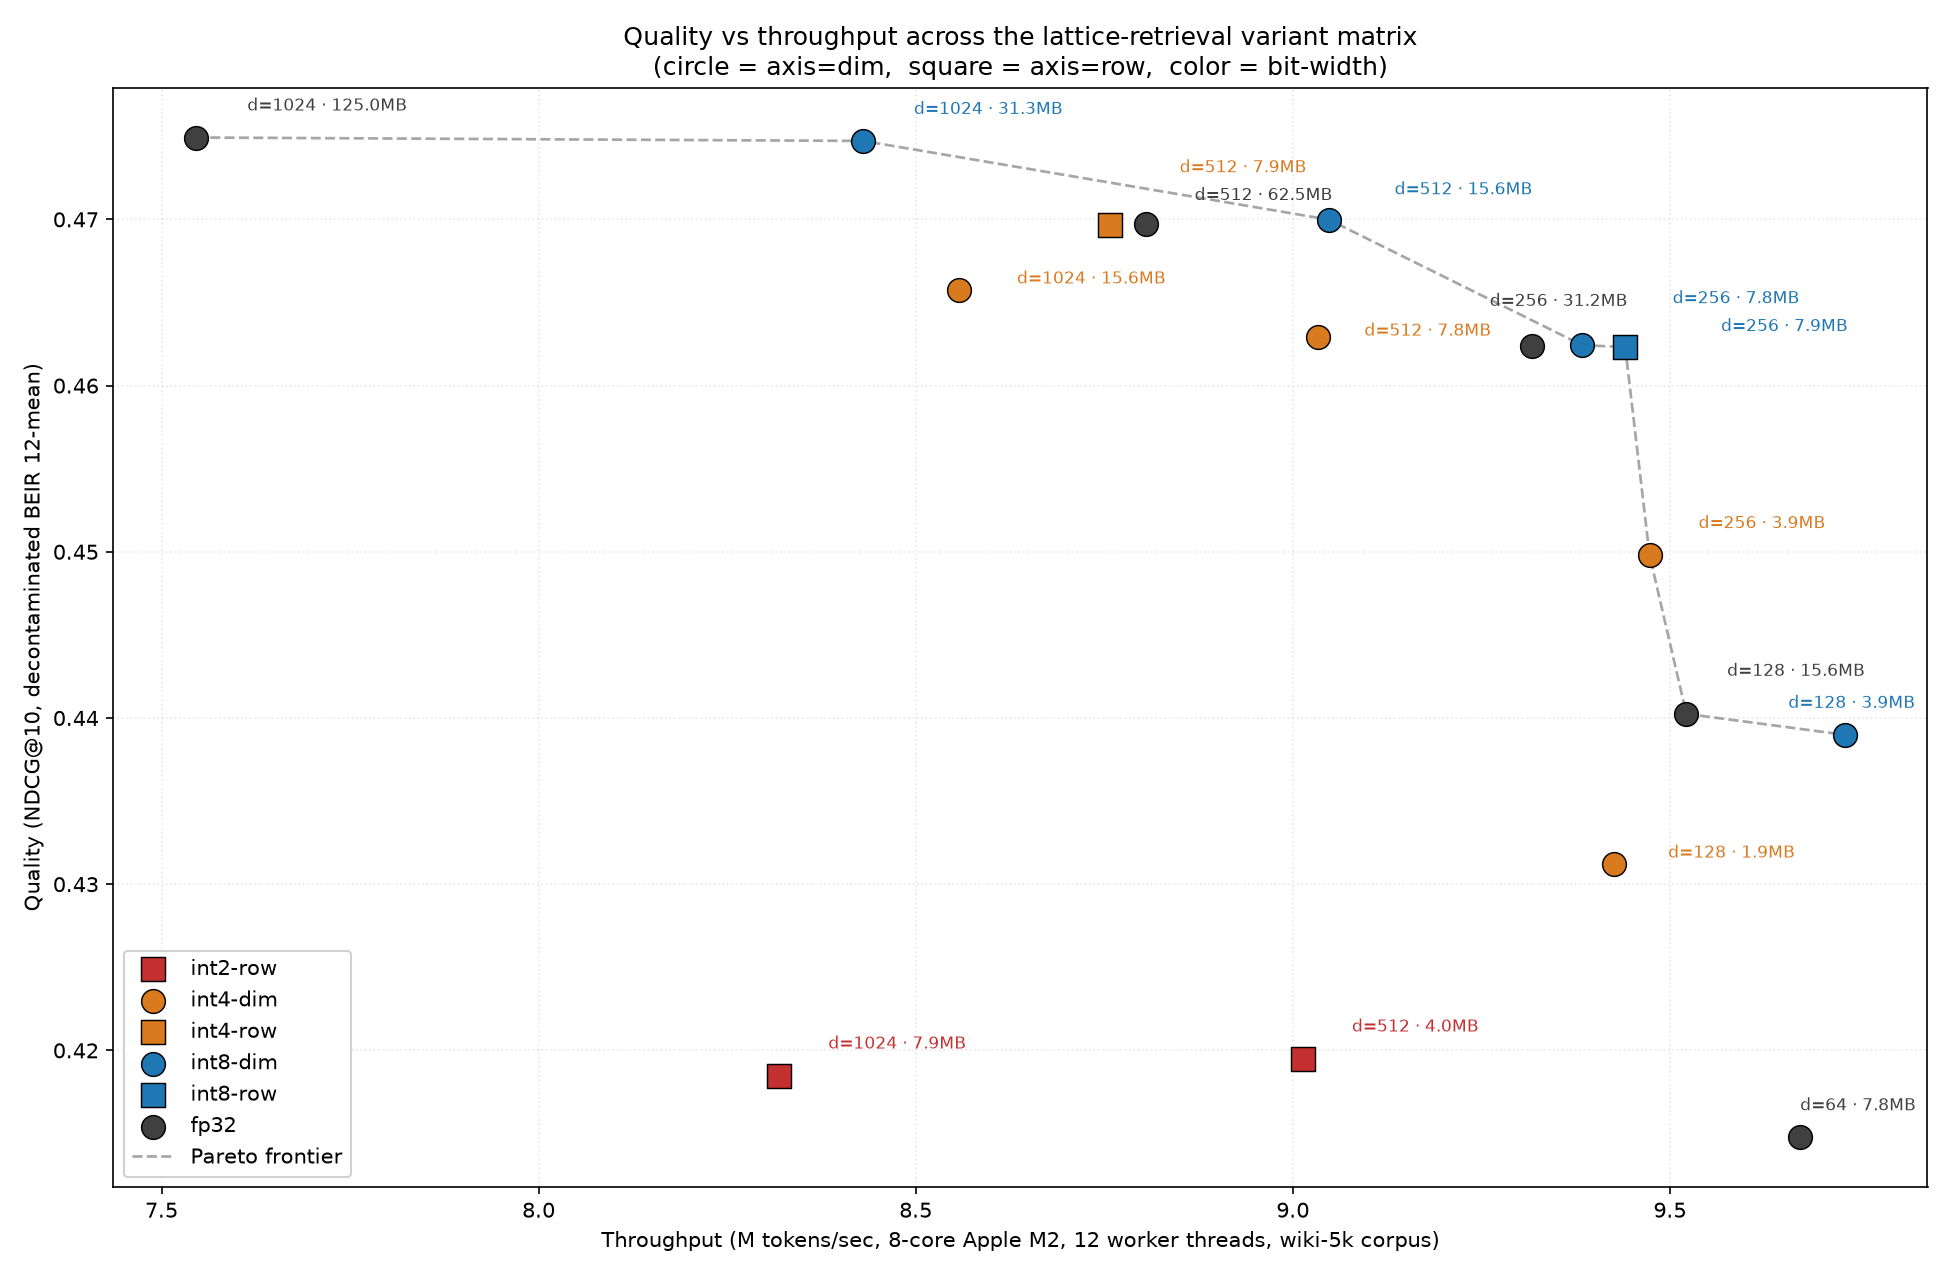
在量化策略上,我比较了按行和按维度两种缩放方式。按行缩放为每个词元分配独立的缩放因子,能够适应词元间的动态范围差异;按维度缩放则共享列缩放,计算效率更高,但在低比特率下可能导致部分词元被完全抹除。
实验数据显示,词元行的最大绝对值动态范围高达97.8倍,而维度的动态范围仅为3.7倍。这意味着按维度量化时,一些"安静"的词元可能被"响亮"的词元压制,在int2精度下,有25%的词元行被完全清零。相比之下,按行量化避免了这个问题,但推理时需要在词元循环内进行浮点运算。
最终,int4按行量化在512维下取得了最佳平衡:权重文件仅7.94MB,而NDCG@10与fp32版本几乎相同(0.4697 vs 0.4697)。int8量化则几乎无损,但文件大小仍为31MB。int2虽然文件更小,但质量损失严重,不适合实际应用。
CPU推理优化:纯Rust运行时
为了在消费级硬件上实现极致的推理速度,我开发了一个纯Rust运行时。该运行时采用内存映射加载模型权重,利用SIMD指令进行向量化计算,并通过多线程并行处理输入。
关键的优化技巧是避免在计算均值前对每个词元行进行反量化。对于按维度量化的模型,由于缩放因子是共享的,可以将缩放操作移到求和之后,从而在热循环中只进行整数累加。具体来说,对于int4模型,每个字节包含两个4位编码,通过减去偏置7并乘以缩放因子,可以在最后一步统一处理。
这种设计使得模型计算仅占总运行时间的6.1%,而分词占据了91.7%。在8核Apple M2 MacBook Air上,整个英文维基百科(640万篇文章)的嵌入耗时仅7分26秒,吞吐量达到每秒952万词元。
总结与展望
这项研究系统地探索了静态嵌入模型的极限,主要发现包括:
- 数据规模仍然有效,660M对数据带来了显著提升
- 硬负样本微调对静态模型有适度帮助
- 静态模型量化表现优异,int4按行量化几乎无损
- 优化的运行时使大规模语料嵌入成为笔记本电脑级别的任务
当然,静态模型无法替代强大的Transformer检索器,但在需要高吞吐、低成本和紧凑部署的场景中,它们提供了极具吸引力的选择。未来,结合任务特定的投影层或混合架构,或许能进一步缩小与Transformer模型的差距。