AI算力超级单体:百万卡时代的数据中心革命
从芯片到系统:AI竞争的新战场
当英伟达CEO黄仁勋在去年接受金融时报采访时断言“中国将赢得AI竞赛”,很多人以为他在谈论芯片。但他随即补充道:未来算力爆发的门槛不在芯片,而在网络、电力、储能、散热等基础设施。
这个判断正在被现实验证。今年4月,OpenAI的星际之门项目接连按下暂停键:英国站点因能源成本过高和监管不确定而停摆,挪威数据中心搁置,得州阿比林旗舰站点扩建计划被放弃。计划2027年竣工的美国数据中心产能,超过60%至今未动工,另有7%明确延期。
问题并非美国独有。当算力从万卡迈向十万卡、百万卡,芯片不再是唯一决定因素。网络、电力、散热等基础设施共同决定一座算力集群能释放多少真实算力。过去处于后台的基础设施,正在走到AI竞争的前台。
乌兰察布:超级单体的诞生地
在内蒙古乌兰察布,地质稳定、气候凉爽、电力充沛。这里是国家“东数西算”八大枢纽节点之一,网络时延位居全国第一梯队,全域绿电占比达67%。
最近,远景科技集团在这里正式投产“远景乌兰察布星河基地”,园区内全球最大的AI算力超级单体同步亮相。这个超级单体建筑面积超12万平方米,相当于20个标准足球场,刷新了AI数据中心的算力密度,是全球Token产出能力最强的单体AI数据中心。
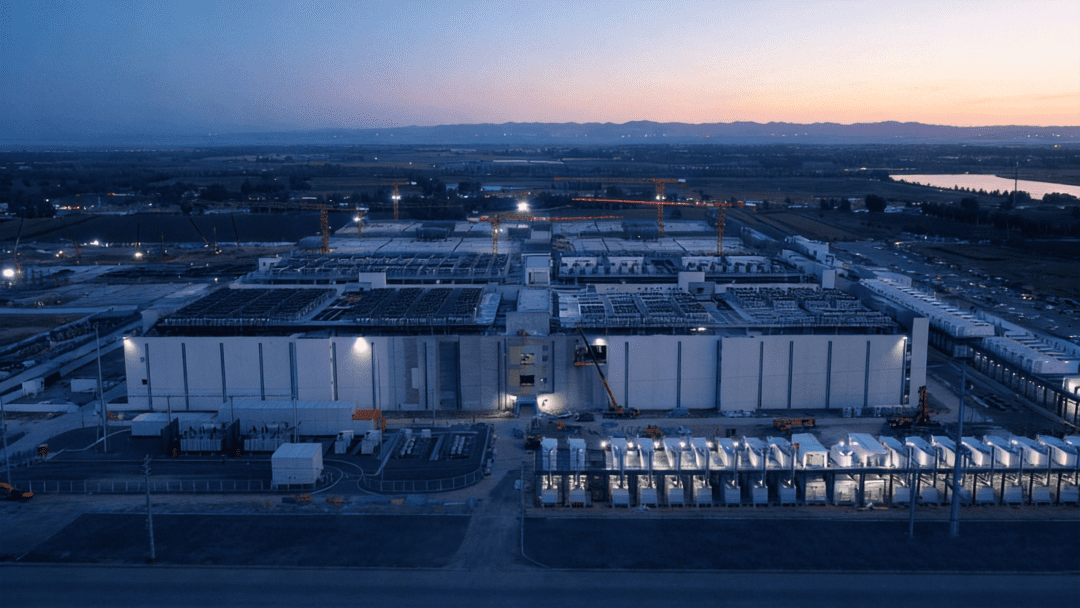
整个园区总规划容量达2GW,可支持百万卡同时运行,拥有百万P级算力规模,是全国最大的AI算力园区。作为对照,OpenAI在得州阿比林的首个星际之门站点,据知情人士透露规划容纳约40万张卡。
为什么必须要有“超级单体”?
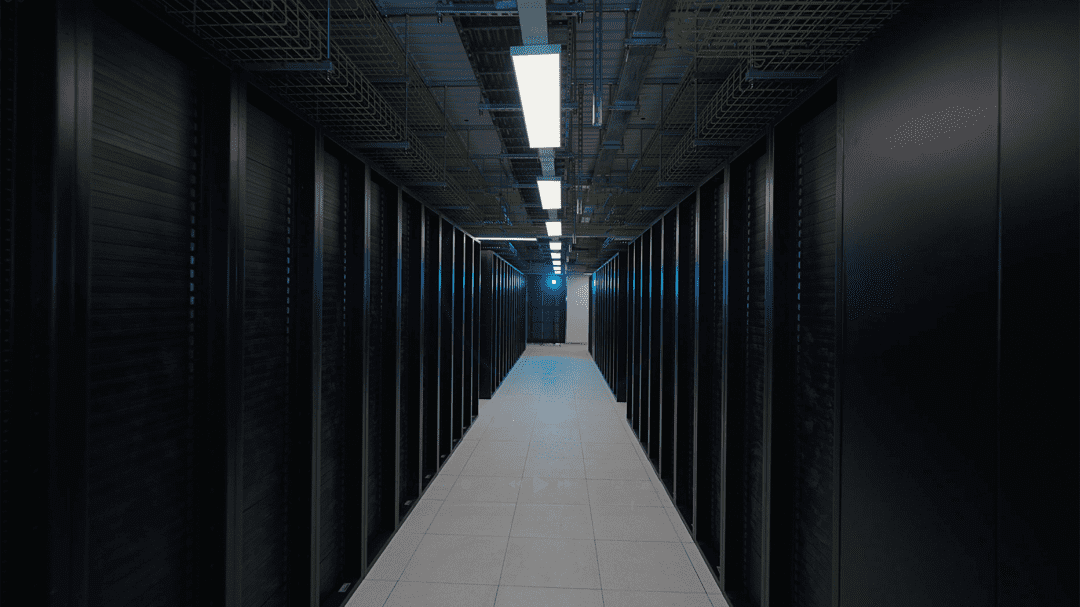
数据中心集群规模一旦推到百万卡量级,物理约束立刻从芯片转移到别处。电力要持续稳定地送到每一排机柜,海量热量要被高效带走,数十万乃至百万张卡之间还要保持高速互联。任何一环跟不上,都会造成算力闲置和集群效率骤降。
这意味着AI基础设施正在发生结构性变化:数据中心不再只是容纳服务器的建筑,而要成为为AI算力专门设计的复杂系统。
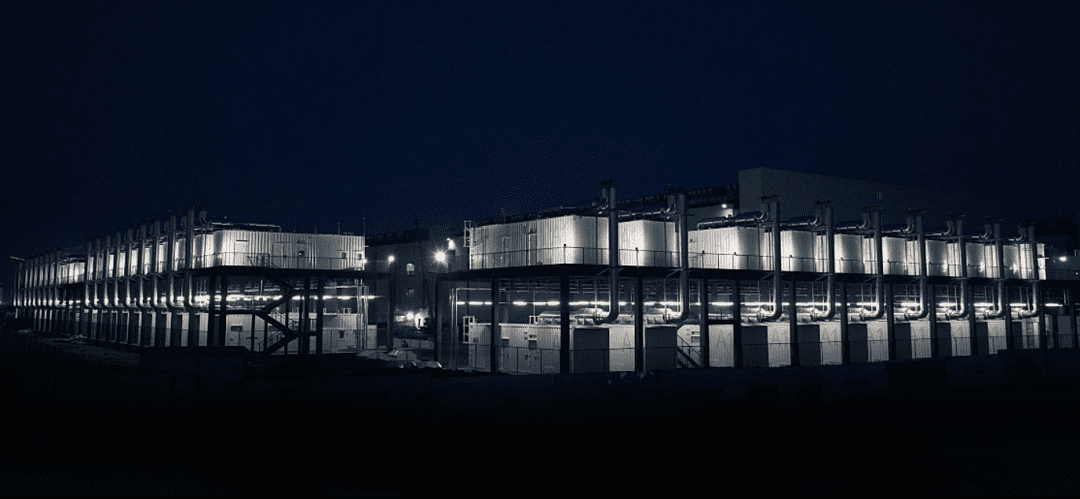
“AI算力超级单体”应运而生。它不是传统数据中心的简单放大版,而是一种为超大规模芯片集群重新设计的基础设施形态,也是AI开始反向定义数据中心的结果。它将算力部署、网络互联、电力供应、储能、散热和智能调度集中在同一个高度集成的建筑与系统中。只有当这些基础设施协同工作,芯片数量才会真正转化为可调用、可持续、可扩展的算力。
远景AIDC总经理郑子浩把这套逻辑概括成一支集团军的后勤问题:“中国芯片走的是集群化突围的路,超级单体要提供的是足够大的部署基地、足够充足的电力粮草和一条畅通的补给线。”
核心:全新的AI电力系统
规模是结果,能力才是前提。十万卡、百万卡要汇聚成一个整体,互联效率、电力供应、散热缺一不可。
GW级用电负荷接近一座中等城市。传统数据中心依赖公共电网被动供电的模式,在这样的规模下会面临并网容量、建设周期、能源成本和可靠性等多重约束。百万卡集群需要的,不只是更多电,而是一整套重新为AI设计的能源与热管理系统。
远景选择把发电、电网、储能、算力负荷和AI调度放进同一套系统协同运行。远景科技集团董事长兼创始人张雷在国家能源局的全国“人工智能+”能源现场推进会上诠释了远景的AI电力系统。他的判断是,大模型约每6个月一次重大迭代、芯片约12个月一个版本,而承担能量转换的电力系统过去一百年几乎没有结构性变化。当指数级发展的芯片和模型撞上线性演进的电力系统,矛盾必然在后者身上产生。
远景要解决的,其实是三个问题:如何让波动的绿电变成稳定的算力能源,如何让更多电高效送到芯片,以及如何把高密度算力产生的热持续带走。
把波动的绿电,变成稳定的算力能源
远景乌兰察布星河基地的电来自自建风场,通过专线直供,全年80%以上电量直接从风机发出送进机房。这带来一个绕不开的矛盾:风电天然高波动,但AI训练要的是工业级的稳定电力。
第一步是预测。“远景天机气象大模型”融合卫星、雷达、地面气象站和设备运行数据,并引入大气动力学、地形等物理约束,将天气变化转化为不同时间尺度的风光功率预测。长期预测用于安排发电和储能计划,短期预测则提前识别功率骤升、骤降和极端天气风险。在高比例可再生能源直供条件下,气候系统本身就是能源系统的一部分,对天气的预测能力直接决定调度精度的上限。
第二步是优化。“远景天枢能源大模型”结合预测结果与实时设备状态,在发电、储能、负荷和算力需求之间持续寻优:风力增强时提前为储能腾出容量,风力减弱前预留电量和备用功率。
统一调度的前提,是让不同设备进入同一个控制系统。远景EnOS智能物联操作系统将风机、储能、电力设备和算力设施接入同一套系统,上层模型负责预测与优化,场站控制器滚动调整策略,底层设备快速执行,形成从感知、决策到控制的闭环。
与此同时,小时级储能负责平滑风光出力和调度偏差,秒级储能结合SST和800V直流架构响应算力负荷变化,更快速的功率补偿则用于处理AI训练和推理带来的瞬时电能质量问题。这套多时间尺度储能体系,使高比例绿电能够真正转化为稳定、可调度的算力能源。
供电架构:让更多电到达芯片
数据中心供电链路长期存在一笔隐性成本:从中压交流到芯片端的低压直流,中间要经过多次变换,每次都吃掉一部分效率。也就是说,供电架构本身也决定着最终有多少电真正到达芯片。
远景在乌兰察布项目采用的是SST加BESS的800V直流架构,固态变压器负责中压到直流的直接变换以减少中间环节,电池储能内嵌在供电链路里承担瞬时功率支撑。其核心是能够缩短从中压电网到芯片的整个供电链路,让更多电真正进入GPU,而不是损耗在中间转换环节。
热管理必须与供电一起设计
超节点带来的另一个极限,是热。数十万乃至百万张芯片集中部署后,供电密度和热流密度会同时放大。输入服务器的电能最终大部分都会转化为热量,任何散热瓶颈都会直接影响芯片持续满载运行。
乌兰察布低温气候为自然冷却创造了条件,超级单体同时结合风冷、液冷等高密度散热方案,降低用于制冷的非算力能耗。因此,AI电力系统并不只是“供电系统”。它把能源管理、芯片供电和热管理放在同一个架构中协同设计:电要稳定地进来、高效地到达芯片,热还要持续地出去。
超节点解决芯片如何协同计算,AI电力系统解决的是这些芯片如何持续、高效、低成本地运行。
从能源侧延伸:重构AIDC交付
过去,数据中心主要由电信运营商、专业数据中心开发商和互联网巨头主导:运营商提供网络,开发商建设机房,互联网公司部署服务器,电力更多只是从电网采购的一项生产要素。
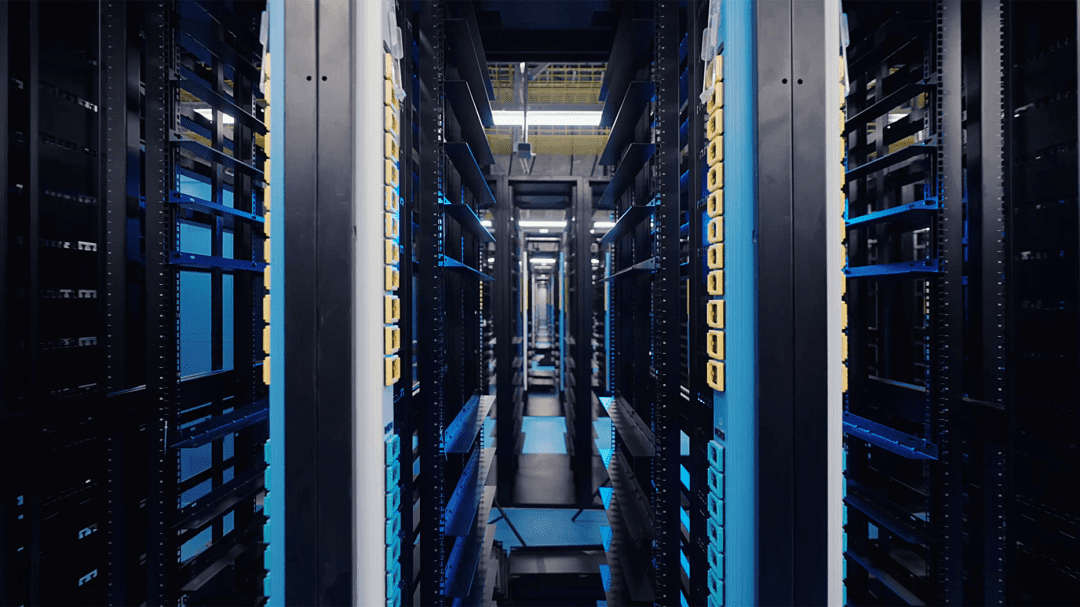
但当IT负荷进入百兆瓦乃至GW级,能源获取、供配电、储能和热管理开始决定项目能否按期建成、能否高效运行。AIDC的技术重心,因此正在从传统机房工程向能源基础设施明显迁移。
这也解释了为什么一家能源企业会进入AIDC领域。远景不是从服务器和芯片向能源侧延伸,而是从能源侧向机房内部延伸。从风场、绿电专线、储能和电力电子,到墙内供配电、冷却和超级单体,远景试图把过去由不同供应商分别承担的环节,整合成一座完整的AI基础设施。
这与行业多数设备商和解决方案提供商的交付边界不同。远景负责土建、供配电、绿电、储能和配套系统,客户则部署和管理自己的服务器和芯片集群。对客户而言,理想状态是“把卡运来即可部署”,减少从拿地、并网到能源系统建设的时间和不确定性。换句话说,客户负责算力,远景负责让这些算力拥有可以直接运行的基础设施以及背后支撑的AI电力系统。
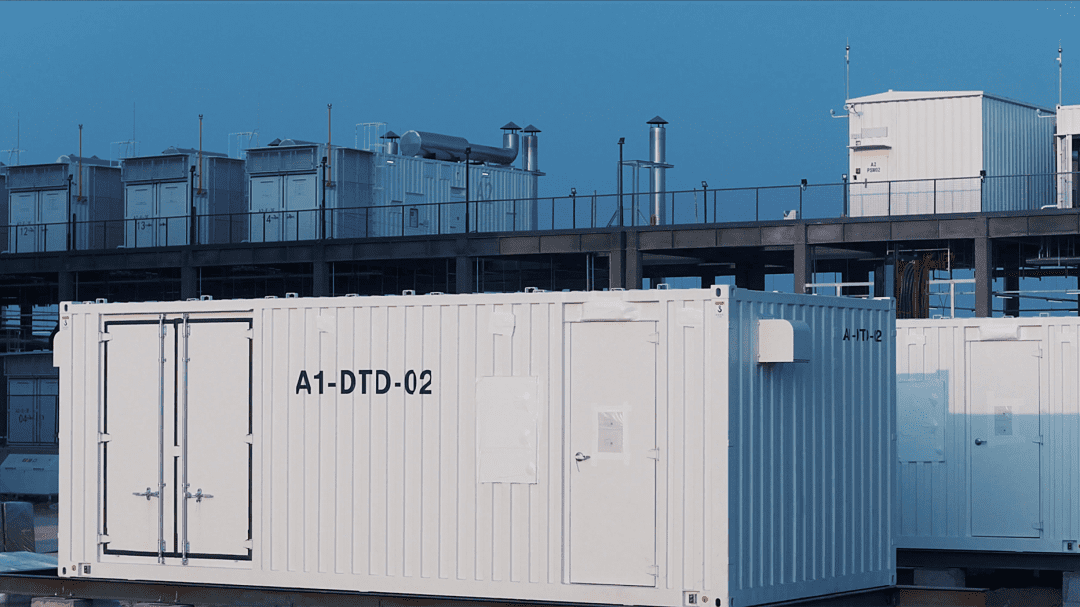
更重要的是,远景乌兰察布星河基地已经建成并投入运营,全球最大的AI算力超级单体也已同步落地。这意味着,远景已经完成了从技术方案、工程建设到AIDC实际交付的跨越。
从乌兰察布出发:超级单体能否复制?
2026年6月,远景发布戈壁使命(Mission Gobi),目标是到2030年在全球戈壁荒漠地区建成5GW规模的绿色AI算力中心。“远景乌兰察布星河基地”是戈壁使命的首个旗舰项目。
远景希望复制的,并不是一栋12万平方米的超级单体,而是“能源富集区+超级单体+AI电力系统”的绿色数据中心模式。过去,数据中心往往围绕城市、网络和既有电网布局。而星河基地尝试的是另一种逻辑:让大规模算力主动靠近土地和绿色能源,在能源富集区同步规划能源与AI基础设施,再通过高速网络连接主要算力需求市场。
远景并不涉及客户芯片和算力运营,而是希望把自身在风机、储能、电力电子、能源管理和工程交付上的能力,转化为支撑大规模AI算力运行的基础设施能力。
这背后也折射出中国AI基础设施正在形成的一条特色路径。中国拥有庞大的算力需求、快速发展的国产计算生态,同时具备全球领先的新能源开发能力、完整的储能和电力装备产业链,以及大规模基础设施建设能力。相比单纯追求某一个环节的性能极限,更重要的问题开始变成:如何把这些资源组织成一个高效的系统。
超节点将更多芯片组织成高效协同的计算系统,超级单体为这些集群提供高密度的物理承载,而AI电力系统进一步把绿电、储能、供配电和热管理组织起来。计算、能源与基础设施不再分别优化,而是开始围绕整个系统的效率共同设计。
从这个意义上说,远景星河基地不仅仅是用基础设施“弥补”某个单点的不足,而是在放大中国已有的产业优势——用系统工程能力,把芯片、能源、土地和基础设施转化为更大规模、更高效率的可用算力。
因此,真正需要验证的,不是这一栋超级单体还能装下多少卡,而是这套“超级单体+AI电力系统”模式,能否在更多能源富集地区实现规模化复制,走向全球。如果能够复制,星河基地就不再只是乌兰察布的一项规模纪录,而可能成为百万卡时代一种新的AI基础设施形态:算力跟随能源布局,计算与电力协同设计,以系统效率释放每一张芯片、每一度电的价值。
超级单体不是算力竞赛的终点,而是AI基础设施从“设备堆叠”走向“系统协同”的一个起点。