TimechoAI时序大模型实战:从零开始掌握时序数据接入与调用
一、专栏开篇:我们到底要干什么
1.1 为什么写这个专栏?
在工业一线摸爬滚打多年,我发现很多开发者对时序数据的理解往往停留在概念层面。当真正需要将大模型与时序数据结合时,常常无从下手。市面上的教程要么过于高深,一上来就是数学公式;要么过于简略,丢一段代码让你自己跑,跑不通也不管。这两种方式对新手都不友好。因此,我决定从最基础的内容讲起,逐步拆解每一个细节,帮助大家真正掌握这套技术。这个系列规划了约两百篇文章,虽然数量庞大,但每个知识点都会深入剖析,确保读者能够扎实掌握。
1.2 这套东西到底适合谁看
如果你是一名后端开发,经常与数据库打交道,但对大模型了解不深,这个专栏非常适合你。如果你是数据分析师,厌倦了繁琐的SQL查询,想寻找更智能的工具,这里也有你需要的答案。甚至如果你是运维人员,每天面对海量监控图表,希望有一个能自动生成分析报告的工具,这个专栏同样能帮到你。我们不谈空洞的理论,只关注实际应用、联调技巧和避坑指南,这就是本专栏的定位。
二、扒掉外衣:到底什么是时序数据
2.1 别被名词吓到,其实就是带时间戳的数字
在深入TimechoAI之前,我们必须先理解它处理的对象——时序数据。官方术语听起来高深,但说白了,它就是带时间戳的数据。普通数据如用户表,包含姓名、年龄等静态信息,时间属性并不重要。而时序数据则必须包含时间标签,否则就失去了意义。例如,监控服务器CPU使用率,仅记录“80”这个数字毫无价值,必须记录“2023年10月24日14:00,CPU使用率80%”,时间与数值紧密绑定。
2.2 它和我们平时存的那些数据有啥区别
再举一个生活化的例子:每天早晨称体重,记录“早上8点,70公斤”“早上8点01分,70.1公斤”,这就是一组时序数据。在工业界,这类数据无处不在:车间温度传感器每五秒上报一个温度值,电表电量按分钟累加,股票分时价格每秒跳动,手环心率记录连续曲线。这些数据共同的特点是数据量大、持续写入,且很少修改历史记录。例如,昨天下午三点的温度测错了,通常不会更新那条记录,而是追加一条备注或忽略。这种追加式的写入模式,是理解时序数据的关键。
三、传统处理方式为什么让人这么累
3.1 以前我们是怎么干活的
在没有大模型的时代,处理时序数据主要依赖SQL。我们将数据存入时序数据库(如IoTDB、InfluxDB),然后通过查询语句获取信息,比如计算过去一小时的平均温度。这看似简单,但真实业务场景往往复杂得多。
3.2 老板的一个需求,暴露了SQL的短板
假设老板要求:“分析昨晚三号线的温度异常情况,并判断是否与机器转速有关。”这个需求立刻暴露了SQL的局限。首先,需要同时查询温度与转速数据,但两个传感器上报时间点不一致,必须进行时间对齐,涉及插值或窗口函数。其次,需要定义“异常”的标准,是超过80度还是波动超过10度?定义后还需编写复杂的聚合和窗口函数。最后,老板可能进一步追问异常的根本原因,而SQL只能提取数据,无法进行推理或生成自然语言报告。传统方式往往止步于“查数据”,而“分析”和“解释”必须依赖人工,盯着折线图手动撰写报告,效率极低。
四、时序大模型能在这个场景里干嘛
4.1 换一种思路:用大白话去查数据
TimechoAI的核心,是将大语言模型的能力引入时序数据领域。你不再需要编写复杂的SQL,只需用自然语言提问:“帮我看看昨天三号线的温度有没有异常,有的话总结可能的原因。”它就能直接返回一段文字分析。
4.2 背后的原理其实很直白
其原理并不神秘:大模型本身无法直接理解数字序列,只识别文本。TimechoAI在中间做了一层转换,将查询到的时序数据转化为模型可读的格式,模型通过逻辑推理分析后,再将结果转化为人类可读的文字。这省去了大量编写代码和数据可视化的时间。以前可能需要用Python脚本和matplotlib画图,人工寻找波峰波谷,现在模型直接完成分析并生成报告,这就是最直接的价值。
五、搞懂整体调用流程,别一上来就敲代码
5.1 先在脑子里过一遍框架图
动手之前,我们先梳理整个交互流程,以便后续看代码时思路清晰。流程如下:
- 发送自然语言问题
- 鉴权校验(API KEY是否有效)
- 解析意图,提取时间范围与指标
- 返回原始时序数据
- 大模型推理与分析
- 返回JSON结果
- 接收结果
作为使用者,我们站在客户端位置,组装问题并携带身份凭证(API KEY)发送至API网关。网关首先验证KEY,无效则返回401错误。验证通过后,请求进入模型后台,内部从时序数据库提取数据,模型分析后生成结论,再通过网关返回。
5.2 把它当成一个黑盒来看待
整个过程中,我们只需关注两件事:如何发送请求,如何解析返回结果。中间的数据转换和模型推理,完全可以视为黑盒。无需关心内部神经网络结构或参数规模,只需将其视为一个智能助手,输入问题,输出答案,这样心理负担会小很多。
六、前期准备:去哪里拿通行证(API KEY)
6.1 注册账号和找对入口
要使用TimechoAI服务,首先需要注册账号。登录后,第一步不是写代码,而是获取API KEY,它相当于门禁卡。访问密钥管理页面(https://ai.timecho.com/settings/keys),点击“创建密钥”按钮。
6.2 拿到KEY之后的那些坑
创建后,会弹出一个包含密钥的窗口。注意,这串字符只显示一次,关闭后无法再次查看。如果未复制,只能删除旧密钥重新创建。因此,看到密钥后应立即复制并妥善保存,例如存入环境变量或本地文件。切勿明文写在代码中并上传至GitHub,以免泄露。我曾见过新人因此被刷掉数百元额度。此外,页面上通常显示配额信息,如每日调用次数和每分钟限制,需留意,避免因死循环触发限流。
七、怎么看开发文档才不迷路
7.1 新手看文档最容易犯的错
拿到KEY后,下一步是阅读文档(https://ai.timecho.com/docs/)。新手常犯的错误是从头到尾逐行阅读,导致迷失。正确做法是直接查找“快速开始”或“API参考”板块,跳过架构介绍和模型原理,先专注于让代码跑起来。
7.2 重点找哪几个参数
在API参考中,重点寻找请求的URL地址和必需参数。例如,基础请求地址可能是https://ai.timecho.com/v1/chat/completions。参数方面,通常必须包含API KEY(放在请求头)、模型名称(model)和消息内容(messages)。其他如温度、最大token数等参数,初期使用默认值即可,不要急于调优,先跑通最简单的请求。
八、体验一下官方的应用示例
8.1 在网页上先玩一玩
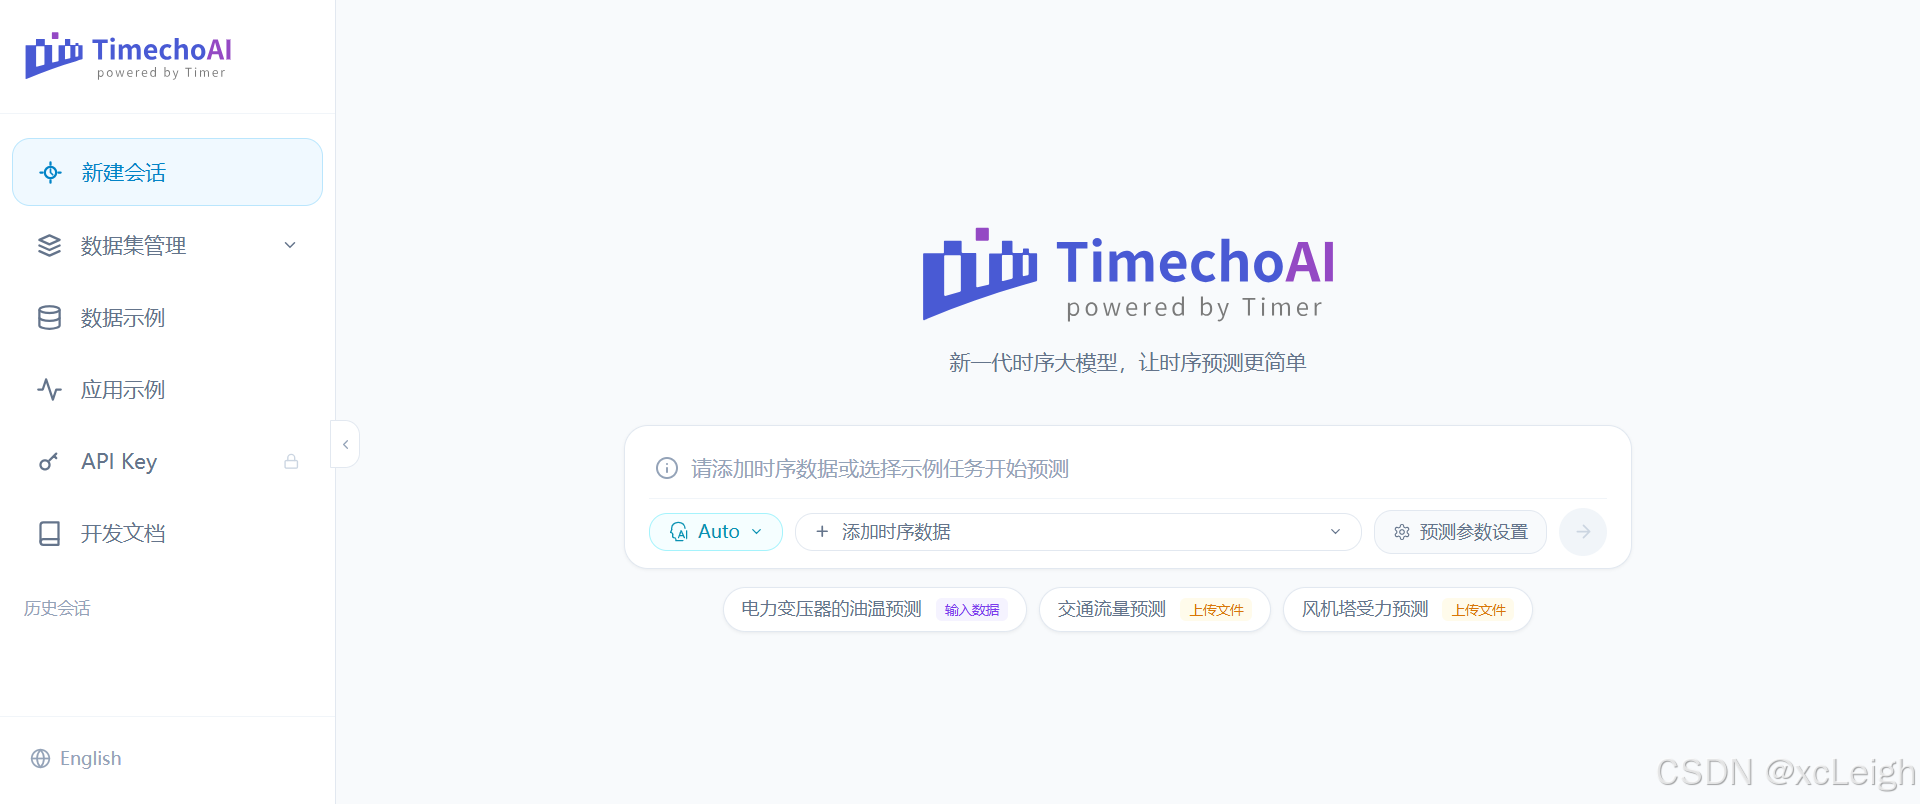
官方提供了实时交互页面(https://ai.timecho.com/realtime),类似聊天界面。你可以输入问题,如“帮我查一下最近一小时的CPU平均负载”,后台会自动调用API并展示结果。
8.2 为什么建议你在这里调提示词
建议多在此页面尝试,观察返回的数据格式。你会发现,返回内容不仅包含文字,还可能附带数据摘要或趋势描述。这个页面是测试工具,你在页面上能实现的功能,代码同样能实现。如果页面无法回答某个问题,代码调用也会失败。因此,在写代码前,先在这里打磨好问题,因为大模型对提问方式敏感,好的提示词能显著提升回答质量。调整好提示词后,再写入代码,可避免反复修改。
九、环境准备:把工具箱备好
9.1 Python版本的坑
开始编码前,确保已安装Python 3.8以上版本。过旧版本(如2.7或3.6)可能引发兼容性问题。在终端输入python --version检查版本。若未安装,请前往官网下载安装包。
9.2 安装requests库
打开终端,安装requests库,用于发送网络请求。执行命令:
pip install requests若pip命令不可用,说明环境变量未配置,需自行搜索配置方法。安装完成后,新建Python文件(如test_timecho.py),使用支持代码高亮的编辑器(如VSCode、PyCharm)打开。
十、第一行代码:发一个最简单的请求
10.1 引入库和定义地址
首先导入所需库:
import requests
import jsonjson库用于解析API返回的JSON字符串。然后定义请求地址:
url = "https://ai.timecho.com/v1/chat/completions"注意路径必须准确,多或少一个斜杠都会导致404错误。
10.2 拼装请求头和请求体
准备请求头,包含API KEY:
api_key = "sk-你的真实KEY粘贴在这里"
headers = {
"Content-Type": "application/json",
"Authorization": f"Bearer {api_key}"
}注意Bearer前缀,后跟空格和KEY,这是标准认证格式。接着构造请求体:
payload = {
"model": "timecho-model", # 请替换为文档中的实际模型名
"messages": [
{
"role": "user",
"content": "你好,请简单介绍一下你自己。"
}
]
}model参数需查阅文档,填写当前可用的模型名称。messages列表包含对话上下文,role为user表示用户输入。
10.3 发送请求和解析结果
发送POST请求:
response = requests.post(url, headers=headers, json=payload)使用json=payload,requests库会自动将字典转为JSON字符串,并设置Content-Type。然后打印状态码和响应文本:
print(response.status_code)
print(response.text)状态码200表示成功。响应文本是JSON字符串,包含模型回复。提取回复内容:
result_dict = response.json()
answer = result_dict['choices'][0]['message']['content']
print(answer)这样就能得到干净的模型回答。
十一、把代码稍微封装一下,养成好习惯
11.1 加上try…except防崩溃
将代码封装为函数,并添加异常处理:
import requests
import json
def ask_timecho_ai(question, api_key):
url = "https://ai.timecho.com/v1/chat/completions"
headers = {
"Content-Type": "application/json",
"Authorization": f"Bearer {api_key}"
}
payload = {
"model": "timecho-model",
"messages": [
{"role": "user", "content": question}
]
}
try:
response = requests.post(url, headers=headers, json=payload, timeout=10)
response.raise_for_status()
result_dict = response.json()
answer = result_dict['choices'][0]['message']['content']
return answer
except requests.exceptions.HTTPError as err:
return f"请求报错了,状态码是:{err}"
except Exception as e:
return f"发生了不知道什么错:{e}"
if __name__ == "__main__":
my_key = "sk-你的真实KEY粘贴在这里"
my_question = "什么是时序数据库?"
result = ask_timecho_ai(my_question, my_key)
print(result)11.2 加上timeout和raise_for_status
timeout=10防止请求卡死,raise_for_status()确保非200状态码立即抛出异常,便于定位错误。这些习惯能提升代码健壮性。
十二、初步接触时序提问的技巧
12.1 试着问点沾边的问题
将问题改为与时序数据相关的内容,例如:
my_question = "如果我有一组服务器的CPU监控数据,每秒一条,我想找出其中突然飙升的时间点,你应该怎么帮我分析?"模型可能不会直接给出数据结果,而是提供方法论,如通过斜率计算、动态阈值或突变点检测。
12.2 提示词工程的概念
这验证了模型的意图理解能力。在实际开发中,提示词越清晰,分析越准确。例如,明确指标、时间范围和异常定义。后续专栏将深入讲解时序场景的提示词编写技巧,今天只需建立概念。
十三、常见报错排查(新手必看)
13.1 报401怎么办
返回401 Unauthorized,表示API KEY无效。检查三点:KEY是否复制完整;请求头是否包含Bearer前缀(注意空格);KEY是否被禁用。
13.2 报400怎么办
返回400 Bad Request,说明请求体格式错误。常见原因是model参数拼写错误,或JSON格式损坏(如漏引号、多逗号)。可打印payload检查语法。
13.3 报429怎么办
返回429 Too Many Requests,表示触发限流。官方对每个KEY有频率限制,循环中需添加time.sleep()控制节奏。
13.4 没报错但返回空内容怎么办
代码无异常但content为空,可能是问题过长超出上下文限制,或服务端临时故障。尝试缩短问题或稍后重试。
十四、今天这篇我们就先打住
14.1 回顾一下今天干了啥
作为专栏开篇,我们解决了“是什么”和“怎么接通”的问题。跑通代码意味着环境、账号、网络均正常,这是最关键的一步。
14.2 下期预告
下一篇将真正接触时序数据输入,讲解如何将真实时间序列数据按格式传给大模型,进行异常检测。如果遇到问题,对照常见错误排查,大部分是低级错误。代码不怕报错,慢慢调试即可。我们下期再见。