类脑互补视觉突破:天眸芯如何解决开放世界视觉退化难题?
开放世界中的视觉退化:AI感知的隐形瓶颈
在人工智能技术飞速发展的今天,多模态大模型、世界模型与具身智能正不断拓展AI能力的边界。然而,一个基础性问题却长期被忽视:开放世界中的视觉退化。当高速运动的物体、强烈的光照变化、频闪干扰等复杂现象同时出现时,传统视觉系统往往束手无策。图像结构失真、信息缺失,导致AI系统做出错误判断。更棘手的是,这类退化数据缺乏可靠的真值标注,难以用于传统监督学习,成为训练中的盲区。
以自动驾驶为例,车辆在隧道出口遭遇强光,或对向车灯造成过曝,摄像头捕获的画面可能丢失关键交通信息。即便拥有强大的感知模型,错误的视觉输入也会导致决策失误。同样,在工业检测中,高速运转的零部件会产生运动模糊,使得缺陷难以识别。这些场景共同指向一个核心需求:如何在有限硬件资源下,获取高质量、高鲁棒性的视觉信息,为机器人和具身智能提供可靠的感知基础。
从0到1:天眸芯开创互补视觉感知范式
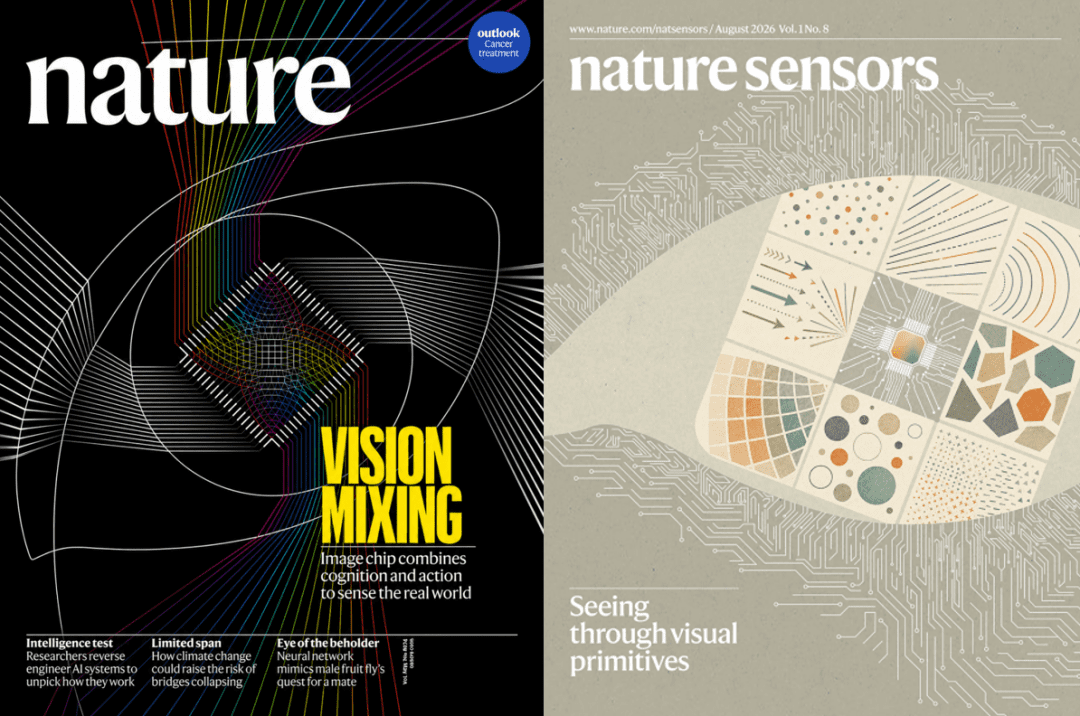
2024年,清华大学类脑计算研究中心团队在《Nature》封面发表研究成果,首次提出基于视觉原语的类脑互补视觉感知新范式,并研制出全球首款基于原语的双通路互补视觉感知芯片“天眸芯”。这一工作借鉴人类视觉系统的核心机制,将开放世界的视觉信息拆解为视觉原语,通过有机组合形成“认知通路”与“运动通路”两条优势互补的感知通路。
具体而言,天眸芯将光信号分解为三类互补的数据模态:认知导向通路(COP)保留完整RGB信息,动作导向通路(AOP)捕捉高精度、高动态范围、高速稀疏信息,包括空间差分(SD)和时间差分(TD)。不同通路对视觉退化的响应各异:RGB保留颜色与外观,但易受运动模糊和过曝影响;空间差分保留边缘,却缺少运动特征;时间差分对变化高度敏感,但也可能将闪烁误判为位移。多种视觉原语互为补充,使AI系统同时获得颜色、结构和变化证据,在不同退化之间形成有效互补。
这一创新不仅提供了新的感知硬件,更奠定了从感知入口应对视觉退化的基础。然而,多路感知只是起点,真正的挑战在于如何让AI在退化信息中判断“该信谁”。
从1到10:自监督学习构建内部模型
2026年,团队在《Nature Sensors》封面发表最新进展,实现了从“1到10”的系统级算法软件生态飞跃。研究借鉴人类视觉原语的自监督表征构建与内部模型形成机制,将互补视觉扩展为一个可学习、可迁移、可扩展的完整技术体系。
核心突破在于提出了无需真值标注的退化数据自监督表征学习框架。传统方法依赖“完美图像”作为监督信号,但在开放世界中,这种真值往往不存在。团队另辟蹊径,将不同视觉先验嵌入一组中间表征,使其各自具有不同的优势,进而让不完整的证据彼此预测、校验。例如,积分表征适应光照变化,运动补偿表征恢复瞬时结构,高动态范围表征补回过曝或欠曝区域。
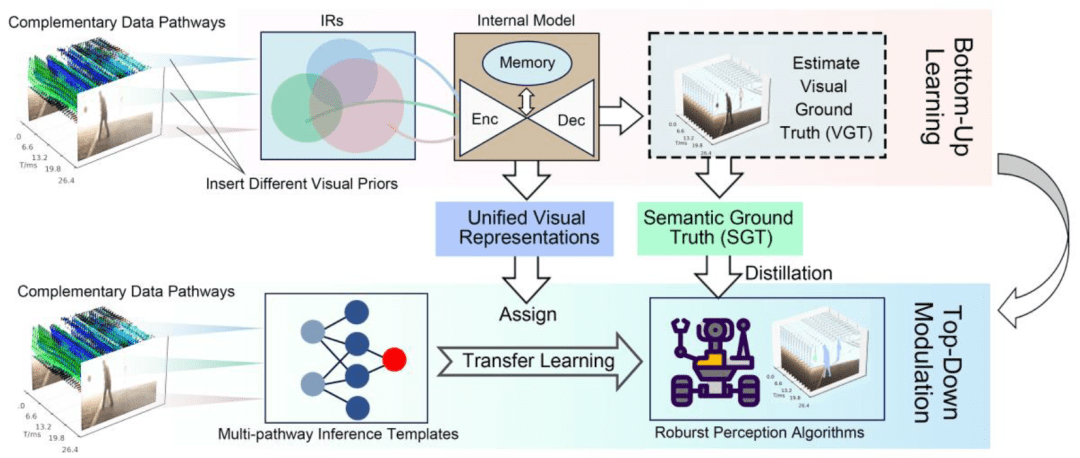
基于这些表征,研究进一步通过时间上的对称自监督预测学习获得了一个内部模型——IGFNet。它利用跨通路注意力和记忆模块分配权重,保留可靠线索并推断缺失结构,最终在隐空间中形成通用的视觉表示,并可解码出视觉真值的估计(e-VGT)。这一过程为AI构建了尽可能完整、清晰、高动态范围且时空对齐的表征,使模型能够直接从真实退化数据中学习有效视觉表示。
从“看清”到“看懂”:感知能力赋能下游任务
自上而下阶段,内部模型的视觉知识被送入高层任务。一条路径以e-VGT作为“新画布”,帮助基础模型生成语义标注;另一条迁移IGFNet内部形成的鲁棒特征,让下游网络继承应对视觉退化的能力。AI获得的不只是一张清晰图像,而是可用于深度、分割和定位的感知基础。
在单目深度估计中,团队以实拍数据的e-VGT配合大模型标注,建立了在极端环境下有良好单目深度标注的Tianmouc-MDE数据集,并将预训练的IGFNet编码器接入深度网络。实验表明,即使图像受到曝光变化等视觉退化影响,深度结构仍能保持连续。在视频实例分割中,团队构建了Tianmouc-VIS数据集并设计YOLO-CVS,配合模拟数据习得基本的检测和分割能力。尽管数据集规模不大,但基于e-VGT生成的真实标注在多个模型的训练验证下都显著提升了极端环境下的检测和实例分割表现。
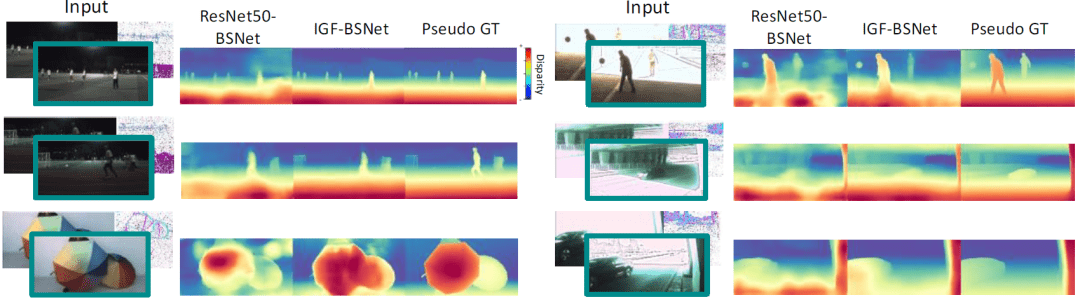
这些成果展示了互补视觉从“看清”到“看懂”的跨越,为自动驾驶感知、工业缺陷动态检测、低空无人机成像等场景提供了高鲁棒性的解决方案。
生态矩阵:TianMouCV开源与多领域应用
《Nature Sensors》论文不仅提供了完整的理论框架,还正式发布了服务天眸芯的TianMouCV算法软件库。目前,TianMouCV已支持多篇顶会顶刊的发表,逐步形成围绕天眸芯的算法应用生态群。
在手机影像领域,天眸芯可在一次RGB曝光内同步记录空间差分和时间差分,保留结构与运动证据。CVPR 2026工作STGDNet在超过100类真实场景中验证,实现了无模糊成像。在机器人场景中,IROS 2025工作CSVO以低帧率RGB和高速空间差分构建异步双通路视觉里程计,在曝光错误和快速视角变化中保持更稳定的轨迹。结合视频扩散生成模型,ICCV 2025工作训练出级联双向循环扩散模型(CBRDM),实现精准、清晰且色彩丰富的视频帧重建。
此外,互补视觉在可穿戴设备与心理学领域也展现出潜力。基于天眸芯的眼动追踪可用稀疏差分信号追踪快速、微小的眼球变化,大幅降低算力与功耗需求,适用于AR/VR及可穿戴设备。在深度估计任务中,双通路互补特征能够被高效解码、融合与优化,精准还原场景真实深度分布,显著提升复杂动态场景下的精度与稳定性。
从10到100:重塑Physical AI时代的感知基础设施
从2024年“天眸芯”提出新的AI视觉感知范式,到如今《Nature Sensors》封面进一步构建从传感、自监督表征到系统认知的完整技术框架,清华团队围绕“天眸芯”持续完善了覆盖芯片、算法与软件生态的协同创新体系。这一路线不仅推动了互补视觉研究不断向前发展,也正逐步辐射全球相关领域的前沿探索。
作为清华大学类脑计算研究中心成果转化的核心平台,晰见科技全面承接并持续推进“天眸芯”类脑视觉技术的产业化应用。公司核心创始团队均师从施路平教授、赵蓉教授,长期参与国家类脑智能重大科研项目,曾作为核心成员参与两项登上《Nature》封面的原创文章。研发团队中博士、硕士占比超80%,核心成员平均拥有10至20年的图像传感器与芯片从业经验,曾服务于索尼、英伟达、安森美等全球顶尖企业。
依托这一产学研协同团队,类脑互补视觉技术正在快速实现工程化落地。基于视觉原语RGB+TD+SD融合感知与双通路混合芯片架构,晰见科技实现了自适应视觉Token提取,在减少90%以上冗余视觉信息的同时,将多模态大模型与世界模型的首token延迟(TTFT)大幅降低20倍以上,Token处理速度(TPS)提升10倍以上,并使模型训练成本降低一个数量级。
更重要的是,这推动了视觉大模型输入范式的转变。长期以来,AI视觉系统始终以“帧×像素”作为统一输入,将海量冗余像素送入模型,再依赖大规模算力完成信息筛选。而类脑互补视觉首次将视觉原语直接组织为稀疏、高信息密度的视觉Token,使传感器输出天然与Transformer等大模型的Token表示相衔接,实现了从“采集全部像素,再理解世界”向“直接获取可理解的信息单元”的范式跃迁。
这意味着,视觉传感器不再只是数据采集设备,而开始承担信息编码与语义组织的前端计算,成为大模型和世界模型的智能输入层。随着这一新型视觉输入范式不断成熟,类脑互补视觉正推动智能机器人、无人系统、AR/VR、智能制造等场景加速落地,为Physical AI构建面向开放世界、更高效、更鲁棒的新一代视觉基础设施。
结语
从“天机芯”到“天眸芯”,再到如今的《Nature Sensors》封面工作,清华大学类脑计算研究中心团队始终坚持从第一性原理出发,探索新型智能计算与感知体系。这条持续十余年的原创技术路线,正不断推动类脑互补视觉走向Physical AI的真实应用。未来,随着TianMouCV生态的持续壮大和产业化进程的加速,我们有理由相信,类脑互补视觉将成为下一代智能系统不可或缺的感知基石,为AI在开放世界中的可靠运行提供坚实保障。