TensorCast革新大模型基础设施:统一张量管理层破解万亿参数时代难题
近年来,大模型技术的飞速发展推动了计算基础设施的持续演进。从最初的简单推理到如今复杂的多轮对话Agent,从单机部署到分布式集群,整个生态系统经历了前所未有的变革。然而,伴随着模型规模的指数级增长和应用场景的日趋复杂,一个深层次的架构问题逐渐浮出水面:如何高效管理在系统各组件间流动的海量张量状态。
传统的优化思路主要聚焦于计算层面的效率提升,包括并行策略优化、请求调度改进、显存管理增强以及算子层面的精细化调优。这些技术确实显著提升了模型推理性能,但面对日益增长的张量管理需求,现有架构开始显露出明显的局限性。当模型规模达到万亿参数级别,上下文长度扩展至数十万token,多轮交互Agent成为常态时,张量状态的管理复杂度呈几何级数增长。
在实际应用中,这种挑战表现得尤为突出。大模型服务弹性扩容时,需要将TB级别的模型权重快速分发到新实例;长上下文和多轮对话场景中,需要存储大量GB级KV Cache,并在推理实例间快速迁移和复用;强化学习训练中,需要将训练节点产生的TB级新模型参数快速同步到大量rollout推理节点。这些张量状态已不再是计算过程中的临时数据,而是成为了大模型系统的核心状态资产。
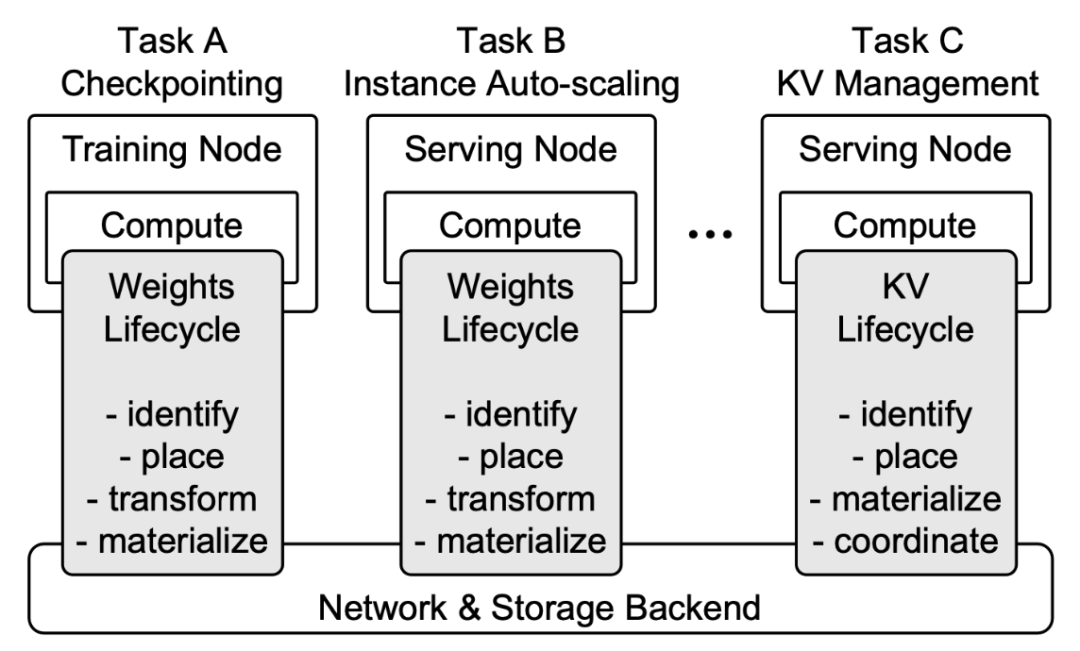
当前的基础设施架构存在一个根本性问题:不同系统都在重复解决类似的张量管理问题,却缺乏统一的基础抽象。模型加载系统专门负责权重分发,KV Cache系统专门处理KV存储和迁移,Checkpoint系统专门管理模型状态保存和恢复。虽然每个系统都在各自领域取得了显著性能提升,但它们往往深度绑定特定的推理或训练框架、网络环境和存储后端,形成了彼此隔离的纵向技术栈。
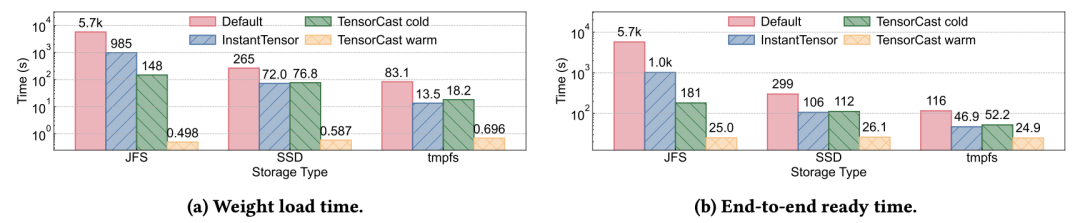
这种架构带来的第一个问题是系统开发成本的持续增加。当新的优化策略出现时,开发者往往需要同时修改调度器、缓存系统、执行引擎等多个组件。例如,一个同时考虑负载均衡和KV Cache亲和性的推理策略,需要协调请求路由、缓存迁移和实例管理逻辑,导致系统开发牵一发而动全身。第二个问题是复杂的大模型应用越来越需要跨组件协同优化,而传统的孤立系统难以表达这样的跨任务组合优化策略。
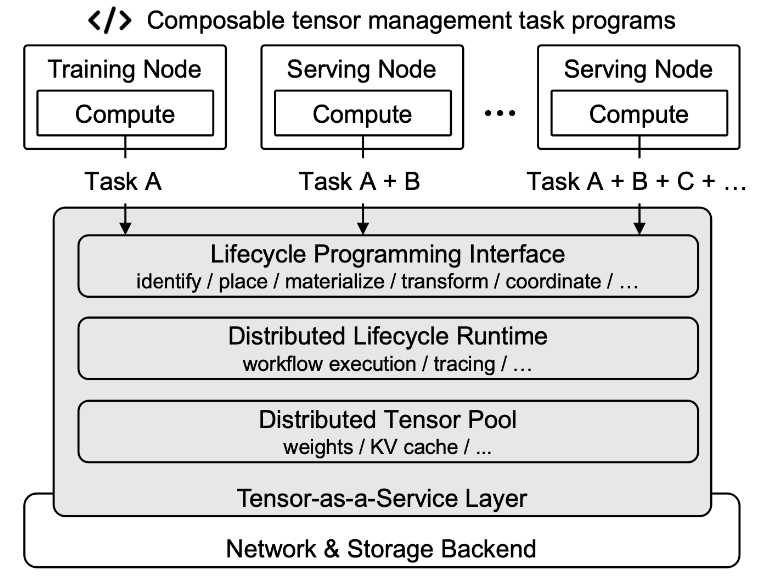
针对这一基础设施层面的根本性缺失,北京大学、阶跃星辰与北京邮电大学联合提出了TensorCast,这是一个全新的统一、可编程的张量生命周期管理抽象层。TensorCast在计算引擎、网络与存储之间引入了一个统一的张量管理抽象,将模型权重、KV Cache等张量状态从具体系统中解耦出来,使不同工作负载能够复用并组合统一的张量管理能力。
TensorCast的核心创新在于提出了Tensor-as-a-Service(TaaS)这一新的系统抽象。在这个框架下,张量生命周期管理从计算执行逻辑中解耦出来,让开发者能够像管理系统资源一样管理模型权重、KV Cache等张量状态。这种设计使得张量拥有了独立的系统身份和生命周期,开发者无需关心张量具体位于哪个节点、哪块GPU或哪种存储介质,TensorCast会负责完成后续的数据定位、移动和物化。
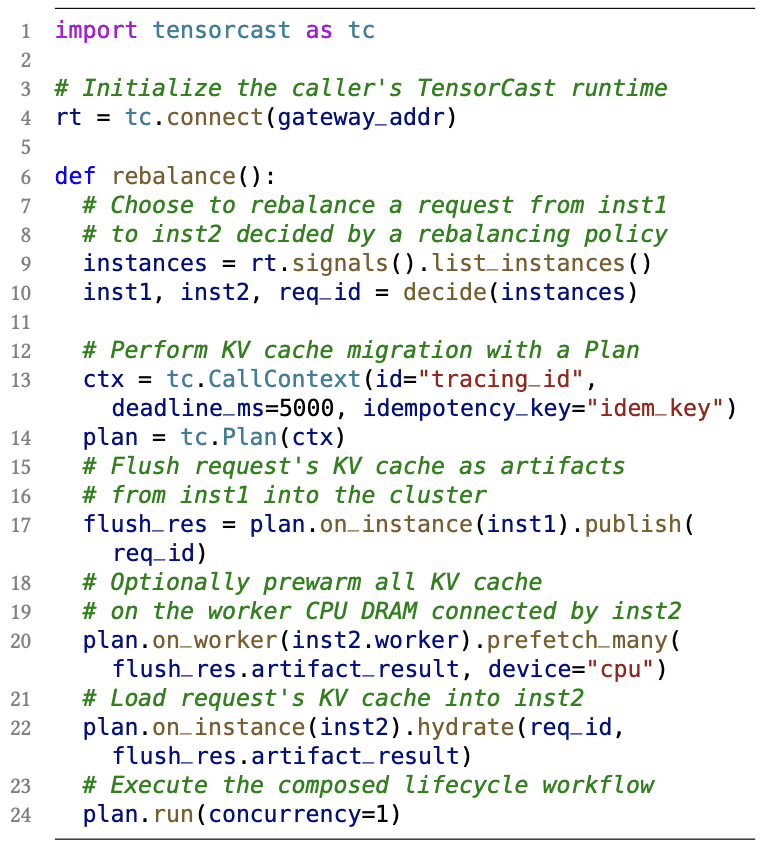
在TensorCast中,张量管理操作被抽象成可组合的生命周期原语,开发者可以通过普通程序组合这些操作,实现面向具体业务需求的优化策略。以KV Cache迁移场景为例,在多轮对话LLM服务中,用户会话可能因负载不均需要从一个推理实例连带KV Cache迁移到另一个实例。在传统系统中,这通常需要同时修改请求调度器、KV Cache后端和推理引擎内部逻辑。而在TensorCast中,这一过程可以通过一个简单的生命周期程序完成KV导出、迁移和恢复。
为了支撑大规模LLM集群中的张量管理,TensorCast设计了一套分布式运行架构,将控制逻辑与数据传输分离。在控制面,TensorCast通过Global Store(GS)维护整个集群的元信息,包括节点状态、张量位置以及任务调度所需的信息。GS负责协调集群状态,但不参与实际的数据传输,避免成为性能瓶颈。
在数据面,TensorCast部署多个Worker节点管理本地存储、内存和GPU资源,并负责执行具体的张量生命周期操作,例如张量迁移、复制、转换和加载。不同Worker之间通过RDMA、零拷贝、流水线传输等技术实现高性能P2P数据传输,使系统能够随着集群规模增长持续扩展。
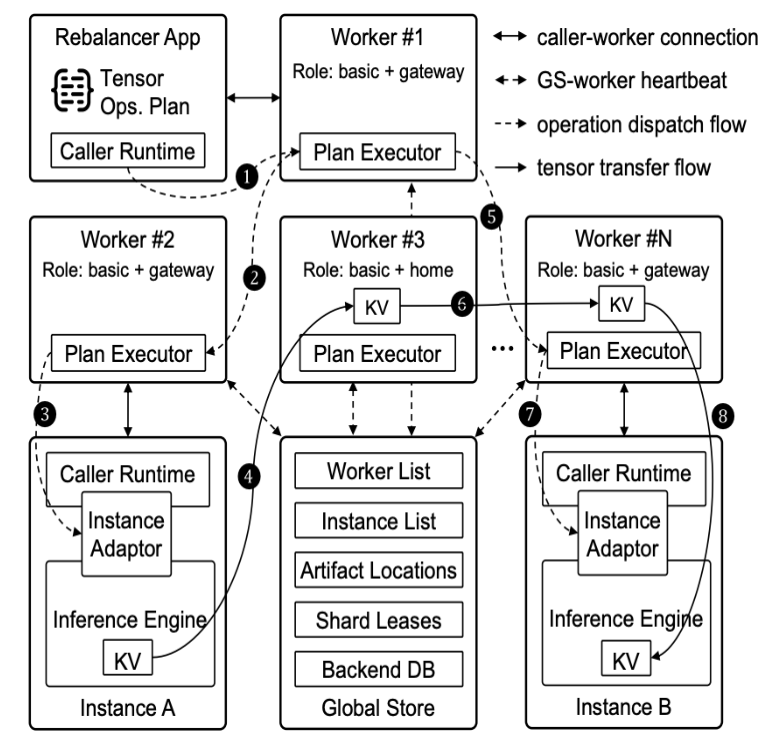
在实际部署中,TensorCast可以作为独立层接入现有的大模型推理系统。上层应用通过TensorCast API定义张量管理策略,下层Worker负责在整个集群中高效执行这些操作,从而为模型权重、KV Cache等不同类型的张量状态提供统一管理能力。这种设计既保证了与现有系统的兼容性,又提供了强大的扩展能力。
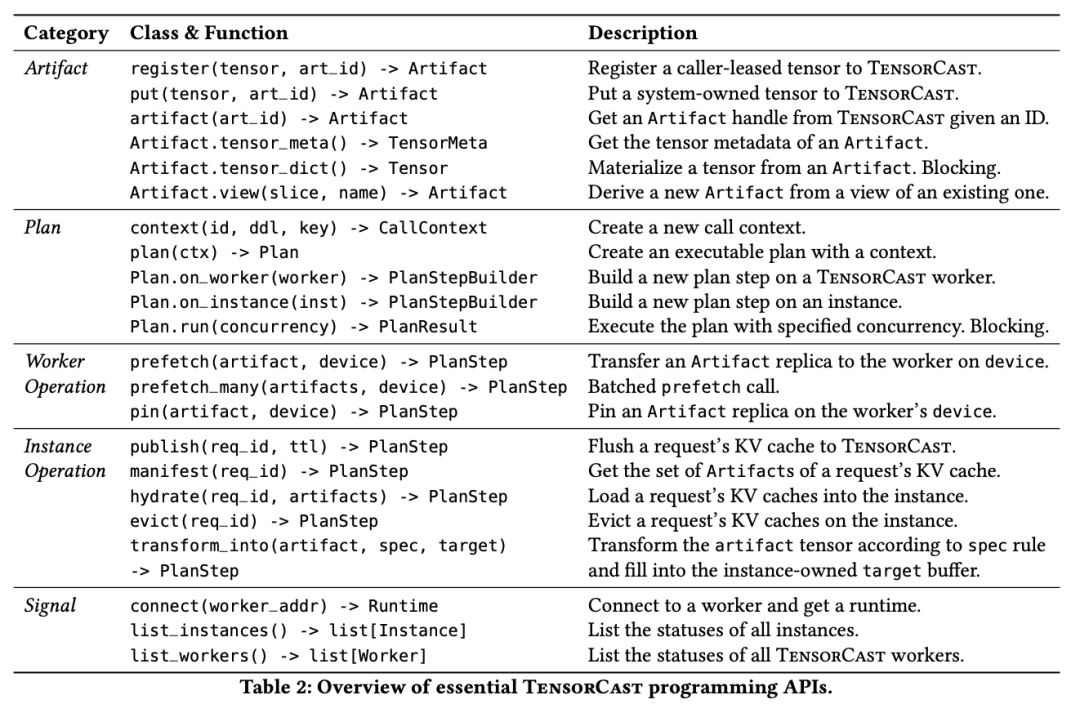
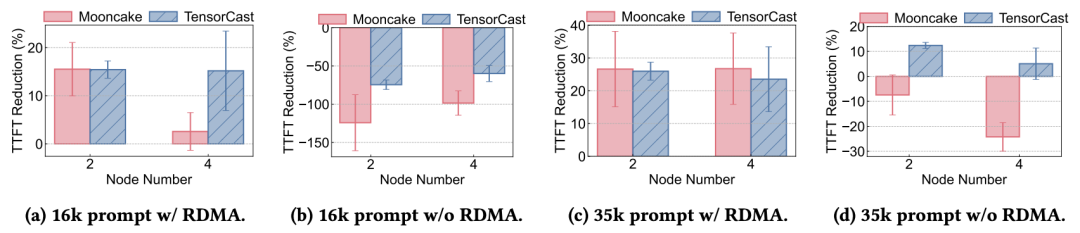
实验验证充分证明了TensorCast的有效性。在模型部署场景中,TensorCast将端到端实例启动时间最高降低了228.6倍,这对于大模型服务的弹性扩容具有重要意义。在通用张量管理方面,TensorCast达到了与专业KV Cache系统相当的性能水平,证明了其通用性和高效性。
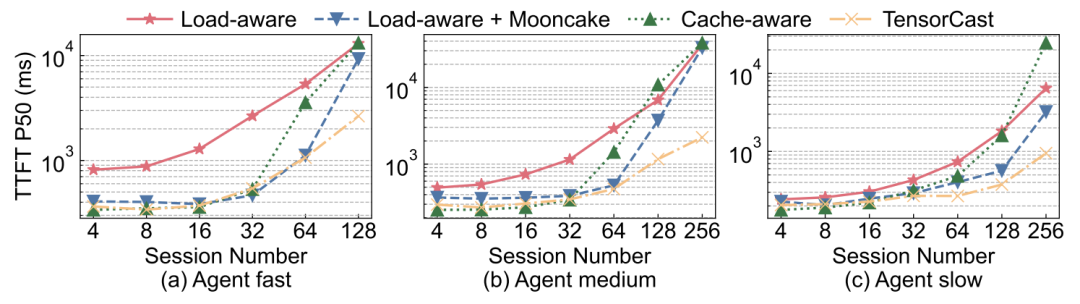
最令人印象深刻的是在多轮Agent场景的实验结果。基于TensorCast API实现的面向多轮对话Agent场景的请求调度器,结合KV Cache后端与推理引擎逻辑,实现了根据实例负载动态调整请求分布,并自动完整迁移会话状态。在高并发多轮Agent工作负载下,TensorCast将中位数TTFT最高降低了93.2%,这一结果充分验证了可编程张量管理的巨大潜力。
TensorCast的设计理念体现了对大模型基础设施演进趋势的深刻理解。随着Agent、多轮推理、持续学习等应用推动大模型系统走向更加动态化,如何管理跨节点、跨组件、跨阶段流动的张量,将成为下一代大模型基础设施的核心问题之一。TensorCast为解决这一问题提供了全新的思路和工具。
从技术架构的角度看,TensorCast的成功在于其巧妙地平衡了通用性和性能。通过统一的抽象层,它避免了重复造轮子的问题,同时通过高效的分布式实现,确保了与专用系统相当的性能水平。这种设计哲学对于整个系统软件领域都具有重要的借鉴意义。
在实际应用层面,TensorCast为大模型服务提供商带来了显著的价值。首先,它大幅降低了系统开发和维护的复杂度,开发者可以专注于业务逻辑而非底层的张量管理细节。其次,它提供了前所未有的灵活性,使得快速响应业务需求变化成为可能。最后,它为未来的创新应用提供了坚实的基础平台。
展望未来,TensorCast所代表的张量生命周期管理理念有望成为大模型基础设施的标准组成部分。随着模型规模的进一步扩大和应用场景的持续演进,统一、可编程的张量管理能力将变得越来越重要。我们可以预见,基于TensorCast这类系统,将会涌现出更多创新的大模型应用和服务模式。
此外,TensorCast的技术理念还可能扩展到其他领域。在科学计算、数据分析、机器学习等需要处理大规模张量数据的场景中,类似的统一管理抽象同样具有巨大的应用潜力。这标志着系统软件设计思想的一次重要演进,即从功能导向转向资源导向,将复杂的数据管理能力作为基础服务提供给上层应用。
总的来说,TensorCast不仅解决了当前大模型基础设施面临的紧迫问题,更为整个行业的未来发展指明了方向。它证明了通过精心设计的抽象层,可以在保持高性能的同时大幅提升系统的灵活性和可维护性。这种平衡艺术正是优秀系统软件设计的精髓所在,也为后续的研究和工程实践提供了宝贵的经验和启示。