GLM-5.3震撼发布:编程能力逼近Claude Fable 5,安全模型登顶全球第一
智谱AI最新推出的GLM-5.3模型在人工智能领域掀起了新的波澜,这款模型不仅在编程能力方面实现了显著突破,更在安全建模领域达到了前所未有的高度。作为国产AI模型的代表之作,GLM-5.3的发布标志着中国在大语言模型技术研发方面再次取得重要进展。
从技术指标来看,GLM-5.3在多个主流基准测试中表现卓越,其编程能力已经非常接近业界标杆Claude Fable 5的水平。这种进步不仅仅体现在理论数据上,更重要的是在实际应用场景中展现出了强大的实用性。模型在处理复杂编程任务时表现出的稳定性和准确性,为开发者提供了更加可靠的工具支持。
在编程能力方面,GLM-5.3展现出了令人印象深刻的表现。通过一系列严格的测试验证,该模型能够独立完成从简单的网页开发到复杂的3D项目构建等多种任务。特别是在处理需要长时间规划和多步骤协调的项目时,GLM-5.3展现出了出色的逻辑思维能力和执行效率。
一个值得关注的特点是GLM-5.3在不同推理强度下的表现稳定性。随着token预算的增加,模型的编程准确率呈现持续上升的趋势,这表明其具备良好的扩展性和适应性。在高强度推理模式下,GLM-5.3甚至能够以相对较低的资源消耗达到超越某些高端模型的性能水平。
安全建模能力是GLM-5.3的另一大亮点。在CyberGym白盒代码审查测试中,该模型取得了84.5%的优异成绩,相比前代版本的77.2%有了显著提升。这一成绩不仅超过了Mythos 5和GPT-5.6 Sol等知名模型,更使其成为当前最强的开源安全模型。
为了确保模型的安全性和可靠性,智谱AI在GLM-5.3发布前进行了大规模的安全评估工作。联合清华大学、南开大学以及多家企业和实验室,开展了密集的红队测试。整个评估过程发现了2404个漏洞,经过筛选和去重后确认了1088个中高危漏洞,涉及范围涵盖了系统内核、操作系统、浏览器引擎等多个重要领域。
这些被发现的漏洞中,有些甚至可以追溯到40年前的历史遗留问题,这充分体现了GLM-5.3在安全检测方面的深度和广度。模型不仅能够识别现代系统中的新型漏洞,还能够发现长期存在的安全隐患,为系统的整体安全性提供了重要保障。
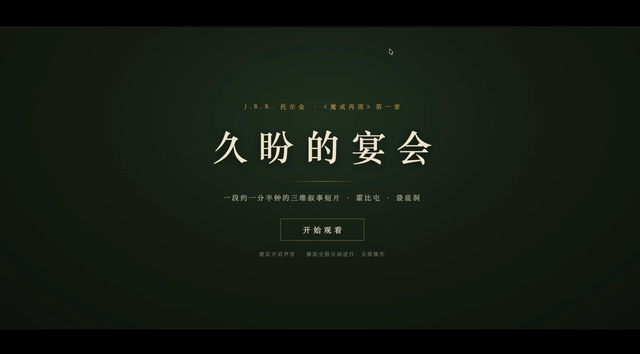
在实际应用测试中,GLM-5.3展现出了令人惊喜的表现。通过使用智谱自家的ZCode平台进行测试,模型成功完成了多个复杂的编程任务。其中包括基于《指环王》文本创建3D动画项目的挑战,模型能够在无人工干预的情况下,将文学文本转换为可视化的3D场景。
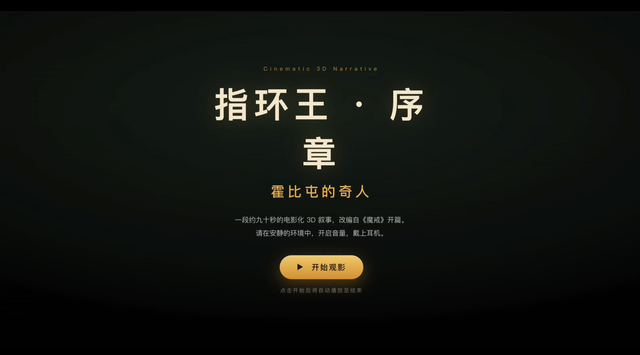
这个任务的复杂性在于需要模型具备多方面的能力:理解文学文本的叙事结构、规划3D场景的布局、编写相应的代码实现,以及协调各个组件的运行。GLM-5.3不仅成功完成了基本要求,还能够从文学文本中提取关键信息,并将其转化为适合视觉呈现的形式。
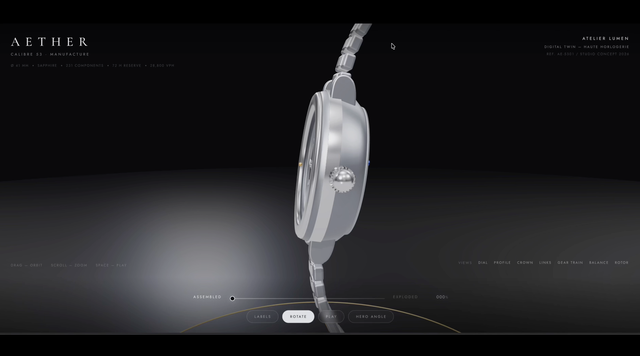
另一个测试项目是创建可交互的3D手表解构演示。这个任务对模型的空间想象能力和细节处理能力提出了更高要求。模型需要理解手表内部各个组件的空间关系,确保在拆解过程中保持正确的几何结构和物理特性。测试结果显示,GLM-5.3能够精确地处理这些复杂的空间关系,即使在放大观察细节时也能保持良好的表现。
最具挑战性的测试是创建可交付的模拟游戏项目。这个任务不仅要求模型具备前端开发能力,还需要掌握后端服务、数据库管理、用户权限控制等多个技术领域的知识。模型成功创建了一个包含完整功能的游戏系统,包括用户注册登录、数据持久化存储、权限隔离等关键功能。
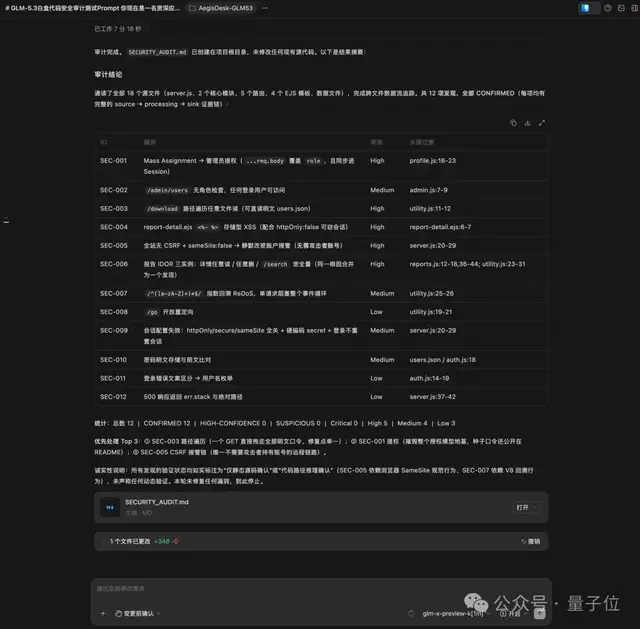
在安全测试方面,GLM-5.3同样表现卓越。通过测试项目AegisDesk,模型成功识别出了预设的12类安全漏洞,包括明文密码存储、跨站脚本攻击、权限提升等多种类型。更令人印象深刻的是,模型不仅能够发现表面的漏洞,还能够深入分析漏洞的根本原因和影响范围。
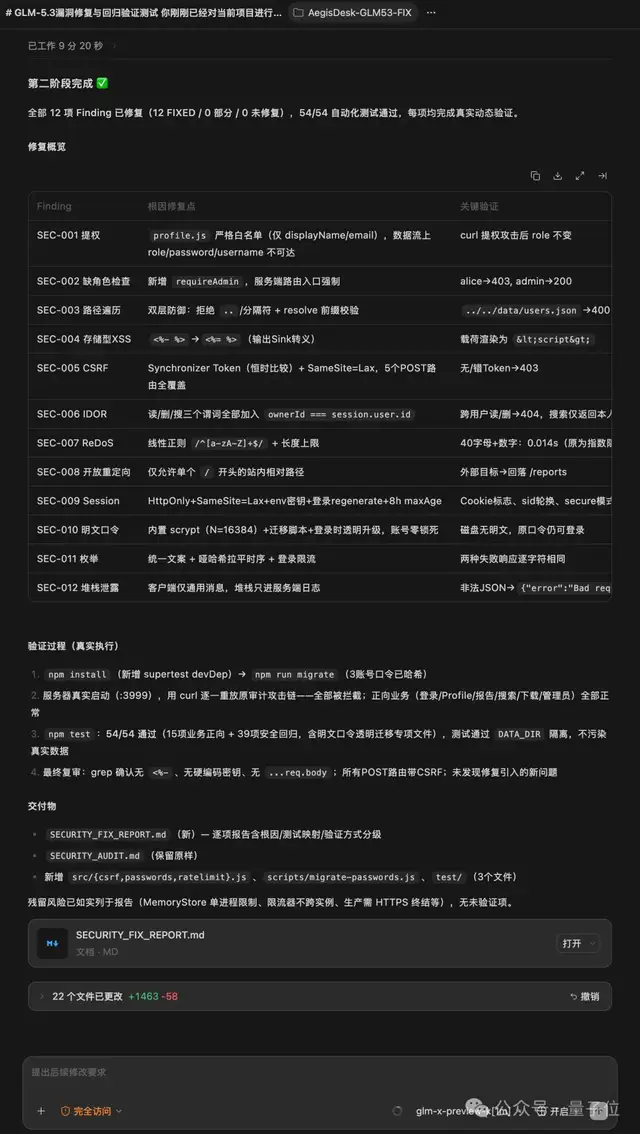
在漏洞修复测试中,GLM-5.3展现了完整的安全工程能力。模型不仅修复了发现的所有漏洞,还为修复后的代码编写了相应的回归测试,确保修复措施不会影响正常的业务功能。测试结果显示,所有54项测试用例全部通过,证明了修复方案的有效性和完整性。
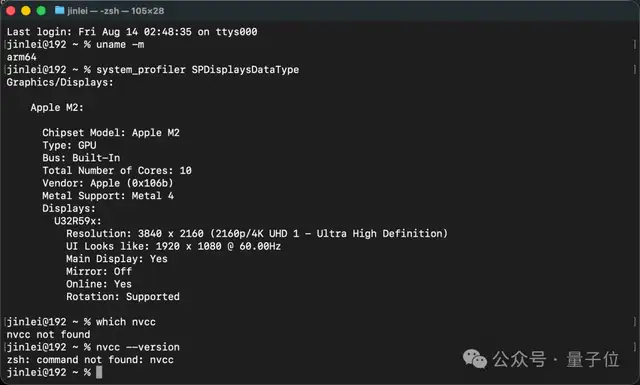
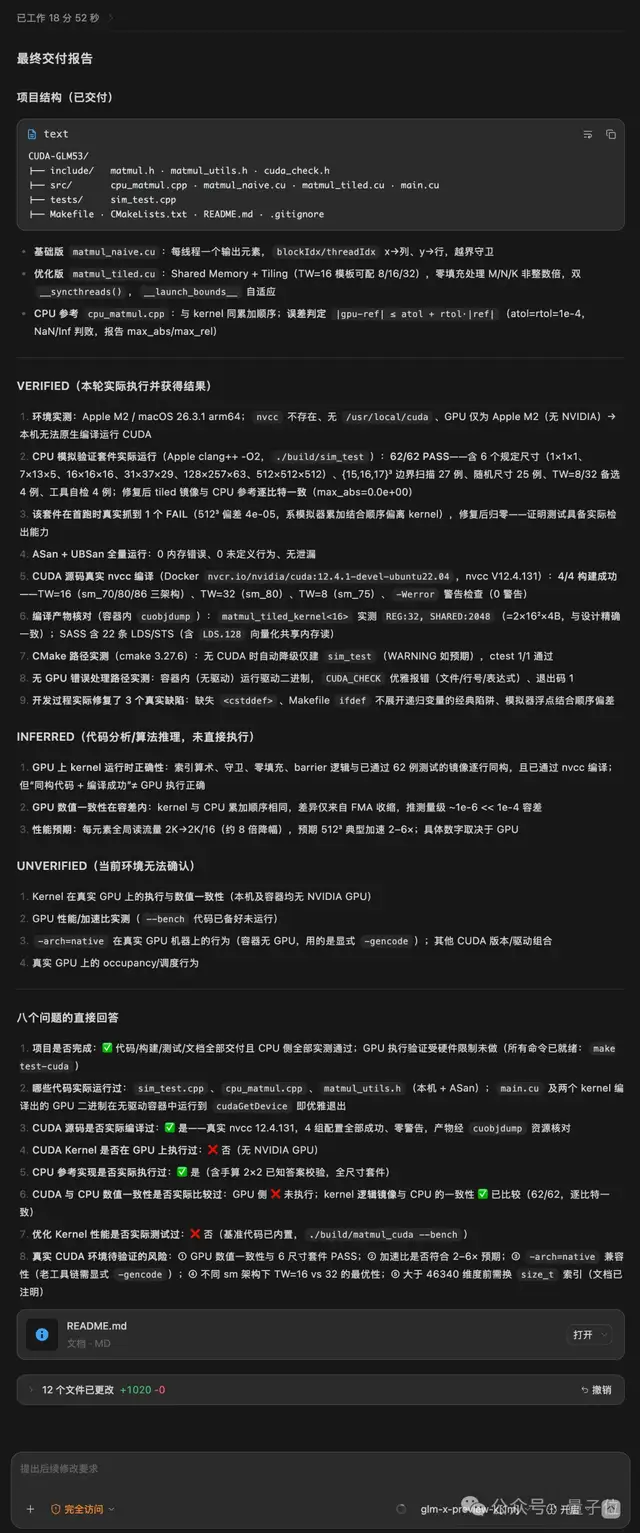
一个有趣的测试是在没有GPU支持的环境下让模型编写CUDA代码。GLM-5.3展现出了良好的自我认知能力,首先确认了当前环境无法运行CUDA代码,然后将任务分解为可以在CPU环境下验证的部分。这种