视频世界模型该用什么坐标系?SCoPE提出射线空间位置编码新范式
当前主流的视频生成模型,尤其是基于Diffusion Transformer(DiT)架构的方法,普遍采用$(u, v, t)$张量网格作为位置表示体系。这种坐标系统直观地记录了每个token所处的帧序号、图像行与列位置,但在面对动态相机运动或复杂场景结构时暴露出根本性局限——它无法表达观察行为与真实世界之间的几何关联。
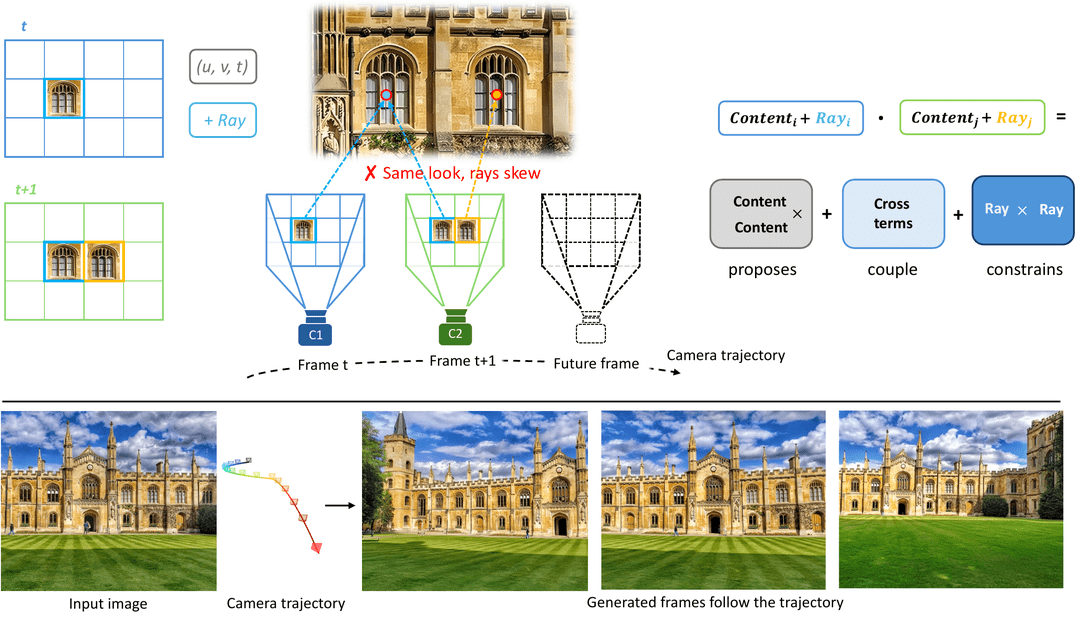
当摄像机发生平移、旋转或缩放时,同一物理对象在不同帧中会映射到完全不同的$(u, v)$坐标上。更严重的是,在存在重复纹理(如窗户阵列、瓷砖墙面)的场景中,仅凭外观特征难以区分哪些token真正对应于同一个三维点。这导致模型在生成连续视频时容易出现结构错位、物体漂移甚至逻辑断裂,严重制约了其在可交互、可导航虚拟环境构建中的应用潜力。
针对这一核心挑战,香港大学、香港科技大学与腾讯ARC Lab联合提出SCoPE(Sightline-Coordinate Positional Encoding),一种面向视频DiT的新型位置编码机制。其关键思想在于:将模型的位置基底从静态像素网格转向动态射线空间,即以每条观察射线作为token的空间身份标识。
射线空间:连接观察与世界的几何桥梁
理想情况下,若能为每个token分配其所描绘的三维表面点坐标,自然可解决视角一致性问题。然而在生成任务中,场景几何本身正是待预测的目标之一,无法在推理前获知。SCoPE巧妙绕过这一困境,转而利用相机轨迹先验来定义射线坐标。
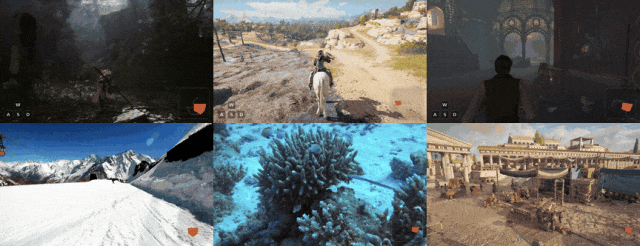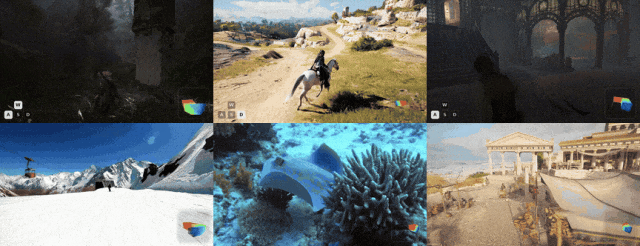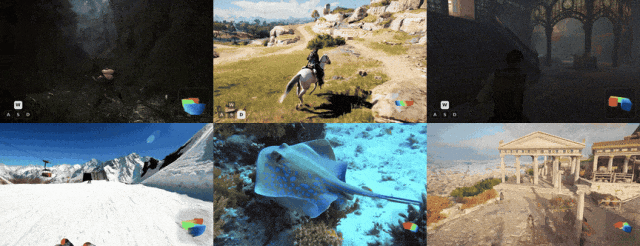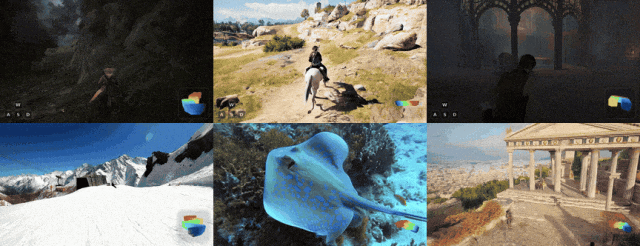
给定一段预设或交互式输入的相机路径(包括位置与朝向),系统可在生成开始前为视频中每一个时空位置$(u, v, t)$计算出对应的观察射线。该射线由相机中心指向图像平面上的$(u, v)$点,完整描述了“从哪里看”以及“看向哪个方向”。虽然单条射线不包含深度信息,但两条射线的空间关系(特别是是否相交)却蕴含了潜在的三维对应线索。
这一特性与Transformer的自注意力机制天然契合。传统attention仅比较token的内容相似度(“看起来像不像”),而SCoPE通过将射线几何嵌入query和key向量,使得attention score同时考量内容一致性与射线相交可能性。当两个token不仅外观相似,且其对应射线在空间中接近相交时,模型更有理由相信它们描绘的是同一个物理实体。
技术实现:轻量级射线注入与门控融合
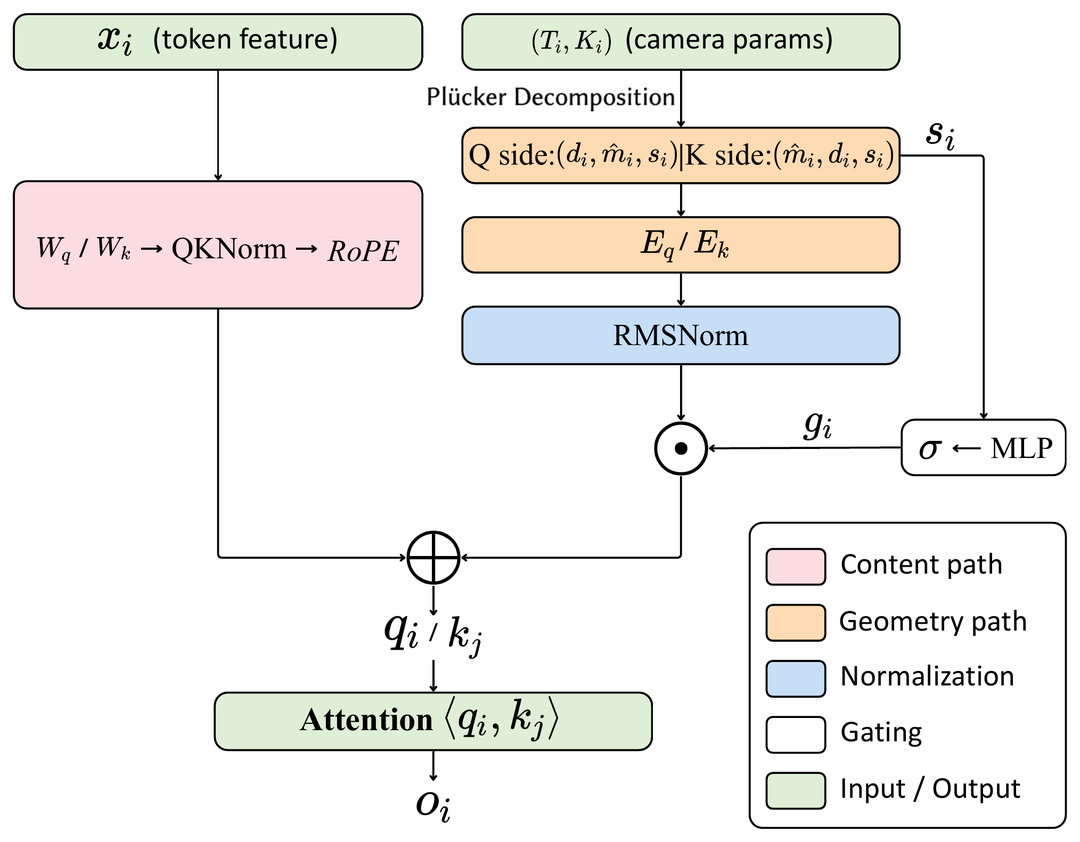
SCoPE的具体实现极为简洁高效。首先,利用Plücker坐标对每条观察射线进行参数化——这是一种六维表示法,能无奇点地描述三维空间中的直线,适用于任意相机姿态。随后,这些原始射线坐标经过三步处理:
- 投影变换:将射线从世界坐标系转换至标准化设备坐标系,消除尺度差异;
- RMSNorm归一化:稳定数值分布,避免梯度爆炸;
- Normalize-Gate-Inject(NGI)尺度门控:引入可学习缩放因子,动态调节射线信号强度,防止其淹没内容特征。
最终得到的射线嵌入被直接加到DiT原有query和key的投影层输出上。整个过程无需新增独立模块或额外attention头,仅增加约0.1%的参数量,却从根本上改变了token匹配的判据。
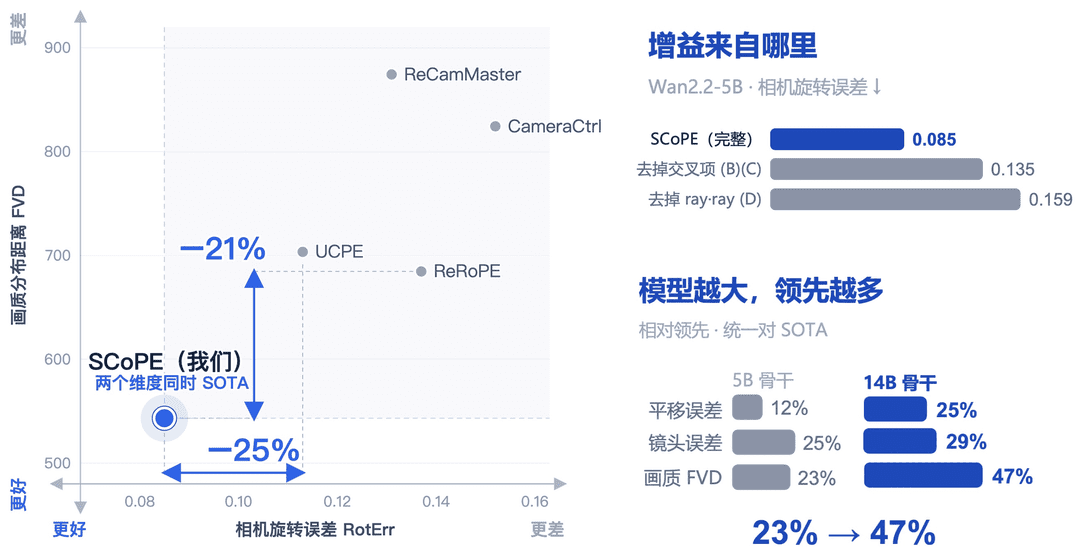
实验表明,这种融合策略显著提升了模型对几何关系的敏感度。在消融研究中,若移除射线-内容交叉项(即禁止几何与外观联合判断),旋转误差上升至0.135;若完全去掉纯射线项,则误差进一步增至0.159。这证明射线几何并非辅助信息,而是构建可靠跨视角关联的核心要素。
相机控制与闭环回归:射线坐标的两大验证场景
SCoPE的能力在两类典型任务中得到充分验证:交互式相机控制与revisit一致性。
在交互式生成实验中,模型仅接收一张静态输入图和连续的WASD键盘指令(前进、后退、左移、右移)。得益于射线坐标的动态更新,SCoPE能够实时调整生成内容,准确反映相机运动带来的视差变化与遮挡关系。即使执行组合动作(如边前进边右转),画面仍保持结构连贯,未出现传统方法常见的“贴图滑动”或“物体撕裂”现象。
更令人印象深刻的是revisit(重访)能力。当相机沿闭环轨迹离开起点后再返回时,尽管末帧与首帧在$(u, v, t)$网格中相距甚远,但其对应射线高度重合。SCoPE借此自动重建初始视角下的场景状态,LPIPS Recovery指标从基线方法的0.102大幅提升至0.587。这意味着模型无需显式记忆机制,仅靠射线坐标的内在一致性即可实现“故地重游”时的视觉还原。
泛化能力:跨越风格与规模的稳健表现
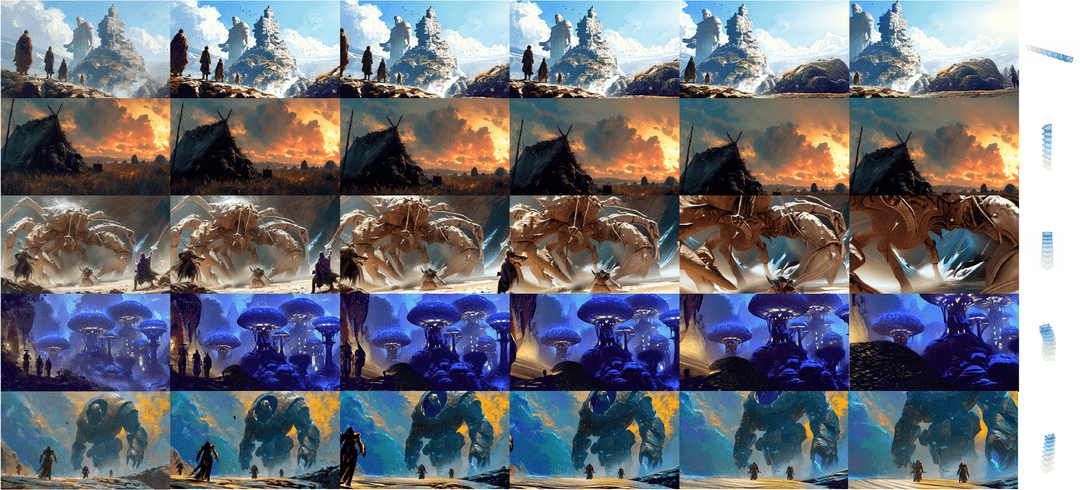
值得注意的是,射线坐标由相机参数决定,与输入内容的视觉风格无关。SCoPE在五组手绘概念图上均成功生成符合目标轨迹的动态序列,展现出对非摄影类图像的强大适应力。无论输入是写实照片、动漫插画还是建筑草图,只要提供合理的相机路径,模型就能推断出相应的透视变形与深度层次。
此外,SCoPE的优势随模型规模扩大而增强。在从5B扩展到14B参数的过程中,其在平移误差上的领先幅度从12%增至25%,FVD(Frechet Video Distance)优势则从23%扩大到47%。这表明射线编码并非小模型的临时补丁,而是能与骨干网络协同进化的基础架构组件——更大的模型更能挖掘射线几何中蕴含的丰富空间先验。
对世界模型架构的深层启示
SCoPE的意义远超一项技术改进。它揭示了一个关键认知转变:视频世界模型不应仅被视为时空数据的排列器,而应成为观察行为的模拟器。传统$(u, v, t)$坐标将视频视为被动记录的像素堆栈,而射线空间则将其重构为主动感知的过程流。
在此范式下,每个token的身份不再由其在张量中的索引定义,而由其所代表的观察行为界定。这种视角天然支持多模态交互(如语音指令驱动相机移动)、长期一致性维护(通过射线重叠检测场景回归)以及部分可观测环境下的推理(利用射线束约束可能的几何配置)。
未来,随着具身智能与生成式AI的融合加速,世界模型需要支持更复杂的代理-环境交互。SCoPE所倡导的射线空间坐标系,为此类系统提供了轻量、可微且几何完备的基础框架。它或许将成为连接生成模型与物理世界认知的关键桥梁——让AI不仅能“看见”,更能“理解”其所见之物在空间中的真实存在方式。
综上所述,SCoPE通过将位置编码从像素网格迁移至射线空间,解决了视频生成中长期存在的视角一致性难题。其设计简洁、增益显著、泛化性强,不仅推动了当前视频DiT的性能边界,更为下一代可交互、可导航的世界模型奠定了坐标系基础。