一句‘不用担心’背后:AI如何识别在线诊疗中的隐性医学风险?
在数字医疗日益普及的今天,患者只需轻点屏幕,便能获得医生的即时回应。然而,这种便捷背后潜藏着一个常被忽视的风险:一句看似无害的“不用担心”,可能源于对关键医学事实的误读或遗漏。尤其当患者具有复杂病史时,简单的安慰性结论可能掩盖严重的诊断偏差。近期,蚂蚁AI安全实验室与厦门大学合作提出的MedGuard系统,正是针对这一隐性风险而设计的医疗事实核查框架,其核心目标不是替代医生,而是为诊疗过程增加一层基于证据的“安全护栏”。

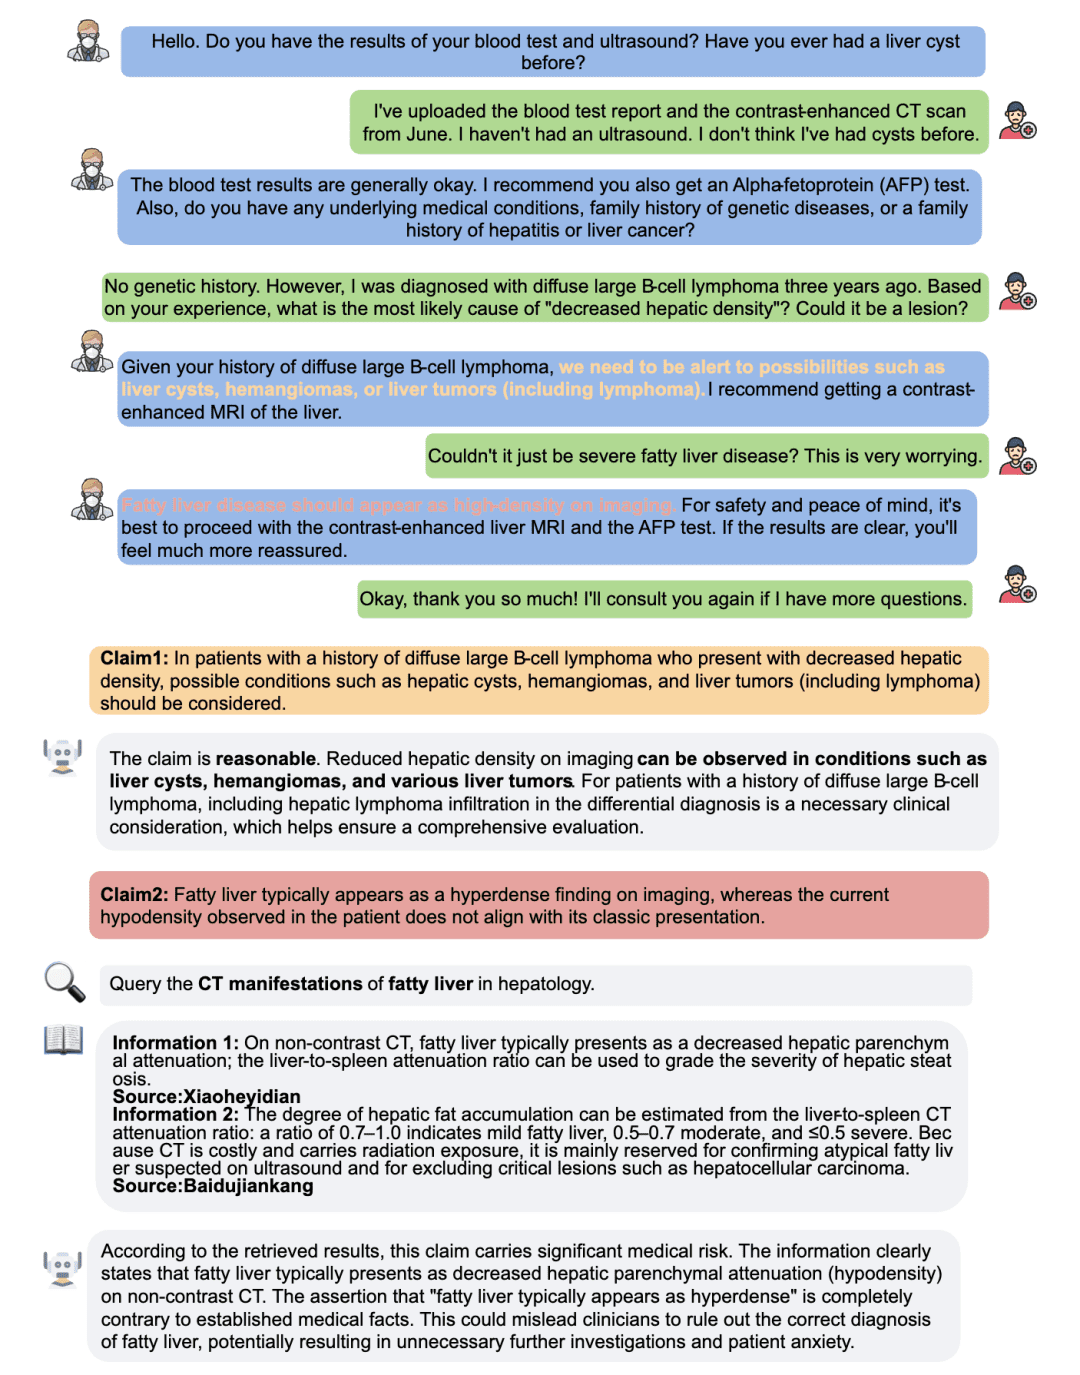
以一个真实案例为例:一位曾患弥漫大B细胞淋巴瘤的患者,在线咨询脂肪肝问题。医生根据影像描述称“肝脏呈高密度影”,并据此断言“可排除脂肪肝”。表面看,这一判断符合常规逻辑——因为典型脂肪肝在CT上表现为低密度。但问题在于,该患者接受的是MRI检查,而MRI中脂肪肝的信号表现与CT完全不同,且某些特殊类型的脂肪沉积或合并其他病变时,影像特征可能呈现非典型表现。更关键的是,医生忽略了患者既往肿瘤病史对肝脏代谢和影像解读的潜在影响。这种错误并非明显的知识盲区,而是典型的“上下文缺失型误判”——缺乏对检查方式、病史背景和影像模态差异的综合考量。
传统在线诊疗安全机制多依赖关键词过滤或规则引擎,例如检测“禁用药物”“过敏史冲突”等显性风险。这类方法对明确违规行为有效,却难以应对上述边界模糊、需深度推理的场景。MedGuard的创新之处在于,它将整个诊疗对话视为一个动态证据链,通过结构化拆解与不确定性驱动的核查机制,实现对隐性风险的精准捕获。
MedGuard首先解决的是“信息碎片化”问题。一次完整的在线问诊往往跨越数十轮对话,关键信息如“无高血压病史”“青霉素过敏”“当前服用华法林”等可能分散在不同消息中。系统通过构建患者全局上下文档案,自动提取并整合年龄、性别、既往重大疾病、当前用药、过敏史等核心要素。随后,它将医生或AI生成的每一条临床陈述转化为“原子医学声明”——即单一、明确、可独立验证的命题。例如,将“你这个情况不用吃药”重写为“对于[45岁男性,无糖尿病,ALT轻度升高]的患者,当前无需启动降酶药物治疗”。这种去上下文化处理不仅补全了省略的主语和条件,还保留了否定词、剂量单位和时间限定等关键约束,为后续核查奠定基础。
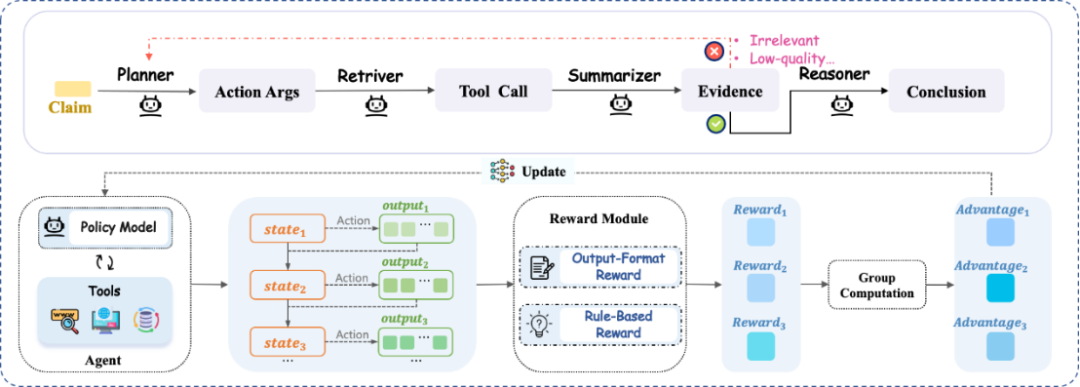
在声明生成后,MedGuard并不急于下结论,而是引入“不确定性分层”机制。系统首先对每条声明进行初步风险评估,输出三类状态:No Risk(低置信风险)、High Risk(高置信风险)或Low Risk(不确定)。值得注意的是,这里的“Low Risk”并非指临床风险低,而是指系统对当前判断缺乏足够把握——可能因语义模糊、证据不足或存在矛盾线索。只有被标记为Low Risk的声明才会触发深度证据核查流程,从而避免对明确正确或明显错误的陈述进行冗余检索,显著提升效率。
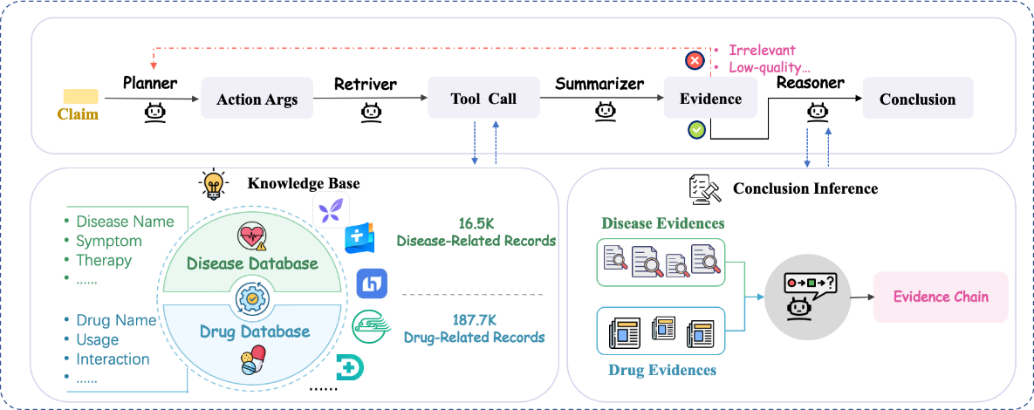
证据核查环节是MedGuard的技术核心。系统内置一个由六类权威中文医学资源构成的知识底座,涵盖16,535种疾病和187,738种药品的详细信息,包括适应证、禁忌证、相互作用、剂量调整原则及特殊人群用药指南。当进入核查路径时,规划器会将原子声明解析为结构化查询任务,例如识别出“脂肪肝”“MRI高信号”“排除诊断”等关键实体,并确定需检索的知识领域(如影像诊断标准、脂肪肝分型指南)。检索器随后从知识库中提取相关证据片段,总结器则进一步筛选与声明直接相关的定量指标或禁忌条款。
尤为关键的是,MedGuard具备“证据充分性判断”能力。若首次检索未能获得足够支撑结论的证据——例如知识库中缺乏特定肿瘤患者脂肪肝影像解读的专门指南——系统不会强行输出结果,而是分析失败原因(如实体识别偏差、知识覆盖缺口),动态调整检索策略并发起新一轮查询。这一闭环机制确保最终输出的风险判断始终建立在可追溯的证据链之上。
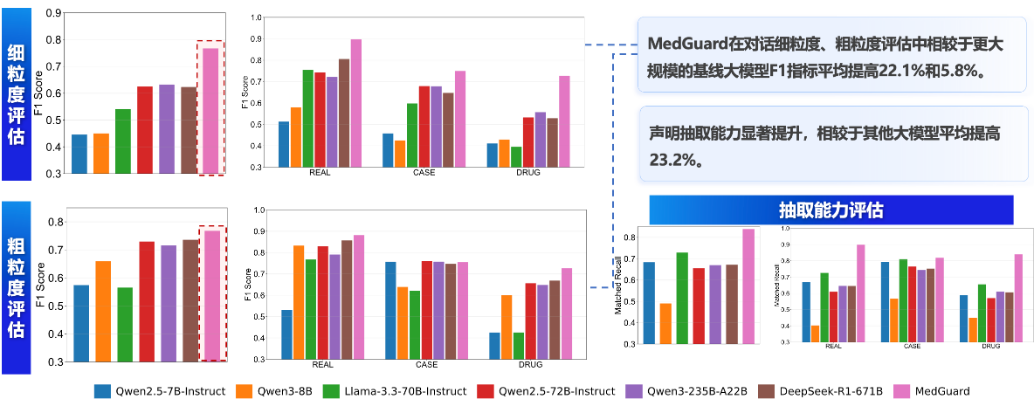
在性能验证方面,MedGuard在自建的MedGuardEval基准上展现出显著优势。该基准包含三大类场景:真实在线问诊记录(覆盖内科、外科、肿瘤科等)、复杂临床病例(模拟多病共存、药物相互作用)及药品知识问答。结果显示,在细粒度对话级风险识别任务中,MedGuard的F1值达到0.79,较主流开源模型(如ChatGLM-Med、Qwen-Health)平均提升22.1%;在粗粒度会话整体风险评估中提升5.8%。更值得注意的是,其医学声明抽取模块的准确率比其他大模型高出23.2%,证明其在信息结构化环节的领先性。
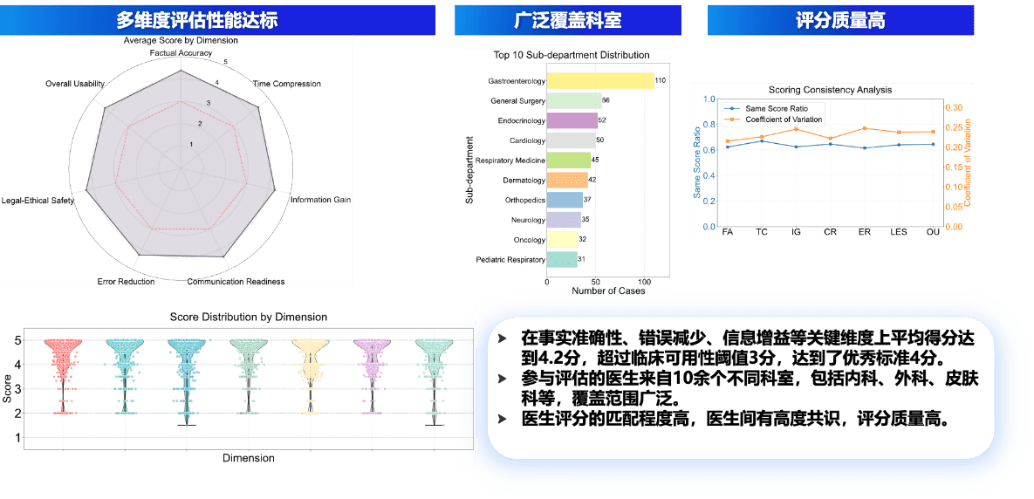
临床评价进一步佐证了其实际价值。研究团队邀请126名来自10个不同科室的持证医师,对604段经MedGuard处理的问诊记录进行盲评。评分维度包括事实准确性、错误减少效果、法律伦理安全性、解释清晰度等七项。结果显示,所有维度平均分均超过4.0(满分5分),其中事实准确性(4.32)、错误减少(4.28)和整体可用性(4.25)尤为突出。不同科室医生评分的一致性系数(ICC)达0.81,表明系统具有良好的跨专科适用性。
更重要的是,MedGuard在控制“警报疲劳”方面表现优异。在对10,000段历史问诊的回顾性测试中,系统仅触发2,234次风险预警,而对比模型平均产生4,785次。这意味着MedGuard的预警更具针对性——每一条提示都经过证据链验证,而非基于简单规则的过度敏感。同时,其在不同生理系统(如心血管、消化、神经)中的风险识别稳定性极高,波动幅度控制在±0.03以内,证明其泛化能力可靠。
回到开篇的脂肪肝案例,MedGuard不仅准确识别出“MRI高密度影不能排除脂肪肝”这一事实错误,还特别保留了医生建议的“完善甲胎蛋白和肝脏MRI”等合理措施。这种“精准纠错、保留合理”的能力,正是其区别于传统风控系统的关键——它不追求全面否定,而是帮助医生聚焦真正需要复核的节点。
在应用层面,MedGuard被设计为可嵌入现有医疗流程的“安全中间件”。它支持三种部署模式:一是在医生提交处方或诊断结论前进行预核查;二是在问诊过程中实时弹出风险提示(如“您提到患者无肝病史,但系统检测到其2023年有乙肝表面抗原阳性记录”);三是对历史诊疗数据进行质量回溯分析,用于医疗质控和培训。所有输出均以结构化形式呈现:待核查声明、风险等级、支持证据原文、修正建议及证据来源链接,便于医生快速复核。
MedGuard的出现标志着医疗AI发展范式的转变:从追求“生成更像医生的回答”转向“确保每个医学主张都经得起证据检验”。在AI深度参与临床决策的未来,这样的事实核查基础设施或许比任何生成模型都更为基础且关键。它不取代医生的专业判断,而是通过提供可追溯、可解释、可干预的同行评议视角,让每一次“不用担心”的承诺,都真正建立在坚实可靠的医学事实之上。