国产多模态大模型GLM-5.3 Flash深度解析:320B参数如何实现性能与成本的双重突破?
近期,一个代号为「牛来」(Ox Alpha)的神秘大模型在全球开发者社区掀起热潮。它在OpenRouter和OpenCode等平台迅速登顶,创下单日Token调用量新高,甚至终结了DeepSeek长达56天的榜首纪录。然而,最令人意外的并非其强大性能,而是其真实身份——这款被海外开发者疯狂追捧的模型,竟是由中国公司智谱AI自主研发并开源的GLM-5.3 Flash。更关键的是,所有推理计算均运行于国产加速芯片之上,实现了从模型到算力的全栈国产化。

这一事件不仅标志着中国大模型技术迈入新阶段,更揭示了一个重要趋势:前沿AI能力正从“奢侈品”向“日常消耗品”转变。而GLM-5.3 Flash正是这一转变的关键推手。
多模态能力:从“看得见”到“看得懂”
GLM-5.3 Flash是GLM-5系列中首个原生多模态模型,这意味着其视觉与语言能力并非通过后期对齐或插件拼接,而是从训练之初就深度融合。这种架构优势在复杂多模态任务中表现尤为突出。
在一项实测中,研究人员向模型输入一段多人对话视频,要求其识别不同说话人,并生成具备卡拉OK效果的动态字幕。任务要求极高:需固定人物底色、平滑高亮当前词、排除背景音干扰、重新对齐时间轴,且字幕必须位于画面安全区。GLM-5.3 Flash不仅准确区分了主讲人、主持人与插话者,还通过捕捉画面中仅出现一次的“名签”细节,精准建立了声音与人物的对应关系。这种细粒度的跨模态对齐能力,远超传统多模态模型的简单图像-文本匹配。
更进一步,当面对整部电影《神话》时,模型能自动梳理主线剧情、提取关键冲突、剪辑连贯片段,并生成配音与字幕。整个过程无需人工干预,最终成片逻辑清晰、节奏合理,展现出对长视频内容的深度理解与结构化输出能力。这表明GLM-5.3 Flash已具备处理长时序、高复杂度多模态内容的潜力,为影视解说、教育视频生成、会议纪要自动化等场景提供了新可能。
代码生成:从设计图到可交互应用的端到端实现
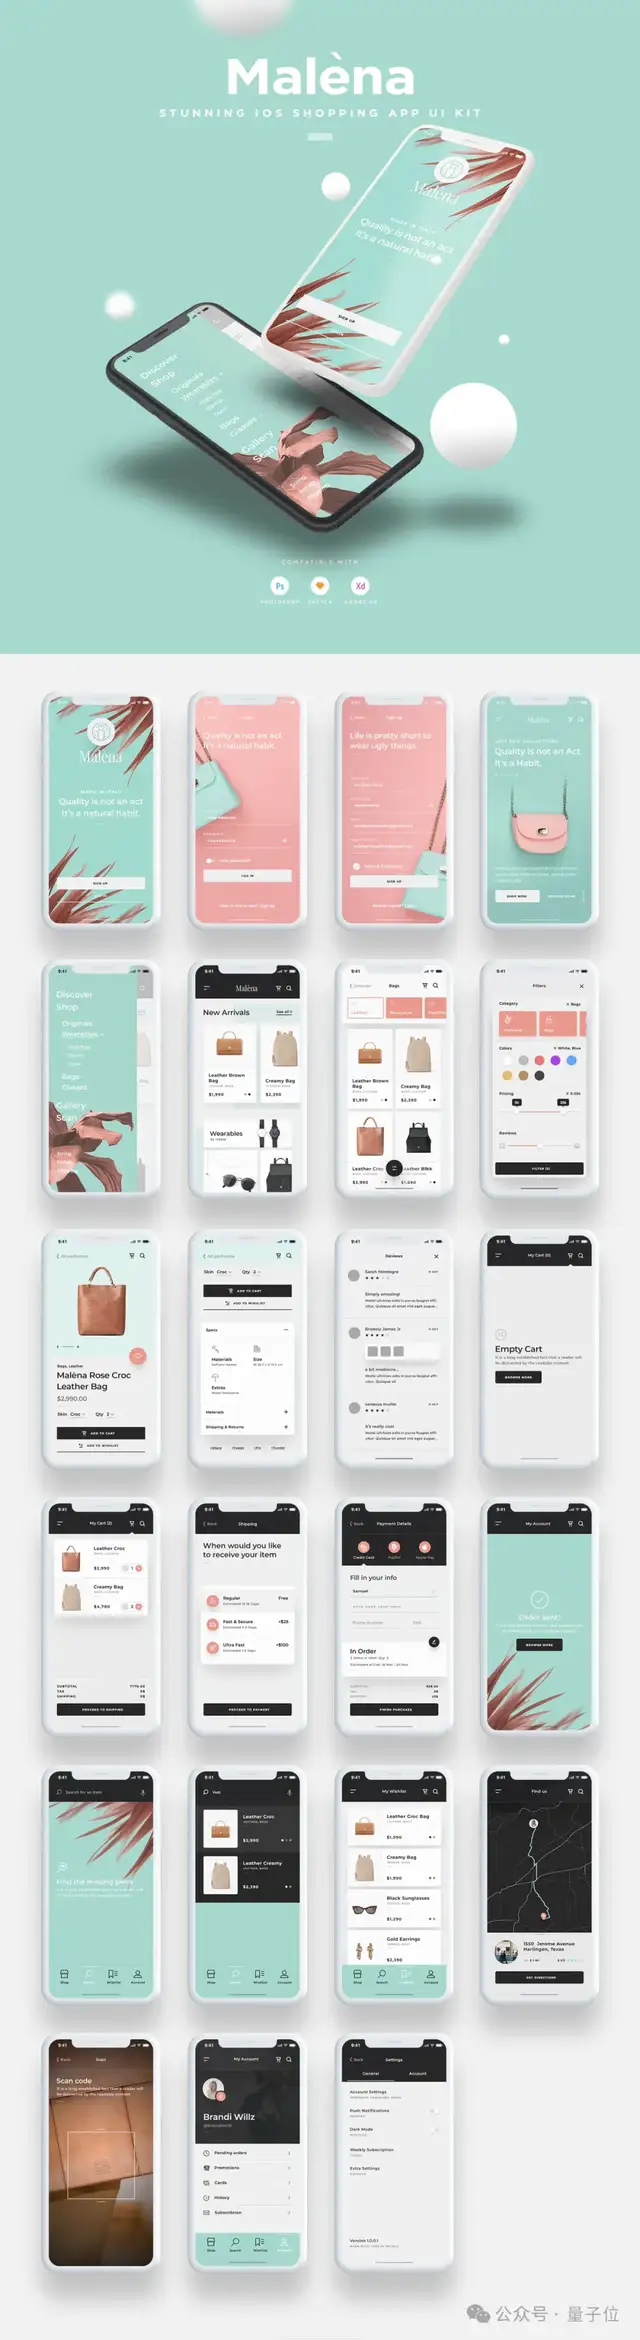
除了多模态理解,GLM-5.3 Flash在视觉编程(Visual Coding)领域同样表现出色。在一项测试中,研究人员仅提供一张移动端购物App的设计稿,要求模型还原配色、布局,并实现首页、商品详情、购物车、支付等完整购物流程的交互功能。
结果令人惊讶:模型不仅准确复现了UI元素,还生成了可实际操作的前端代码。用户可在模拟环境中完成从浏览商品到下单支付的全流程,交互流畅,逻辑严谨。这种能力源于智谱专门构建的视觉反馈训练机制——模型在生成代码的同时,能“看到”最终界面效果,并根据视觉反馈进行迭代修正,形成“写-看-改”的闭环。
更复杂的案例来自3D建模领域。在一项耗时12小时的任务中,GLM-5.3 Flash独立完成了Blender场景的构建,包括材质、光照、相机路径等细节。这表明模型不仅能理解2D设计,还能将其转化为3D空间逻辑,为游戏开发、虚拟现实等内容创作开辟了新路径。
架构革新:小参数量如何实现大能力?
GLM-5.3 Flash的参数量仅为320B,远低于前代GLM-5.2的753B,却在多项指标上实现反超。这一“瘦身增效”的奇迹,源于其底层架构的深度重构。
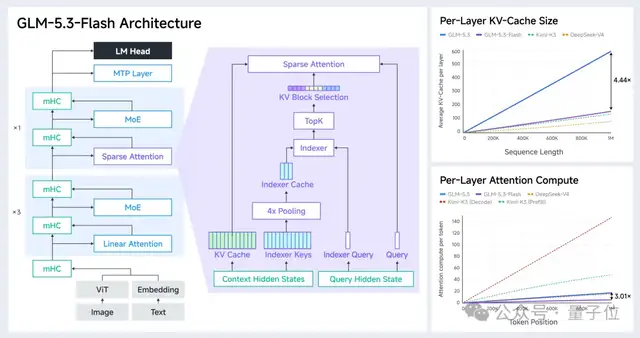
首先,模型采用了线性注意力与稀疏注意力的混合架构。线性注意力高效处理局部上下文,而稀疏注意力则通过轻量级索引器(Indexer)动态检索全局关键信息。面对1M长度的上下文,传统Transformer需进行O(n²)的全连接计算,而GLM-5.3 Flash通过这种混合机制,将注意力计算量降低3.01倍,KV Cache占用减少4.44倍。
其次,智谱引入了IndexPool技术,将索引器的4个缓存向量压缩为1个,在几乎不损失精度的前提下大幅节省显存。同时,模型层数从92层精简至45层,激活参数仅18B,显著提升了推理效率。
更重要的是,为适配国产芯片,智谱设计了Encode-Prefill-Decode分离式架构。该架构将多模态编码、Prompt预填充和逐Token解码拆分为独立模块,支持灵活调度与扩缩容。配合Layer Split(层间切分)和混合缓存量化等优化,端到端服务性能提升3倍,单Token成本降至与主流英伟达GPU相当水平。
国产算力与开源生态:构建自主AI基础设施
GLM-5.3 Flash的另一重大意义在于其全栈国产化。所有线上请求均由国产加速芯片处理,62T Tokens的训练与推理数据流完全运行于中国自研硬件之上。这不仅打破了高端AI算力对国外GPU的依赖,也为国产芯片提供了真实场景的验证平台。
与此同时,智谱选择全面开源GLM-5.3 Flash的权重,并开放API与ZCode平台接入。开发者可自由下载模型,在本地或私有云部署,企业也能基于此构建定制化AI应用。这种“开源+国产算力”的组合,正在形成一个良性循环:开源吸引开发者,开发者推动生态繁荣,生态反哺国产芯片与框架的优化。
在定价策略上,GLM-5.3 Flash更是激进——其价格仅为GLM-5.3的1/10,Claude Opus 4.8的1/40。在AA榜单得分持平的情况下,这种成本优势使得复杂AI任务(如长时间Agent运行、高并发多模态处理)变得经济可行。前沿大模型不再是少数巨头的专利,而是中小企业和独立开发者也能负担的工具。
未来展望:从“能干活”到“会思考”
GLM-5.3 Flash的成功,不仅是一次技术突破,更是一种范式转变。它证明了通过架构创新与软硬协同,中国AI完全有能力在保持成本优势的同时,达到全球领先水平。
未来,随着更多开发者基于该模型构建应用,其在医疗影像分析、工业质检、智能教育等垂直领域的潜力将进一步释放。而“牛来”这个名字,也恰如其分地概括了这一代国产大模型的特质:能干活,吃得少,且根植于自己的土壤。
当全球还在争论AI霸权归属时,中国团队已悄然走出一条兼顾性能、成本与自主可控的道路。GLM-5.3 Flash或许只是开始,但它的出现,无疑为国产大模型的未来注入了强大信心。