TransVLM:基于视觉语言模型的全类型镜头转场检测新范式
在电影或短视频中,从一个场景平滑过渡到另一个场景的溶解效果看似自然流畅,但对人工智能系统而言,准确识别这类转场却是一项长期挑战。传统方法主要聚焦于“镜头边界检测”(Shot Boundary Detection, SBD),即定位两个镜头之间的单一切换帧。这种方法在处理硬切(hard cut)时表现尚可,但对于持续数帧甚至上百帧的渐进式转场——如溶解(dissolve)、淡入淡出(fade)、划像(wipe)或复杂特效——则几乎失效。其根本原因在于:将一段连续的时间过程压缩为一个时间点,本质上丢失了关键的时序结构信息。
为解决这一问题,研究者提出了全新的任务定义——镜头转场检测(Shot Transition Detection, STD)。不同于SBD输出离散的帧索引,STD要求模型输出完整的时间区间(start, end),精确标定转场的起始与结束时刻。这种表示方式天然统一了硬切(start ≈ end)与渐进转场(start < end),并能与现代视觉语言模型(Vision-Language Model, VLM)的结构化输出能力无缝对接——模型可直接返回包含多个时间段的JSON数组。
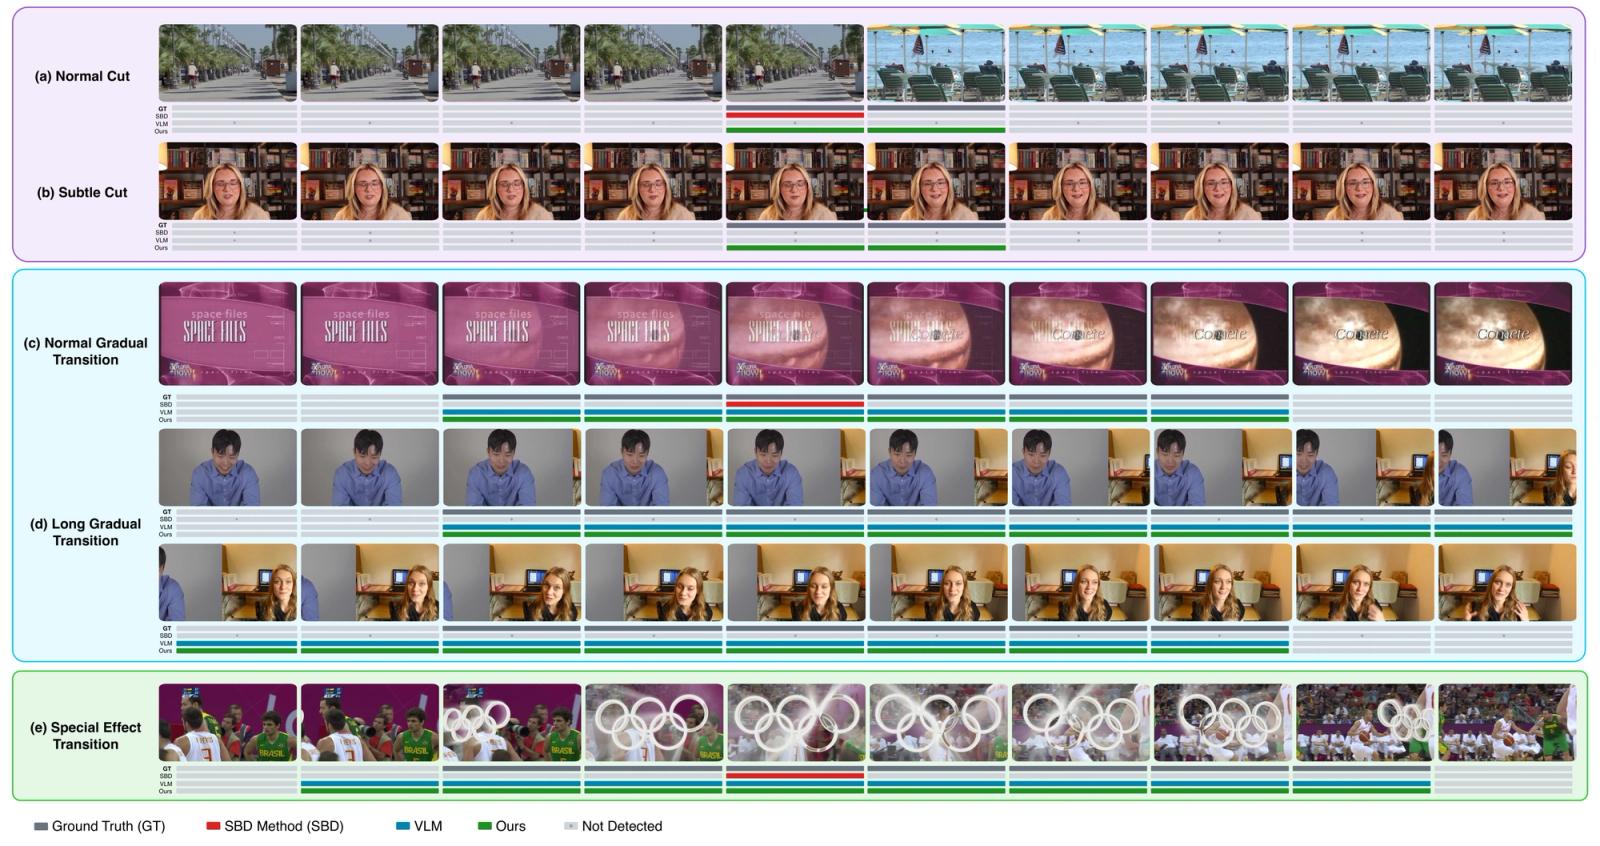
当前主流方法存在明显短板。一方面,传统SBD工具如PySceneDetect、TransNet和AutoShot虽在硬切检测上精度较高,但在面对渐进转场时,其基于帧间差异的阈值机制极易产生误报或漏检;另一方面,通用VLM(如Qwen3-VL、Gemini)虽具备更强的语义理解能力,能识别部分复杂转场,却因输入帧率过低或缺乏细粒度运动建模,常常完全忽略瞬时硬切。两者均无法同时兼顾精度与覆盖广度。
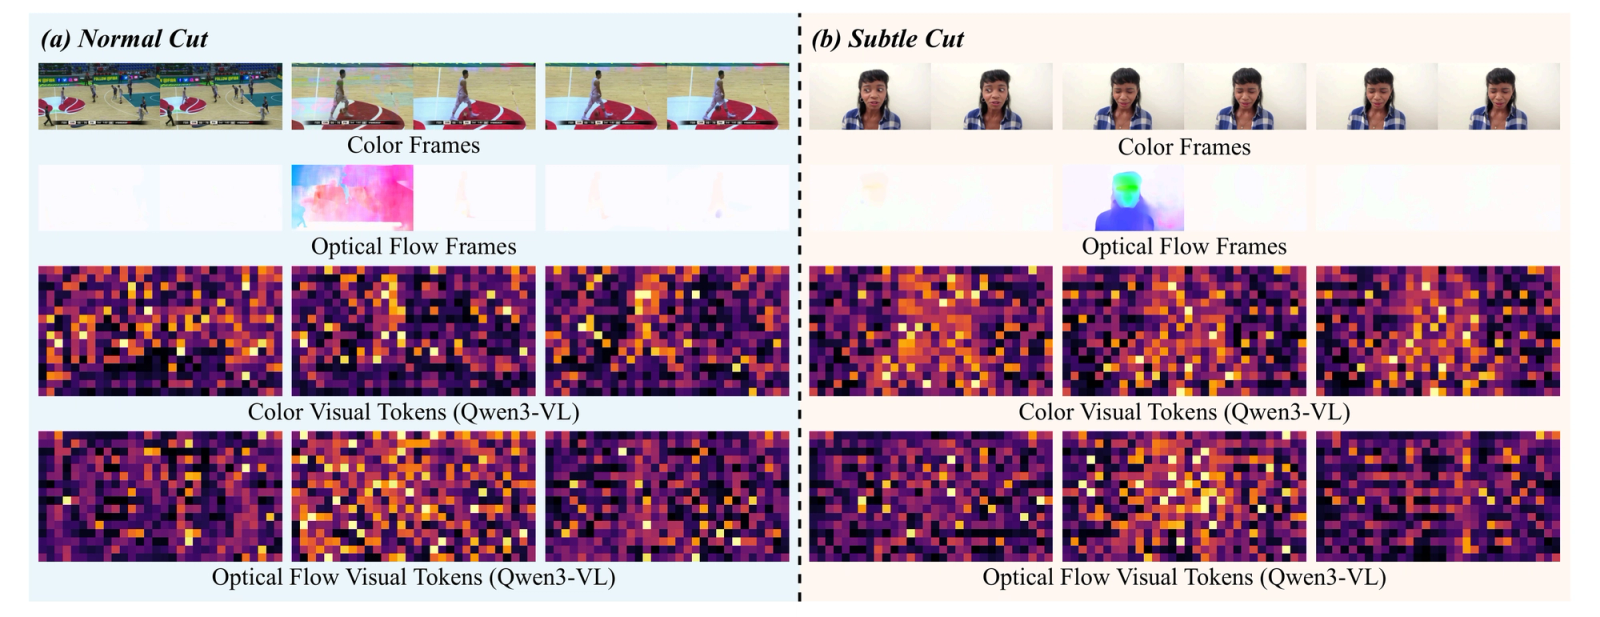
TransVLM的核心突破在于引入光学流(optical flow)作为运动先验。视觉语言模型本质上偏向静态空间语义,对帧间细微的像素变化不敏感。然而,镜头转场的本质正是运动模式的突变:硬切表现为像素值的剧烈跳变,溶解则体现为像素的线性混合。光学流恰好能捕捉这种跨帧的位移与变化信息。实验表明,在Qwen3-VL内部生成的视觉token中,基于光学流的表示在转场边界处展现出远高于彩色帧的对比度,尤其对“微妙硬切”(subtle cut)具有显著区分能力。
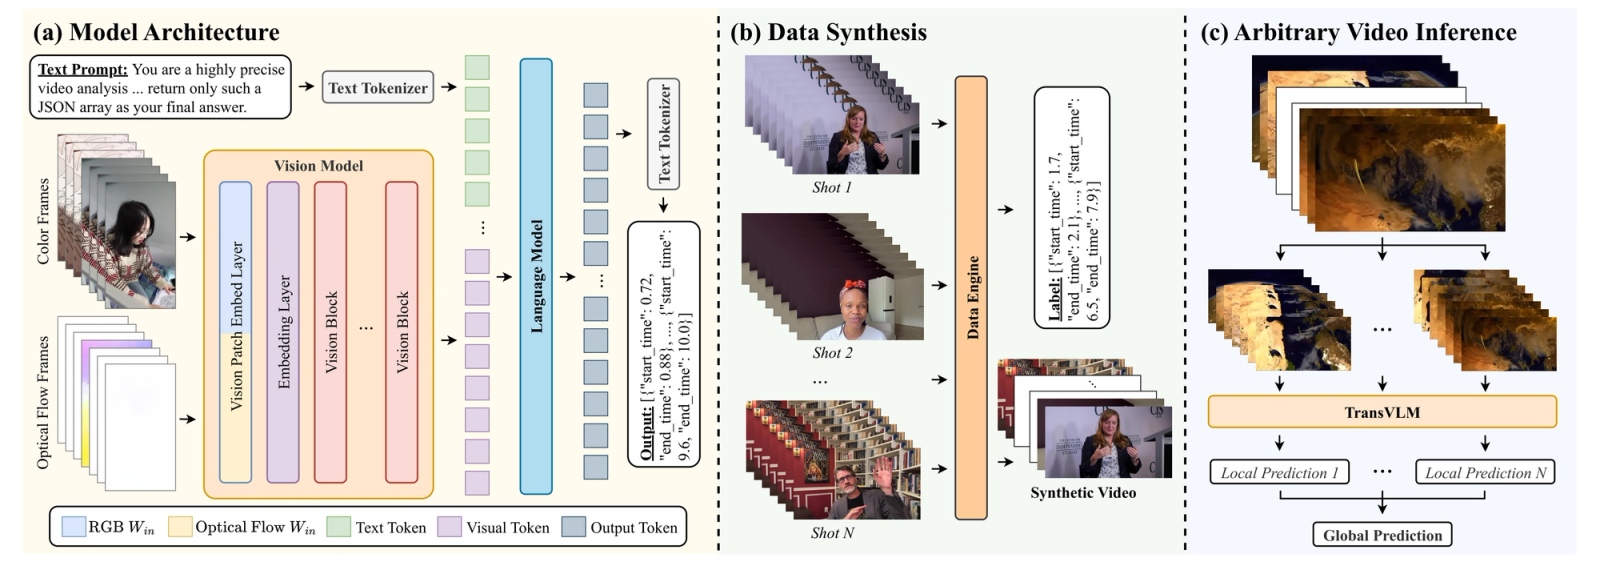
为高效融合两类信息,TransVLM采用通道拼接+特征融合策略。具体而言,将RGB三通道彩色帧与双通道光学流帧沿通道维度拼接,形成六通道输入,送入视觉编码器的Patch Embedding层。此设计保持了输出token数量不变,避免增加语言模型的计算负担。更重要的是,通过零填充初始化(zero-padding initialization)——即对新增的光学流通道权重初始化为零——确保在训练初期不会破坏预训练模型已有的空间表征能力,有效防止灾难性遗忘。
为支撑模型训练,团队构建了一个可扩展的数据引擎。由于真实世界中标注精确转场区间的视频极为稀缺,且公开数据集多为点级标签,研究者利用FFmpeg内置的59种转场效果,自动将干净镜头片段合成为带精确段级标签的训练视频。结合对现有公开数据的重新标注与质量感知采样策略,最终构建出包含23.3万条视频、69万次转场的大规模训练集,涵盖四个质量层级,显著提升模型泛化能力。
针对长视频处理难题,TransVLM设计了滑动窗口推理机制。模型在短片段上训练,但实际应用场景常涉及数小时长的视频。直接全视频输入会导致显存溢出且分布偏移。因此,系统将视频切分为重叠的时间窗口,分别进行局部预测,再通过时序非极大值抑制(temporal NMS)合并结果,生成全局一致的转场段列表。该策略既保证了训练-推理一致性,又支持任意长度视频的处理。
为客观评估STD性能,研究团队发布了首个STD基准测试集,包含5,215段视频(超100小时),标注了45,239个转场实例,覆盖短于0.1秒的硬切、1秒内的常规转场及超过1秒的长时转场。评估指标不仅包括段级F1和帧级F1,还引入绝对边界误差(Absolute Boundary Error, ABE)衡量时间定位精度,以及实时因子(Real-Time Factor, RTF)评估推理效率。
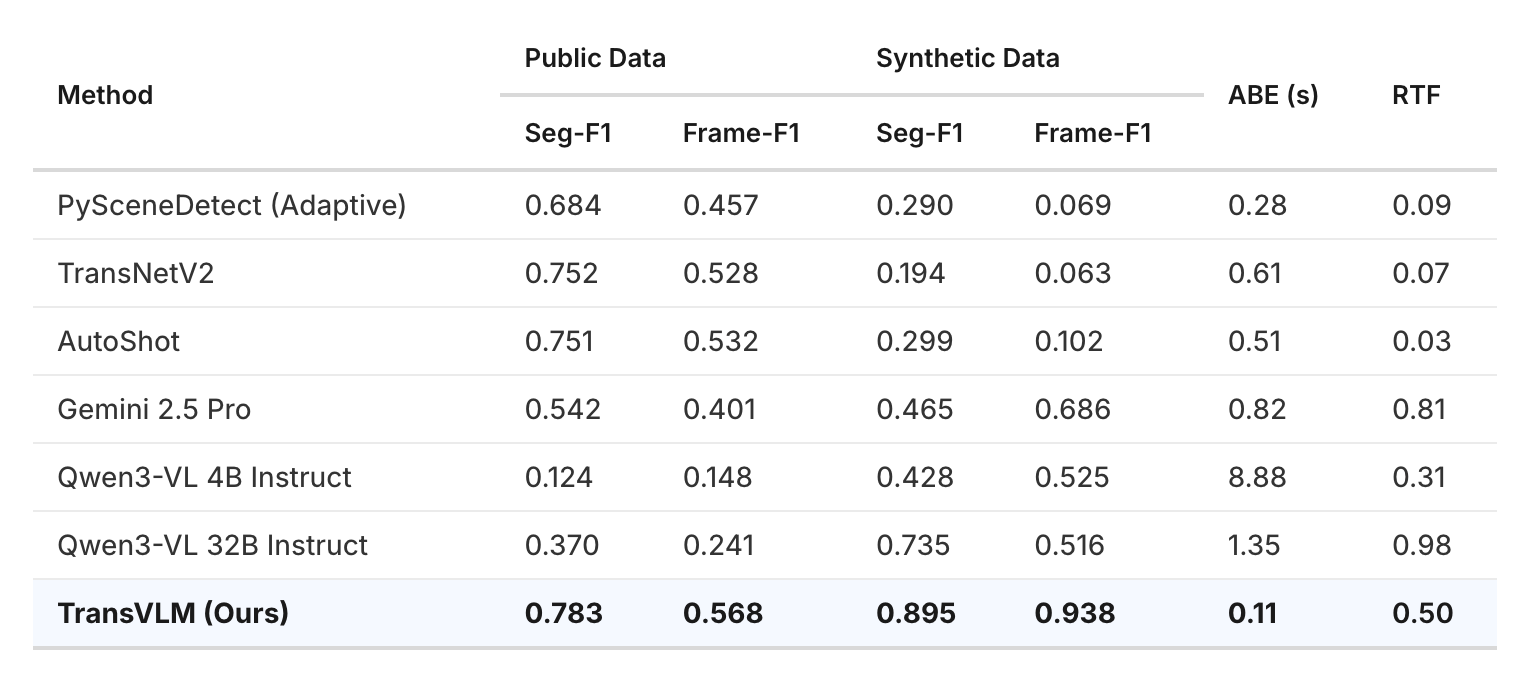
实验结果显示,TransVLM在各项指标上全面领先。在公开数据上,其段级F1达78.3%,超越AutoShot(75.1%);在包含复杂渐进转场的合成数据上,优势更为显著——TransVLM取得89.5%的段级F1,而AutoShot骤降至29.9%。ABE仅为0.11秒,表明模型具备极高的时间定位精度。尽管推理速度(RTF=0.50)慢于传统方法(如AutoShot的RTF=0.03),但仍是唯一能在所有转场类型上保持鲁棒性能的实用方案。
消融实验进一步验证了各组件的必要性。移除光学流导致公开数据段级F1下降近9个百分点,证明运动信息不可或缺;若采用双流编码(分别处理彩色与光流),虽精度相近,但RTF升至1.29,失去实时性;仅用合成数据训练会导致在真实数据上性能崩塌(F1=41.6%),凸显混合数据策略的重要性;而若对光流通道采用简单权重复制而非零填充初始化,段级F1会跌至65.5%,说明预训练知识保护机制至关重要。
这项工作的意义远超技术本身。精准的镜头转场检测是视频理解系统的基础设施。无论是视频检索中的片段定位、视频描述生成中的事件划分,还是动作识别中的上下文建模,都依赖于高质量的镜头分割结果。对HeyGen等文本生成视频平台而言,训练数据中的转场标注质量直接影响生成内容的连贯性与艺术性。错误的硬切标签可能导致生成视频出现突兀跳变,而缺失的溶解标注则会使模型无法学习平滑过渡技巧。TransVLM提供的段级精确标注,从源头上净化了训练信号,为下一代生成式视频模型奠定坚实基础。
值得注意的是,TransVLM并非孤立的技术突破,而是体现了多模态AI发展中的一种趋势:将低层感知线索(如光流)。传统计算机视觉擅长前者,大模型擅长后者,而真正的智能系统需要两者的深度融合。未来,随着VLM架构的演进与视频理解需求的增长,类似TransVLM的混合范式有望在更多时序感知任务中发挥关键作用。