李飞飞发布全球首个多模态世界模型Atlas:如何重塑机器人与视觉AI的未来?
近年来,人工智能的发展正从单一模态、任务导向的模型,逐步迈向能够理解并模拟真实世界的通用系统。在这一演进路径中,李飞飞及其创立的World Labs于2026年9月发布的Atlas,被广泛视为一个里程碑式的突破。这款被官方称为“全球首个多模态世界模型”的系统,不仅具备强大的图像与视频生成能力,更关键的是,它能以像素级精度理解并重构三维空间,同时建模时间动态,从而为机器人、视觉特效乃至未来智能体提供一个可交互、可扩展的“数字孪生”世界。

Atlas的核心目标并非仅仅生成逼真的画面,而是建模世界本身。正如其宣传语所言:“建模世界,移动相机,模拟空间和时间。”这一理念标志着AI从“内容生成器”向“世界模拟器”的范式转移。传统生成模型如Stable Diffusion或Sora,虽能产出高质量图像或视频,但缺乏对底层几何结构和物理一致性的深层理解。而Atlas则试图在统一架构下,同时处理文本、图像、视频、相机位姿乃至3D深度图,构建一个连贯、可推理的空间上下文。
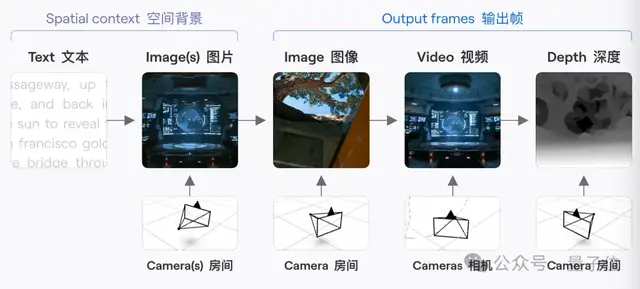
技术上,Atlas采用了一种创新的多模态自回归扩散Transformer架构。这一设计融合了大语言模型(LLM)的序列建模能力与扩散模型在高维连续数据生成上的优势。所有输入——无论是文字描述、单张照片,还是多视角图像序列——都会被锚定到一个共享的三维坐标系中,形成所谓的“空间上下文”。在此基础上,模型通过自回归方式逐步生成新的多模态元素,每一步都以前序内容为条件,确保输出在空间和时间上的连贯性。
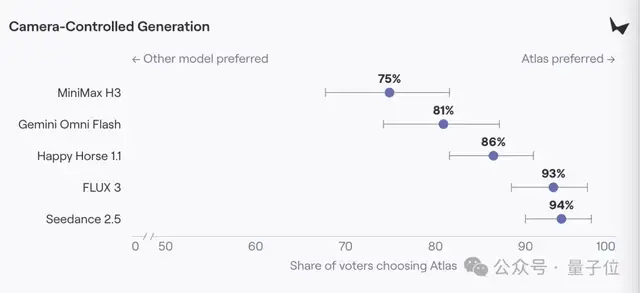
例如,用户仅需提供一张街景照片,Atlas即可推断出该场景的三维结构,并允许用户“移动相机”——生成从任意新视角观察的图像或视频,最高支持1440p分辨率、长达一分钟的连续输出。更令人惊叹的是,即使输入的是两张毫无关联的参考图(如一张室内客厅与一张户外森林),只要指定它们在虚拟空间中的相对位置,Atlas也能将二者无缝融合成一个逻辑自洽的3D环境。这种能力远超传统图像拼接或NeRF等3D重建方法,展现出对空间关系的深层理解。
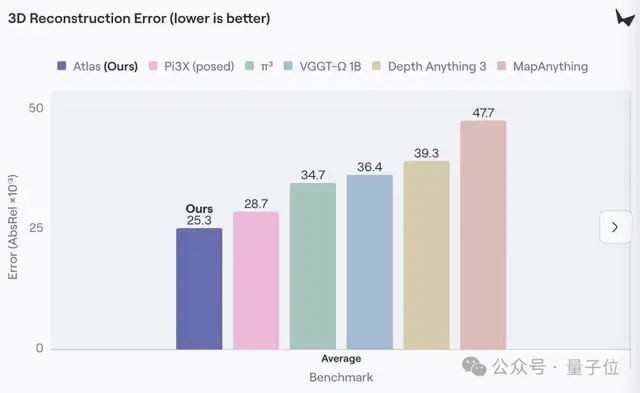
在3D重建任务中,Atlas的表现同样突出。实验表明,即便仅基于稀疏的几张输入图像,其重建质量已超越当前最先进的专用3D模型。这得益于其端到端训练策略和对空间先验的内化学习。不同于传统流程依赖多阶段处理(如特征提取、匹配、优化),Atlas在一个统一框架内完成从感知到重建的全过程,减少了误差累积,提升了几何一致性。
而真正让业界振奋的,是Atlas在具身智能(Embodied AI)领域的应用潜力。长期以来,机器人训练面临“现实鸿沟”——真实世界数据采集成本高、风险大,而传统仿真环境又过于简化,难以迁移至现实。World Labs提出的“Real-to-Sim-to-Real”闭环,正是为解决这一瓶颈。Atlas作为其中的关键一环,能够从少量真实照片自动构建高保真模拟场景,生成对应的RGB图像与深度图,供机器人进行大规模、安全的策略训练。
英伟达机器人主管、李飞飞的学生Jim Fan评价Atlas是“Real-to-Sim的一大步”,正是因为其生成的模拟环境不仅视觉逼真,更保留了准确的空间几何与物理属性。这意味着机器人在Atlas构建的虚拟世界中学到的导航、抓取或避障策略,更有可能在真实环境中有效执行。World Labs此前收购仿真公司SceniX,并发布Marble机器人平台,如今Atlas的推出,显然意在打造一个完整的具身智能开发生态。
值得注意的是,Atlas并非简单堆砌现有技术,而是在架构层面进行了深度整合。它采用Rectified Flow(校正流)作为扩散机制,相比传统DDPM或DDIM,在生成速度与质量之间取得更好平衡。同时,模型充分利用了LLM领域的推理优化技术,如KV缓存、缓存感知路由等,使其在处理长序列多模态数据时仍保持高效。此外,其潜空间设计结合了先进VAE架构,支持复杂提示(如精确文字渲染、风格控制)的忠实表达。
更重要的是,Atlas从设计之初就为规模化扩展做好了准备。研究团队透露,初步实验已显示出明显的“能力随规模增长”趋势——更大的参数量、更广的数据覆盖,将带来更强的空间推理与泛化能力。这预示着Atlas可能成为未来世界模型的基础平台,类似当年的BERT或ResNet之于各自领域。
目前,Atlas已向部分合作伙伴开放早期访问,并计划集成到World Labs未来的Marble机器人系统及其他产品中。尽管尚未全面公开,但其技术路线已清晰勾勒出下一代AI的发展方向:不再局限于“看”或“说”,而是真正“理解”并“模拟”我们所处的三维动态世界。
从更宏观的视角看,Atlas的出现也重新定义了“世界模型”的内涵。李飞飞在今年早些时候曾将世界模型分为三类:渲染器(Renderer)、模拟器(Simulator)和规划器(Planner)。她强调,模拟器才是核心,因为只有准确模拟世界的几何、物理与动力学,才能支撑可靠的感知与行动。Atlas正是朝着这一目标迈出的关键一步——它不仅是渲染工具,更是可交互、可干预的动态模拟引擎。
未来,随着Atlas能力的进一步释放,我们或许能看到更多应用场景:电影工业中快速生成带精确摄像机轨迹的特效镜头;城市规划中基于街景照片构建可漫游的数字孪生城市;教育领域创建沉浸式历史场景重现……甚至,它可能成为通用人工智能(AGI)通往物理世界的重要桥梁。
当然,挑战依然存在。如何提升对复杂物理交互(如流体、柔性物体)的建模能力?如何确保长时间视频中的因果一致性?如何降低计算成本以实现实时交互?这些问题仍有待后续研究。但不可否认的是,Atlas已经为“建模世界”这一宏大目标,树立了一个坚实而富有想象力的起点。
在这个AI从“感知智能”迈向“认知与行动智能”的转折点上,李飞飞团队的Atlas不仅是一项技术成果,更是一种愿景的体现:让机器真正理解我们生活的这个三维、动态、充满因果的世界,并在其中安全、有效地行动。而这,或许正是具身智能乃至通用人工智能的必经之路。