Facet-0:让机器人在精密装配中学会‘感知失败并自我修复’
近年来,机器人技术在通用性方面取得了显著进展。借助视觉—语言—动作(Vision-Language-Action, VLA)模型,机器人已能理解自然语言指令、识别物体并执行多步骤操作,摆脱了传统“一任务一程序”的开发范式。然而,当这些系统真正进入制造现场,尤其是高精度装配环节时,新的挑战浮现:能否在毫米甚至亚毫米级的接触过程中保持稳定,并在出现偏差后自主恢复,成为决定其能否实际部署的关键门槛。
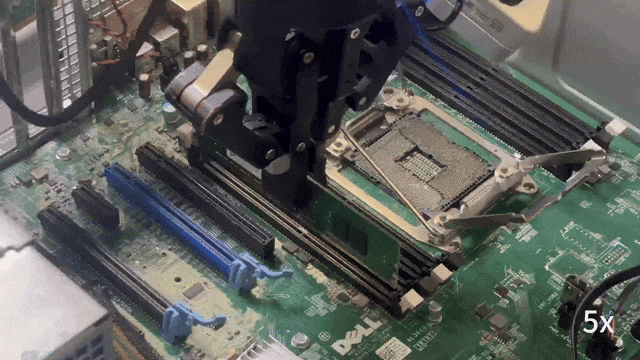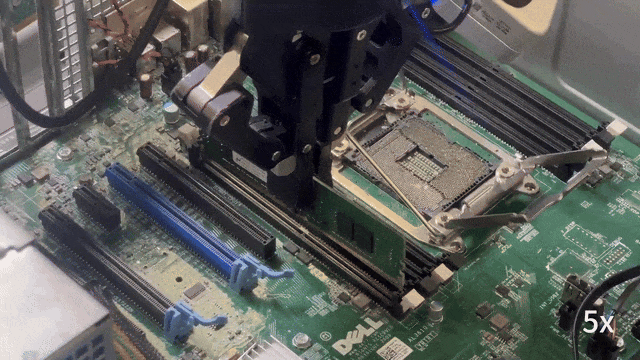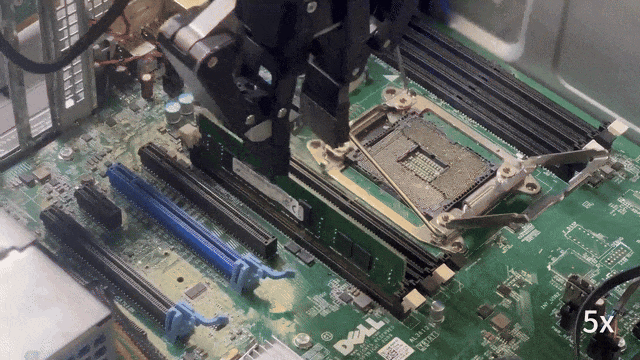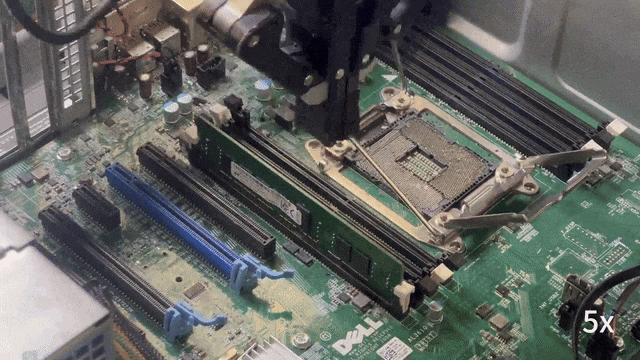
精密装配任务——如将内存条、CPU或GPU插入服务器主板——看似简单,实则对接触控制提出极高要求。零件可能在视觉上已对齐,但在最后0.1–0.3毫米的插入过程中,微小的角度偏差或异物干扰即可导致卡滞、偏斜甚至损坏。一次未被处理的异常,足以中断整条任务链。因此,机器人不仅需要“知道做什么”,更需“感知做得对不对”并“有能力修正错误”。
在此背景下,新加坡南洋理工大学(NTU)PINE Lab团队提出了面向接触丰富型精密操作的机器人基础模型 Facet-0,旨在弥合通用VLA能力与工业级可靠性之间的鸿沟。
高精度任务下的性能突破
Facet-0在五项真实计算机硬件装配任务(包括RAM、CPU、Disk和GPU安装)中实现了82%的平均任务成功率。作为对比,当前主流基线模型π0.5和GR00T N1.7的成功率分别仅为10%和4%。这一差距凸显了通用VLA模型在精密场景中的局限性。
值得注意的是,这些任务并非简单的抓取与放置,而是包含23个子目标的复杂流程,涉及多次对齐、插入、压合、锁定与撤离操作。其中大量关键步骤发生在0.10–0.30毫米的装配间隙内,对位置精度和接触控制提出严苛要求。Facet-0的放置精度达到0.5毫米,指令延迟约50毫秒,满足实时控制需求。
更关键的是,82%的成功率并非依赖大规模预训练堆砌而来。其训练流程分为三个阶段:预训练阶段成功率仅为16%;经过强化学习(RL)后训练提升至38%;最终通过轻量化适配模块(仅更新6.6%参数)达到82%。这一路径表明,针对性的后训练与适配机制,比单纯扩大数据规模更能提升工业场景下的鲁棒性。
在部署阶段,Facet-0展现出强大的自主恢复能力:人工干预率从47%降至24%,失败恢复率从44%跃升至81%。例如,当内存条插入过程中发生卡滞,系统能自动回撤、重新对齐并再次尝试,而非直接报错或等待人工介入。
为什么通用VLA模型难以胜任精密制造?
通用VLA模型擅长处理开放域任务,如整理桌面、倒水或开门。它们依赖视觉提供语义和几何信息,结合语言理解生成动作序列。但在精密装配中,视觉信息存在天然盲区:一旦零件进入插槽,夹具或机械臂本体可能遮挡关键接触区域,导致视觉无法判断是否真正对准。
此时,力/力矩传感器提供的接触状态成为不可替代的信息源。例如,一个零件位置几乎未变,但六维力信号显示Z轴压力持续异常升高,这往往是卡滞的早期征兆——而视觉系统对此无能为力。
因此,精密制造需要的不是“带有力传感器的VLA”,而是将力觉深度融入决策闭环:模型需同时理解任务语义、感知接触状态、评估动作质量,并在必要时调整策略。这要求视觉、语言、本体状态与力觉在模型内部形成统一表征,而非简单拼接输入。
ManuFacet-1K:构建接触感知的数据基石
要训练具备上述能力的模型,首先需要高质量、高同步性的多模态数据集。PINE Lab为此构建了 ManuFacet-1K,包含约1000小时的真实机器人操作数据。
该数据集覆盖三种主流机械臂(UR7e、xArm、Franka)、两类服务器机箱,以及四类典型装配任务(GPU、RAM、CPU、Disk)。每一帧数据均同步记录:
- 多视角RGB图像(提供环境与物体语义)
- 自然语言指令(描述当前子任务)
- 末端执行器位姿与夹爪状态
- 六维力/力矩信号(反映接触动态)
- 技能阶段标签(如“接近”“对齐”“插入”“压合”等)
尤为关键的是,ManuFacet-1K并未剔除失败轨迹。真实部署中的卡滞、人工接管、回撤与恢复过程均被完整保留。这使得模型不仅能学习“成功怎么做”,还能理解“失败如何发生”以及“如何从失败中恢复”。这种对异常行为的建模,是提升系统鲁棒性的核心。
Facet-0架构:语义动作与力觉控制的对齐
有了高质量数据,下一步是如何设计模型架构以有效利用力觉信息。Facet-0的核心思想是:不让力觉沦为边缘输入,而是将其作为驱动动作精化的关键信号。
其架构包含两个专家模块:
动作专家(Action Expert):基于多模态输入(图像、语言、本体状态、历史力觉)生成粗粒度动作序列,对应高层任务意图(如“将内存条插入插槽”)。
精化专家(Refinement Expert):在进入接触阶段后,结合实时力/力矩反馈,对粗粒度动作进行微调,生成细粒度控制指令。例如,当检测到侧向力异常增大,系统会小幅回撤并调整角度,而非继续下压。
最终动作由高频合规控制器执行,该控制器施加工作空间约束、单步运动限制等安全机制,确保物理交互的稳定性。这种分层设计实现了“语义决策”与“接触控制”的对齐:高层意图指导方向,底层力觉保障执行质量。
强化学习后训练:从“是否成功”到“如何成功”
即使模型具备感知与控制能力,仍面临一个深层问题:任务最终成功,并不意味着中间过程值得模仿。例如,两条轨迹都完成了内存插入,但一条通过温和对齐实现,另一条则靠持续硬顶强行压入——后者虽成功,却可能损伤插槽或缩短设备寿命。
Facet-0的RL后训练机制正是为解决此问题而设计,其核心在于精细化的信用分配(Credit Assignment):
阶段级信用分配
系统将整条轨迹划分为多个技能阶段(如对齐、插入、压合)。即使某阶段发生失败,只要机器人后续成功回撤并重新完成该阶段,这段恢复行为仍可获得正向奖励。这避免了因局部失败导致整条轨迹被丢弃,使模型能从部分成功中学习。
接触质量评估
价值模型不仅关注“是否完成阶段”,还评估“如何完成”。它结合动作平滑性与力/力矩变化,对接触质量打分。过大的接触力、剧烈的力波动会降低价值,从而引导策略偏好温和、稳定的交互方式。
关键片段聚焦
由于接触事件在整条轨迹中占比极小(通常<5%),若对所有时间步平等采样,关键接触动作易被自由空间运动淹没。Facet-0采用分阶段采样策略:在接触阶段提高采样密度,确保模型重点学习对齐、插入、卡滞与恢复等决定成败的瞬间。
策略迭代闭环
高价值经验被用于微调动作专家,使其逐步形成对“理想接触状态”的内在预期。同时,真实部署中的新轨迹(包括成功、失败、人工接管与恢复)持续回流至训练系统,形成 “运行 → 异常检测 → 恢复/纠正 → 价值评估 → 策略更新” 的闭环。这种机制使模型能在实际使用中不断进化,而非仅依赖静态训练集。
轻量化适配:快速迁移至新零件与工况
工业场景常面临零件变更、工装调整或机器人平台切换。Facet-0通过轻量化适配模块应对这一挑战。在面对从未见过的内存模块时,仅需10条示范轨迹、约3小时训练,并更新6.6%的参数,即可达到45%的成功率(最强基线仅为5%)。这表明,其核心接触理解能力具有良好的泛化性,适配成本远低于从头训练。
从Demo到产线:机器人可靠性的新标准
Facet-0的意义不仅在于技术指标的提升,更在于重新定义了工业机器人的能力边界。过去,研究者追求“一次成功”的演示;而今,真正的挑战在于第100次面对微小偏差时是否仍能稳健完成。
生产现场关心的不是理想条件下的表现,而是:
- 当零件公差累积导致装配间隙变化时,能否自适应调整?
- 当出现训练集未覆盖的卡滞模式时,能否自主回撤并重试?
- 更换供应商提供的新批次零件后,调试周期有多长?
Facet-0通过将失败转化为可学习信号,使机器人具备“经验积累”能力。这种从“执行者”向“学习者”的转变,是机器人走向规模化工业应用的关键一步。
未来方向
PINE Lab表示,下一步将扩展ManuFacet数据集,覆盖更多长尾零件与复杂工况;探索更统一的语义—力觉联合建模方法;并研究面向长期部署的安全持续学习机制,确保模型在数月甚至数年的运行中保持性能稳定且不退化。
归根结底,在精密制造中,决定机器人能否真正进入生产线的,或许并不是它在理想情况下成功了多少次,而是当那一次不可避免的失败到来时,它能不能自己把任务继续做下去。Facet-0所展示的,正是这样一种面向真实世界的韧性与智慧。