李飞飞World Labs发布Atlas世界模型:全模态生成如何重塑数字现实?
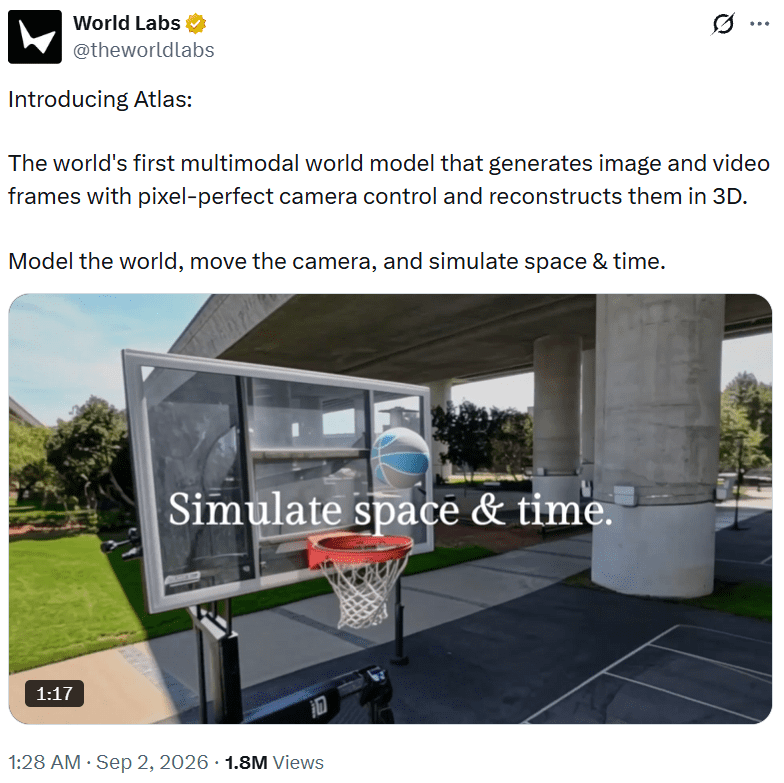
近年来,生成式人工智能正从单一模态向多模态融合加速演进。在这一浪潮中,由AI领域先驱李飞飞联合创立的World Labs于2026年9月发布了其备受瞩目的新一代世界模型——Atlas。这款被官方称为“全模态模型”(omni model)的系统,不仅能够生成高度逼真的图像与视频,还能同步构建可交互的3D空间,甚至为机器人训练提供物理一致的仿真环境。其最引人注目的演示之一,便是生成“李飞飞在办公室叠衣服”的画面,细节之真实令人难以分辨虚实。
Atlas的出现,标志着世界模型(World Model)从“视觉拟真”向“空间可用”的关键跃迁。它不再仅仅是一个内容生成工具,而是一个能够理解、重建并模拟物理世界的统一框架。这一转变背后,是其独特的“空间上下文”设计理念与多模态自回归扩散架构的深度融合。
全模态能力:打通文本、图像、视频与3D的壁垒
Atlas最显著的特征是其对四种核心模态的原生支持:文本、图像、视频和3D。不同于以往模型需通过中间转换或分阶段处理不同模态,Atlas从零开始预训练,将所有输入统一编码到一个共享的表示空间中。这种设计使其具备四大核心能力:
首先是相机可控生成。用户只需提供1至6张参考图像,并指定目标视角的相机参数(如位置、朝向、焦距),Atlas即可生成符合该视角的新图像或视频帧。输出分辨率最高可达1440p,视频时长最长支持1分钟。这意味着创作者无需依赖复杂的CGI流程,仅凭少量实拍素材即可实现电影级的镜头运动。
其次是空间重建。Atlas能从单张乃至数十张输入图像中重建出完整的3D场景。其输出不仅包括新视角下的图像序列,还包含点云(point cloud)和3D高斯泼溅(3D Gaussian Splatting)等显式几何表示。这种能力在建筑扫描、文化遗产数字化等领域具有巨大潜力。
第三项能力是时空模拟。通过分析输入视频中的动态信息,Atlas能够同时建模空间结构与时间演化。这一特性被直接应用于机器人领域的Real-to-Sim(真实到仿真)流程:将真实环境视频转化为可供机器人训练的虚拟场景,其中包含精确的RGB图像与深度图。
最后是传统的图像生成能力,包括基于文本提示生成图像(text-to-image)以及生成360度全景图。尽管这项能力看似常规,但在Atlas的空间上下文框架下,生成结果天然具备几何一致性,避免了传统文生图模型常见的透视错误或结构矛盾。
空间上下文:让AI真正“理解”三维空间
Atlas的技术核心在于其提出的“空间上下文”(spatial context)机制。这一设计灵感来源于大语言模型(LLM)中的上下文窗口——LLM将输入文本编码为上下文向量,再基于此预测下一个token。Atlas沿用了这一范式,但关键区别在于:每一张输入图像都与其对应的相机位姿(camera pose)一同被嵌入到三维空间中。
这意味着,模型内部维护的不是一个抽象的语义上下文,而是一个具象的、带有几何坐标的“空间记忆”。当用户要求生成某个新视角时,Atlas并非依赖对“向左推轨”“俯拍”等文本指令的模糊理解,而是直接在已构建的空间上下文中进行几何插值与渲染。
这种设计带来了两个革命性优势。其一,相机控制变得精确且可预测。传统视频生成模型需将运镜指令写入提示词,模型能否准确执行完全取决于其对自然语言的理解能力,结果往往不可控。而Atlas将相机几何作为原生输入类型,使创作者如同“坐在导演椅上”,而非“拉动老虎机拉杆”。
其二,跨视角的连贯性得到根本保障。例如,用户可将两张毫无关联的图片(如一张室内照片和一张室外街景)分别放置在空间上下文的不同坐标位置,Atlas会自动推断两者之间的过渡空间——想象出门廊、走廊甚至转角结构,生成一个逻辑自洽的连续世界。这种能力在虚拟制片、游戏关卡设计等场景中极具价值。
架构解析:融合LLM与视频生成的双重优势
从技术架构看,Atlas是一个多模态自回归扩散Transformer。这一命名包含了四个关键技术要素:
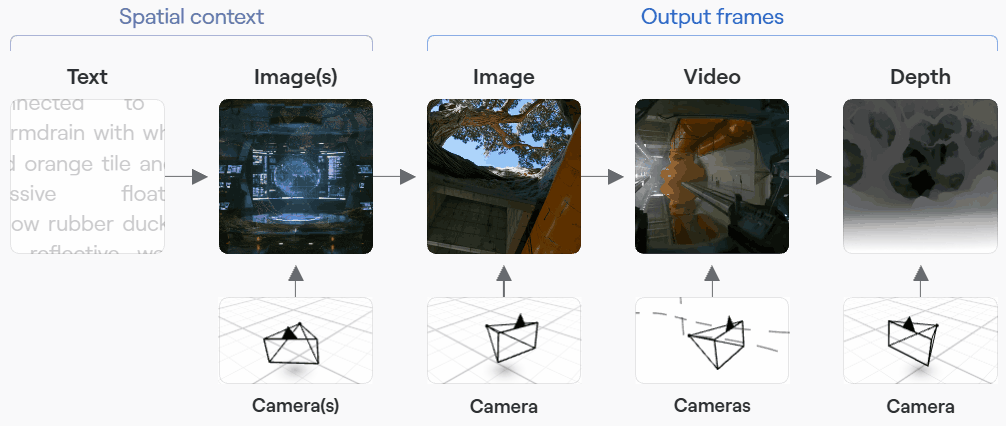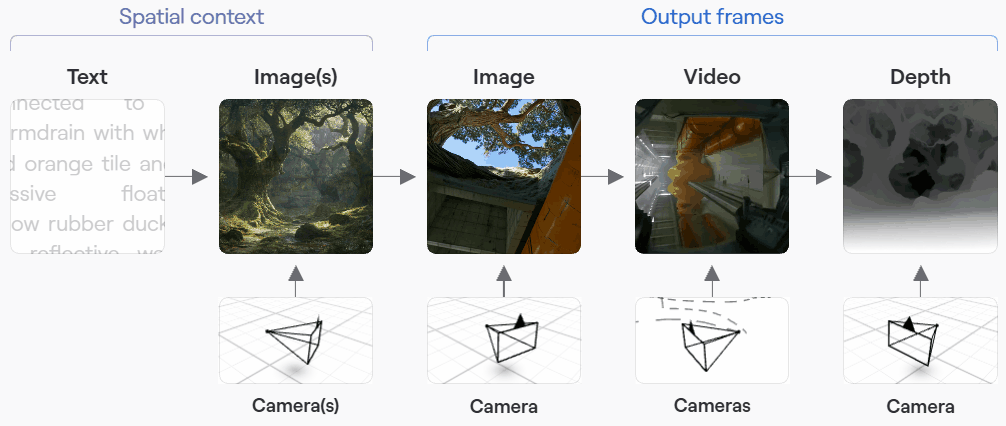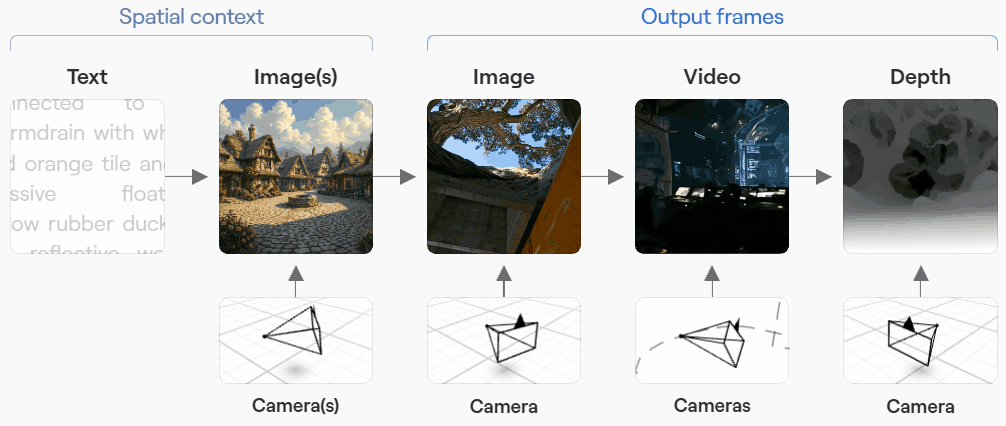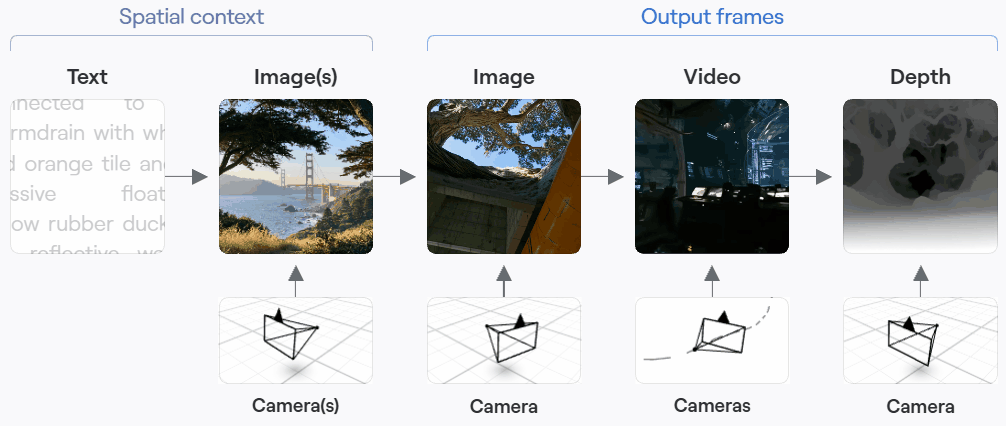
- 多模态:模型原生处理文本、图像、相机位姿和深度图。视频被视为图像序列,与静态图像共享同一套处理流程。
- 自回归:所有输出(无论是图像像素、视频帧还是3D点)均以序列形式逐元素生成。不同任务仅对应不同的序列排列方式,实现了任务统一。
- 扩散机制:采用rectified flow(校正流)作为生成核心。相较于传统扩散模型,rectified flow通过更平滑的轨迹实现去噪,训练与推理效率更高。
- Transformer骨干:确保模型能充分利用现代GPU/TPU的并行计算能力,并兼容LLM领域的优化技术。
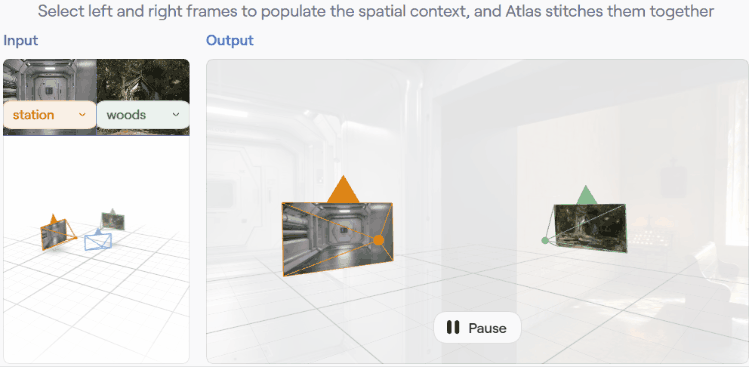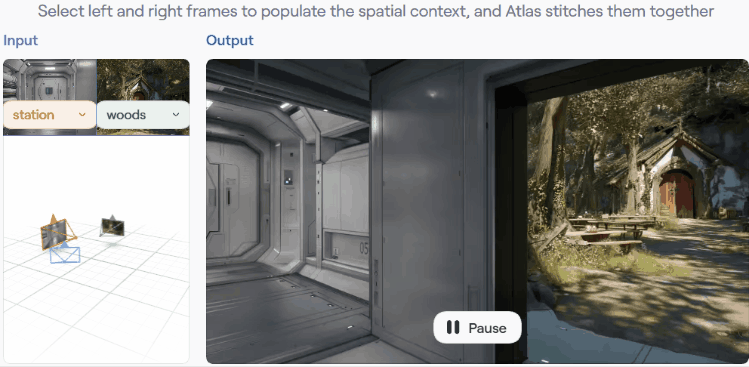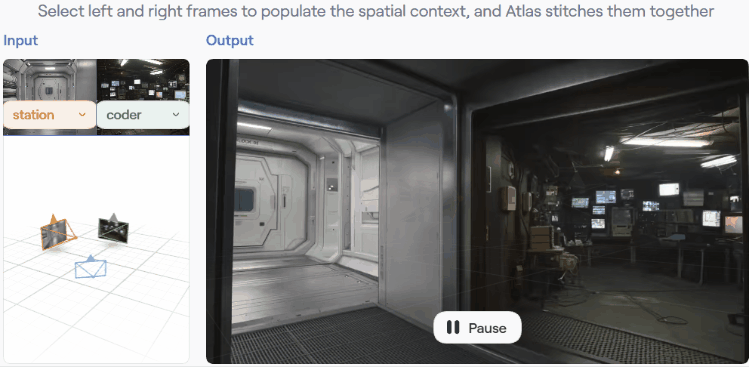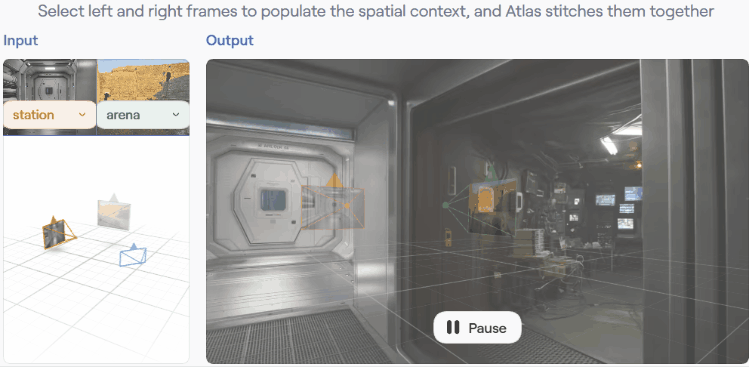
World Labs强调,Atlas本质上是大语言模型与视频生成模型两条技术路线的融合体。因此,它既能受益于LLM侧的推理优化(如KV缓存、分离式部署),也能集成视频生成领域的最新进展(如CFG引导、VAE改进、扩散蒸馏)。这种混合架构使其在保持生成质量的同时,具备更强的可扩展性与工程落地能力。
评测表现:优势明显但需理性看待对比条件
World Labs在博客中公布了两项关键评测结果,但需注意其对比前提。
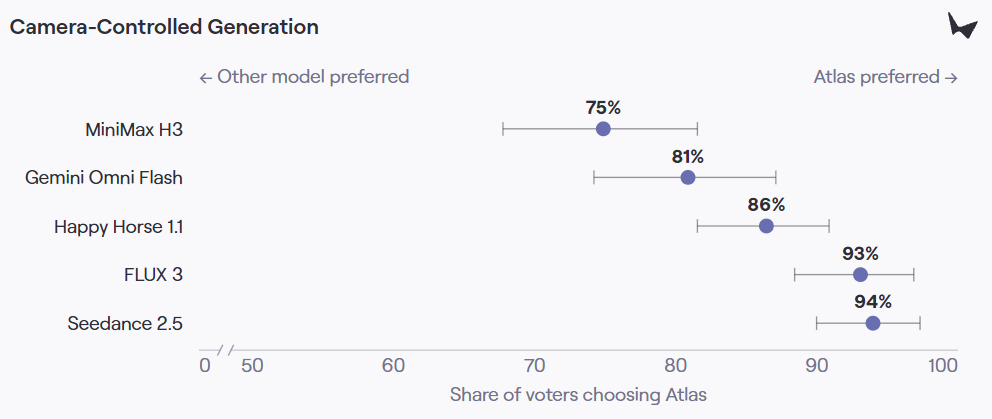
在相机可控生成任务中,Atlas以单张输入图配合1-3段电影化运镜指令进行测试,由人类评分者盲选。结果显示,Atlas对MiniMax H3胜率75%,对Gemini Omni Flash达81%,对阿里HappyHorse 1.1为86%,对FLUX 3为93%,对字节Seedance 2.5高达94%。然而,官方明确指出:所有对比模型均不支持原生相机位姿输入,运镜只能通过文本描述。因此,这一差距主要反映的是“原生几何接口”相对于“文本指令”的优势,而非纯粹的画面生成质量优劣。
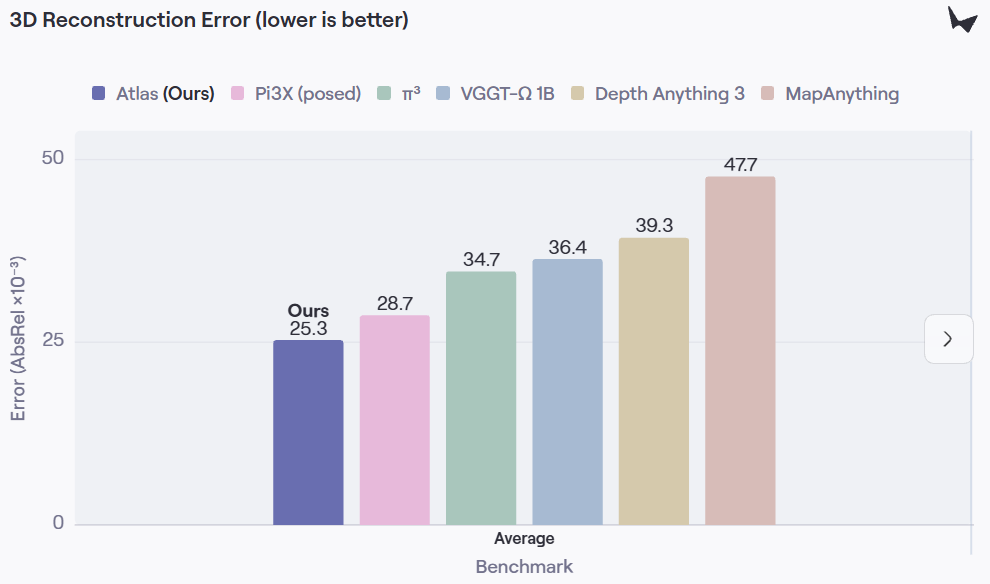
在3D重建方面,Atlas在稀疏视角重建任务上的平均相对误差(AbsRel×10⁻³)为25.3,优于Pi3X(28.7)、π³(34.7)、VGGT-Ω 1B(36.4)等当前最优的开源专用模型。World Labs强调所有基线结果均由其团队复现,确保评测协议一致。但同时也承认,Atlas并非在所有数据集上都排名第一,且对比对象限定为“开源专用模型”,未与闭源商业系统直接比较。
关于模型规模,World Labs仅做定性描述:训练过程中通过递增算力规模逐步解锁新能力,但未公布参数量、数据规模或推理延迟等具体指标。
应用场景:从影视特效到机器人训练
Atlas的能力已在多个前沿场景中得到验证。
在内容创作领域,其“子弹时间”效果尤为惊艳。仅需3-5台普通手机拍摄的多角度视频,Atlas即可冻结时间并生成任意新视角的回放镜头。World Labs团队使用背包中的简易夹具和三脚架完成拍摄,无需专业设备,极大降低了高质量特效的制作门槛。
在机器人仿真方面,Atlas展现出更深层的价值。World Labs今年7月收购仿真公司SceniX后,首次将这一战略落地为模型能力。具体做法是:用手机视频扫描真实环境(如仓库或街道),选取24帧进行重建,随后模拟不同形态的机器人沿预设路径行走,并由Atlas实时生成机器人车载相机应看到的RGB与深度图像。关键在于,环境重建与传感器渲染由同一模型完成,避免了传统Real-to-Sim流程中因系统割裂导致的误差累积。
此外,Atlas还能模拟物体间的物理交互——无论是刚体碰撞、铰接结构(如门、机械臂)还是可变形物体(如布料、软体),并支持批量生成光照、背景、物体位置变化的变体数据,为机器人感知与决策算法提供丰富训练样本。
输入越多,想象越少:重建忠实度与泛化能力的平衡
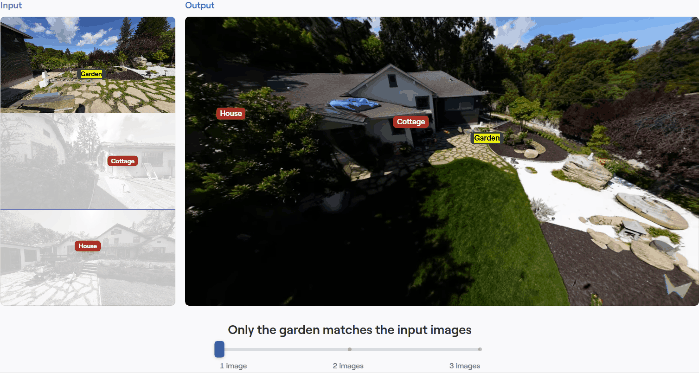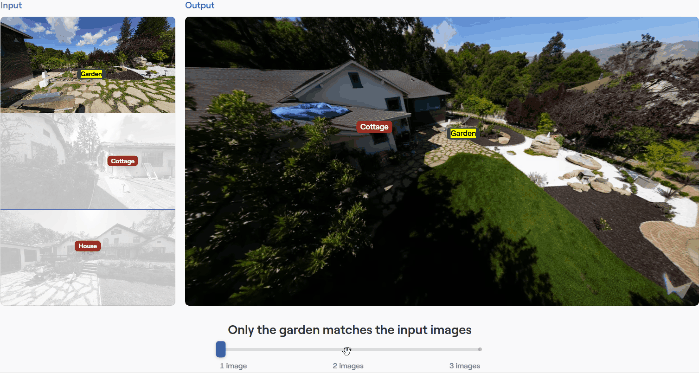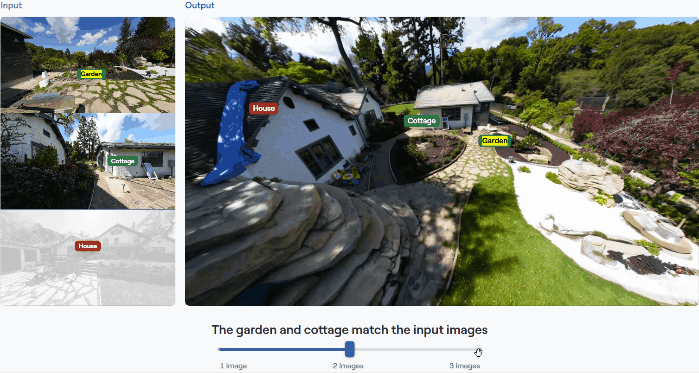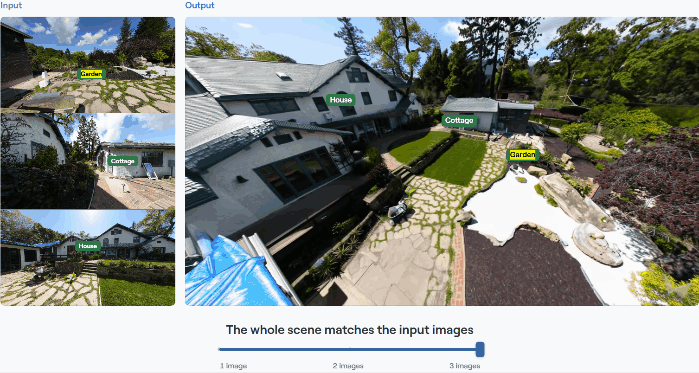
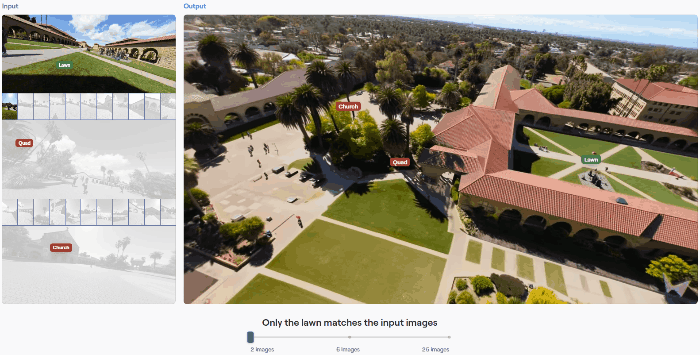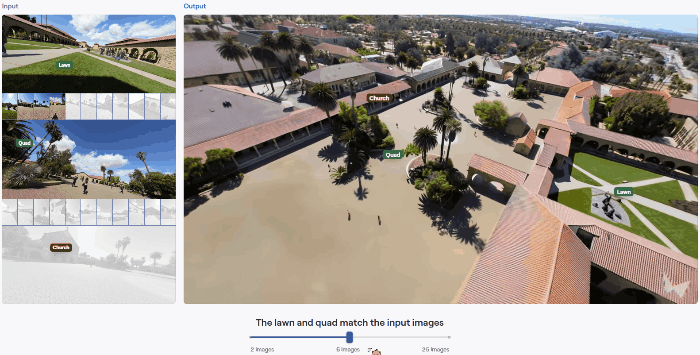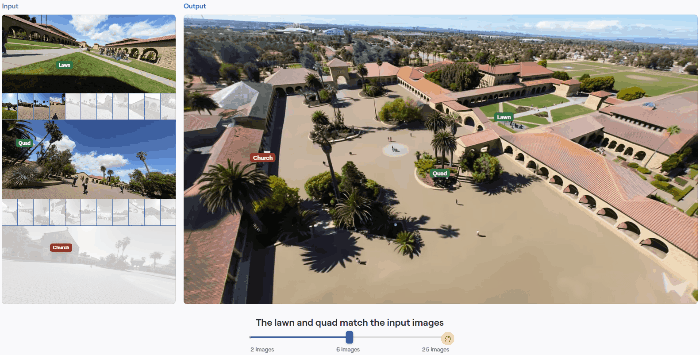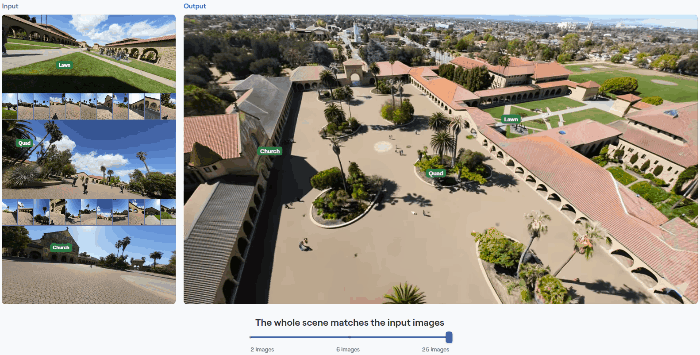
World Labs的示例清晰展示了Atlas在重建忠实度与空间想象力之间的动态平衡。当输入图像较少时(如仅1张),模型会大量填补未观测区域。例如,仅凭一张地面花园照片,Atlas可生成航拍视角,其中花园结构准确,但周围建筑均为合理推测。随着输入图增加(2-3张),重建结果迅速收敛至真实场景。在斯坦福主方庭案例中,仅用2-25张地面照片,Atlas便成功生成了高空飞行路径的连续视角。
这种特性使其既能用于数据稀缺场景的创造性补全,也能在数据充足时提供高保真重建,适应性极强。
从Marble到Atlas:World Labs的战略转向
回顾World Labs的发展轨迹,其技术路线呈现出清晰的演进逻辑。2024年9月,公司以2.3亿美元融资结束隐身状态;2025年11月推出首款产品Marble,聚焦影视、游戏与建筑领域的高保真可视化;2026年1月开放World API,2月完成10亿美元融资(投资方包括英伟达、AMD、Autodesk等),估值达50亿美元;7月收购SceniX强化仿真能力;9月即推出Atlas。
这一系列动作表明,World Labs正从“生成好看的世界”转向“生成够用的世界”。Marble满足的是视觉层面的真实感,而Atlas则追求物理层面的可用性——其生成的3D场景必须能被机器人传感器正确解读,其模拟的物体力学必须支撑真实任务训练。这种转向,正是世界模型从内容工具迈向基础设施的关键一步。
Atlas的发布,不仅展示了多模态AI在空间理解上的新高度,更预示了一个未来:数字世界与物理世界的界限将进一步模糊,而统一的世界模型将成为连接两者的通用接口。