Atlas世界模型如何实现像素级镜头控制?深度解析多模态AI的电影级视觉革命
近年来,生成式人工智能正从二维图像迈向三维空间理解与生成的新阶段。在这一演进过程中,World Labs于2026年推出的Atlas模型无疑树立了一个关键里程碑。作为由“AI教母”李飞飞创立的前沿实验室所打造的全球首个多模态世界模型,Atlas不仅突破了传统扩散模型或GAN在平面图像上的局限,更实现了对三维空间、时间动态与相机运动的统一建模。其最引人注目的能力——像素级镜头控制,使得用户能够像导演一样精确操控虚拟摄像机,在任意角度生成连贯、逼真的高清视频帧,从而轻松复现《黑客帝国》中经典的“子弹时间”视觉效果。
这种能力的背后,是一套全新的多模态预训练架构。与以往依赖单张图像或固定视角输入的模型不同,Atlas从设计之初就将相机参数(如位置、朝向、焦距)作为核心输入模态之一。这意味着模型并非简单地“想象”新视角,而是在一个隐式的三维世界表征中进行推理。当用户提供一张或多张参考图像时,Atlas首先通过多视图几何与神经辐射场(NeRF)相关技术,在内部构建一个可微分的空间结构。随后,它根据用户指定的相机轨迹,逐像素计算光线路径与场景交互,最终合成出几何一致、光照协调的新视图。
值得注意的是,Atlas的重建能力并不仅限于已有可见区域。在处理遮挡或缺失信息时,模型展现出强大的“空间想象力”。例如,当仅提供人物正面照片时,Atlas能合理推断其背面轮廓、发型细节甚至衣物褶皱的延伸形态。这种能力源于其在大规模真实世界数据上进行的自监督预训练——通过学习海量图像-视频对中的时空一致性约束,模型学会了物理世界的基本规律,如物体刚性、光照衰减、透视变形等。因此,其生成结果不仅视觉上逼真,更在几何逻辑上具备合理性。
在具体性能指标上,Atlas支持输出长达60秒的1440p高清视频,帧间过渡平滑无闪烁,且能保持长时间的结构稳定性。这在当前的AI视频生成领域实属罕见。多数现有模型在生成超过几秒的视频时容易出现“漂移”现象——物体形状扭曲、背景抖动或光照突变。而Atlas通过引入时空联合注意力机制与显式3D先验,有效抑制了此类问题。官方演示显示,即使在复杂动态场景(如旋转的汽车、行走的人物)中,模型也能维持精确的相机控制与一致的场景重建。
除了视觉生成,Atlas还具备强大的3D输出能力。用户可从数十张不同角度的照片中重建完整场景,并导出为点云、网格或NeRF格式,供后续在游戏引擎、VR/AR应用或机器人导航系统中使用。这一特性使其在数字孪生、文化遗产保护、建筑可视化等领域具有广阔应用前景。例如,考古学家可利用少量现场照片快速生成遗址的三维模型;电商企业则能为商品创建可交互的360度展示视图,无需昂贵的摄影棚设备。
更进一步,Atlas支持基于文本的端到端生成。用户只需输入一段描述性提示词(如“赛博朋克城市夜景,霓虹灯闪烁,雨后街道反光,低角度仰拍”),模型即可生成符合语义的360度全景图像或带相机运动的短视频。这种文本到3D/视频的直接映射,大幅降低了专业视觉内容的创作门槛。与Stable Diffusion等2D模型相比,Atlas的优势在于其输出天然具备空间一致性——无论从哪个角度观看,场景中的物体位置、比例和光照关系都保持逻辑自洽。
在机器人与具身智能领域,Atlas的时空模拟能力同样意义重大。通过输入真实世界视频,模型可构建高保真的仿真环境,用于训练机器人执行抓取、导航或人机交互任务。这种“真实到模拟”(real-to-sim)的工作流,解决了传统仿真器中“现实差距”(reality gap)的难题。机器人可在Atlas生成的虚拟场景中反复试错,再将策略迁移到物理世界,显著提升学习效率与安全性。
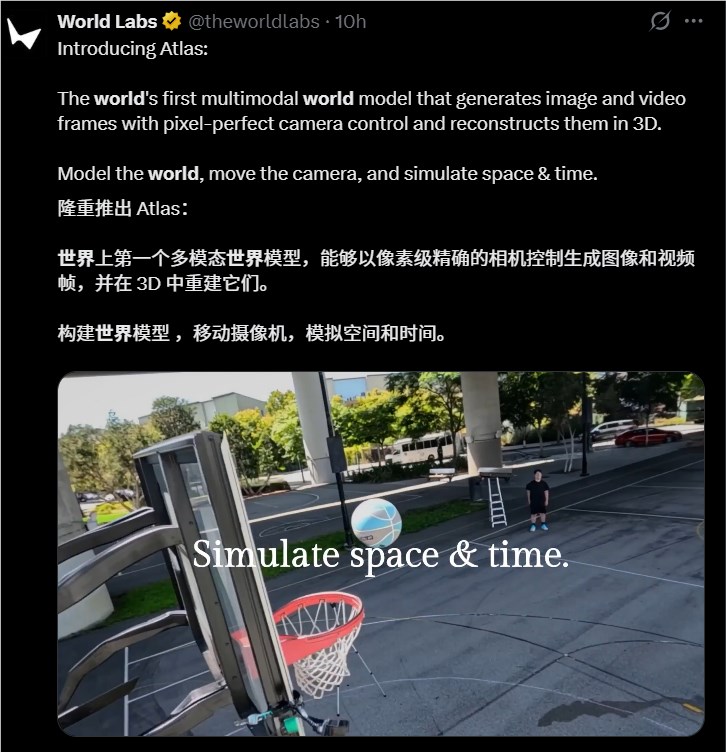
当然,Atlas也面临挑战。其计算资源需求极高,目前仅面向合作伙伴开放早期访问。此外,对于高度非刚性物体(如飘动的旗帜、流动的液体)或极端光照条件(如强逆光、全黑环境),重建精度仍有提升空间。但这些局限恰恰指明了未来研究方向:如何将物理引擎、材料属性建模与神经渲染更深度融合,将是下一代世界模型的关键突破点。
从行业影响来看,Atlas的出现标志着生成式AI正从“内容生成”迈向“世界建模”。过去几年,我们见证了文本、图像、音频的AI生成能力爆发;如今,以Atlas为代表的多模态世界模型开始整合空间、时间与交互维度,构建可编辑、可模拟、可推理的数字世界。这不仅将彻底改变电影、游戏、广告等创意产业的工作流程,更可能成为通用人工智能(AGI)通往具身认知的重要桥梁。
可以预见,未来的内容创作者将不再局限于剪辑现有素材,而是直接“导演”一个由AI构建的虚拟宇宙——设定场景、调度镜头、控制光影,一切尽在指尖。而Atlas,正是这场视觉革命的第一块基石。