Apache Tika实战解析:如何构建高鲁棒性文档提取引擎
在人工智能与大语言模型(LLM)广泛应用的今天,检索增强生成(RAG)已成为提升问答系统准确性的主流架构。而在这条技术链路的最前端,一个常被低估却至关重要的环节——文档解析,直接决定了整个系统的知识上限。看似简单的“读取文件”操作,在真实业务场景中却面临格式混乱、编码错乱、内容缺失等多重挑战。本文将以Apache Tika为核心工具,系统阐述如何构建一个高鲁棒性的文档提取引擎。
文件世界的复杂性远超想象
许多开发者初次接触文档处理时,往往误以为只需按后缀名调用对应库即可。然而现实远比理想复杂。以PDF为例,它并非单一格式,而是包含三种截然不同的类型:
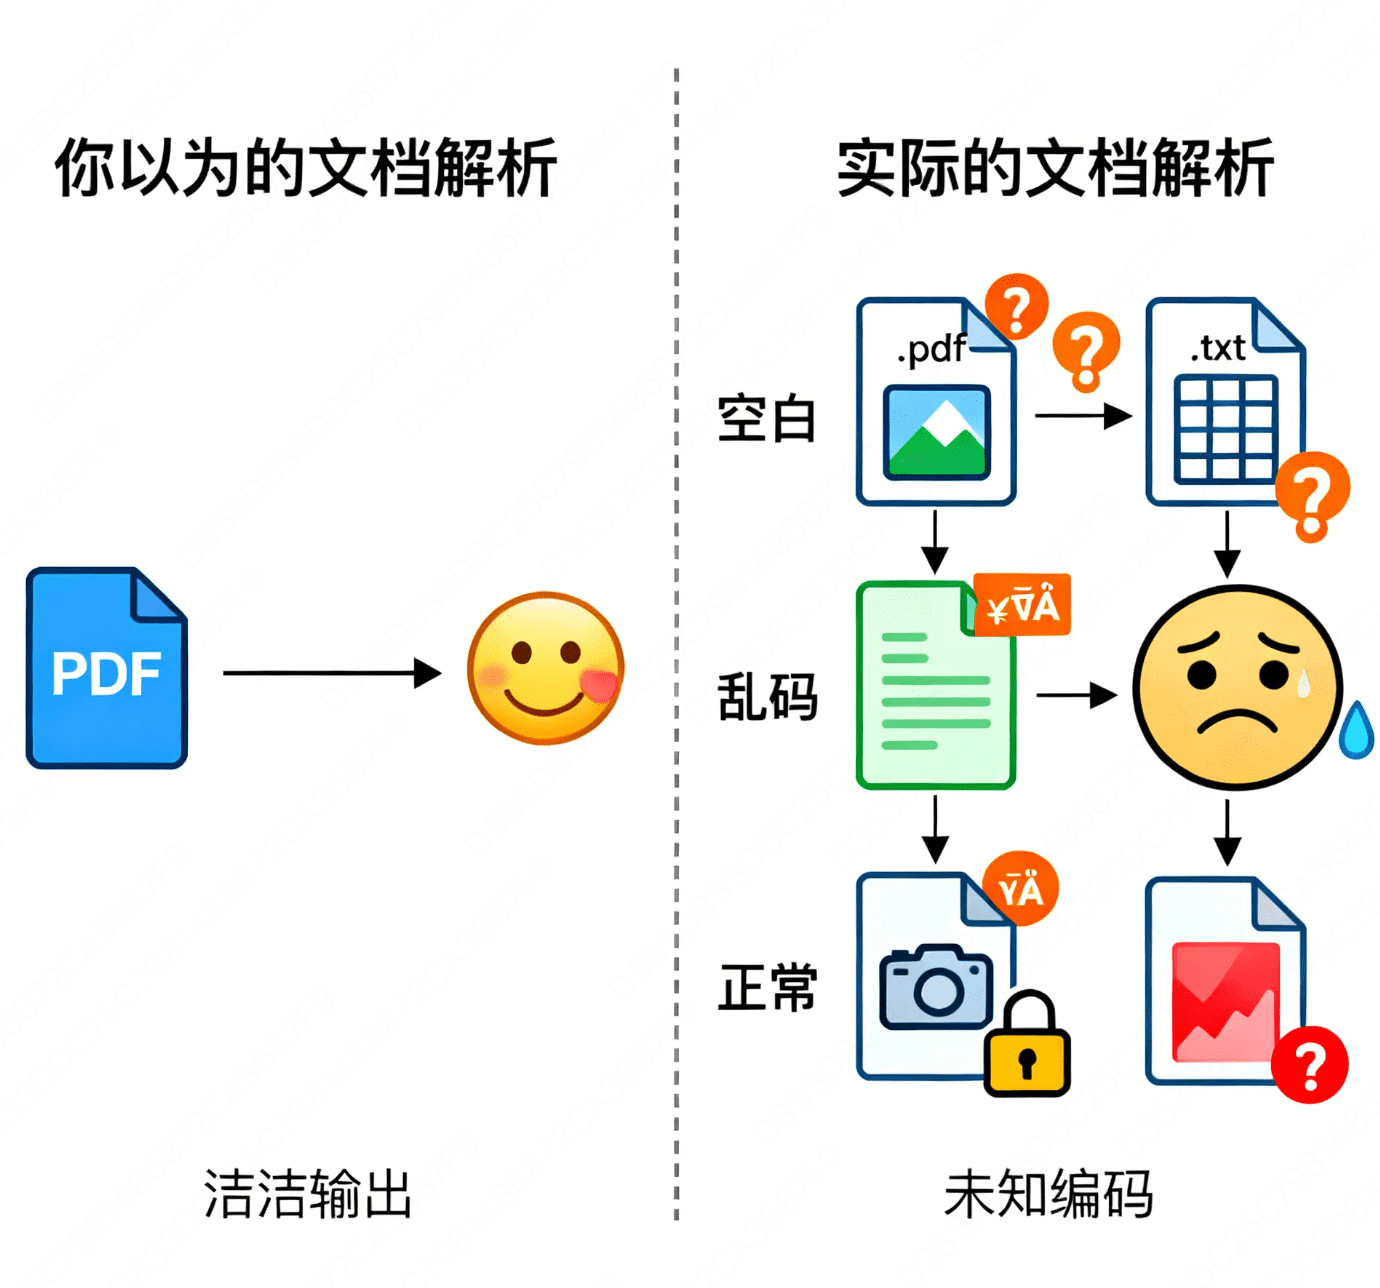
- 文字型PDF:内部存储结构化文本与字体信息,可直接提取;
- 扫描型PDF:本质为图像集合,需OCR介入;
- 混合型PDF:部分页面含文本,部分为图片,需智能判断。
更棘手的是,用户上传的文件常常存在后缀名与实际内容不符的情况。例如,将Excel文件重命名为.dat以绕过邮件限制,或将HTML内容保存为.pdf。若仅依赖文件扩展名进行解析,系统将在生产环境中频繁崩溃。
此外,编码问题在中文环境下尤为突出。GBK与UTF-8的误判会导致“锟斤拷”类乱码,而某些老旧系统生成的文档甚至内部混合多种编码,进一步加剧了解析难度。
Apache Tika:统一解析的工程选择
面对上述挑战,Apache Tika凭借其成熟的设计理念成为理想选择。作为Apache基金会维护的开源项目,Tika的核心价值在于提供统一接口处理超过1000种MIME类型,涵盖办公文档、电子书、邮件、音视频元数据等广泛格式。
其关键优势体现在四个方面:
- 基于内容的真实类型识别:不依赖不可靠的文件后缀;
- 自动化的解析器路由:屏蔽底层库(如PDFBox、POI)的复杂性;
- 结构化元数据提取:获取作者、创建时间、页数等关键属性;
- 可扩展的OCR集成能力:无缝对接Tesseract等光学识别引擎。
这些特性使其特别适合构建企业级知识管理系统的文档摄入层。
核心机制深度拆解
魔数检测:穿透表象看本质
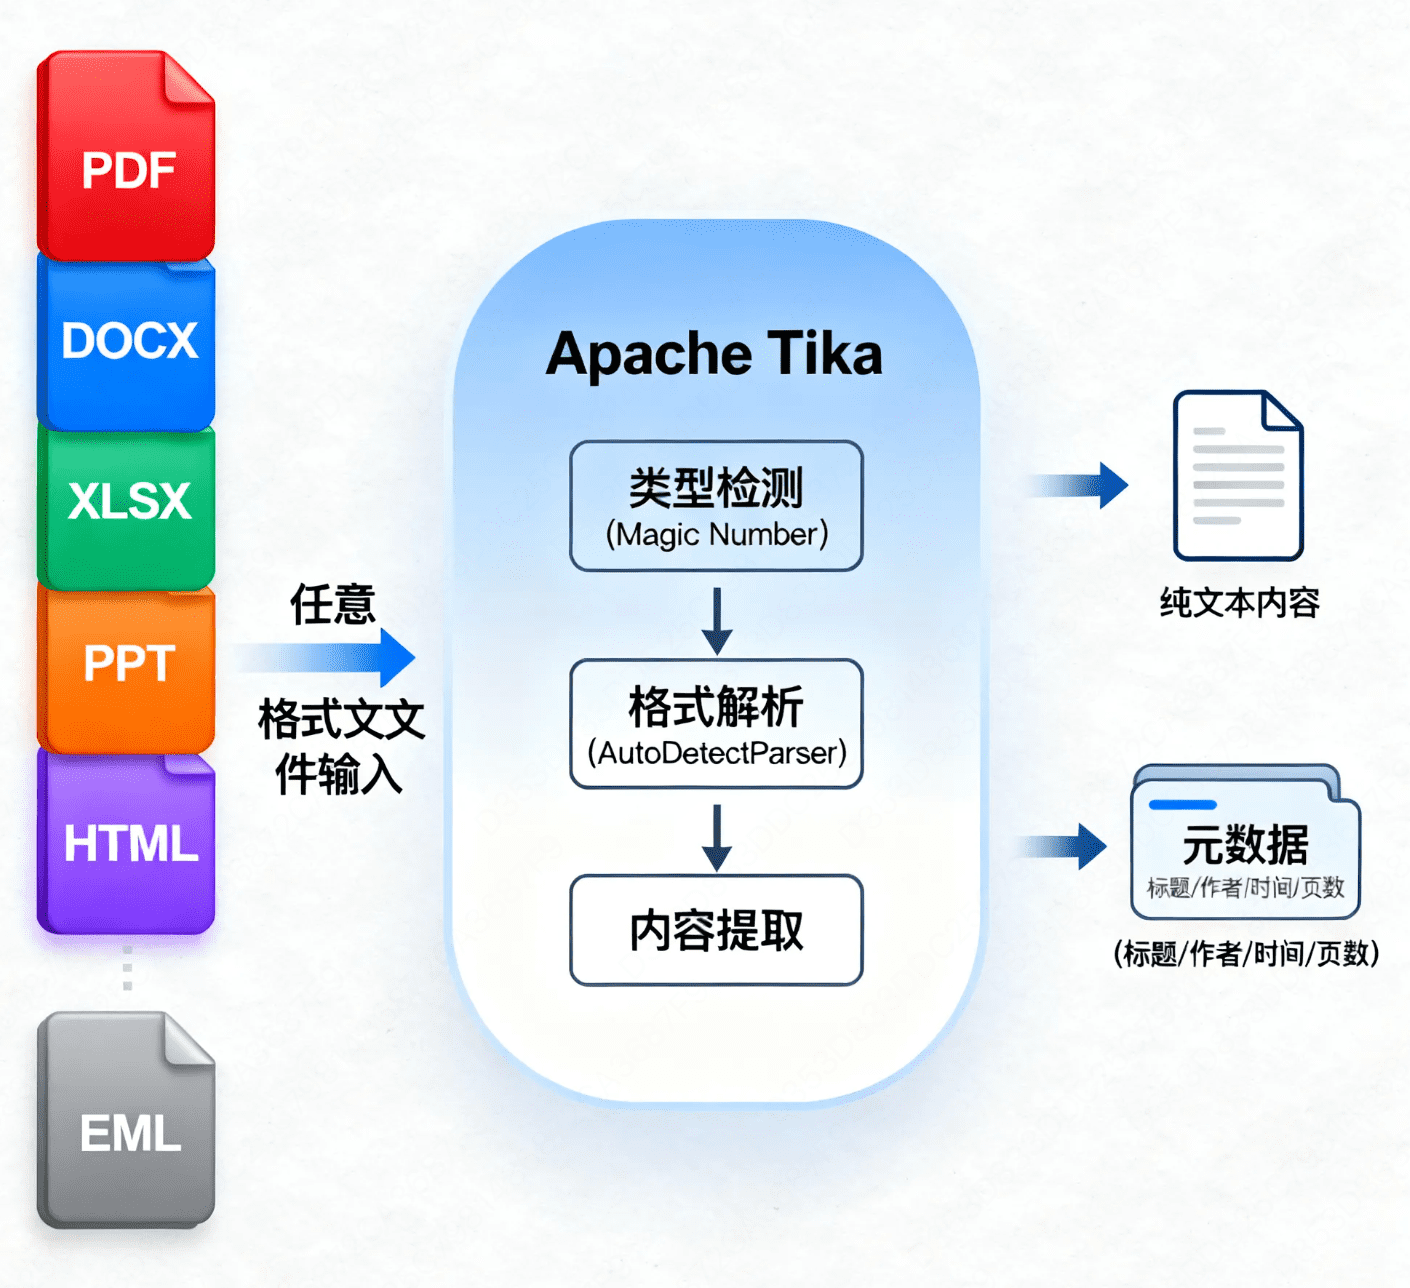
Tika识别文件类型的核心技术是魔数检测(Magic Number Detection)。几乎所有二进制格式都在文件头部预留了固定字节序列作为“签名”:
- PDF:
%PDF- - ZIP (含.docx/.xlsx):
PK\x03\x04 - PNG:
\x89PNG\r\n\x1a\n
Tika通过读取文件前若干字节并与内置签名库比对,从而确定真实MIME类型。这种方式彻底规避了后缀名欺骗问题,为后续正确解析奠定基础。
自动路由解析器架构
Tika内部采用AutoDetectParser实现智能分发。该组件首先调用类型检测模块,然后根据结果动态选择对应的专用解析器:
- PDF → PDFParser(基于PDFBox)
- DOCX → OOXMLParser(基于POI)
- HTML → HtmlParser
对上层应用而言,只需调用统一的parse()方法,无需关心底层实现细节。这种设计极大简化了多格式支持的开发复杂度。
元数据:被忽视的知识富矿
除正文文本外,Tika同步提取的元数据具有重要业务价值:
| 元字段 | 业务用途 |
|---|---|
dc:creator |
权限控制与知识溯源 |
dcterms:created |
时间维度筛选(如“近半年文档”) |
xmpTPg:NPages |
大文件预警与处理策略调整 |
dc:title |
检索结果展示优化 |
在知识图谱构建或精细化检索场景中,这些结构化信息往往比纯文本更具区分度。
OCR智能回退策略
Tika本身不包含OCR引擎,但通过OCRConfig提供标准扩展点。实践中建议采用两阶段策略:
- 优先尝试直接文本提取:速度快,准确率高;
- 结果为空或字符数异常少时触发OCR:针对扫描件进行补救。
需注意OCR处理速度通常比直接提取慢10-100倍,且对手写体、低分辨率图像效果有限。因此应在配置中明确限定OCR触发条件,避免不必要的性能损耗。
工程实现关键细节
依赖管理与瘦身策略
Tika的Maven依赖分为两个层级:
<!-- 核心检测与接口 -->
<dependency>
<groupId>org.apache.tika</groupId>
<artifactId>tika-core</artifactId>
<version>3.2.3</version>
</dependency>
<!-- 全格式解析器集合(传递依赖较重) -->
<dependency>
<groupId>org.apache.tika</groupId>
<artifactId>tika-parsers-standard-package</artifactId>
<version>3.2.3</version>
</dependency>若仅需处理PDF和Office文档,可替换为精简依赖:
<dependency>
<groupId>org.apache.tika</groupId>
<artifactId>tika-parser-pdf-module</artifactId>
<version>3.2.3</version>
</dependency>
<dependency>
<groupId>org.apache.tika</groupId>
<artifactId>tika-parser-microsoft-module</artifactId>
<version>3.2.3</version>
</dependency>此举可减少约60%的JAR体积,降低依赖冲突风险。
流处理与内存安全
文档解析服务必须考虑内存安全。关键措施包括:
- 文本长度限制:通过
BodyContentHandler(TEXT_LIMIT)设置上限(如10MB),防止超大文件导致OOM; - 流独立消费:类型检测与内容解析需分别获取InputStream,因
MultipartFile支持多次读取; - 临时文件缓存:对于网络流等单次读取源,应先写入临时文件再处理。
文本规范化处理
原始解析结果通常包含大量噪声:
- 表格导致的碎片化换行
- 多栏排版产生的交错文本
- 页眉页脚混入正文
建议实施标准化清洗:
private String normalize(String raw) {
return raw
.replaceAll("\\r\\n?", "\\n") // 统一换行符
.replaceAll("(?m)^[\\t ]+|[\\t ]+$", "") // 去除行首尾空白
.replaceAll("\\n{3,}", "\\n\\n") // 压缩多余空行
.replaceAll("[\\t ]+", " ") // 合并连续空白
.trim();
}清洗后的文本对下游分段(chunking)和向量化更为友好。
接口设计与错误处理
RESTful接口应明确区分成功与失败状态:
@PostMapping("/extract")
public ResponseEntity<DocumentExtractionResult> extract(
@RequestParam("file") MultipartFile file) {
DocumentExtractionResult result = extractor.extract(file);
return result.isSuccess()
? ResponseEntity.ok(result)
: ResponseEntity.unprocessableEntity().body(result);
}错误原因需具体化,如“内容为空(疑似扫描件)”、“文档结构异常”等,便于前端针对性处理。
部署模式选型指南
Tika提供两种集成方式,适用场景迥异:
嵌入式部署(Embedded)
适用场景:
- 文件量小(日均<1万份)
- 并发低(QPS<50)
- 对延迟敏感(需避免网络开销)
- 快速原型验证
风险点:
- 解析大文件时CPU/内存压力直接传导至业务进程
- 庞大的传递依赖易与项目现有库冲突
- OCR等重型操作可能阻塞主线程
独立服务部署(Standalone)
通过Docker运行Tika Server:
docker run -p 9998:9998 apache/tika:3.2.3适用场景:
- 批量文档入库
- 多语言/多服务共享解析能力
- 需要资源隔离保障主业务稳定性
- 复杂OCR环境统一管理
优势:
- 解析失败不影响核心业务
- 可独立扩缩容
- 环境一致性高
建议演进路径:初期采用嵌入式快速验证,当单日处理量超过5万份或出现稳定性问题时,平滑迁移至独立服务。
典型问题排查清单
在真实项目中,以下问题高频出现:
解析结果为空
- 根因:扫描件未配置OCR / 文档加密
- 方案:检查MIME子类型(如
application/pdf; type=scan),部署Tesseract并配置ocrStrategy=ocr_only
中文乱码(锟斤拷)
- 根因:编码检测失败
- 方案:确保使用Tika 2.0+版本(改进编码检测算法),避免手动指定编码
表格结构破坏
- 根因:默认解析器丢失布局信息
- 方案:对关键表格文档,改用Apache POI原生API处理
解析超时
- 根因:嵌套OLE对象过深 / 文件损坏
- 方案:设置全局超时(如30秒),超时文件转入人工审核队列
页眉页脚污染
- 根因:解析器全量提取
- 方案:自定义
ContentHandler过滤特定区域文本
构建可靠文档管道的思考
文档解析虽处技术链路前端,却是决定RAG系统效果的基石。一个高质量的解析引擎应具备:
- 格式鲁棒性:覆盖主流办公文档及历史遗留格式
- 内容完整性:最大限度保留原始语义(尤其表格、公式)
- 元数据丰富性:提供结构化上下文信息
- 异常可追溯:详细记录失败原因便于修复
Apache Tika在通用场景下表现卓越,但对于专业领域文档(如法律合同、医疗报告),往往需结合领域特定解析器。建议采用“Tika为主,专用工具为辅”的混合架构:
- 用Tika处理80%常规文档
- 对关键格式(如复杂表格)路由至专用解析器
- 扫描件统一经OCR流水线处理
这种分层策略既保证了开发效率,又兼顾了特殊场景的精度需求。在AI时代,文档解析已不仅是技术问题,更是知识资产数字化的第一道质量关卡。