LLaDA-Image:先用纯图预训练,再对齐语言的文生图新路线
先画后听:一条不一样的文生图训练路径
传统文生图模型通常从训练第一天起就绑定图片与文字说明(caption),要求大量高质量图文对作为“入场券”。但 LLaDA-Image 提出了另一种可能:先让模型从纯图片中学会“画”,再让它通过图文对学会“听话”。
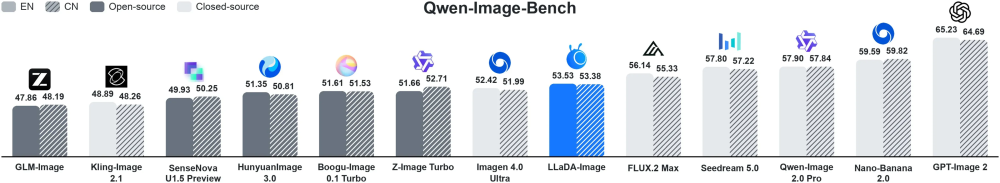
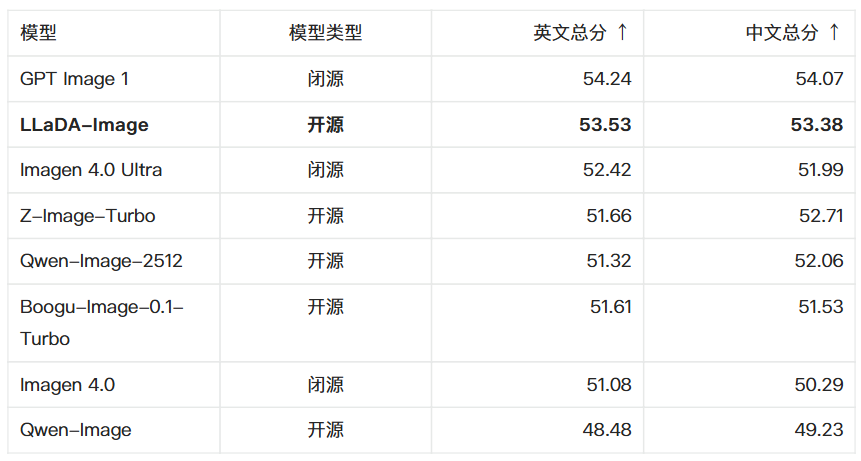
这一思路的核心在于分工——早期阶段用海量真实图像建立视觉生成先验,后期再集中使用经过严格校验的图文对完成语言对齐。最终,这个 6B 参数的 Diffusion Transformer(DiT)在 Qwen-Image-Bench 的英文和中文综合评分中分别达到 53.53 和 53.38,在报告列出的所有开源模型中拿下双榜第一。
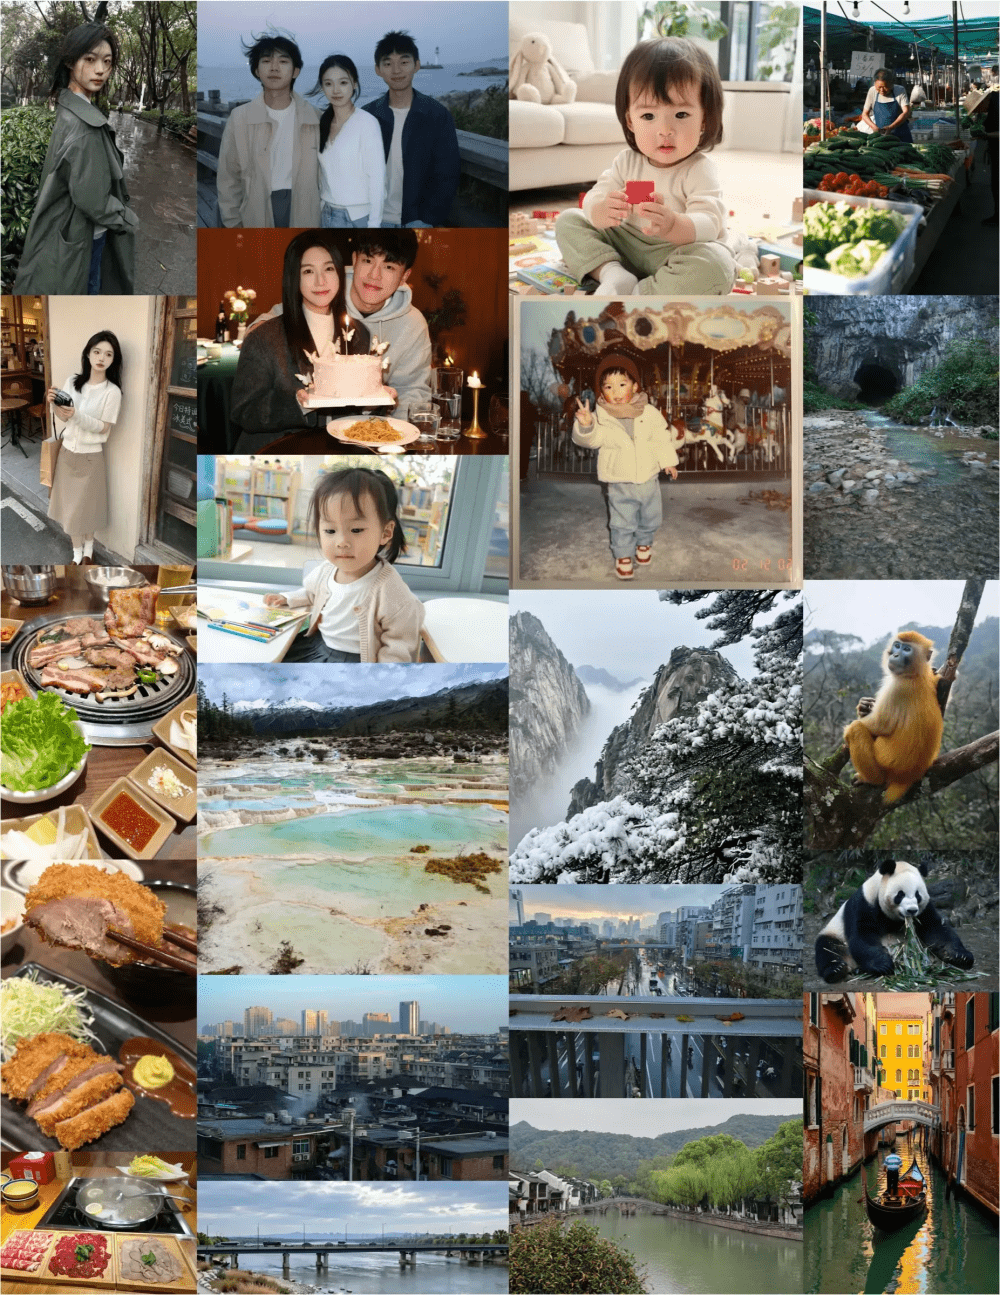
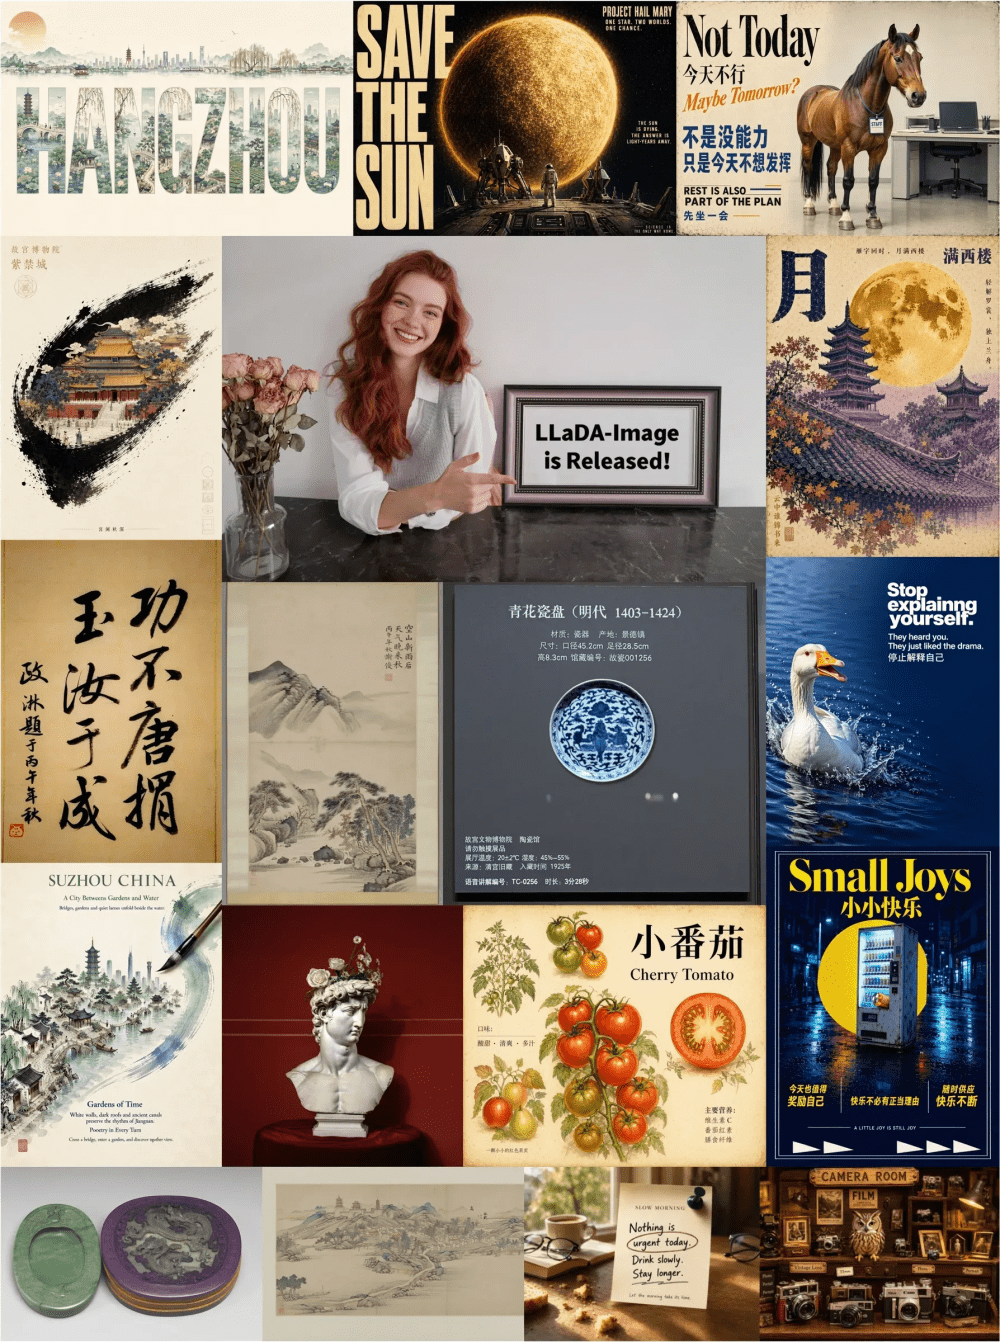
更直观的是它的生成效果:从林间抓拍、家庭合影、街边市场,到雪山、洞穴、中式园林,甚至包含中英文排版的海报和广告——所有画面均由同一模型生成,没有一张是真实照片。
九成训练样本不带文字
LLaDA-Image 的生成训练累计处理约 2.2 亿个样本,其中超过 90% 来自纯图片监督。这意味着在预训练和中期训练阶段,模型并不依赖任何文本描述,而是直接从图像自身提取条件信号。

具体做法是:给定一张训练图,系统先用冻结的 SigLIP-VQ 视觉编码器将其转为图像 token,再随机遮盖一部分。剩下的稀疏 token 与一条固定辅助指令一起输入冻结的多模态理解模型(LLaDA2.0-mini),形成 DiT 的条件;而完整图像的 VAE 潜变量则作为生成目标。

换句话说,图片自己既是“题目”也是“答案”。模型的任务是从局部视觉线索恢复整张图像,从而学习物体结构、上下文关系和视觉组成规律。由于条件直接来自裁剪区域,团队能在低分辨率(如 256×256)训练中保留更多细节,避免因缩放丢失信息。
到了中期训练,像素预算提升,模型开始在多宽高比桶上继续纯图训练,逐步适应更高分辨率和不同画幅。直到这一阶段完成后,才引入图文对进行文本对齐和高分辨率迁移。
图文对被用在更合适的位置

传统方法常在早期就将 caption 作为生成条件,但这对数据质量要求极高——需要详细描述、幻觉检测、文字转录校验和图文一致性过滤。而 LLaDA-Image 把这些高成本操作推迟到 SFT(监督微调)阶段。
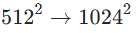
此时,团队使用 Qwen3.6-35B-A3B 和 Qwen3-VL-235B-A22B-Instruct 为图像生成描述,并进一步校验物体、属性、关系及文字内容。高质量配对资源因此被集中用于语言对齐,而非分散在吞吐量最大的视觉学习阶段。

这种分工让两类数据各司其职:原始图像保留材质、光影、小物体等完整视觉信息;文本描述则负责将自然语言概念接入已形成的视觉空间。技术报告明确指出:“纯图片负责建立视觉世界,图文对负责把语言接入这个世界。”
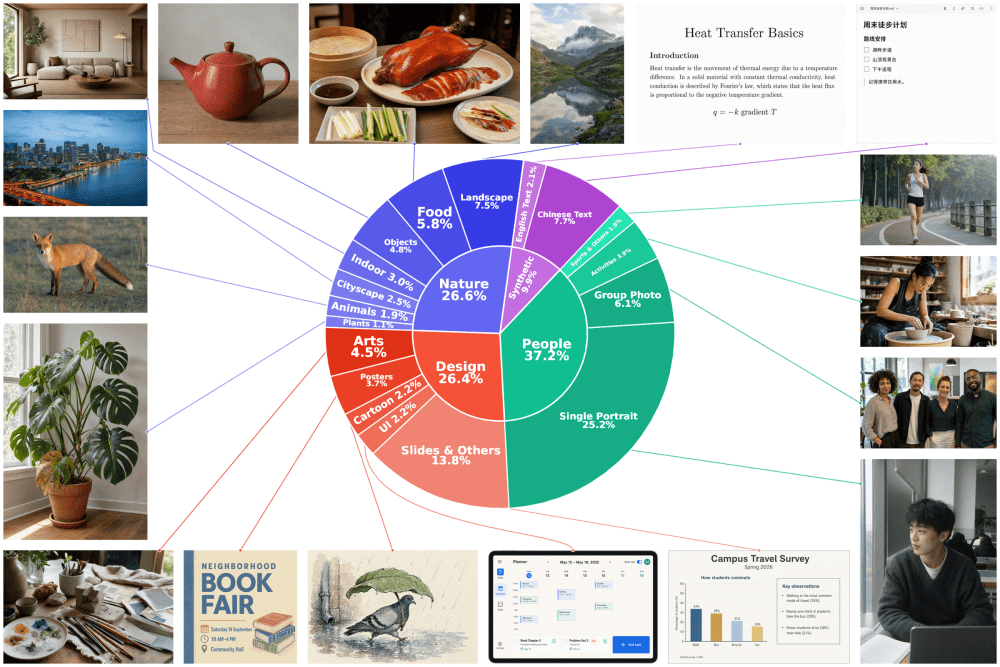
SFT 阶段的数据分布也反映了这一策略:真实图像占绝对多数,仅在后期定向增加文字密集图像和人像数据,以强化特定能力。
一个模型,同时做生成和编辑
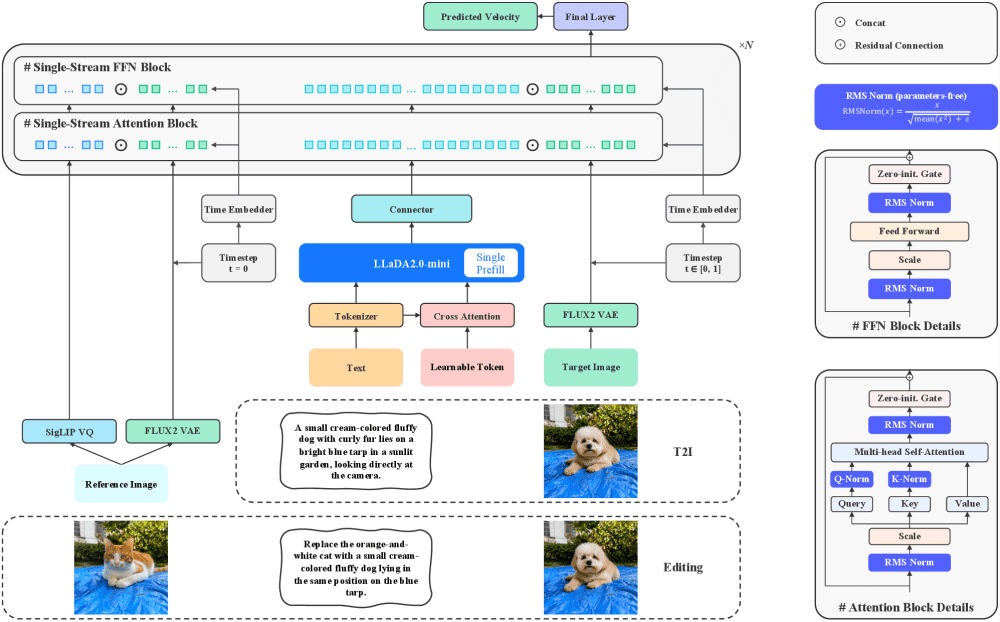
LLaDA-Image 的架构分为三部分:理解模块(基于 LLaDA2.0-mini 扩散语言模型)、轻量接口(RQA + Connector)和生成主干(单流 DiT)。
理解模块不只是将提示词转为静态嵌入,而是作为统一的多模态语义接口,处理文本、视觉条件和结构化推理信息。RQA(Residual Query Adapter)在理解模型前插入可学习查询,通过交叉注意力提取与生成最相关的信息;Connector 再将隐藏状态投影到 DiT 所需的条件空间。
生成部分采用纯单流 DiT,文本条件 token、时间信息和图像 token 在同一组 Transformer 层中直接交互,最终预测 Flow Matching 速度场。
对于指令图像编辑任务,参考图走的是独立通道:完全绕过语言模型。它同时提供两类信号——SigLIP-VQ 特征用于高层语义识别(“是什么”),干净的 FLUX2-VAE 潜变量则提供像素级证据(保留身份、结构、纹理)。两者共同进入 DiT,使一套权重能同时处理开放式生成和参考保持编辑。
训练时,文生图(T2I)和图像编辑(I2I)以 1:1 混合。文生图样本在此充当“能力回放”,持续巩固画质和文本对齐能力,确保生成与编辑在共享主干上协同演进。
工程细节:稳定长训的关键改动
训练一个 6B 参数 DiT 需要极高的稳定性。团队在监控中发现,常规 LayerNorm 或 RMSNorm 中的可学习仿射参数会在深层网络和长周期训练中累积尺度漂移,导致后期梯度范数(gradient norm)快速上升。
为此,LLaDA-Image 在整个 DiT 中统一采用无可学习参数的 RMSNorm。这一看似微小的改动,有效维持了特征尺度的一致性,成为支撑长程训练的基础。
优化器方面,所有生成阶段均使用 Muon。训练计划本身也是渐进式的:从纯图预训练、多宽高比中期训练,到文本对齐、高分辨率迁移、定向增强,再到生成—编辑联合训练。进入 SFT 后,时间步采样还向高噪声区域倾斜——因为早期去噪决定了整体结构,误差更容易沿轨迹累积。
临近收敛时,团队合并相邻 checkpoint 的权重,以平滑不同 mini-batch 数据构成带来的指标波动。
从 50 步到 2–4 步:TwinFlow 蒸馏
基础版 LLaDA-Image 采用 50 步采样,追求完整生成质量。部署时,团队通过 TwinFlow 将其蒸馏为 LLaDA-Image-Turbo,推理仅需 2–4 步。
TwinFlow 基于分布匹配蒸馏(DMD),但做了关键创新:同一个 DiT 主干承担“正负两班制”。正时间(t > 0)负责生成,负时间(t < 0)负责跟踪学生分布。两者共享主干,使用两个输出头,训练时以 1:2 比例交替更新。
推理阶段只保留生成头,fake-score 头完成使命后退出,部署开销与单头模型一致。在 Qwen-Image-Bench 上,Turbo 版的 4 步评测得分达 50.98(英文)和 50.27(中文),形成质量与速度互补的双档位。
全面开源:不止模型权重
除了模型本身,Inclusion AI 还同步开放了完整的训练链条,覆盖五个关键环节:
- 模型权重:包括基础版、Turbo 版及其 FP8 版本,适配不同部署场景;
- 训练与推理代码:核心实现全部公开;
- 纯图片训练配方:含图片筛选、低分辨率预训练和多宽高比中期训练;
- 统一生成—编辑配方:包括文本对齐、高分辨率迁移及 T2I/I2I 1:1 混合训练;
- TwinFlow 蒸馏方案:公开从 50 步到 2–4 步的压缩路径。
这里的 6B 参数指核心 DiT,完整系统还包括冻结的 LLaDA2.0-mini 理解骨干、视觉编码器、VAE、RQA 和 Connector。模块边界和各阶段配方一并给出,便于研究者复用其中任意组件。
实测表现:不止综合得分高
在 Qwen-Image-Bench 上,LLaDA-Image 不仅总分领先,还在质量、美学和提示词对齐三个分项上均居开源模型首位。若将闭源模型纳入比较,其成绩介于 GPT Image 1 与 Imagen 4.0 Ultra 之间。
文字渲染能力同样突出:在 LongText-Bench 上,中英文得分分别为 0.923 和 0.913;在 CVTG-2K(含广告、海报、街景等多文字区域)上,单词准确率达 0.875,归一化编辑距离(NED)为 0.945。
指令编辑方面,在 GEdit-Bench 上的中英文总分分别为 7.336 和 7.294,验证了统一模型同时处理双语文生图与编辑的能力。
传统诊断基准也显示优势:GenEval 总分 0.85(单/双物体得分 1.00/0.98),DPG-Bench 总分 87.48。计数能力(0.53)是当前短板,也是后续优化方向。
推理支持与未来方向
项目发布当天,SGLang 社区完成了 Day-0 推理适配,支持少步采样、序列并行和 FP8 推理。用户可通过兼容 OpenAI Images API 的接口部署 Base、Turbo 及 FP8 版本,同时支持文生图和图像编辑。
下一步,团队计划扩展世界知识、提升长文本与多区域排版稳定性,并推进原生 2K 生成。而对社区而言,这套开放框架已为探索“视觉优先”的生成路线提供了清晰接口。
当图文对不再是预训练的入场券,纯图片也就从“等待配上文字的数据”,变成了视觉生成预训练的主角。LLaDA-Image 用实践证明:先学会画,再学会听话,这条路走得通。