用 Codex 搭建一个简易 RAG 知识库:从原理到客服智能体实战
为什么要做一个“简陋”的 RAG?
现在提到 RAG(检索增强生成),很多人第一反应是:得有向量数据库、得调 Embedding 模型、还得接一个大语言模型 API。这套组合拳确实强大,但对初学者或只想快速验证想法的人来说,门槛太高了。
其实,RAG 的核心思想很简单:用户提问 → 系统从你给的资料里找相关内容 → 基于找到的内容回答问题。这个“找”的过程,不一定非要用复杂的向量相似度计算。在很多场景下,简单的关键词匹配已经能解决大部分问题。
本文就用 Codex 来实现这样一个“简陋”但完整的 RAG 系统。它没有 fancy 的技术栈,只有几个 .txt 文件、一段 Express 代码和一个 HTML 页面。目标很明确:让你亲手跑通一遍 RAG 的完整流程,理解它的骨架长什么样。

第一步:让 Codex 生成项目骨架

我们先给 Codex 下一个非常具体的指令,要求它创建一个教学用的 RAG 演示项目。关键点在于“简单”和“清晰”,所以明确排除了数据库、向量库和外部 API。
请帮我创建一个最基础的RAG知识库演示项目。项目目标:用于教学演示,让用户理解RAG的基本原理:用户提问后,系统先从本地知识库中查找相关内容,再根据查到的内容进行回复。技术要求:1、使用 Node.js + Express;2、创建一个knowledge.txt 文件作为本地知识库;3、创建一个POST /ask接口;4、用户提交问题后,后端读取knowledge.txt;5、使用简单关键词匹配,从knowledge.txt 中查找相关内容;6、如果找到相关内容,就返回基于知识库的回答;7、如果找不到相关内容,就返回:知识库中暂时没有找到相关答案,建议转人工客服处理;8、不需要前端页面;9、不需要数据库;10、不需要向量数据库;11、不需要真实 AI API;12、代码要简单,注释要清楚,适合新手学习。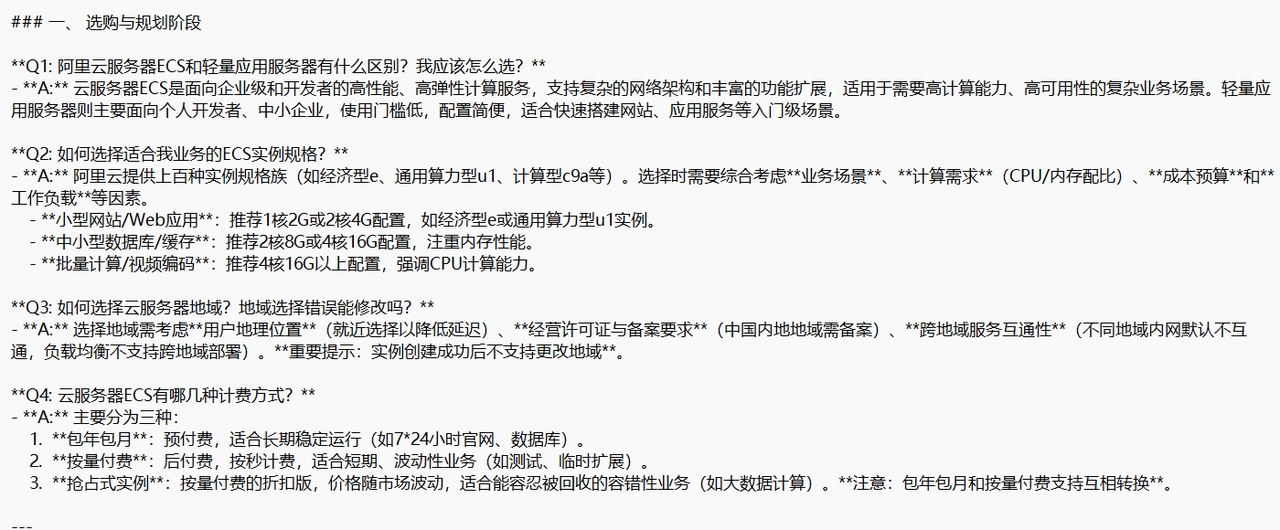
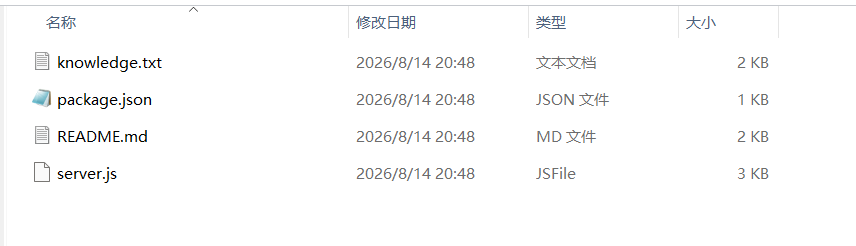
Codex 接收指令后,会自动生成一个名为 basic-rag-demo 的文件夹,里面包含四个文件:
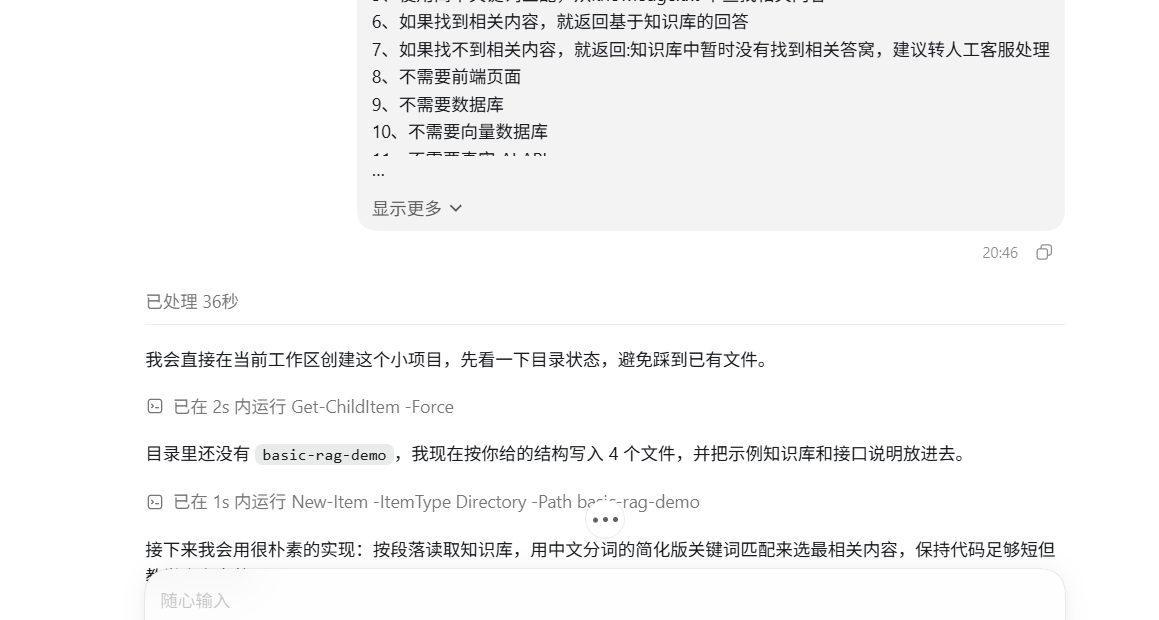
package.json:定义了项目依赖,主要是express。server.js:核心逻辑所在,处理/ask请求,读取文件,执行关键词匹配。knowledge.txt:空的知识库文件,等待我们填入内容。README.md:说明如何安装依赖和启动服务。
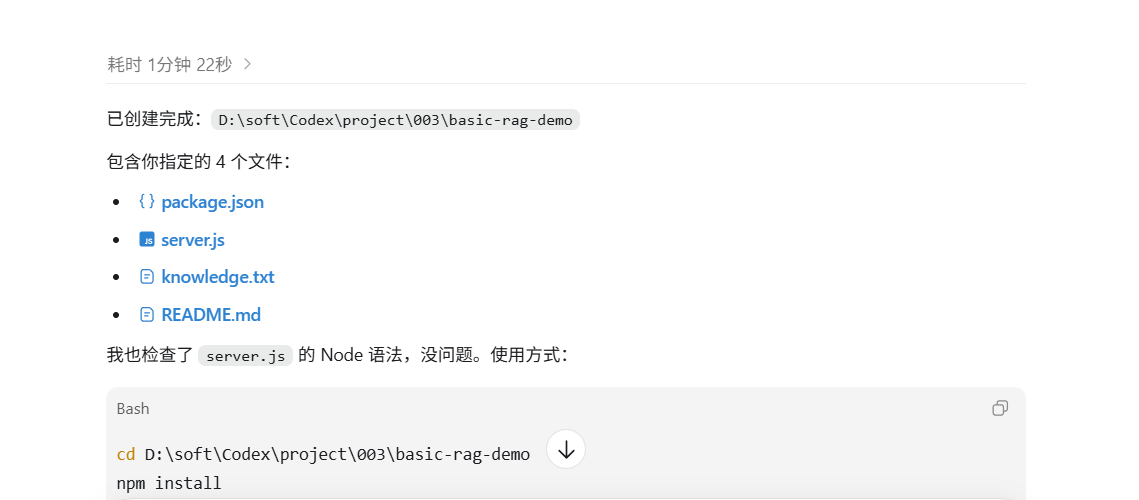
这个 server.js 的逻辑非常直白。它会把用户的问题拆分成关键词(比如去掉“的”、“是”等停用词),然后去 knowledge.txt 里逐行扫描,看哪一行包含最多的关键词。如果命中,就把那一整段内容作为答案返回。
第二步:喂入真实的业务知识
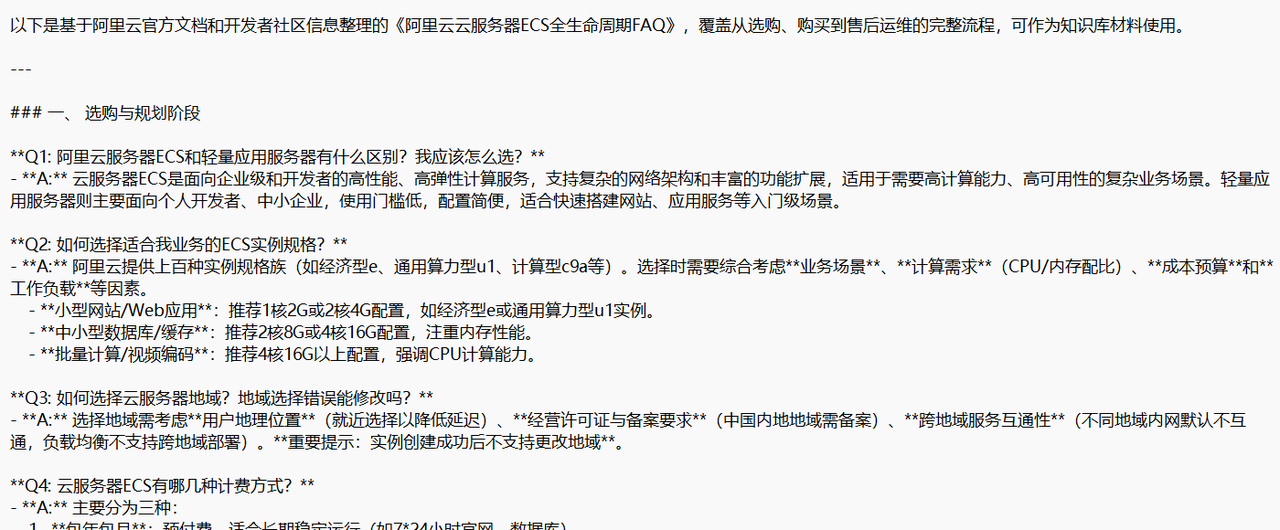
光有框架没用,得有料。假设我们是一家云服务器厂商,需要一个能回答常见问题的客服。我们准备了一份关于服务器选购、计费和售后的 FAQ 文档。
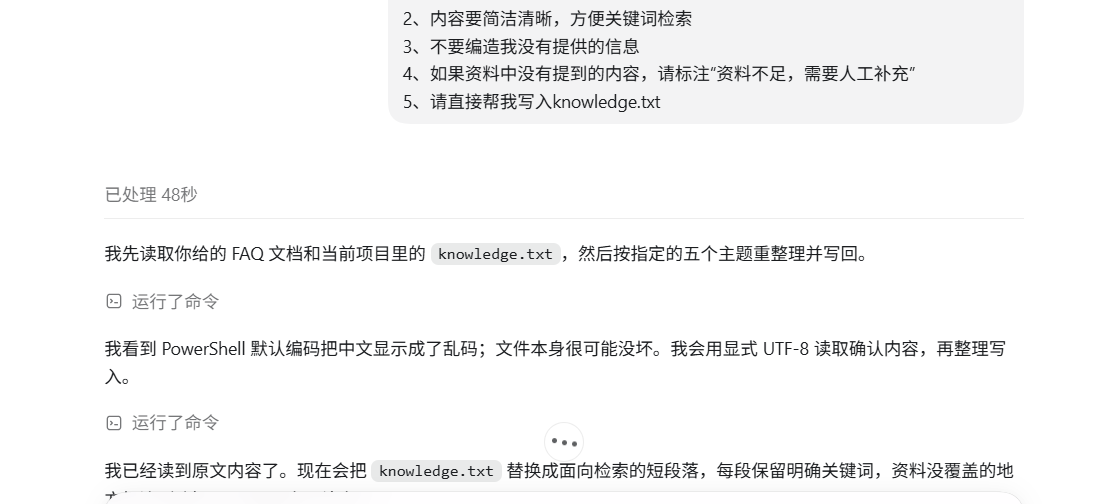
接下来,我们告诉 Codex 如何整理这份原始材料:
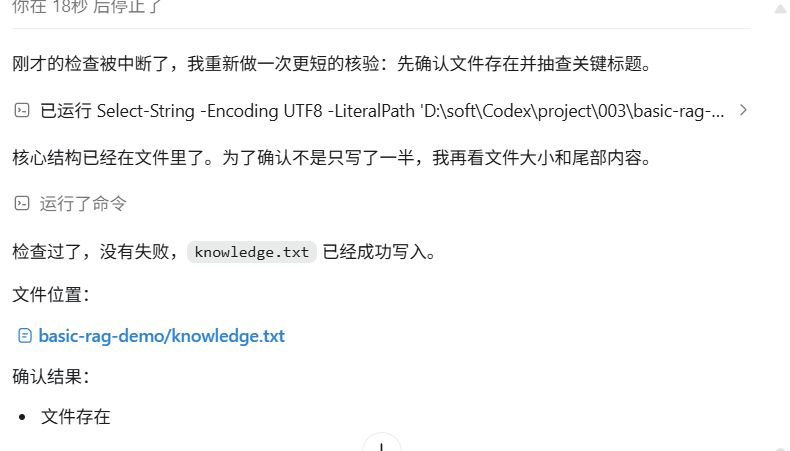
请帮我把这个文档里的资料整理成适合 RAG知识库使用的knowledge.txt 内容。要求:1、按照以下结构整理: -- 服务器选购流程 -- 计费方式 -- 下单流程 -- 配置过程 -- 售后流程;2、内容要简洁清晰,方便关键词检索;3、不要编造我没有提供的信息;4、如果资料中没有提到的内容,请标注“资料不足,需要人工补充”;5、请直接帮我写入knowledge.txt。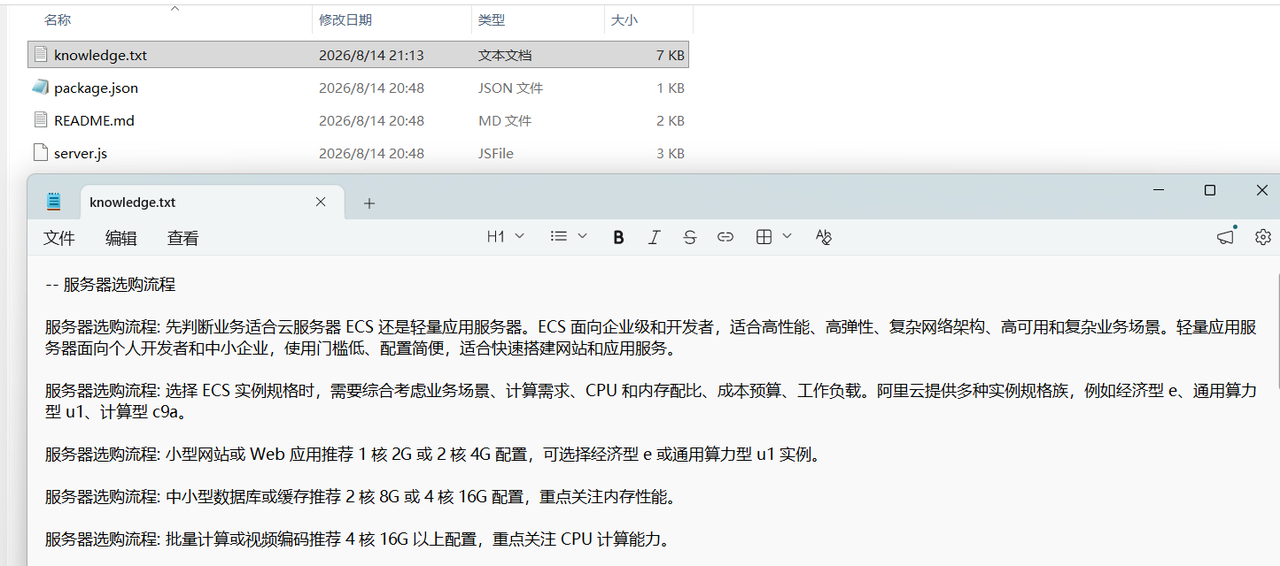
Codex 会仔细阅读你提供的原始文档,按要求的结构重新组织语言,并写入 knowledge.txt。例如,关于计费方式的部分可能会被整理成:
-- 计费方式
阿里云服务器提供包年包月和按量付费两种计费模式。包年包月适合长期稳定使用的业务,价格更优惠。按量付费按秒计费,适合短期或流量波动大的业务。带宽可以选择按固定带宽或按使用流量计费。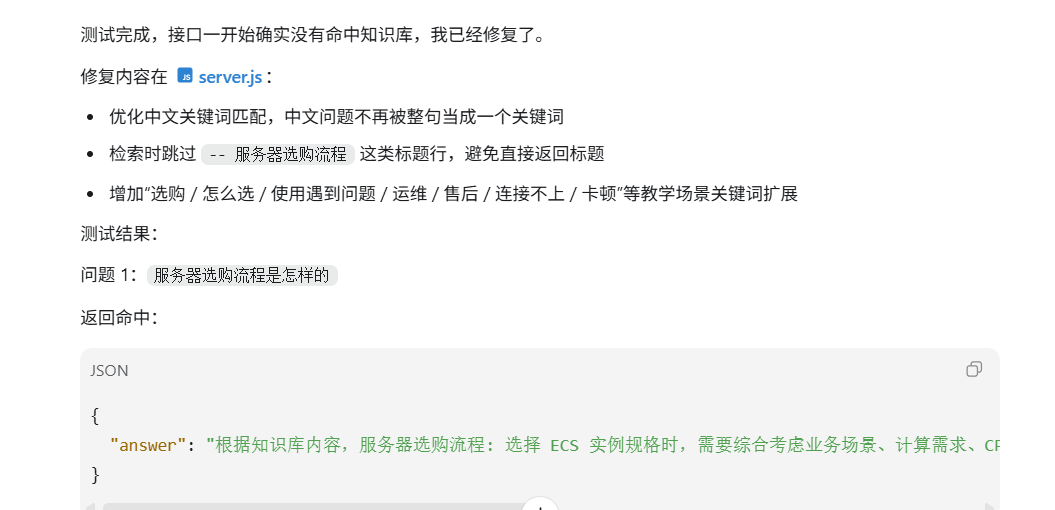
这种结构化的纯文本,对后续的关键词匹配非常友好。
第三步:测试与验证
知识库填好了,得看看它能不能正常工作。我们再次给 Codex 下指令,让它帮我们完成测试:
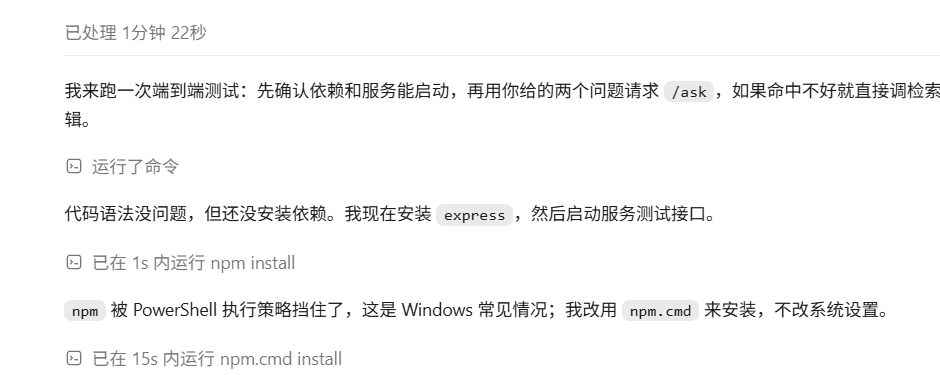
请帮我测试当前 RAG 项目。要求:1、启动项目;2、测试 POST /ask 接口;3、分别测试以下问题: -- 服务器选购流程是怎样的 -- 服务器使用遇到问题怎么办;4、检查返回结果是否正确;5、如果接口报错,请帮我修复;6、如果知识库没有命中,请帮我优化关键词匹配逻辑。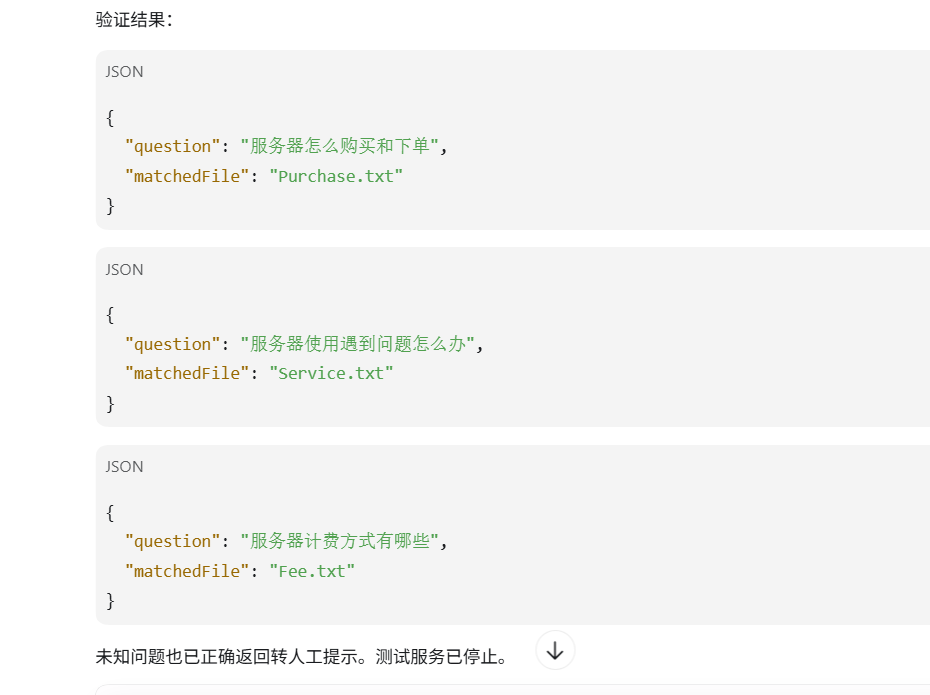
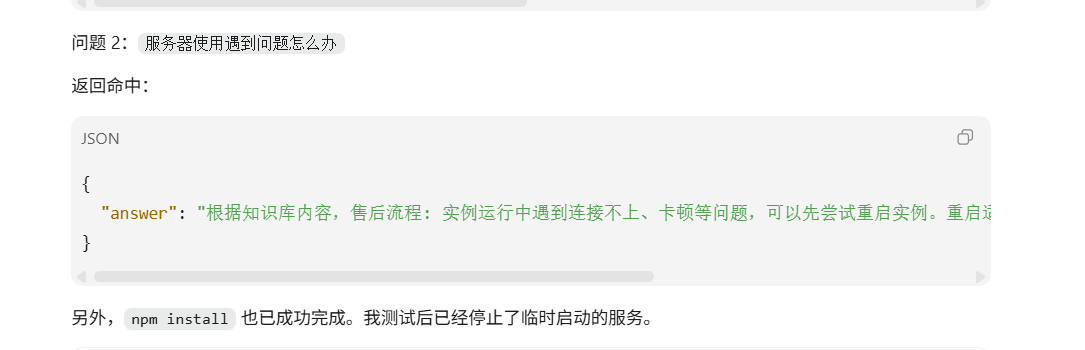
Codex 会自动执行 npm install 安装依赖,然后启动服务。接着,它会模拟发送两个 POST 请求。
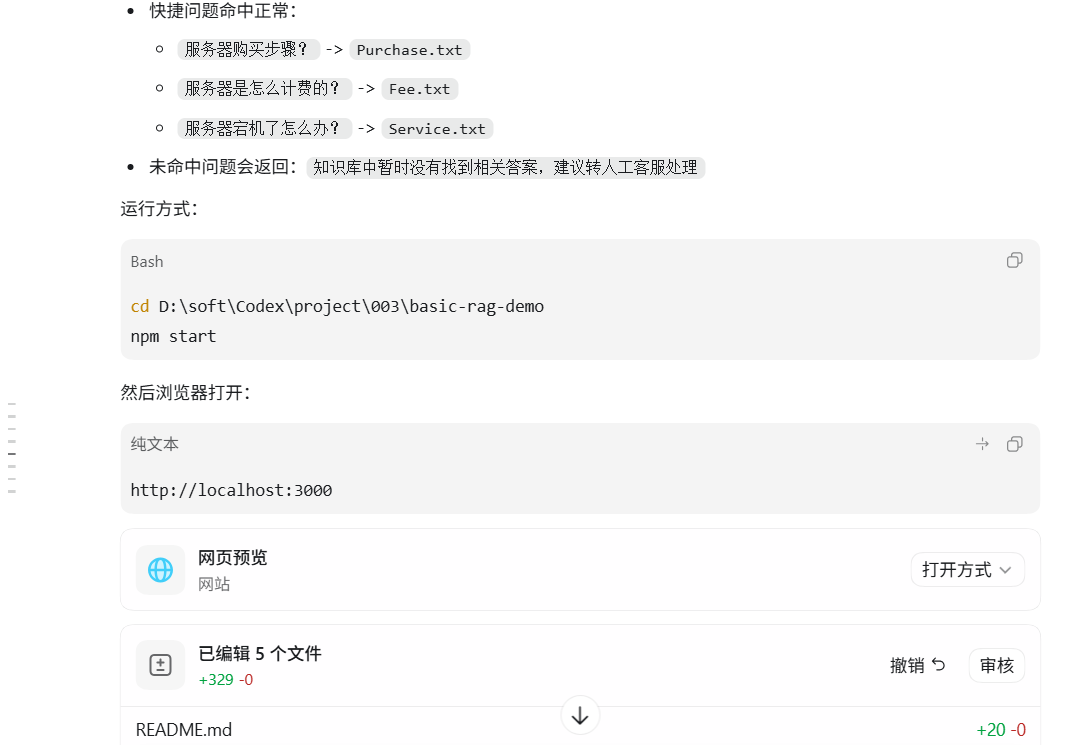
- 当问“服务器选购流程是怎样的”时,系统成功从
knowledge.txt中找到了对应的段落并返回。 - 当问一个知识库里没有的问题,比如“你们支持量子计算吗?”,系统则正确地返回了“知识库中暂时没有找到相关答案,建议转人工客服处理”。
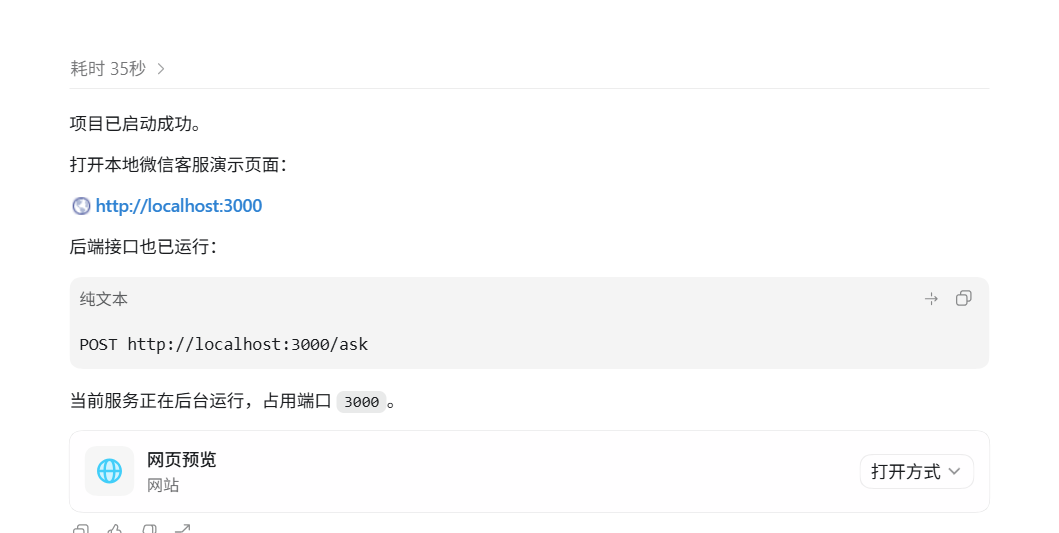
在这个过程中,Codex 甚至发现原始的关键词匹配逻辑对“使用”和“售后”这类近义词区分不够好,于是主动优化了匹配算法,增加了同义词映射,让检索更鲁棒。
第四步:从单文件到多文件知识库
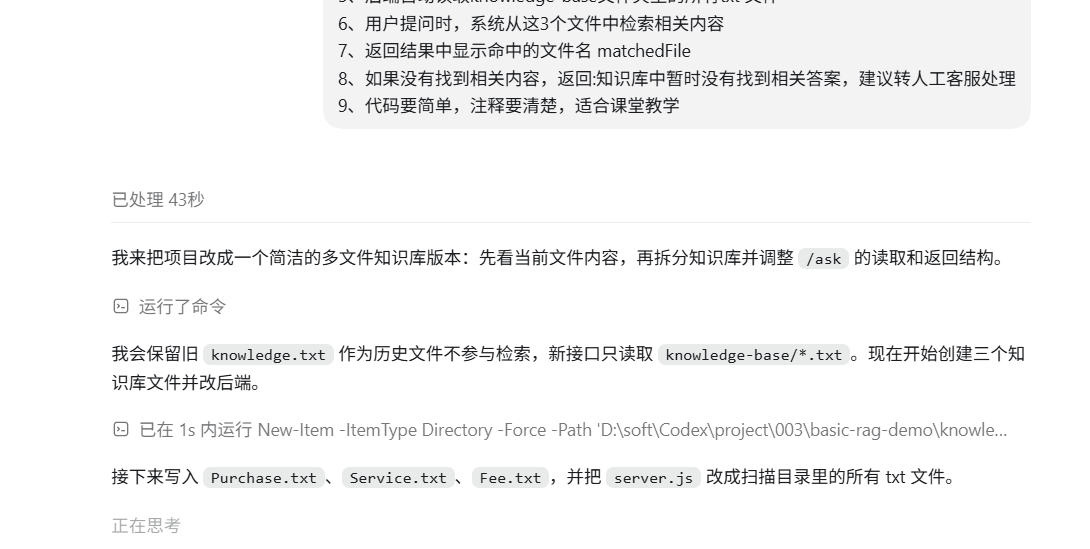
随着业务增长,所有知识都塞在一个 knowledge.txt 里会变得难以维护。是时候升级了。我们决定按业务模块拆分成三个文件:
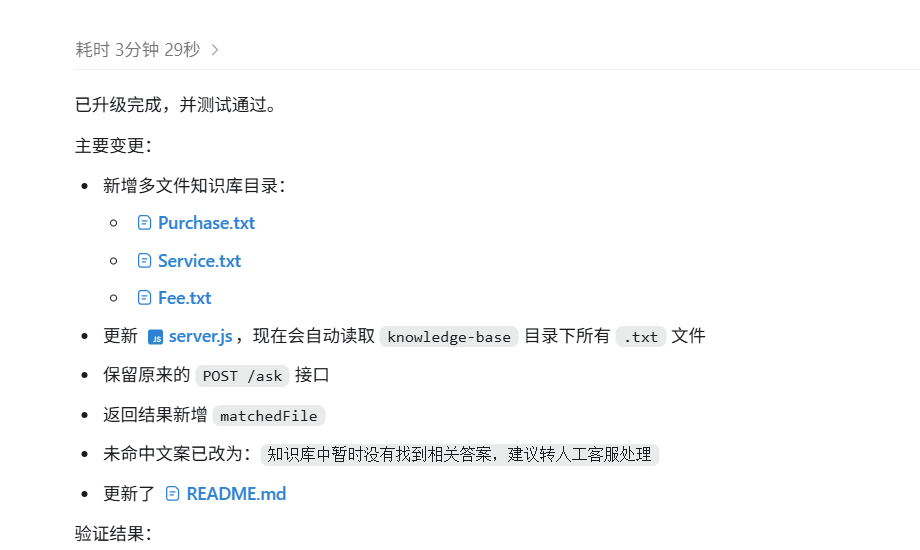
Purchase.txt:存放购买相关的内容。Fee.txt:存放计费相关的内容。Service.txt:存放售后相关的内容。
我们把新需求告诉 Codex:
请帮我把当前 RAG 项目从单个knowledge.txt升级为简单的多文件知识库。不要拆得太细,只需要拆成3个文件: knowledge-base/|-- Purchase.txt |-- Service.txt |-- Fee.txt ...(省略其他要求)Codex 修改了 server.js 的逻辑,让它不再只读一个文件,而是遍历 knowledge-base 目录下的所有 .txt 文件。当找到答案时,还会在返回结果里注明命中的文件名(比如 matchedFile: "Service.txt"),方便后续追踪和调试。
第五步:加上一个“客服”界面
最后一步,为了让整个系统看起来像个产品,我们给它加一个前端界面。目标是模拟一个微信客服的聊天窗口。
指令如下:
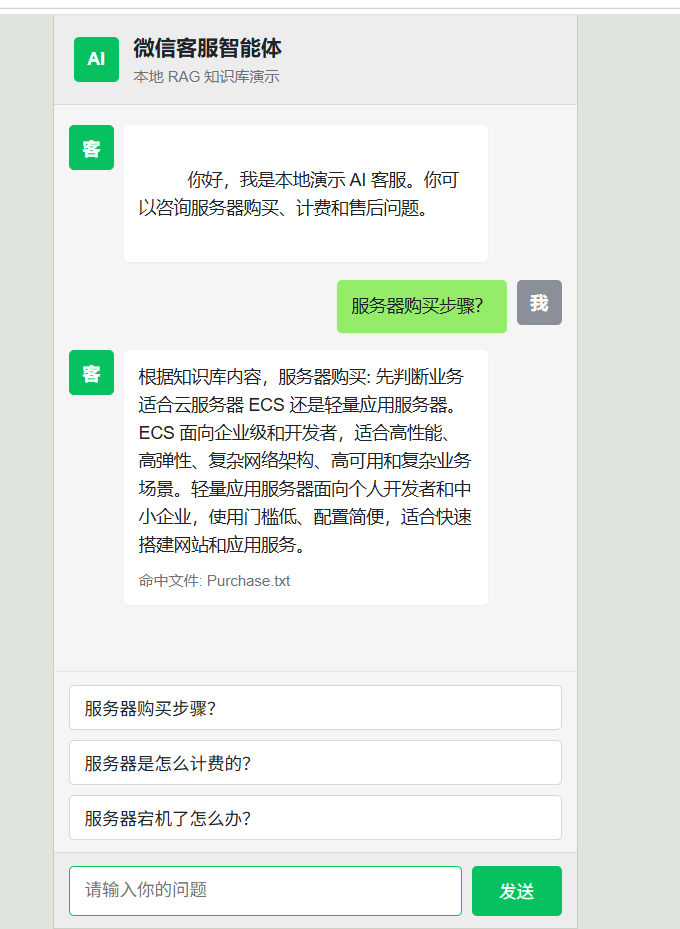
请帮我在当前RAG知识库项目基础上,增加一个“微信客服智能体本地演示页面”...(省略详细要求)Codex 创建了 public 目录,并在里面生成了 index.html、style.css 和 script.js。页面布局很简单:顶部是聊天记录区域,底部是输入框和发送按钮,旁边还有几个快捷问题按钮,比如“服务器是怎么计费的?”。
当你点击发送或按下回车,前端 JavaScript 会向后端的 /ask 接口发起请求。收到答案后,页面会动态生成一个气泡,把 AI 的回复显示在左侧。如果你问了一个知识库无法回答的问题,页面会显示一个醒目的“转人工客服”提示。
至此,一个麻雀虽小、五脏俱全的 RAG 客服智能体就完成了。它虽然简单,但完整地走通了从知识管理、后端服务到前端交互的全部链路。
总结
这个项目的价值不在于它有多先进,而在于它足够透明。你可以打开任何一个文件,看懂每一行代码在做什么。这种“可理解性”是学习复杂概念最好的起点。
Codex 在这个过程中扮演的角色,更像是一个高效的执行者。你负责思考架构和提出需求,它负责把想法变成可运行的代码,并在过程中帮你发现和修复一些细节问题。这种人机协作的模式,或许就是未来开发者工作的常态。