openJiuwen 在 WorkSwarm 上落地 RSI 框架,支持 Harness 与科研产物双维度自我优化
智能体不能只靠人调:让失败自己变成改进动力
现在让一个智能体跑通某个任务已经不算稀奇。但一旦失败,往往还得人来擦屁股:翻日志、改提示词、加工具、再测试。这种“交付即定型”的模式,调优成本高、周期长,而且每次的经验都散落在各处,没法沉淀复用。
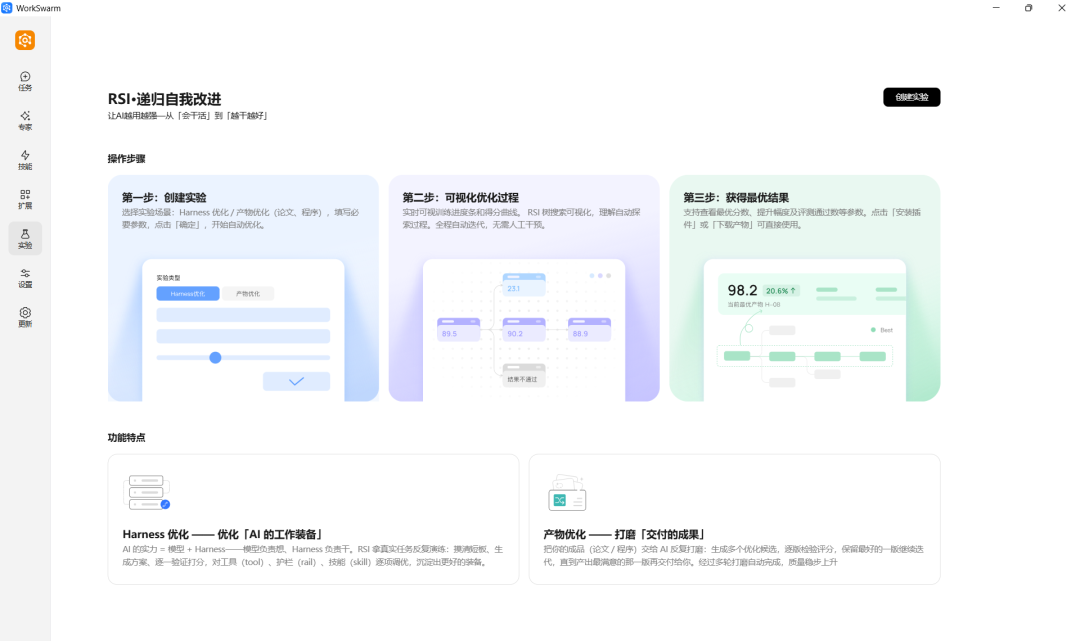
这正是 RSI(Recursive Self-Improvement,递归自我改进) 要解决的核心问题。它不是让模型自己训练自己——那需要海量数据和算力——而是让智能体在真实任务中,基于反馈自动生成改进方案、执行验证、保留有效变更,形成可持续的优化闭环。
今年 6 月,华为多个团队联合推出的开源 AI Agent 平台 openJiuwen 发布了 Auto Harness 能力,让智能体能自动调整自己的“工作装备”。最近,openJiuwen 把完整的 RSI 框架落地到了 WorkSwarm 蜂群办公智能体 上,率先支持 Harness + Artifacts 双维度优化。其中 Artifacts 目前聚焦科研论文和算法程序两类交付产物。配合平台的算力亲和能力,多轮优化的时间和资源开销也被压了下来。

对横跨文档、代码、数据和工具的办公场景来说,这意味着:工作方法可以迭代,产出物可以打磨,成功或失败的经验也能被后续任务直接复用。用户只需像创建普通任务一样点一下“发起实验”,就能看到整个优化过程,并拿到经过验证的结果。

RSI 不是算法,而是一套工程闭环

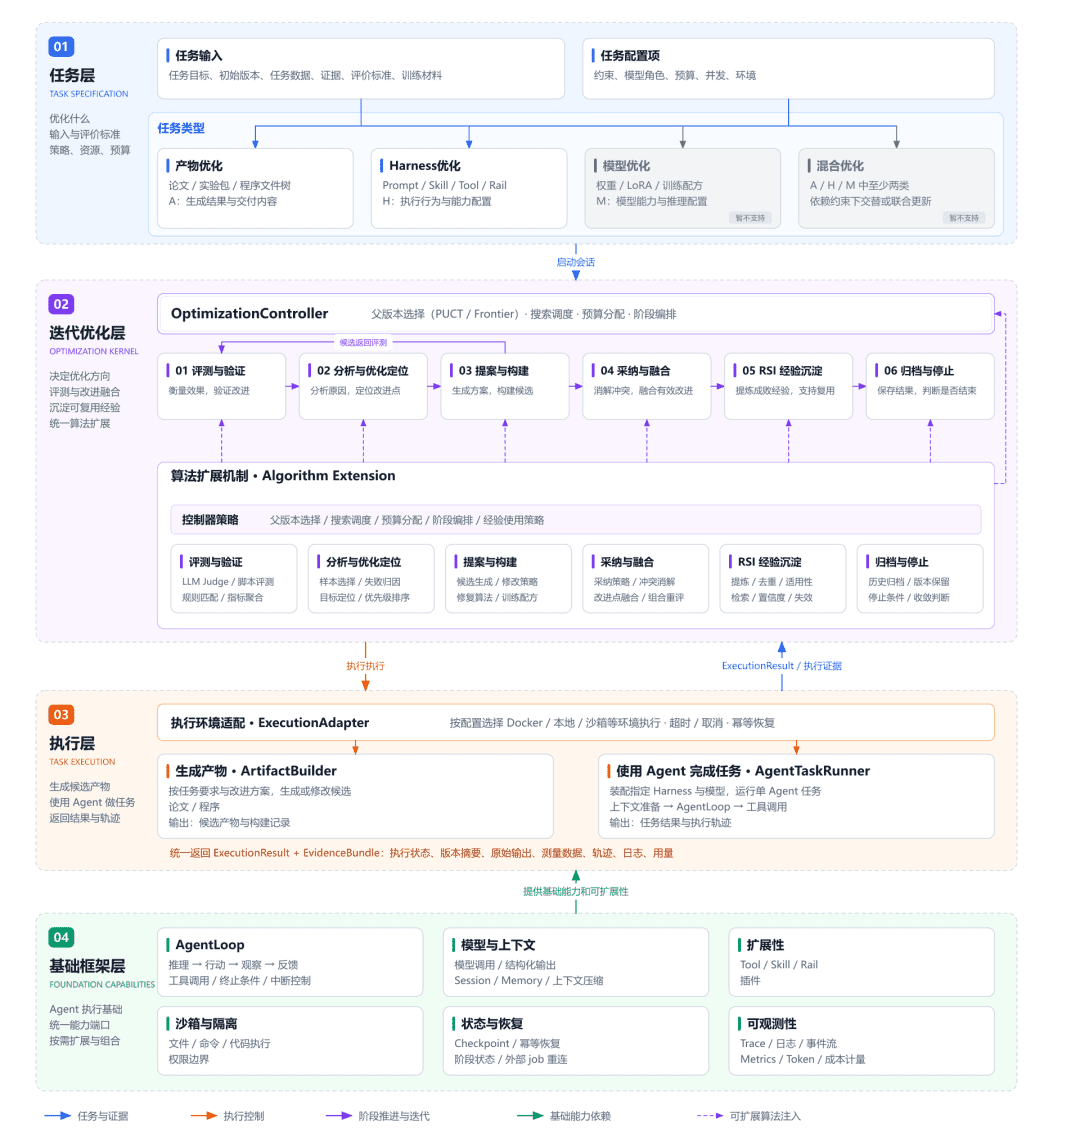
openJiuwen 的 RSI 框架并不是一套固定的优化策略,而是一个能让不同自我迭代任务稳定运行的工程基础设施。它的核心是三个原则:优化对象版本化、执行结果可验证、优化算法可扩展。
整个系统由四层协作构成:
- 任务层:定义“优化什么、怎么评价、能用多少资源”;
- 迭代优化层:决定“下一步试什么、哪些改进值得采纳”;
- 执行层:真正跑起来,返回可验证的证据;
- 基础框架层:提供统一的运行环境、模型调度、沙箱隔离、状态恢复和可观测性。
这四层串起一个六阶段闭环流程:
- 评测与验证:先跑当前版本,建立基线;
- 分析与优化定位:从失败轨迹、指标异常中找根因;
- 提案与构建:生成候选改进方案,并按同一标准重新评测;
- 采纳与融合:消解冲突,组合有效变更,形成新版本;
- RSI 经验沉淀:提炼方法及其适用条件;
- 归档与停止:保存结果,判断是否继续迭代。
只要还有预算和改进空间,系统就会选一个父版本继续下一轮。
可靠性来自明确的职责分离。单次任务的“推理—行动—观察—反馈”由 AgentLoop 负责;跨版本的优化决策则由控制器处理,避免用生成者的主观判断代替客观验证。每份证据都绑定具体版本和评价上下文,所有候选在融合或配置变更后必须重测。执行失败、证据无效、效果退步等情况都会被分别记录。问题、假设、改进点以及采纳/未采纳的原因全部保留,确保下一轮既能借鉴成功,也能避开无效路径。
在统一的任务表达、阶段接口和生命周期下,不同优化对象可以采用各自的算法策略。
三类优化实战:从装备到产出都能自己变好
Harness 优化:把失败案例变成即装即用的新能力
Harness 是智能体的“工作装备包”,包含 Prompt(任务理解)、Skill(专业方法)、Tool(操作能力)和 Rail(执行约束)。当任务失败源于这些组件时,WorkSwarm 能直接从失败用例出发,自动改进整套装备。
操作分四步:
- 构建优化数据:准备一份 JSON 评测集,每条包含任务描述、评测方式、参考答案和评分规则。建议优先选用真实失败过的案例。
- 创建实验:在 WorkSwarm 的“实验”页面选择“Harness 优化”,填实验名,选优化模型、测试模型、初始插件、评测集和最大迭代轮次。
- 自动迭代:系统先跑当前 Harness 建立基线,再从失败轨迹中定位问题,围绕 Prompt/Skill/Tool/Rail 生成候选修改。每个候选先验证是否修复目标用例,再回放完整评测集确认整体提升且未破坏原有功能。页面实时展示得分、轮次、模型用量和搜索树。
- 安装使用:实验产出有效版本后,点击“安装插件”,最优 Harness 会作为插件包热加载,无需手动复制;版本信息保留,支持随时回退。
实测效果显著:在 DeepSeek-V4-Flash 任务模型、最多 5 轮迭代的配置下,Harness 在 SWE-bench Lite Dev 全部 23 题上的通过率从 61.0% 提升至 87.0%。冻结优化后的 Harness 后,在 Evo-Bench General 64 道独立题上的单次执行通过率也从 60.9% 提升至 71.9%。说明优化不仅覆盖参与迭代的任务,还能泛化到新任务。
科研论文优化:从构想到成稿,持续打磨
WorkSwarm 支持两种起点:从研究构想生成论文,或对已有论文继续优化。
用户进入“实验”页面,选择“产物优化 → 论文”,填写研究主题、目标问题或改进方向,或上传本地论文文件夹,设置最大轮次即可启动。
运行期间,详情页展示当前分数、最优论文、模型用量和迭代轮次。论文优化树记录每个版本,点击节点可查看本轮改动、评测结果及未采纳原因。实验结束后,可预览并一键下载最优论文。
整个过程模拟了人类科研中的“写—评—改”循环,但由系统自动执行多轮探索和验证,避免陷入局部最优。
算法程序优化:提交任务包,自动寻找更优实现
对于可运行、可评测的算法程序,WorkSwarm 能自动尝试多个修改版本,交付经过验证的最优结果。
用户先准备初始程序及其评价配置。推荐使用内置的 rsi-program-dataset-creator Skill 生成标准任务包(含源码、scorecard 等)。然后在“实验”页面选择“产物优化 → 程序”,上传任务包即可启动。
优化过程中,页面展示当前最优分数、模型用量和程序优化树。每个节点代表一个候选程序,点击可看具体改动、评测结果和失败原因。支持中途暂停,后续继续。完成后一键下载最优程序,用于验证或集成。
这种方式特别适合需要反复调试性能、正确性或鲁棒性的科研代码,比如机器学习模型、数值算法或数据处理流水线。
算力亲和:让多轮优化不再“烧钱又烧时间”
RSI 的本质是“用算力换智力”:反复生成候选、执行任务、评测结果。一次完整实验可能涉及成千上万次模型调用。而提示词、工具描述、任务材料在多轮中高度重复,加上频繁的暂停、恢复和重试,如果每次都重新计算上下文,资源开销会指数级增长。
openJiuwen 的 算力亲和 能力依托昇腾算力基础设施,让推理引擎“读懂”智能体的任务状态。框架通过 Agent Hint 将任务运行、等待、恢复等信息传递给引擎,驱动其在昇腾 NPU 显存、鲲鹏 CPU 内存和远端缓存池之间主动调度 KV Cache(键值缓存):
- 等待时卸载到低成本存储;
- 恢复前提前预取;
- 结束后及时释放。
这显著降低了多轮优化的延迟和资源占用。
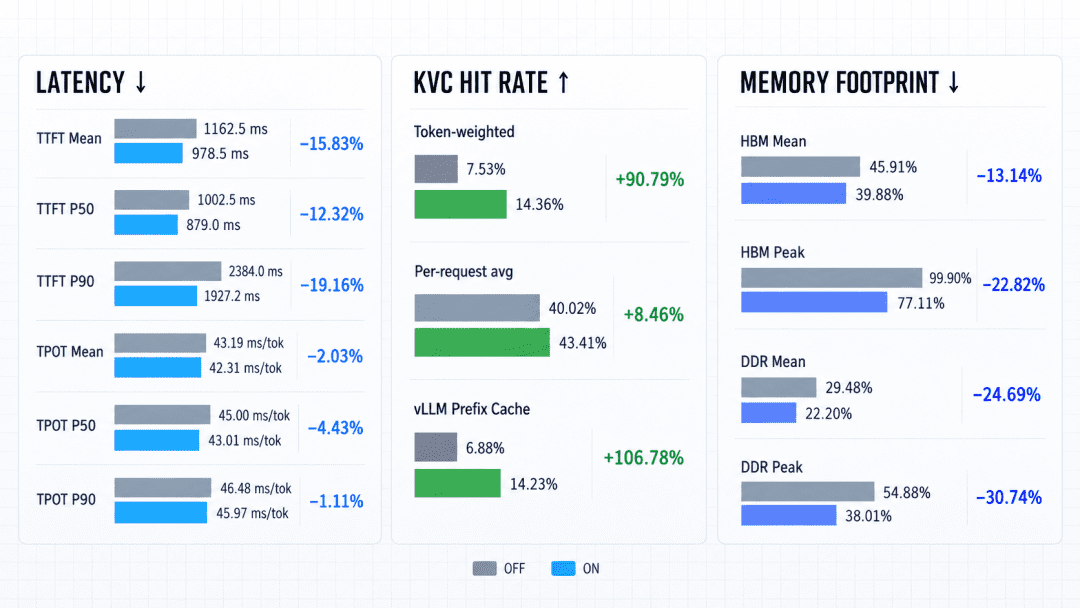
在科研算法程序优化实验中,开启算力亲和后:
- TTFT(首 Token 时延)均值下降 15.83%,P90 下降 19.16%;
- Token 加权 KV Cache 命中率从 7.53% 提升至 14.36%;
- HBM 与 DDR 峰值使用率分别下降 22.82% 和 30.74%。
这意味着重复 Prefill 减少了,响应更快了,存储压力也更低了——让持续改进变得真正可行。
优化不再是黑箱,而是可观察、可复用的流程
openJiuwen RSI 在 WorkSwarm 上已经形成一条完整链路:
- Harness 优化改进智能体的工作方式;
- Artifacts 优化打磨论文和程序等交付物;
- 算力亲和降低多轮迭代成本。
关键在于,每次改变都有证据,每次采纳都经验证,每轮经验都能指导下一轮。用户不再需要猜测“为什么失败”或“怎么改更好”,而是发起一次实验,让系统自动探索、验证、收敛。
未来,框架计划丰富搜索、评测与融合算法,增强跨任务经验复用,并沿统一架构接入模型优化与混合优化,让 Harness、Artifacts 和 Models 在明确的评价标准、预算与安全边界内协同迭代。
目前,RSI 实验模式已在 WorkSwarm 上线,用户可前往官网体验:
- WorkSwarm 立即体验:https://openjiuwen.com/workswarm
- GitHub 代码仓:https://github.com/openJiuwen-ai/
- AtomGit 代码仓:https://atomgit.com/openJiuwen/