FastH3 在八卡 B300 上实现完整 MP4 生成快于播放时长
MiniMax H3 的服务瓶颈不在单一模块
MiniMax H3 是一个多模态生成模型,能根据文本、图像、视频或音频输入,同步输出视频和音频。它的处理流程看起来线性,实则复杂:

request → Qwen3-VL 编码器 → 联合音视频 DiT → 视频 VAE + 音频 VAE → MP4 封装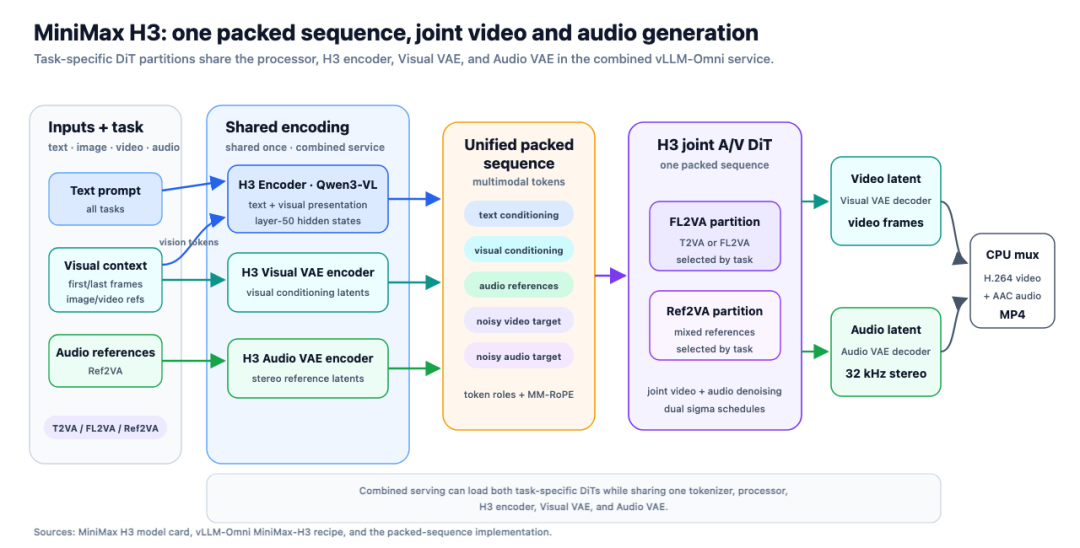
表面上看,DiT(去噪变换器)执行了最多的计算——原始版本要跑 49 次前向传播。但问题在于,即使把 DiT 优化到极致,其他环节的延迟依然存在:编码器常驻占用显存、VAE 解码耗时、帧数据跨进程传输、H.264/AAC 封装等。这些环节串联起来,构成了一个典型的系统级瓶颈。

换句话说,只盯着 DiT 优化,就像只给赛车换轮胎却不修路——车可能更快了,但整体行程时间没变。

实测中的“实时”定义很具体

本文所说的“实时”,不是指首帧快、也不是流式输出,而是指从提交请求到拿到完整 MP4 文件的时间,短于该视频的播放时长。例如,生成一段 10.125 秒的视频,如果系统在 8.7 秒内就返回了可播放的 MP4,那就算实时(RTF_client = 8.7 / 10.125 ≈ 0.86 < 1.0)。

这个定义对实际部署更有意义:用户不需要边等边播,而是能一次性拿到成品,且等待时间比看视频还短。

vLLM-Omni 的系统级优化路径

vLLM-Omni 没有只优化某个模块,而是重构了整个推理流水线。以下是关键改进点:
长序列注意力与通信优化
H3 把文本、音频、视频 token 打包成一条超长序列(约 58k tokens)。传统实现会填充到固定长度,造成大量无效计算。vLLM-Omni 引入 TRTLLM_ATTN,只处理有效 token,并通过 Fast Ulysses 直接以注意力所需布局交换分片,省去了 all-to-all 通信前后的重排开销。
融合 DiT 算子
原始 DiT 循环中,每次前向都包含多个小算子:RMSNorm、RoPE、SwiGLU、残差连接等。vLLM-Omni 将这些操作融合成单个 kernel,减少了 launch 开销和中间内存分配。例如,Q/K 的归一化与 RoPE 合并,SwiGLU 替代两次独立的 SiLU 和乘法。

并行 VAE 解码
去噪完成后,视频和音频分别由各自的 VAE 解码。vLLM-Omni 将视频 VAE 的 patch 分布到八张 GPU 上并行解码,并复用融合算子路径。这显著缩短了原本串行的解码时间。

紧凑输出与并行 MP4 构建

GPU 输出的是 FP32 格式的 BCTHW 帧,体积庞大。优化后的流程先将其转为 uint8 BTHWC,体积减少 75%,再通过 pinned 内存和 IPC 快速传给 CPU。编码器直接读取 planar 格式的 RGB 平面,无需构建完整的交错缓冲区,H.264 和 AAC 封装也能并行进行。

这些优化叠加后,vLLM-Omni 在八卡 B300 上将基础 H3 的端到端延迟降低了 30.8%(1.445 倍加速),且不依赖量化、稀疏注意力或减少去噪步数——属于无损优化。

FastH3:把主导项也压下去

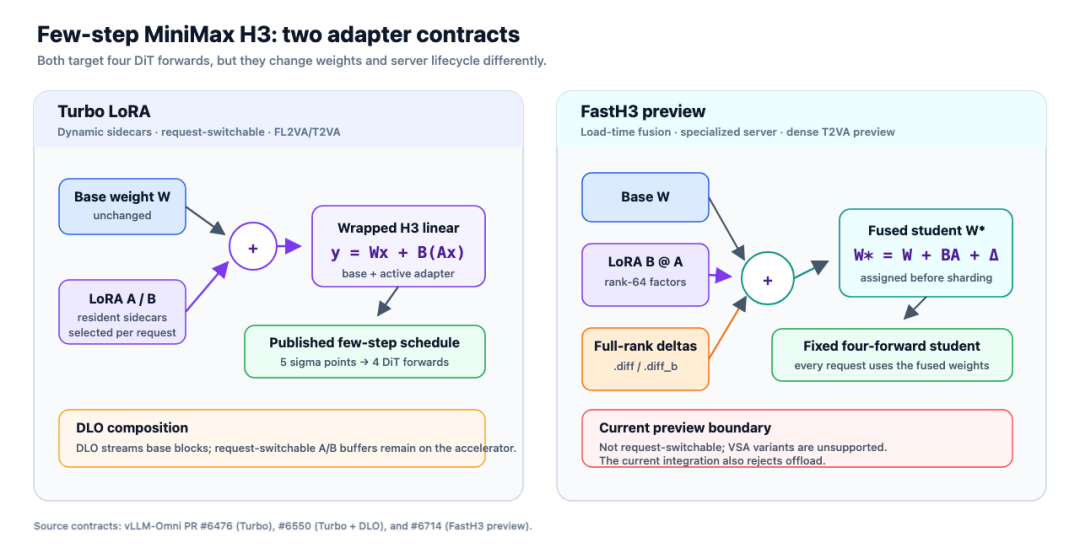
即便如此,DiT 仍是最大开销。FastVideo 团队基于知识蒸馏,推出了 FastH3——一个只需 4 次前向就能完成去噪的学生模型。它复用 H3 的编码器、VAE 和 tokenizer,但调度器和权重经过专门训练。

vLLM-Omni 集成了 FastH3,但不是以 LoRA 形式动态加载,而是在服务启动前就将适配器权重融合进主模型。这是因为 FastH3 不仅包含低秩更新,还有满秩 delta,普通 LoRA 无法表达。
实测结果:真正实现 RTF ≤ 1.0


在八卡 B300 配置下,使用 FastH3 Dense/Data-Free 产物(HF rev bcf40ca),生成 10.125 秒(243 帧,1344×768,24 FPS)的视频,端到端耗时稳定在 8.678 至 8.710 秒。这意味着 RTF_client ≈ 0.86,确实快于播放时长。
更关键的是,这一结果覆盖了从请求提交到 MP4 返回的完整链路,包括 D2H 传输和封装。测试还验证了 5 秒、10 秒、15 秒三种时长,全部满足 RTF ≤ 1.0。
其他加速路径:有损但可控
除了无损优化,vLLM-Omni 还支持多种有损加速选项,但需独立验证质量:
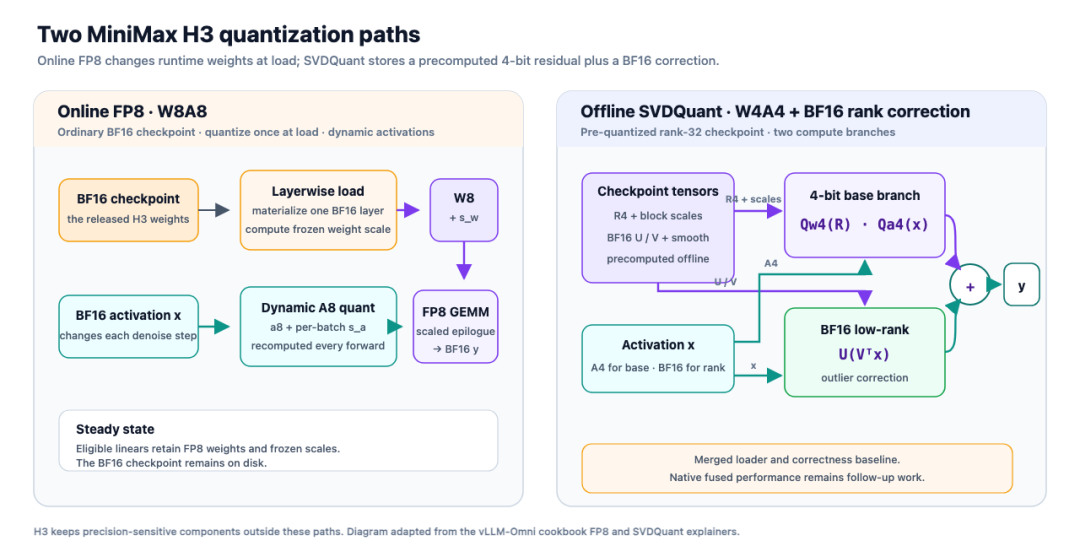
- 在线 FP8:加载时将部分 linear 层量化为 FP8,显存降低,但时延收益有限。
- SVDQuant (NVFP4 W4A4):离线量化加低秩修正,目前主要用于正确性验证,性能路径待完善。
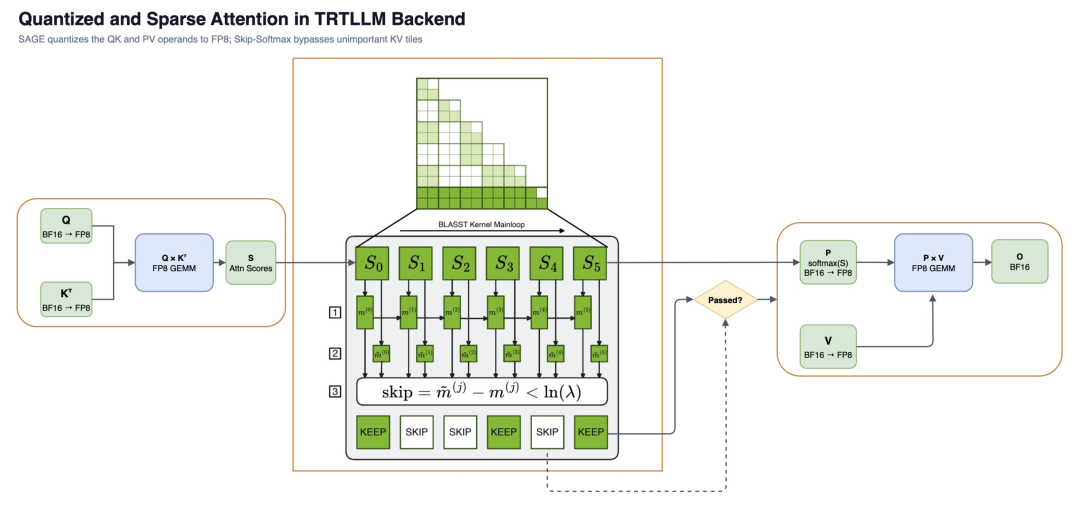
- TRTLLM_ATTN 的 SAGE 与 Skip-Softmax:前者将注意力计算量化到 FP8,后者动态跳过不重要的 Softmax 和 P×V 计算。保守配置下视频质量可接受,激进配置可进一步提速。
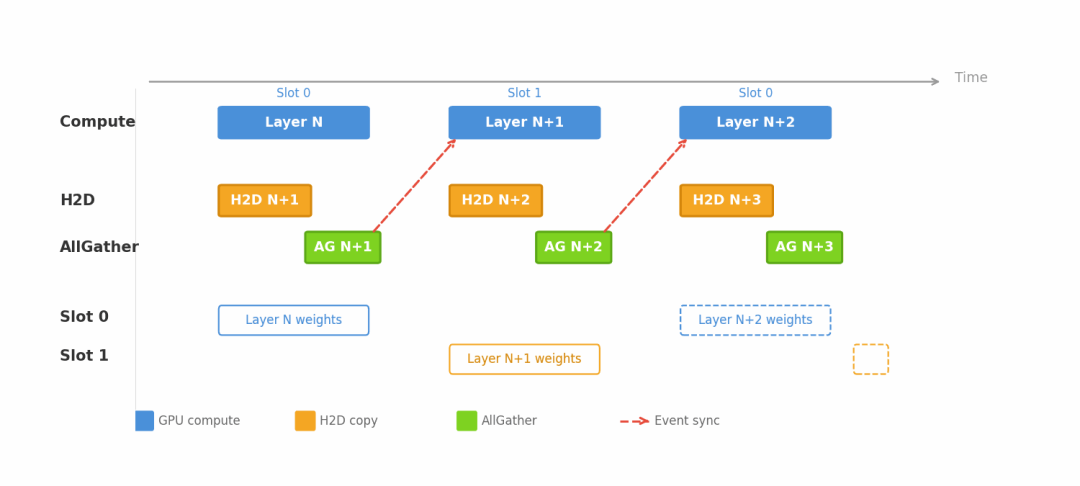
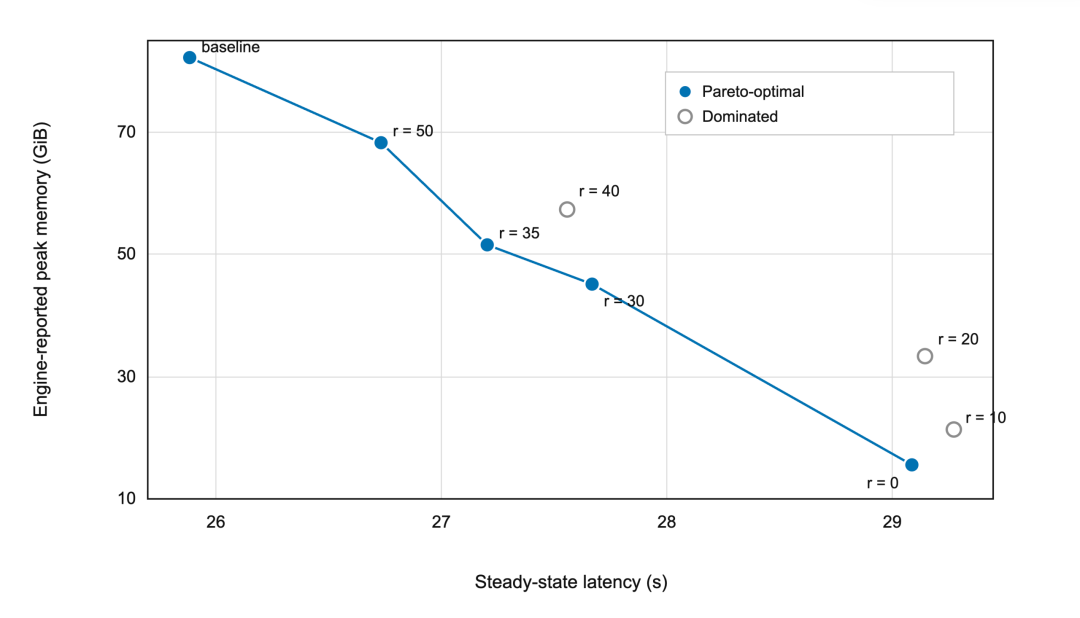
- DLO(分布式逐层卸载):将部分 DiT 层放在主机内存,按需加载。在 r=35(常驻 35 层)时,显存降低 37.5%,仅增加 5.1% 延迟。
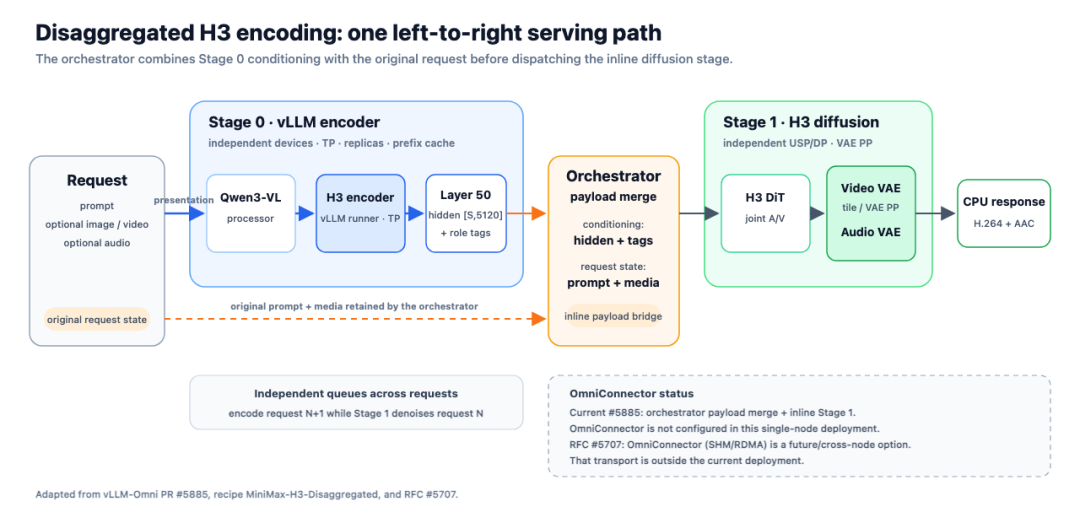
- 编码器分离:将 51.5 GB 的 Qwen3-VL 编码器移到独立服务阶段,便于独立扩缩容。
但这些路径未参与 FastH3 的实测数字。官方建议不要随意组合,必须重新认证正确性、质量和延迟。
后续工作聚焦落地
当前成果已证明系统级优化+模型蒸馏的可行性。下一步重点包括:
- 在 Blackwell 平台上集成原生 FastVideo SM100a VSA kernel 和 NVFP4 融合算子;
- 验证 Sol-Attn 等即时稀疏注意力后端;
- 完成分块 VAE 到 MP4 的流水线重叠,目标再降 10–20% E2E 延迟;
- 推动 FastH3 与编码器分离等扩展特性的组合认证,而非靠推测兼容。
总之,FastH3 的实时能力不是靠单一技术突破,而是系统工程与模型压缩协同的结果。这也为多模态大模型的服务部署提供了新范式:既要“瘦身”模型,也要“疏通”管道。