用 n8n 把 AI、网页抓取和远程触发串成工作流,告别脚本堆砌
自动化不想再堆脚本?试试把流程画出来
写自动化脚本最头疼的不是任务本身,而是时间一长,脚本越积越多,彼此之间的调用关系全靠注释和记忆。一个负责抓数据,一个发通知,另一个处理接口,半年后连自己都要翻半天目录才能理清它们怎么串起来。
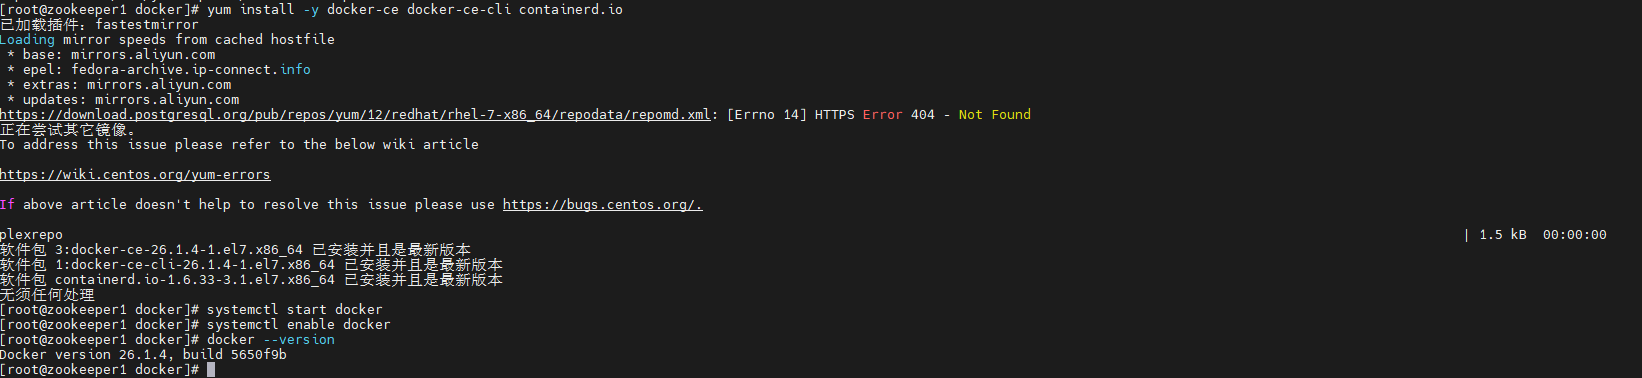
n8n 吸引我的地方,正是把这种原本藏在代码里的执行逻辑直接摆到画布上。它用节点表示触发器、处理步骤和输出动作,连线就是数据流向。这不是为了彻底取代代码,而是先把能标准化的部分交给现成节点,真需要自定义时再补一段脚本。这种方式对我更顺手。
这次我从最基础的本地部署开始:准备 Docker 环境,启动 n8nio/n8n:latest 镜像,确认 5678 端口页面能访问;然后搭两条真实可用的工作流——一条接入 DeepSeek 做 AI 对话,另一条用 HTTP Request 和 HTML 节点抓取网页内容。每条流程都要求实际执行并看到结果,而不是“配置完就算成功”。等本地跑通后,再通过 cpolar 把 5678 映射到公网,并换成固定二级子域名 n8n。这样以后接 Webhook、数据库或更多 AI 节点时,扩展的是一条看得见、能测试的工作流,而不是继续往目录里堆新的孤立脚本。
先把 Docker 环境准备好
这次操作基于 CentOS 系统。如果之前装过旧版 Docker,建议先卸载干净:
yum remove docker docker-client docker-client-latest docker-common docker-latest docker-latest-logrotate docker-logrotate docker-engine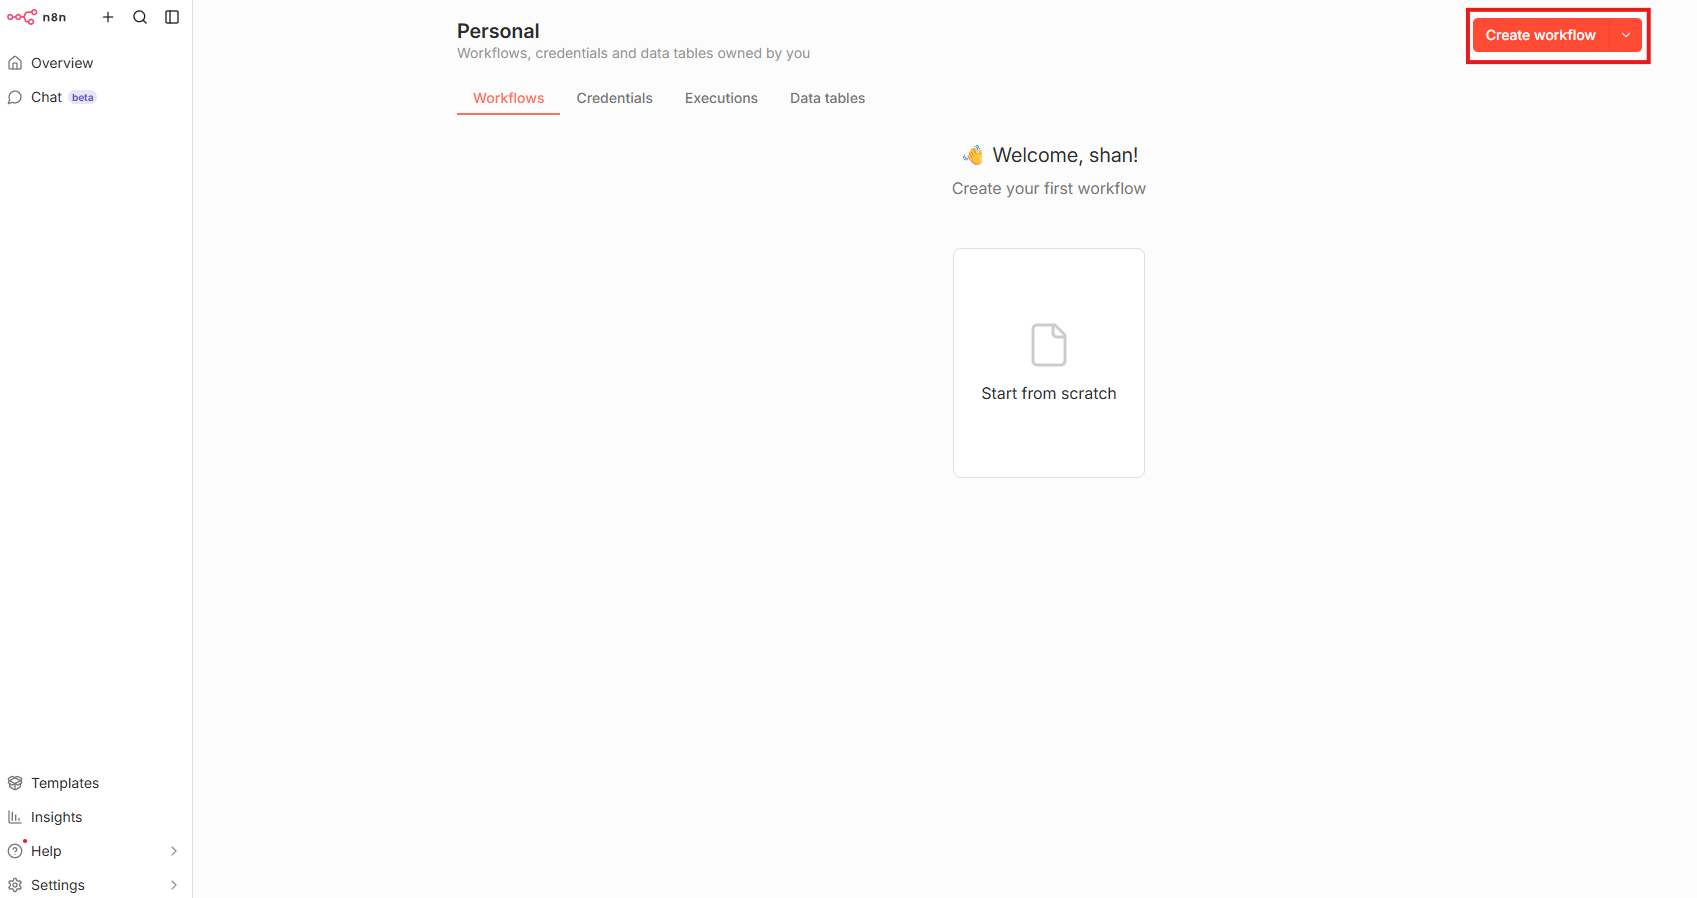
接着安装必要的依赖:
yum install -y yum-utils device-mapper-persistent-data lvm2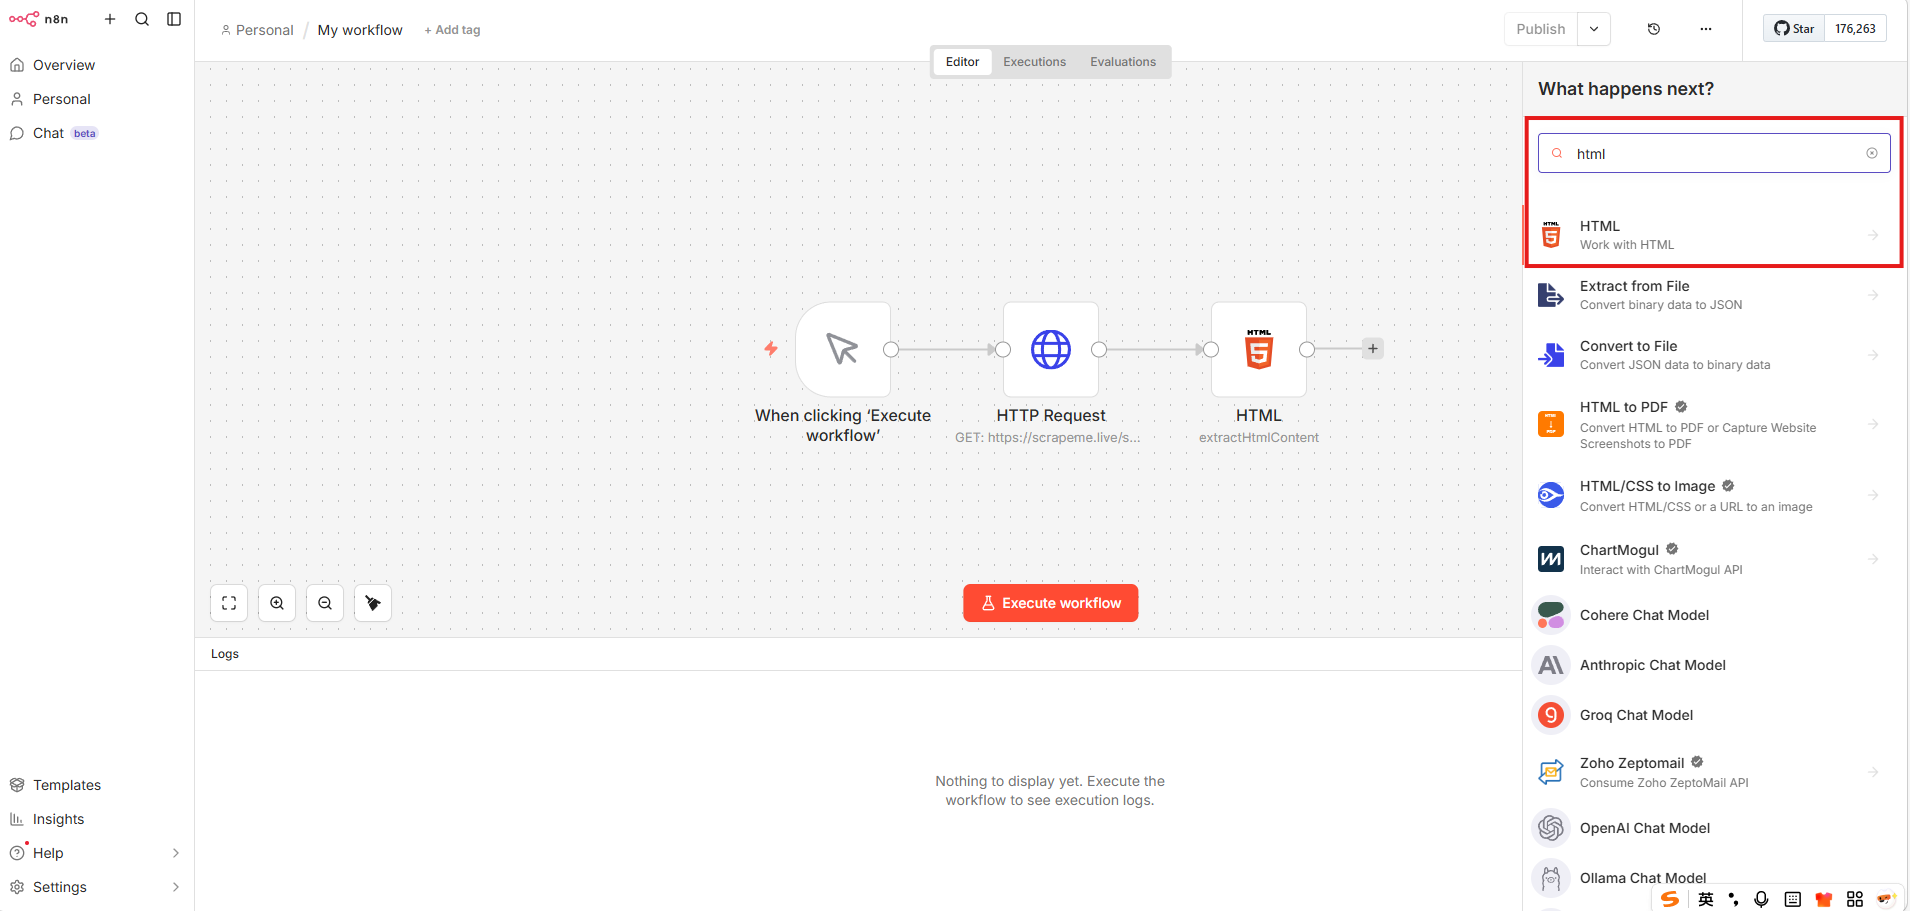
添加阿里云的 Docker 软件源,加速后续下载:
yum-config-manager --add-repo https://mirrors.aliyun.com/docker-ce/linux/centos/docker-ce.repo
然后安装并启动 Docker:
yum install -y docker-ce docker-ce-cli containerd.io
systemctl start docker
systemctl enable docker # 设置开机自启
docker --version # 能显示版本号就说明装好了
为了让镜像拉取更快,还得配个国内镜像源。创建 /etc/docker/daemon.json 文件,写入:
{
"registry-mirrors": [
"https://docker.xuanyuan.me",
"https://docker.m.daocloud.io",
"https://docker.imgdb.de",
"https://docker-0.unsee.tech"
]
}
最后重新加载配置并重启 Docker:
systemctl daemon-reload
systemctl restart docker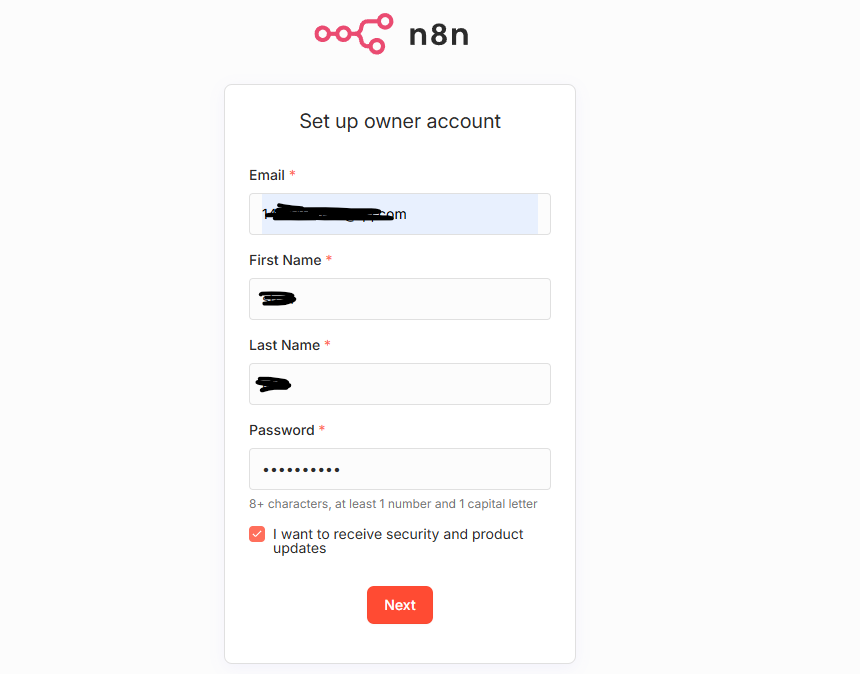
这一步走完,Docker 环境就算准备妥当,可以开始拉 n8n 镜像了。
部署 n8n 容器
先手动拉取最新版镜像,方便观察下载进度:
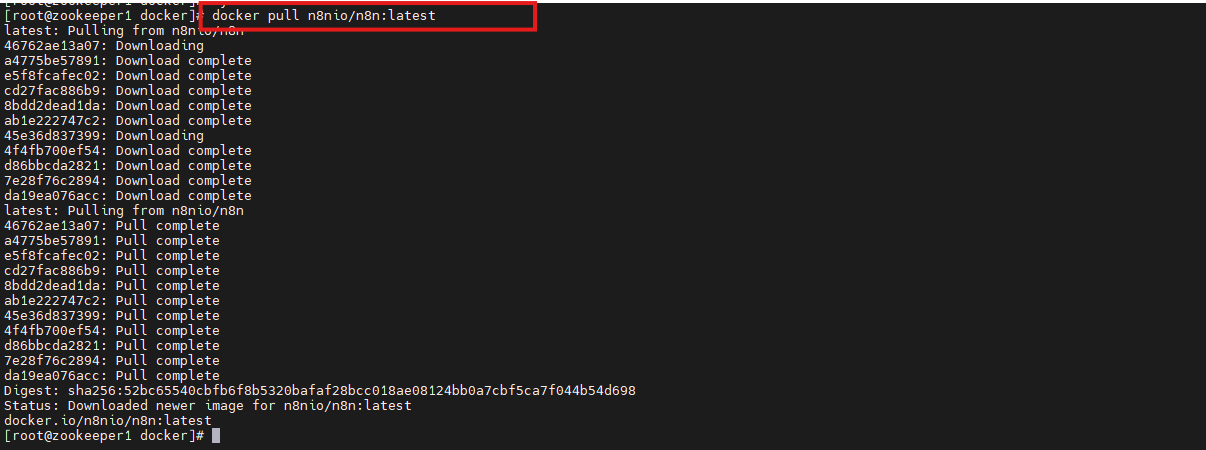
docker pull n8nio/n8n:latest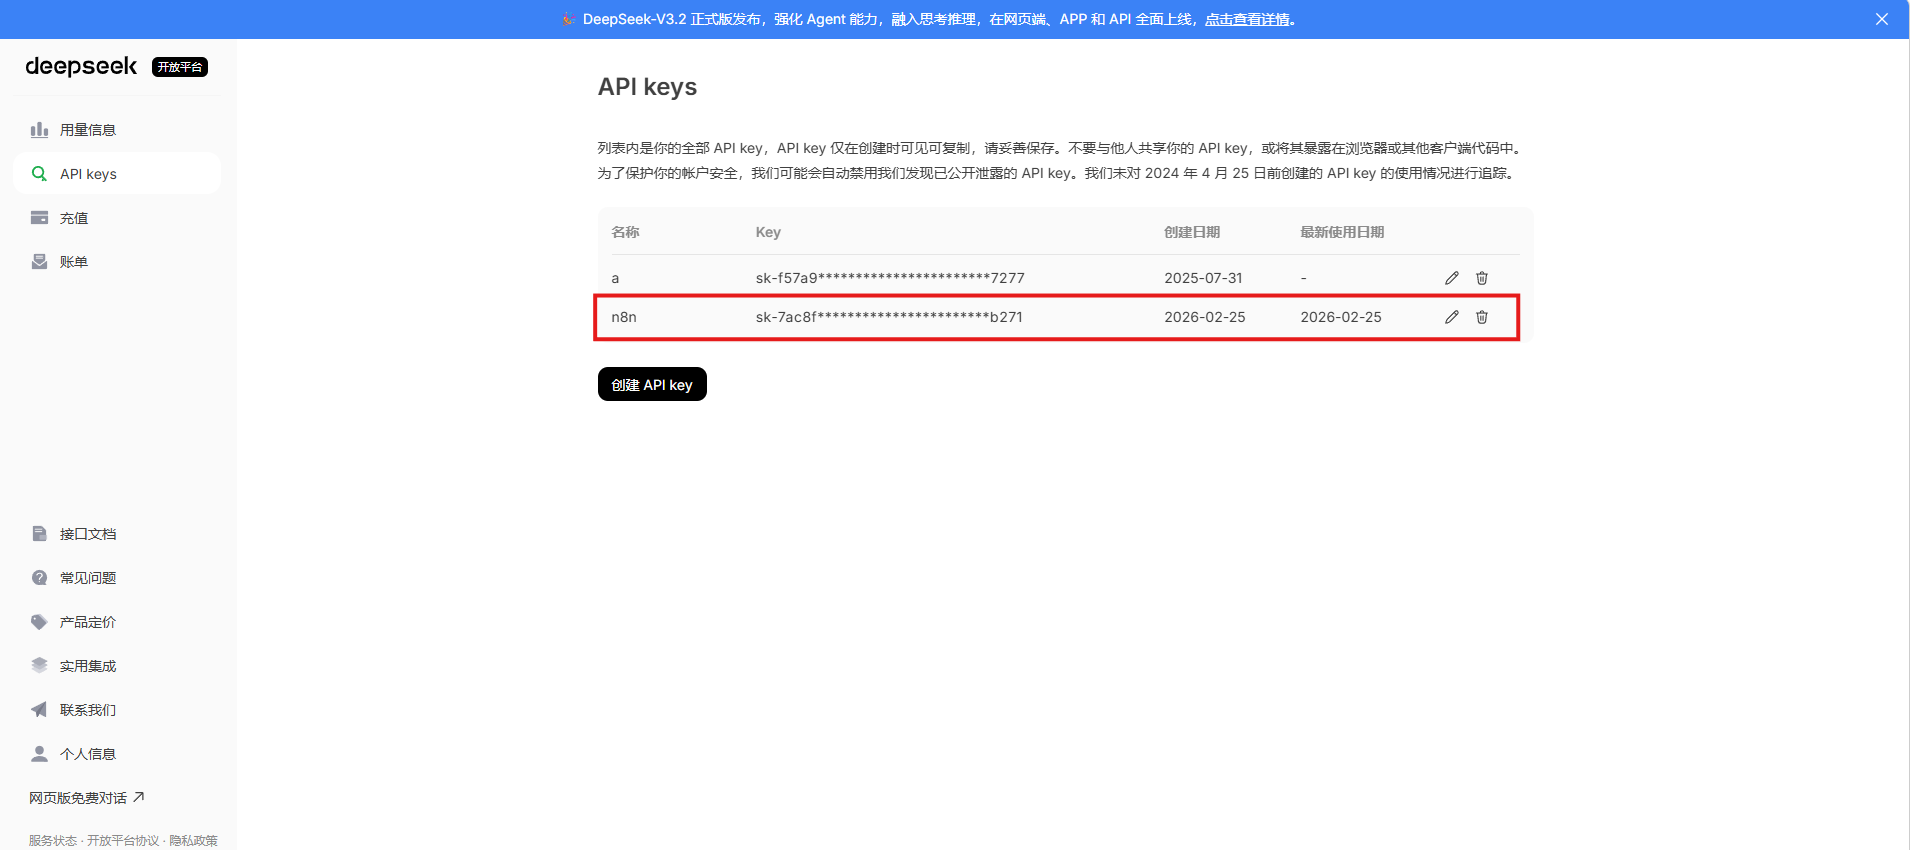
为了避免容器删除后配置丢失,需要创建一个本地目录来持久化数据:
mkdir -p ~/.n8n
chmod -R 777 ~/.n8n # 给足读写权限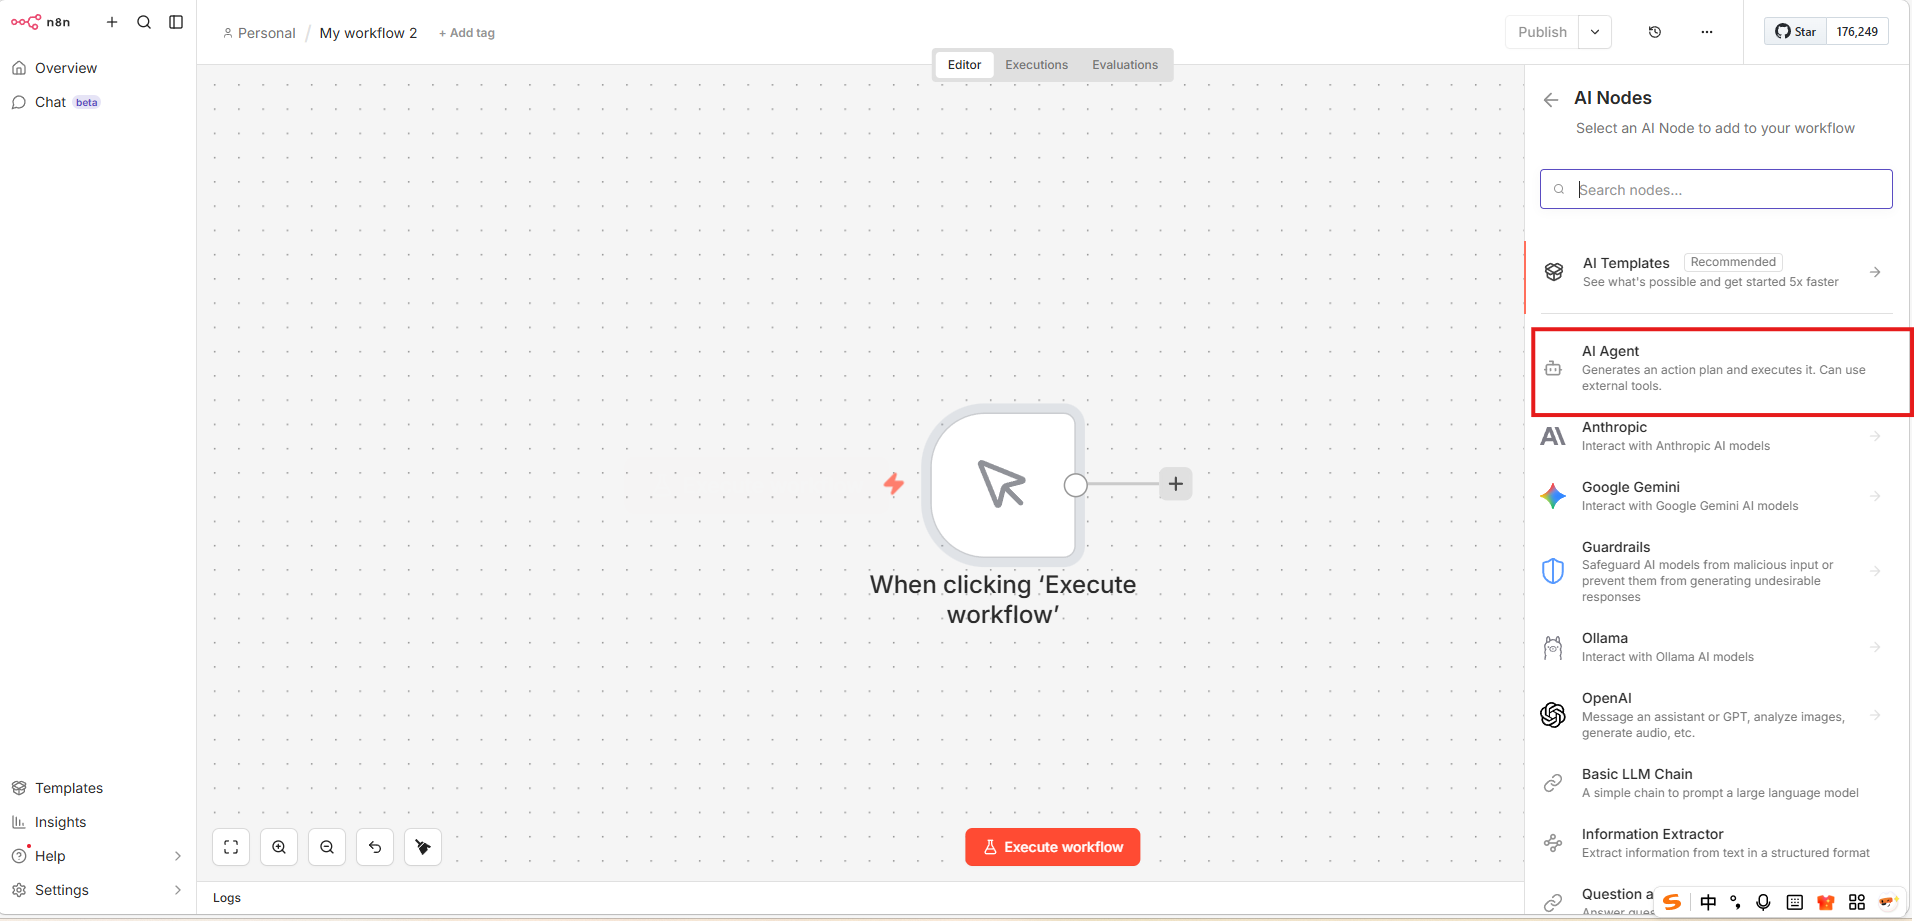
这个目录会挂载到容器内的 /home/node/.n8n 路径。
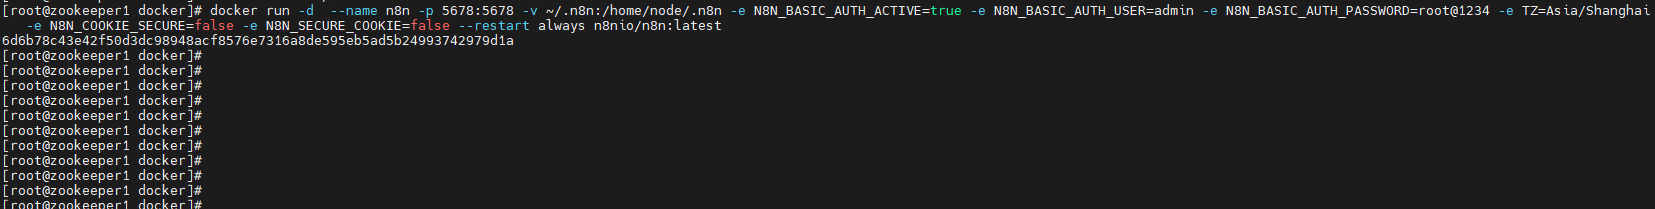
接下来启动容器,命令如下:
docker run -d \
--name n8n \
-p 5678:5678 \
-v ~/.n8n:/home/node/.n8n \
-e N8N_BASIC_AUTH_ACTIVE=true \
-e N8N_BASIC_AUTH_USER=admin \
-e N8N_BASIC_AUTH_PASSWORD=root@1234 \
-e TZ=Asia/Shanghai \
-e N8N_COOKIE_SECURE=false \
-e N8N_SECURE_COOKIE=false \
--restart always \
n8nio/n8n:latest
这里的关键参数包括:
- 暴露 5678 端口
- 挂载数据目录
- 开启基础认证(用户名 admin,密码 root@1234)
- 设置时区为上海
- 关闭安全 Cookie(方便本地测试)
- 设置容器随系统重启
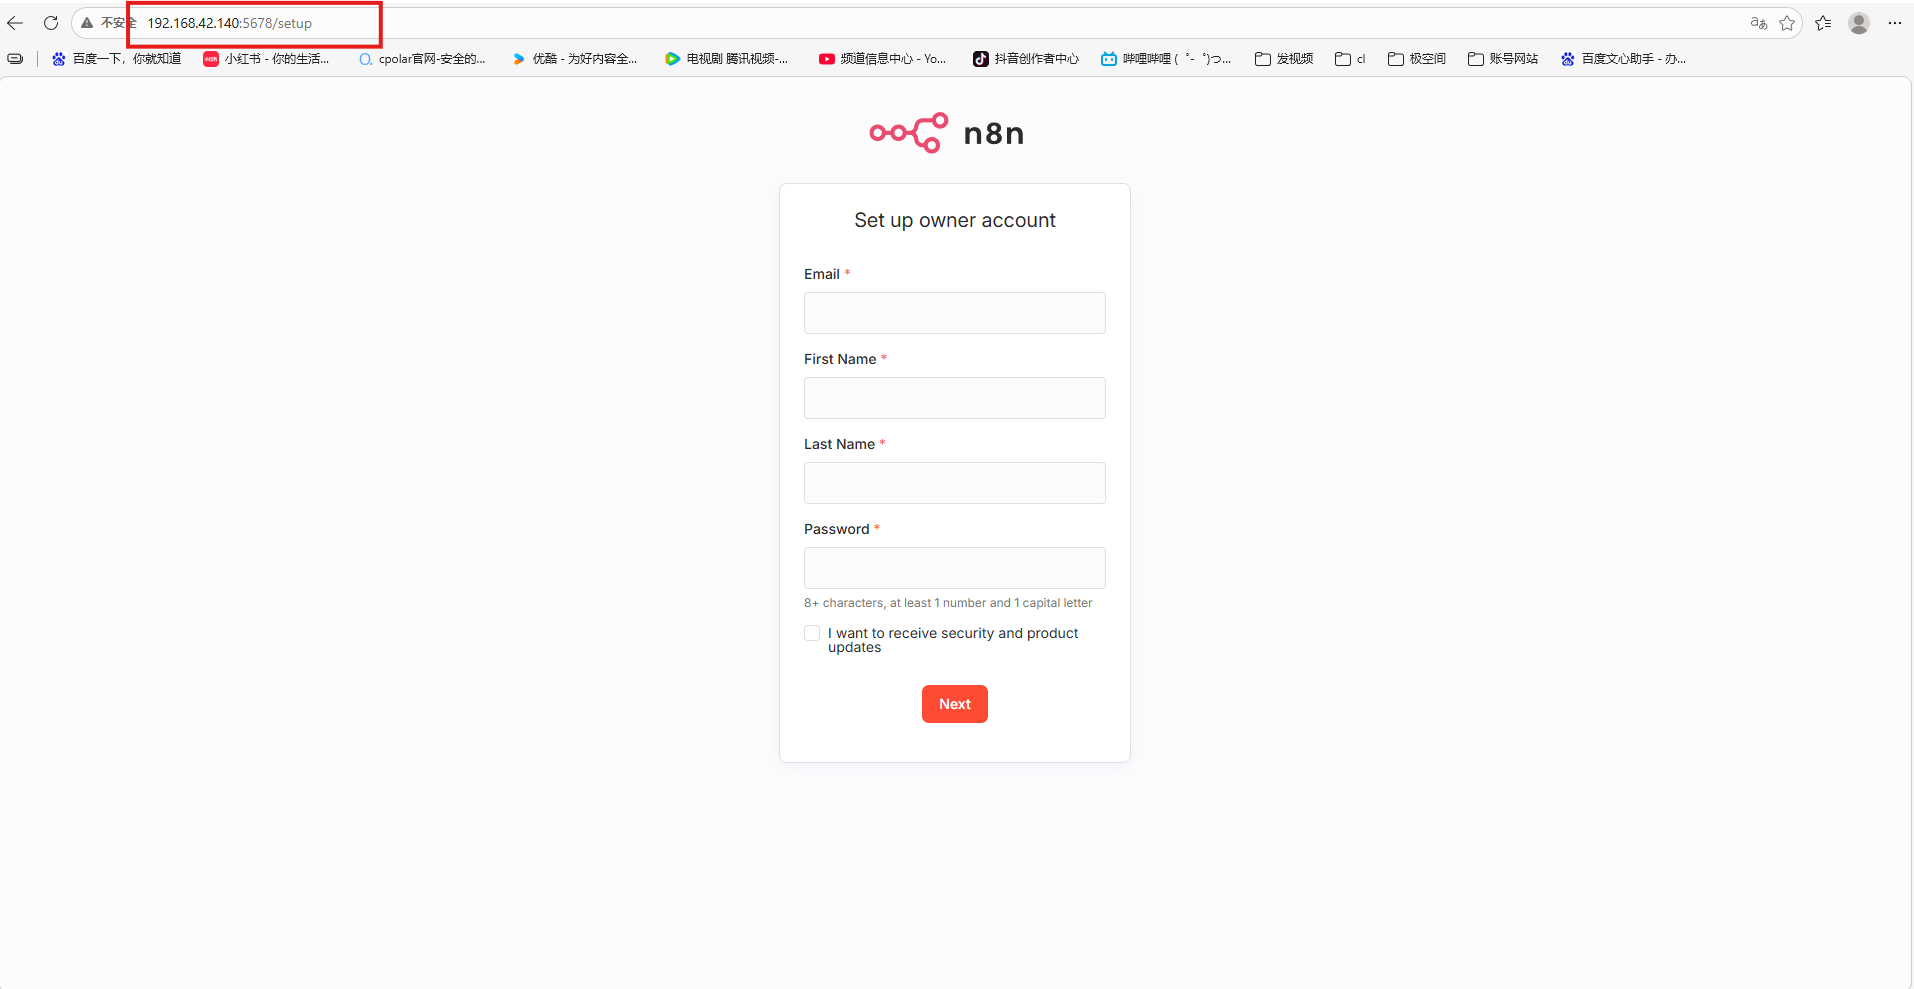
启动后用 docker ps | grep n8n 确认容器运行正常,然后在浏览器访问 http://服务器IP:5678。如果页面能打开,说明 n8n 的本地服务已经跑起来了。
初始化 n8n 并获取免费密钥
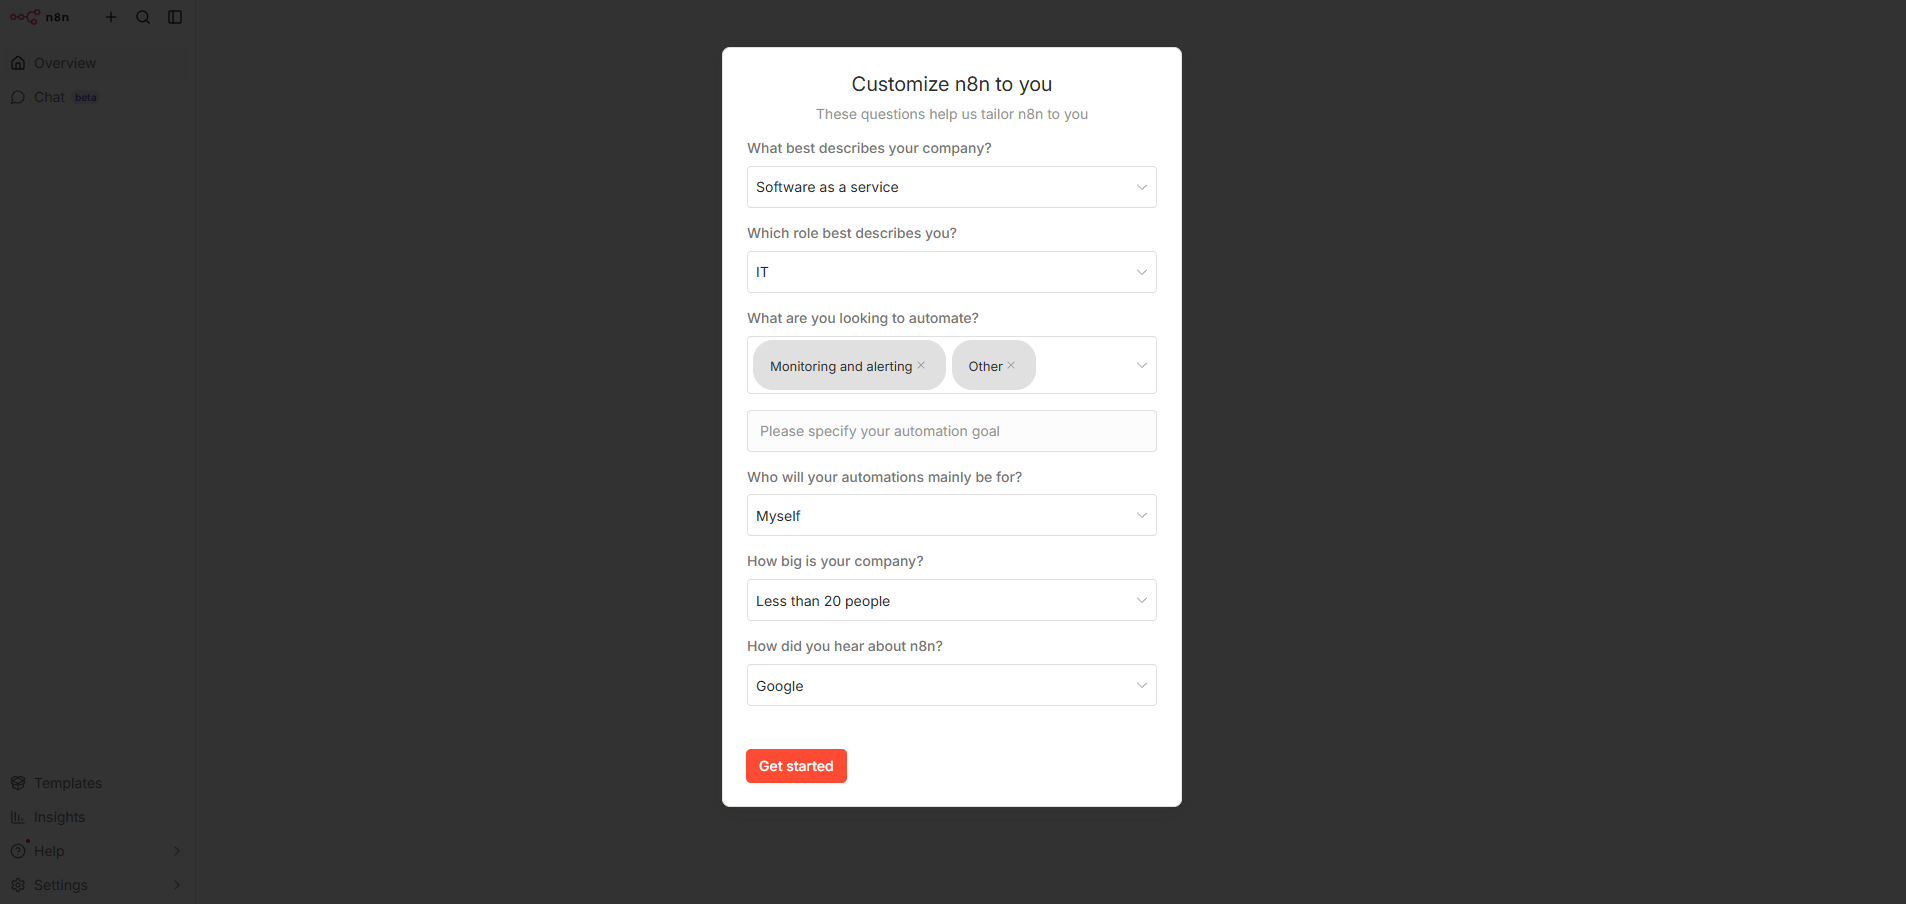
首次进入会要求填写邮箱、用户名和密码完成注册。登录后继续完善基础信息。
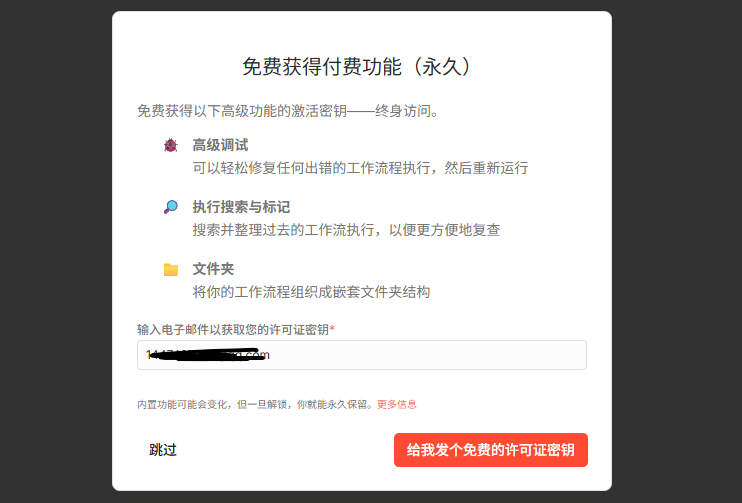
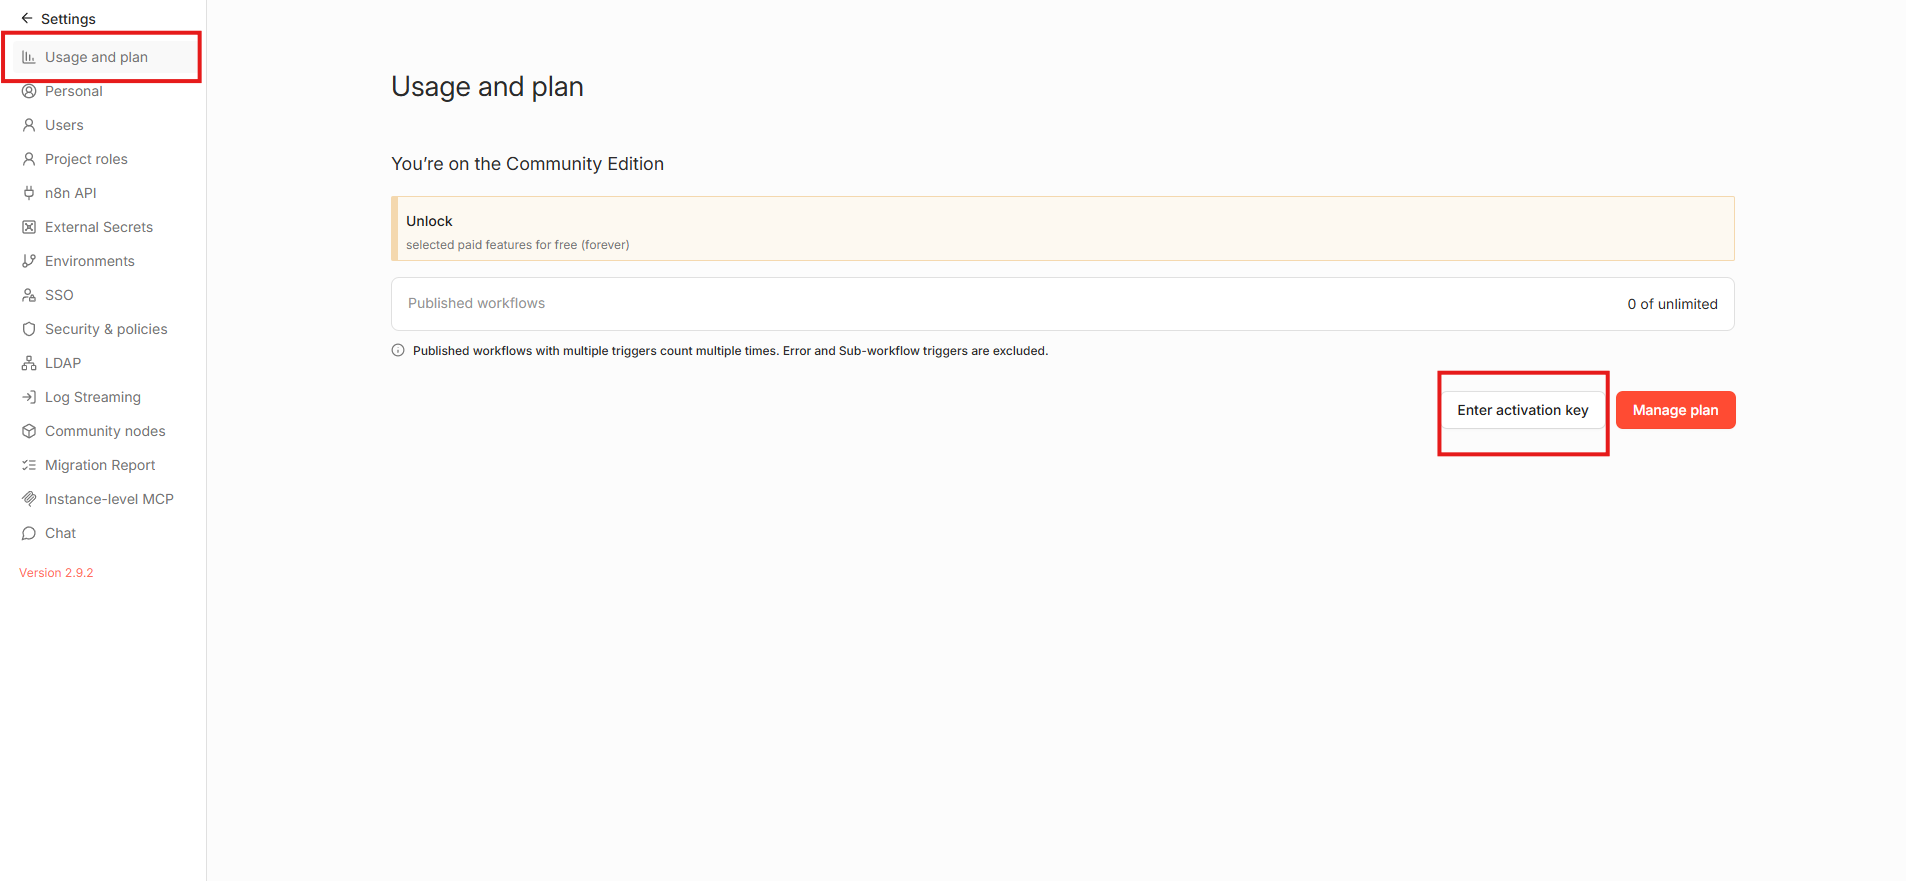
n8n 提供永久免费的社区版密钥,可以在设置页的 “Usage and plan” 区域添加。这个密钥能解锁部分高级功能,比如更多节点类型和更高的执行频率。填好之后,就可以开始创建工作流了。
第一条工作流:接入 DeepSeek 实现 AI 对话
我不想让 n8n 停在首页吃灰,所以第一条流程直接用 AI 对话来验证链路是否通畅。
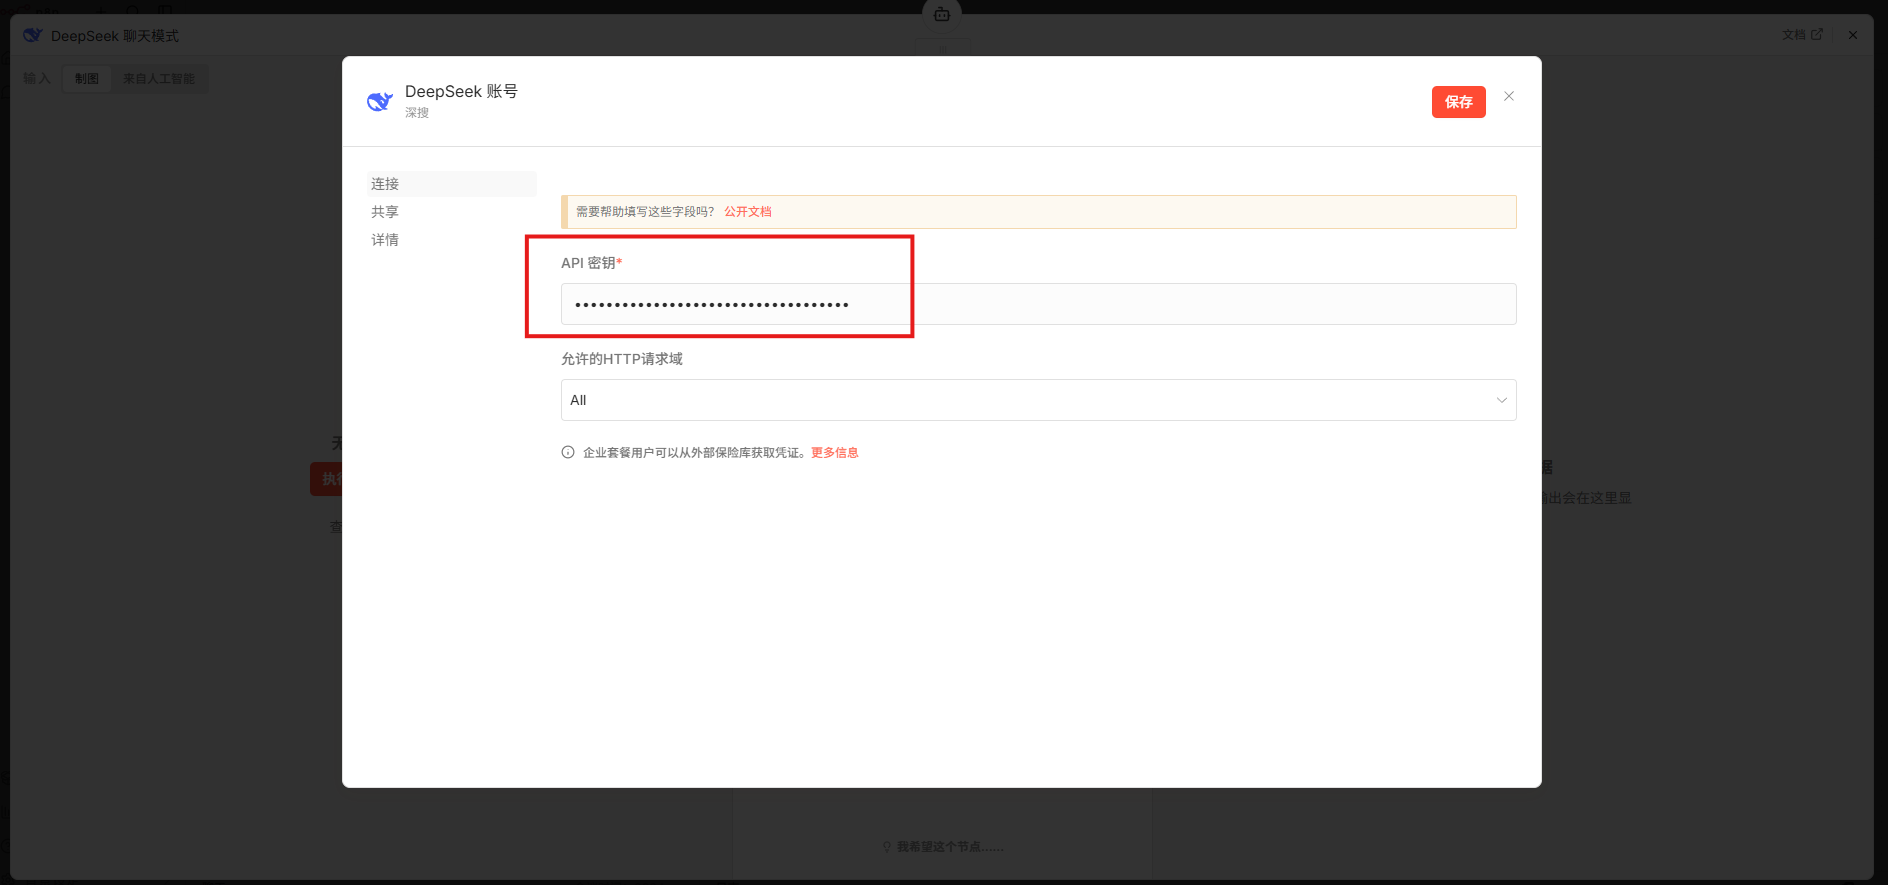
首先去 DeepSeek 开放平台申请 API Key。登录后进入 API 密钥页面,创建新密钥并妥善保存——平台只显示一次。
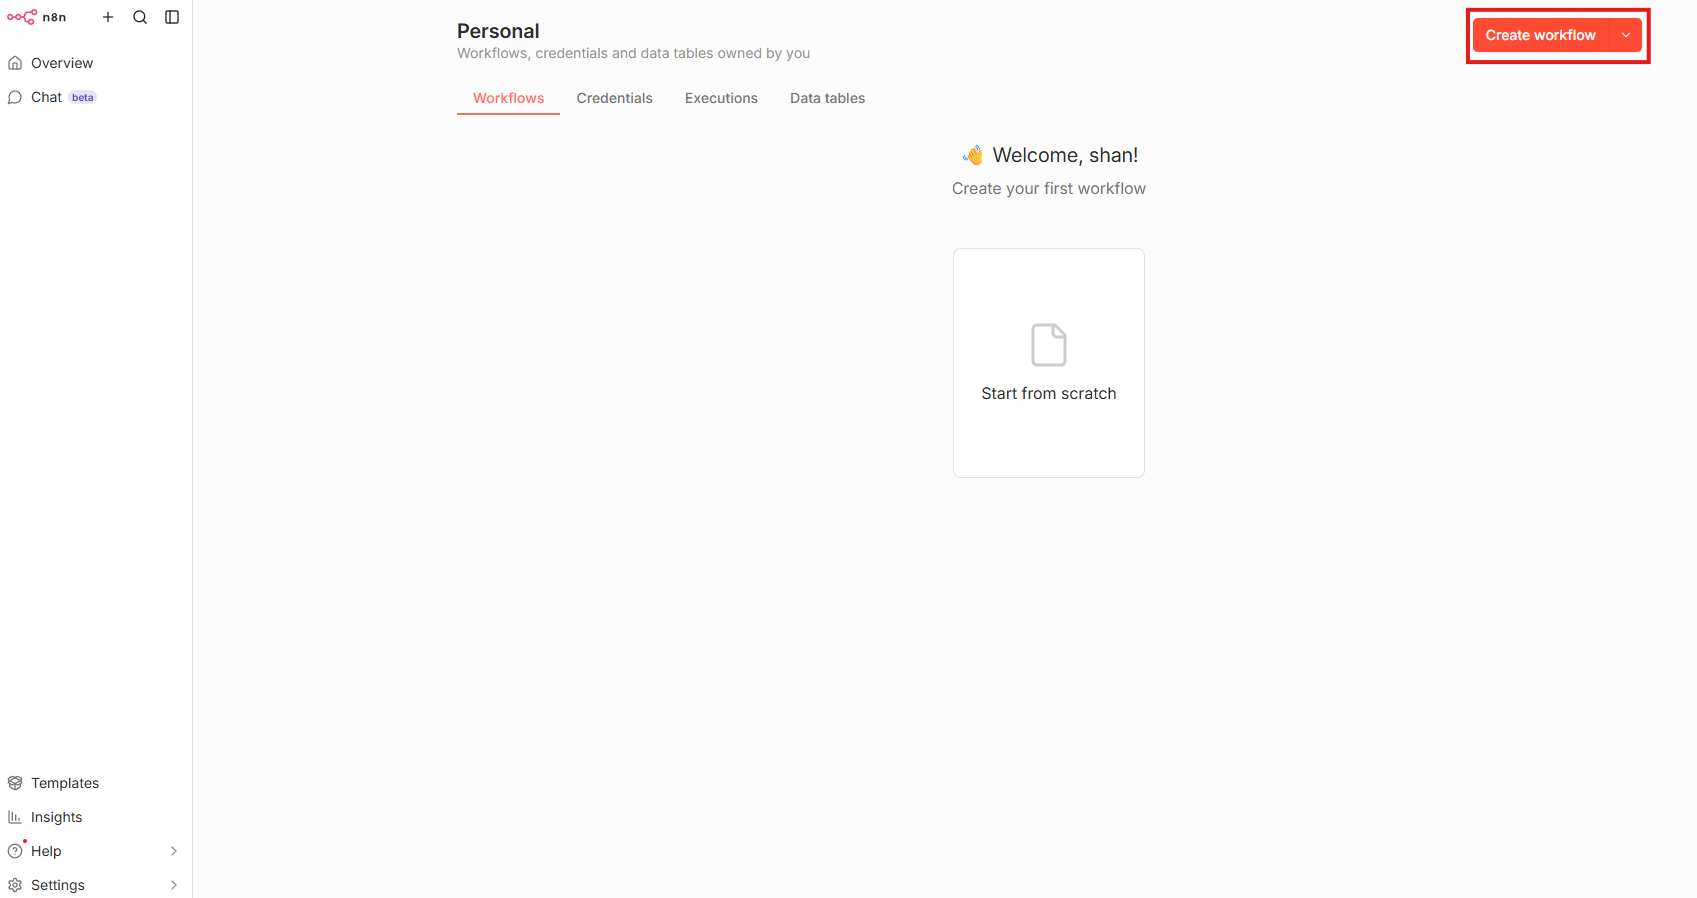
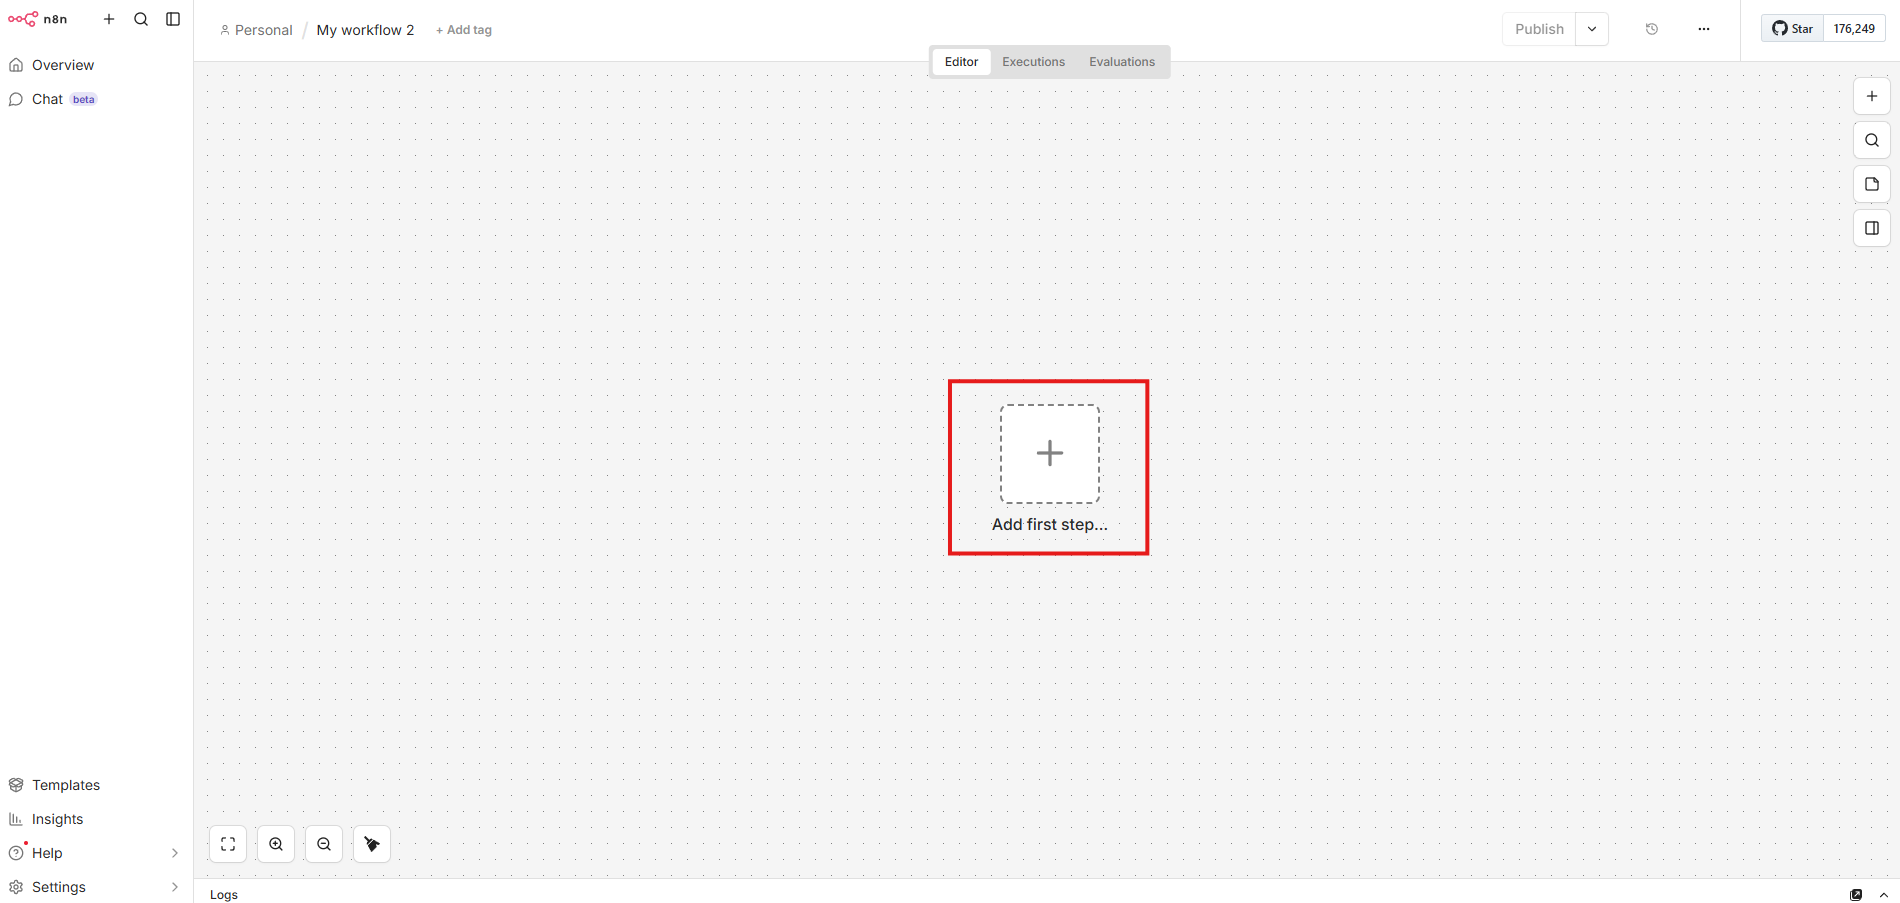
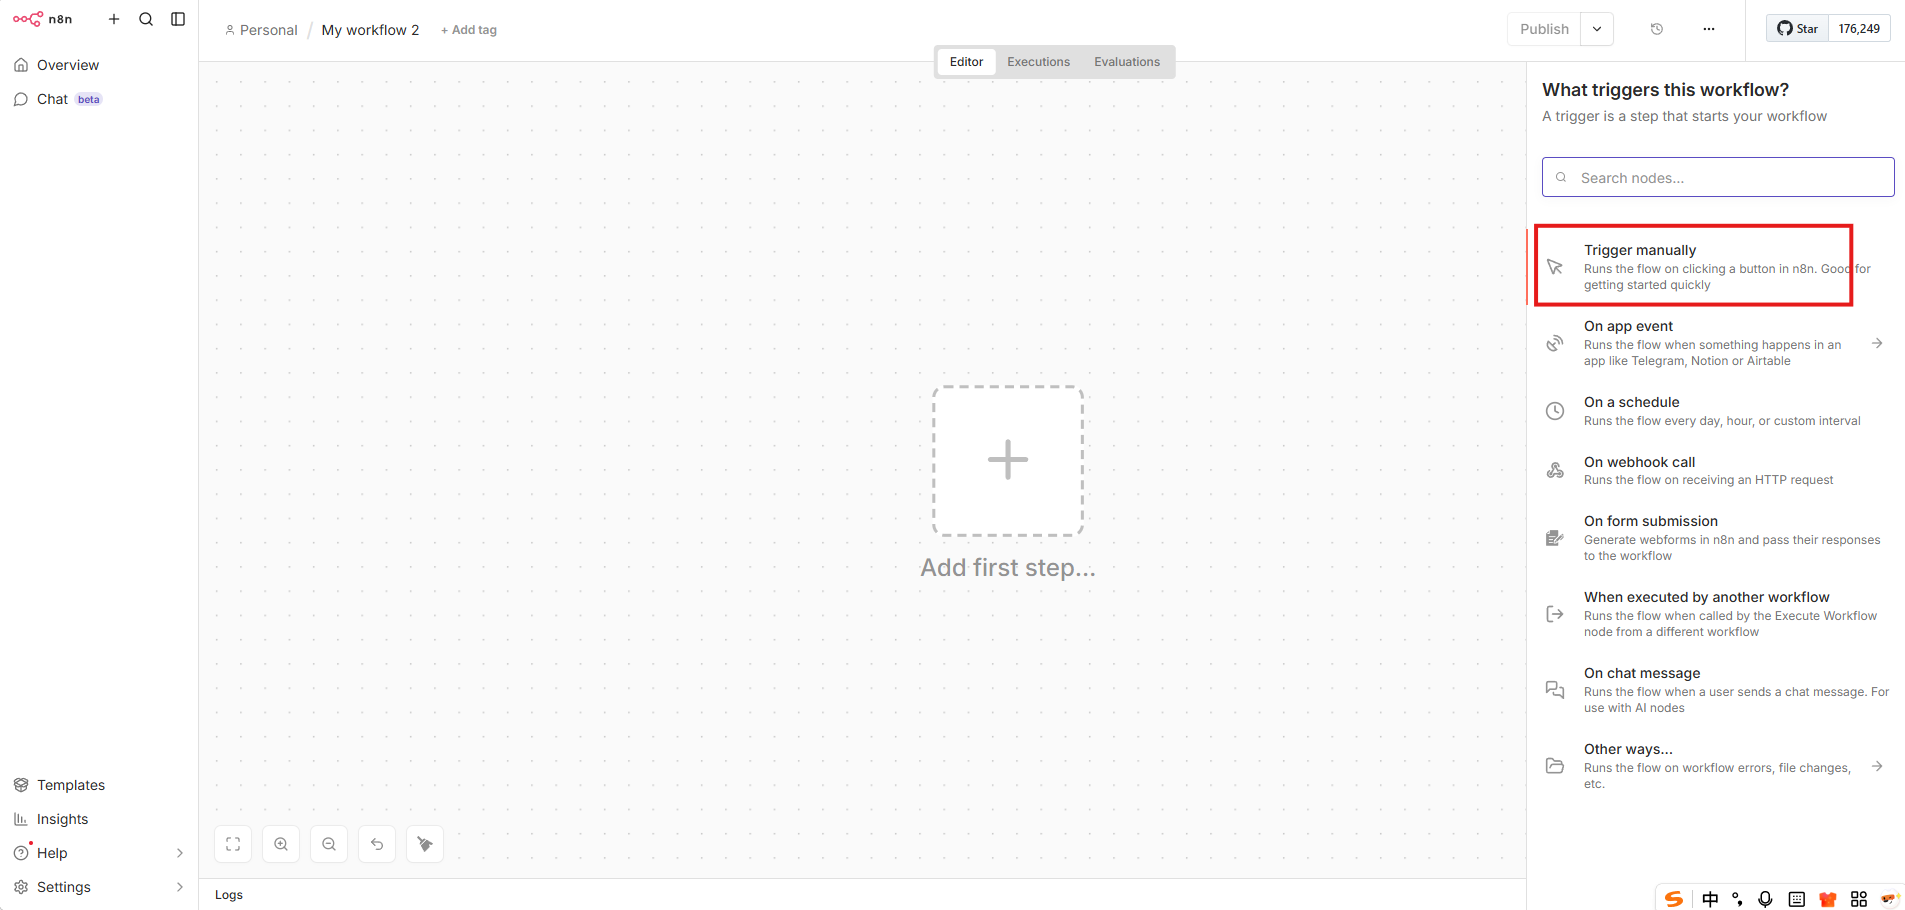
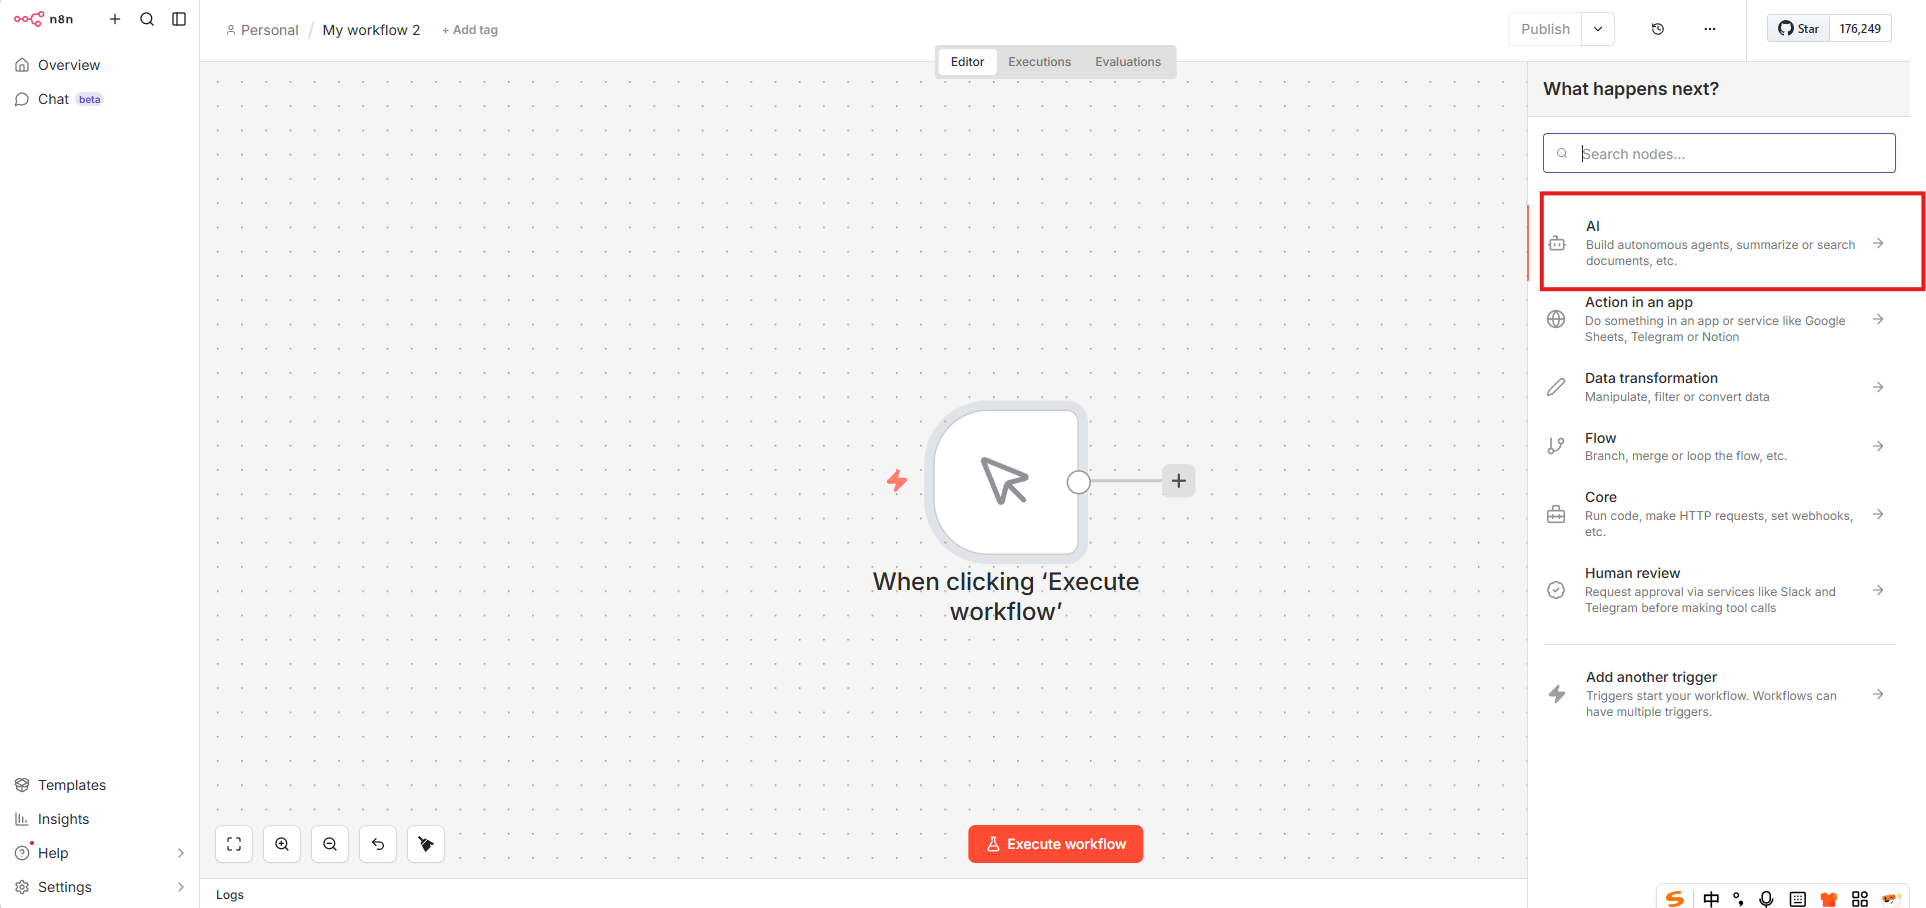
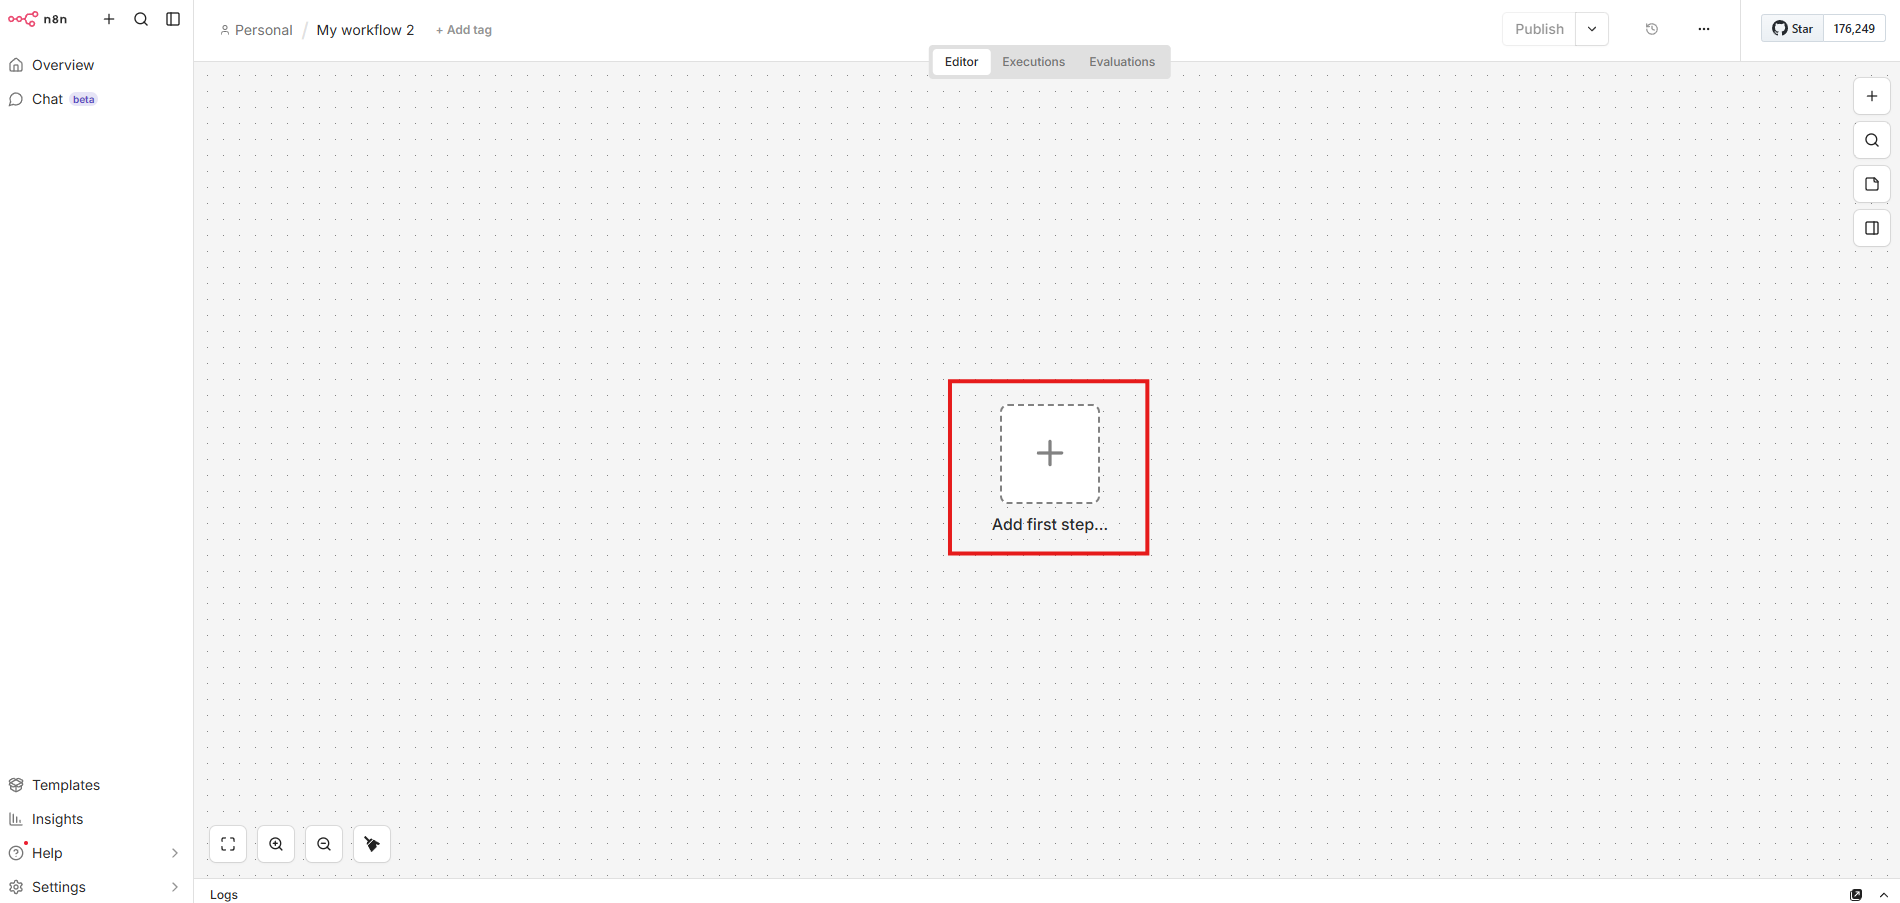
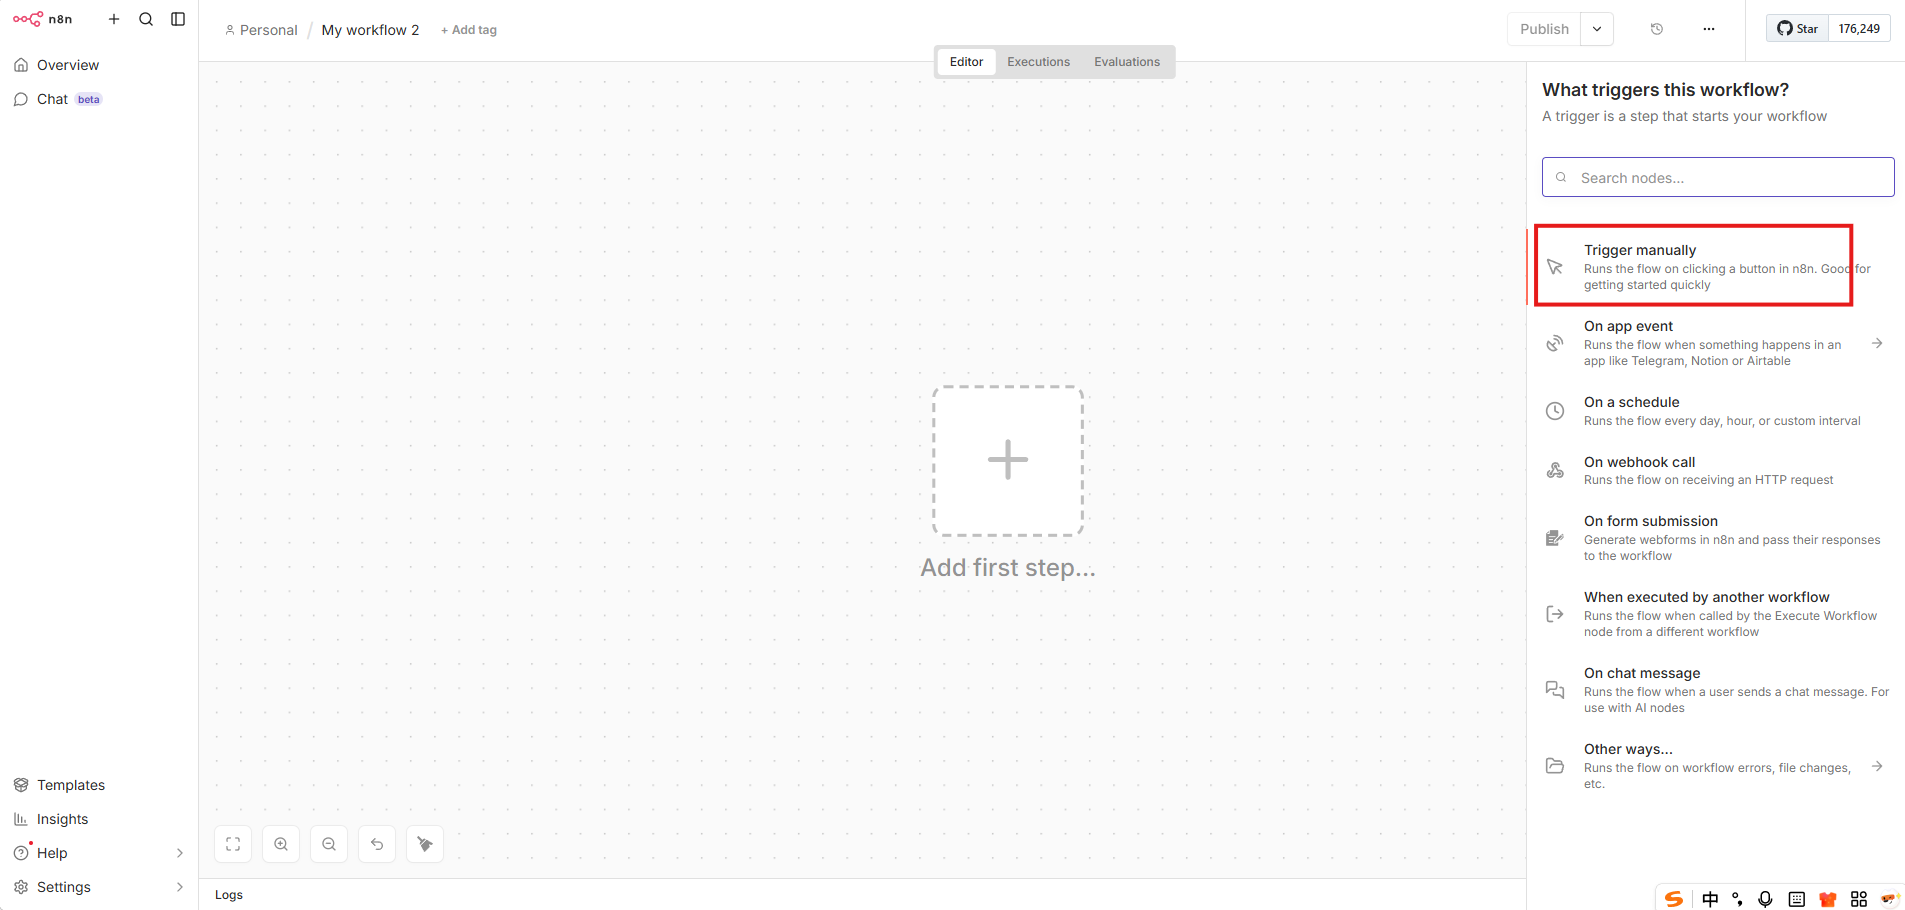
回到 n8n,点击 “Create Workflow” 新建流程。先添加一个 “Manual Trigger” 作为触发器,用于手动启动测试。
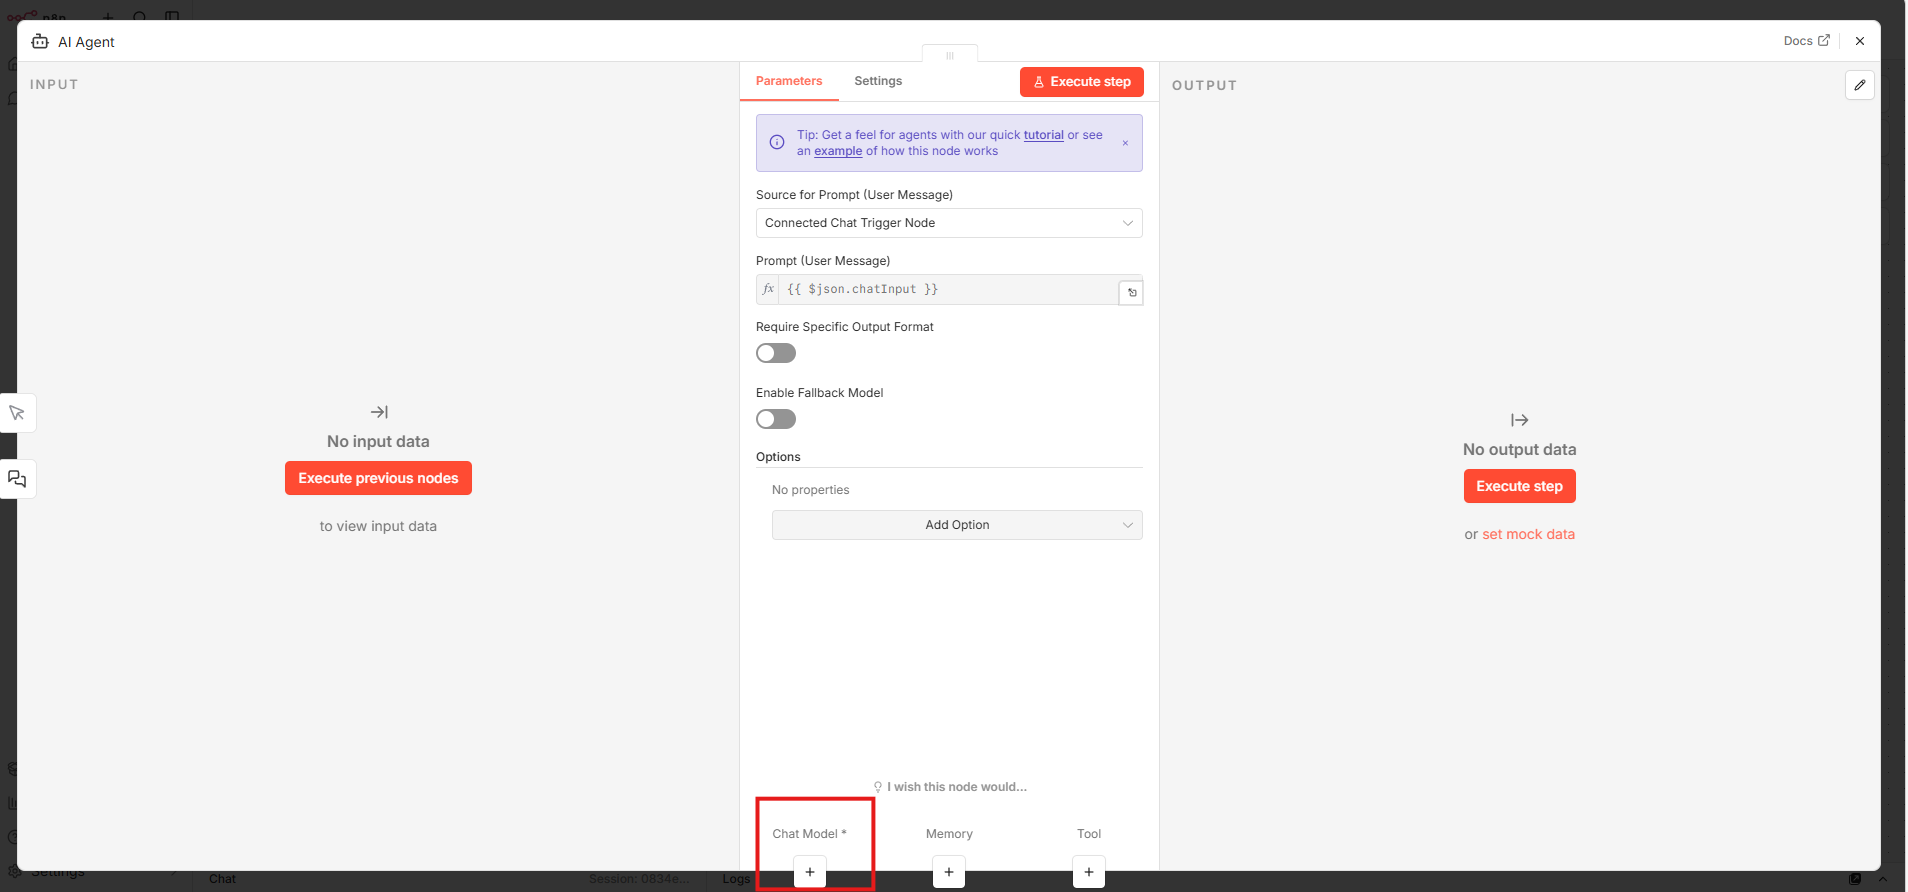
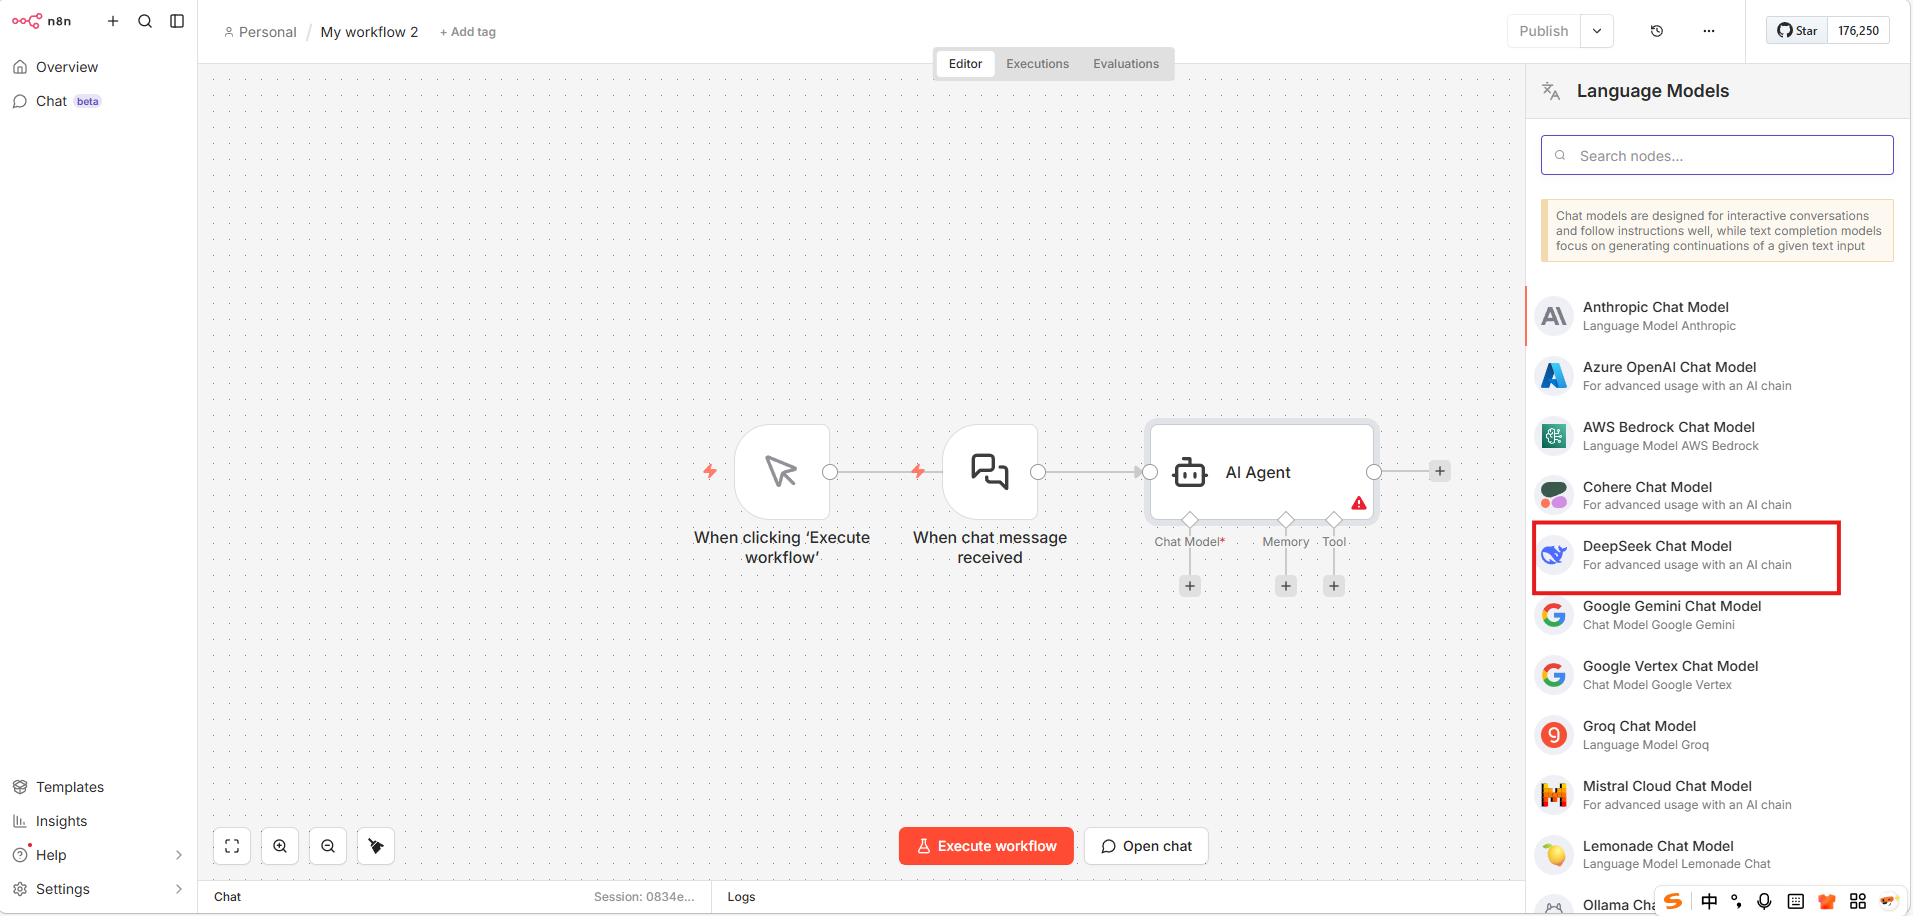
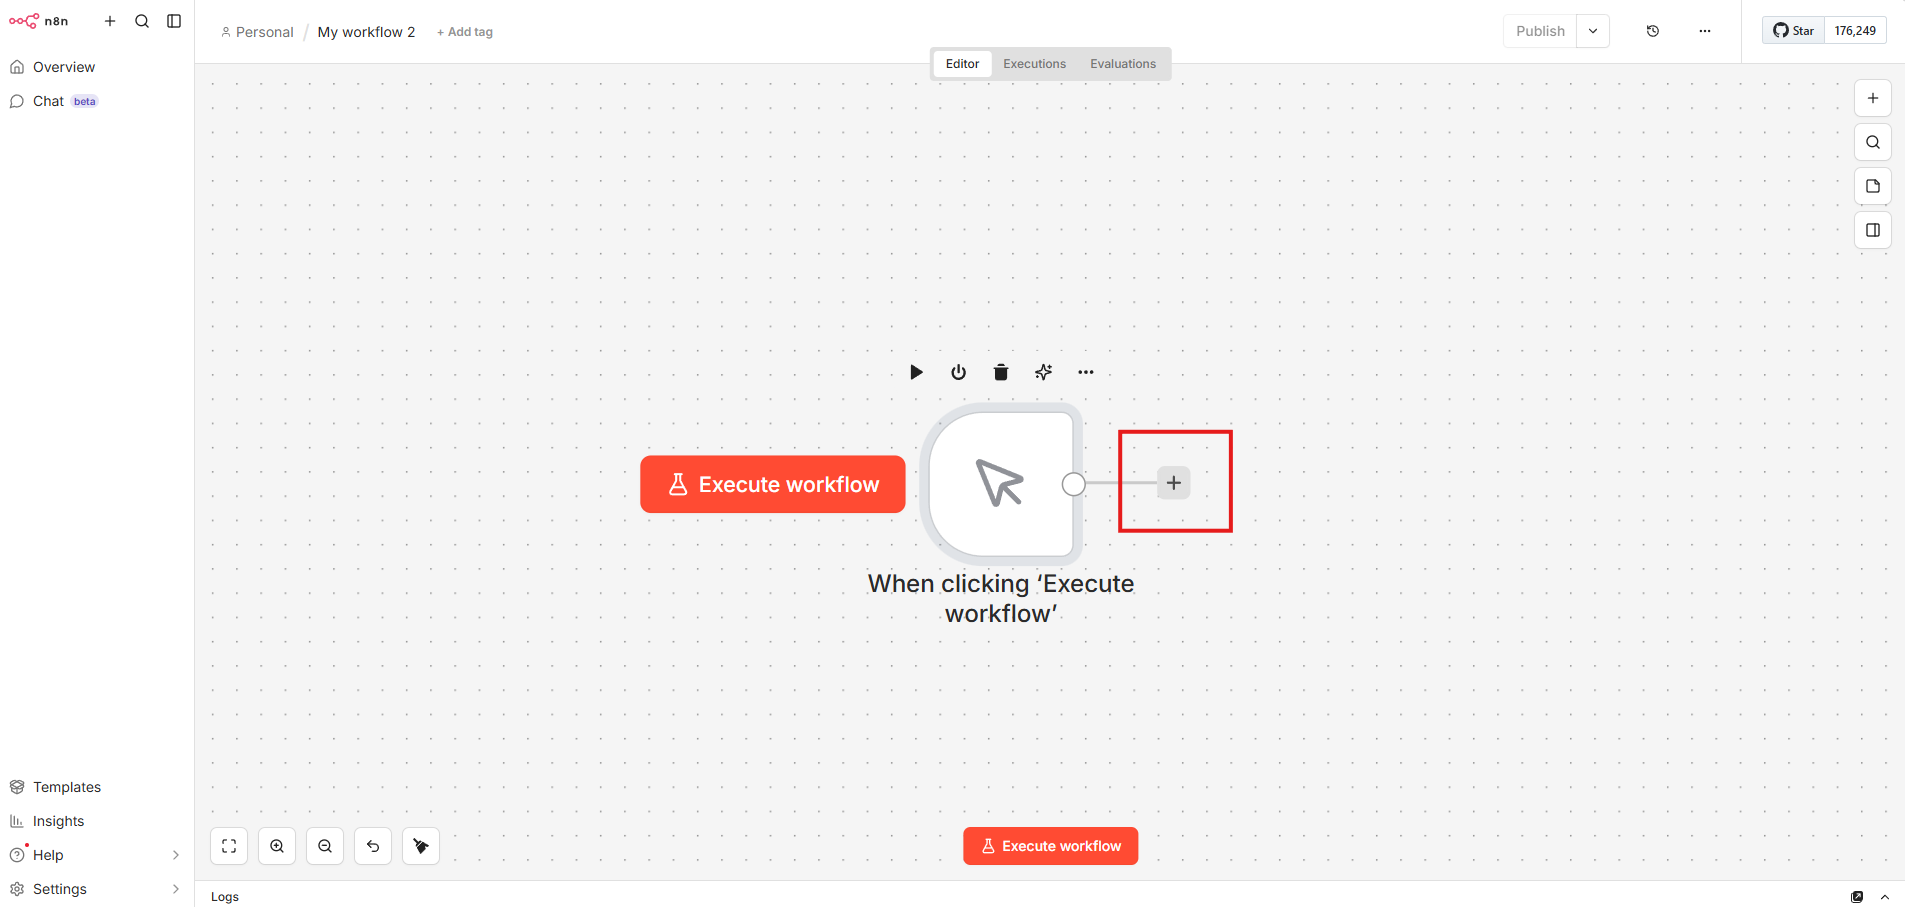
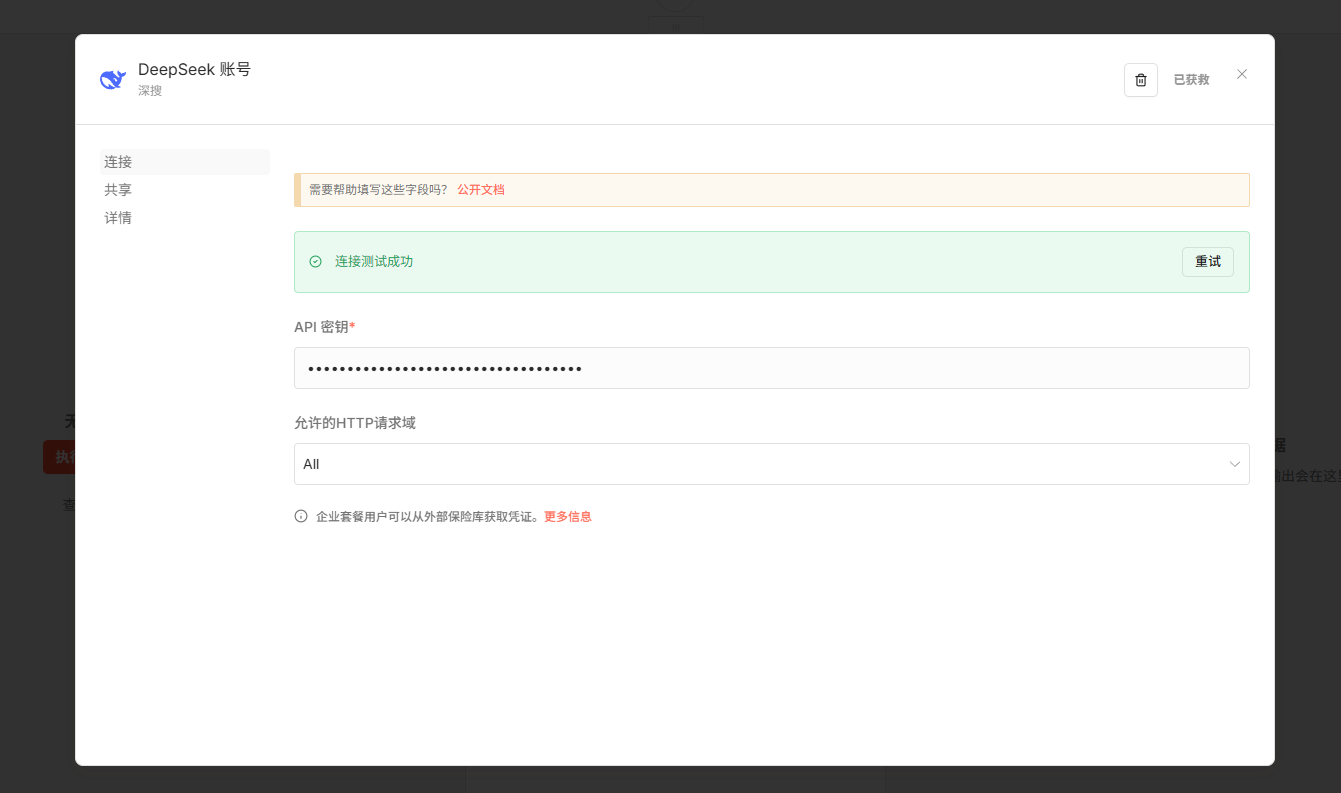
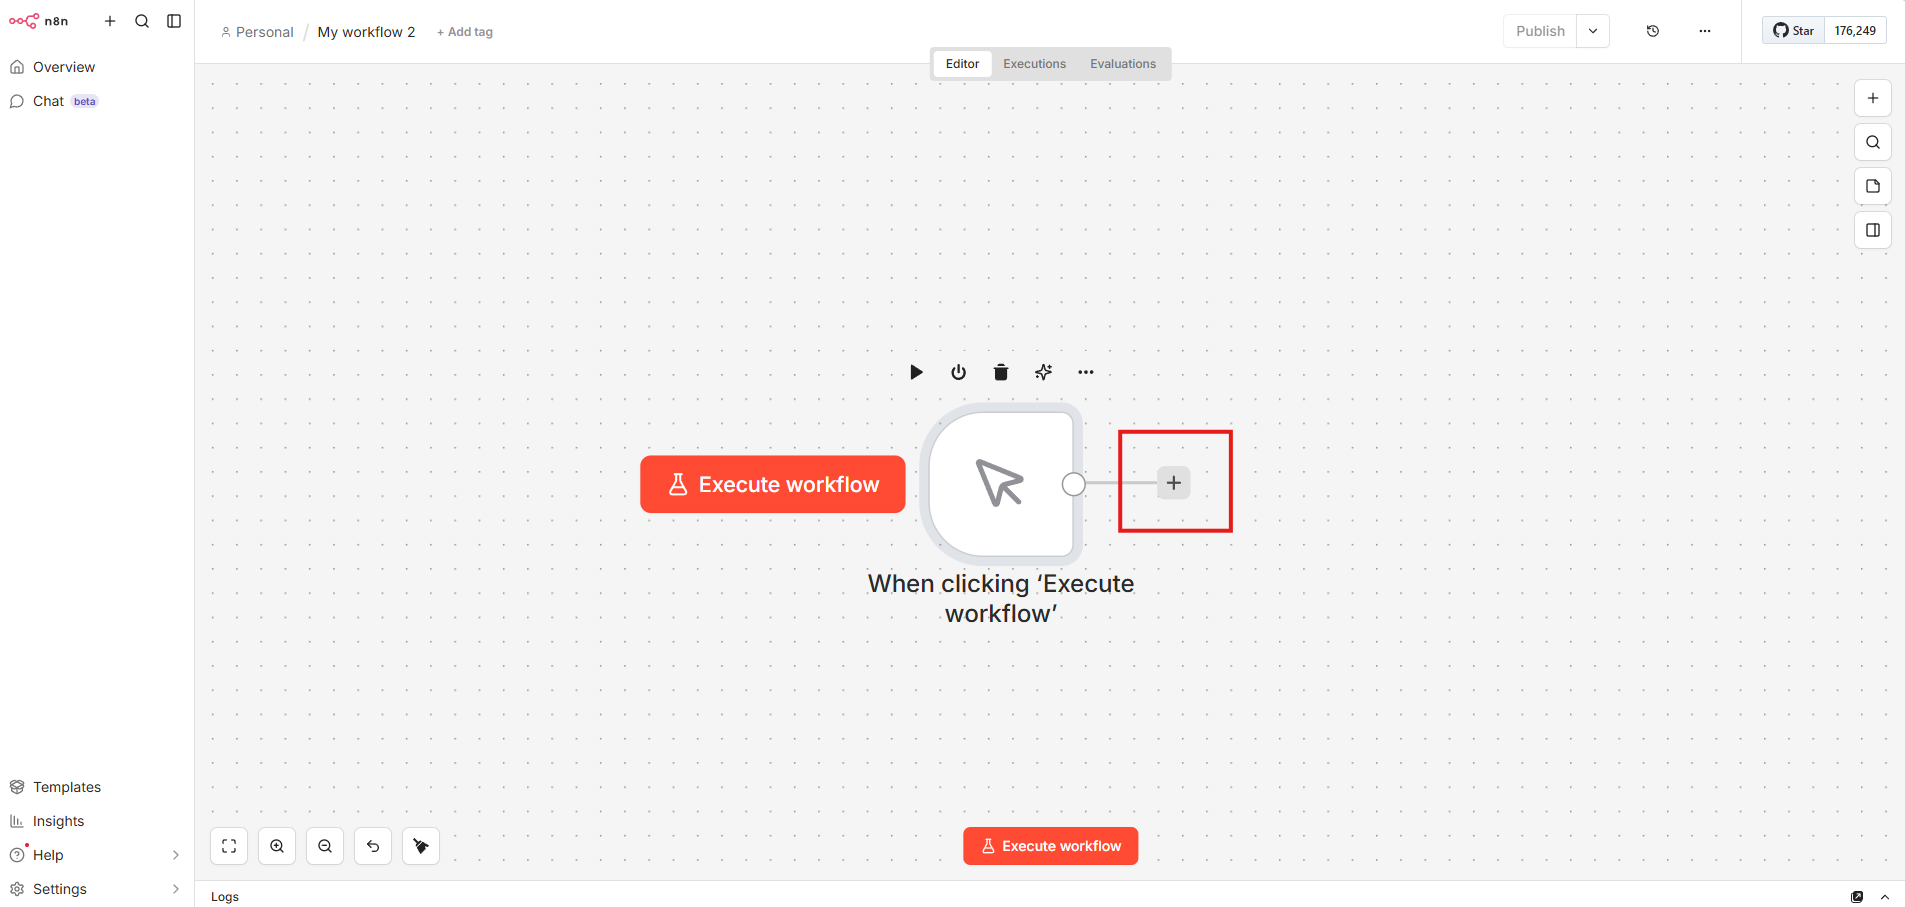
接着在触发器后面拖入 “AI Agent” 节点。在配置面板中选择模型提供商为 DeepSeek,然后填入刚才拿到的 API Key。模型可以选 deepseek-chat。
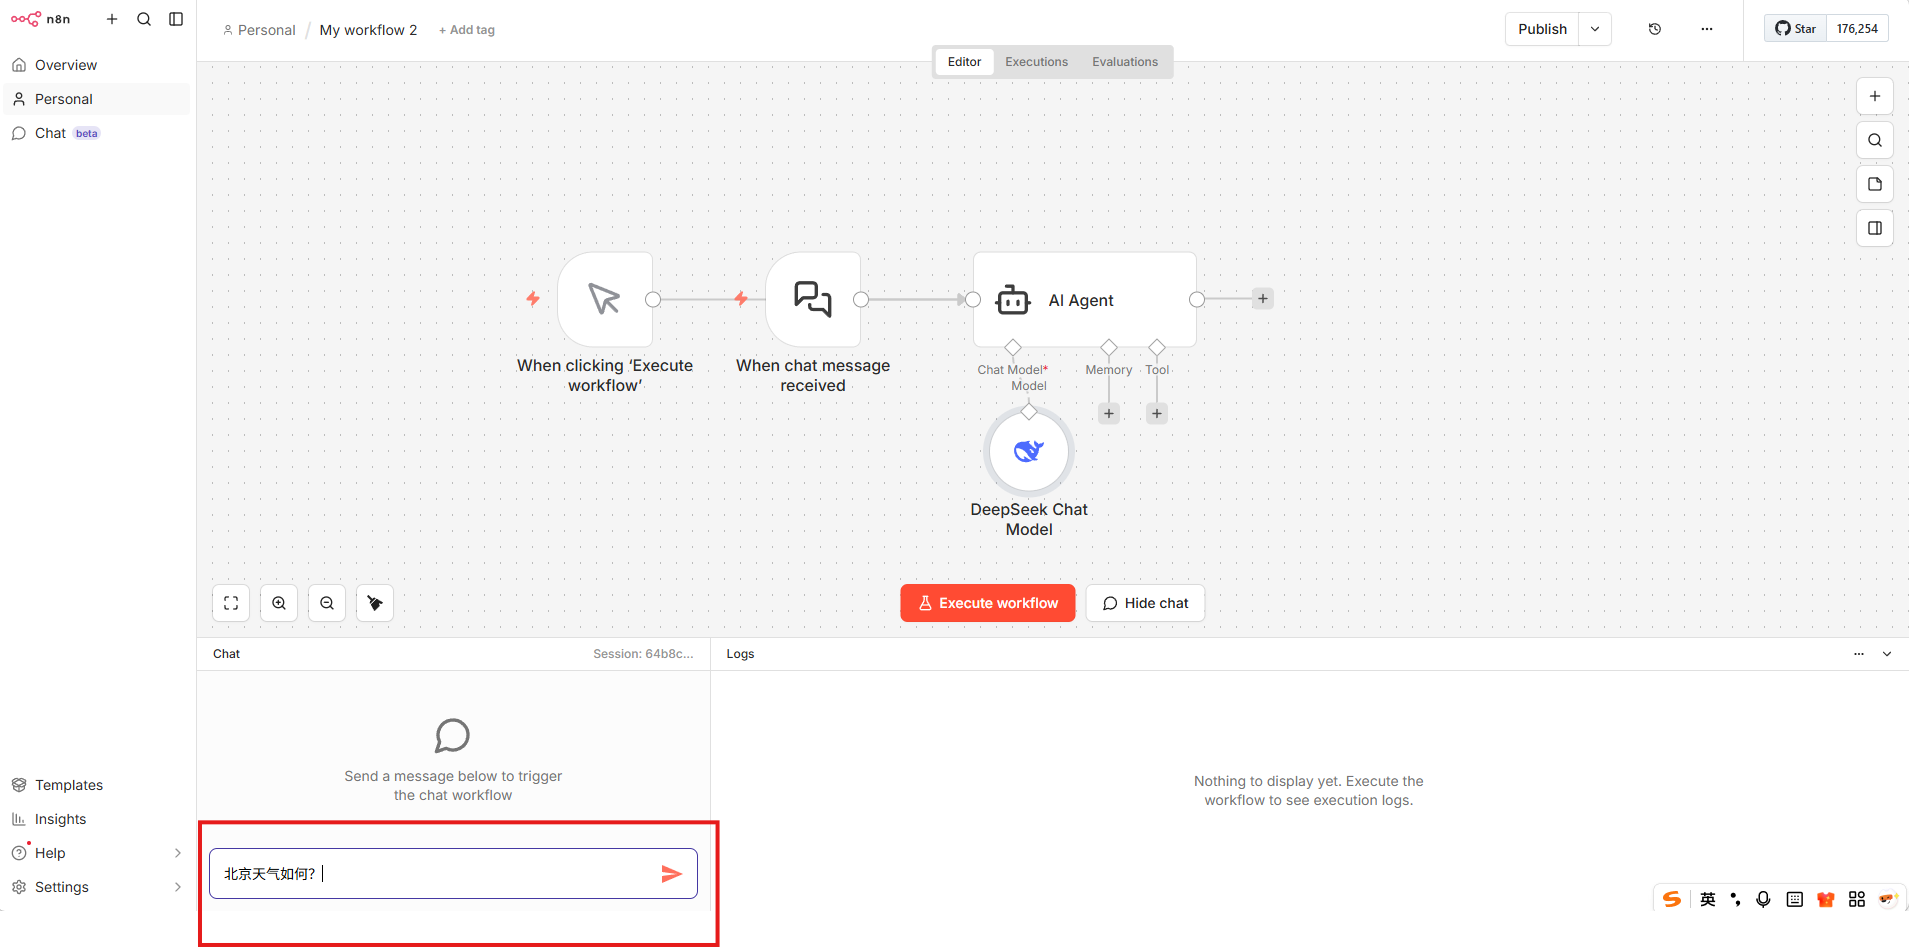
配置完成后,点击画布右上角的聊天图标,在弹出窗口里发送一条消息,比如“你好”。如果几秒后收到有效回复,说明这条链路真正跑通了:
手动触发 → AI Agent → DeepSeek API → 返回结果
这比单纯看到“密钥保存成功”更有意义,因为验证的是整个工作流的执行能力。
第二条工作流:抓取网页内容
第二条流程换种思路,不跟 AI 对话,而是让 n8n 处理网页请求。
同样新建一个工作流,添加 Manual Trigger 作为起点。
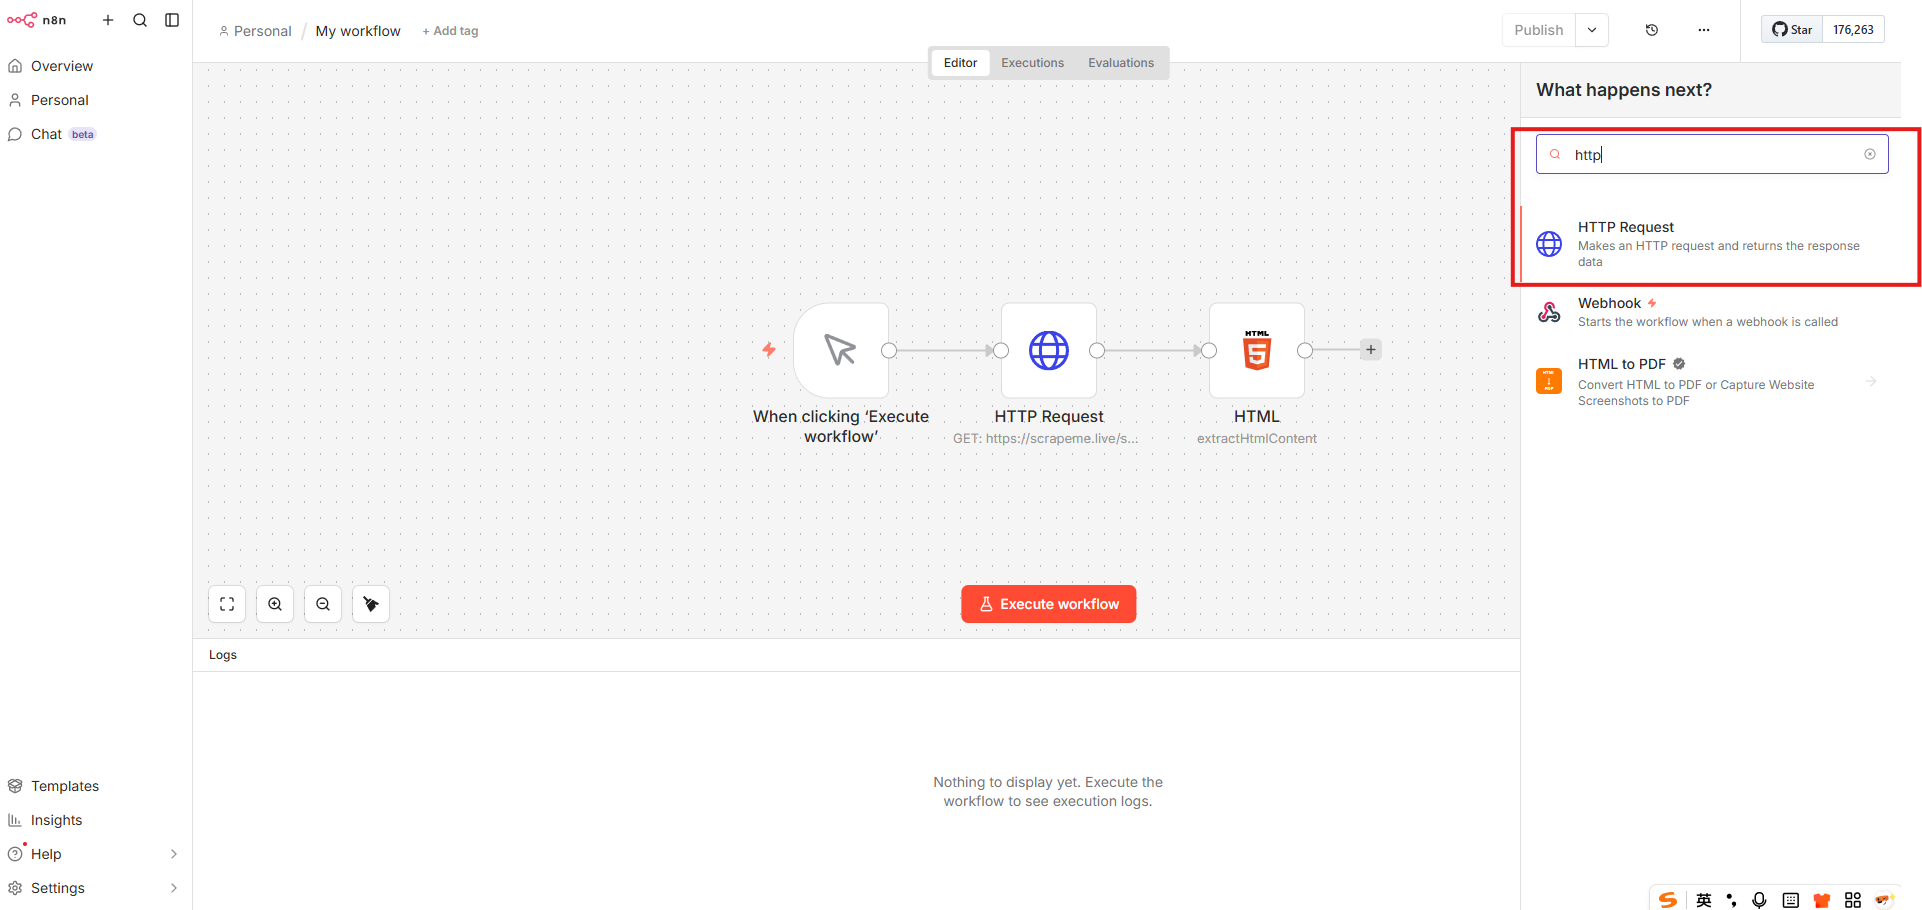
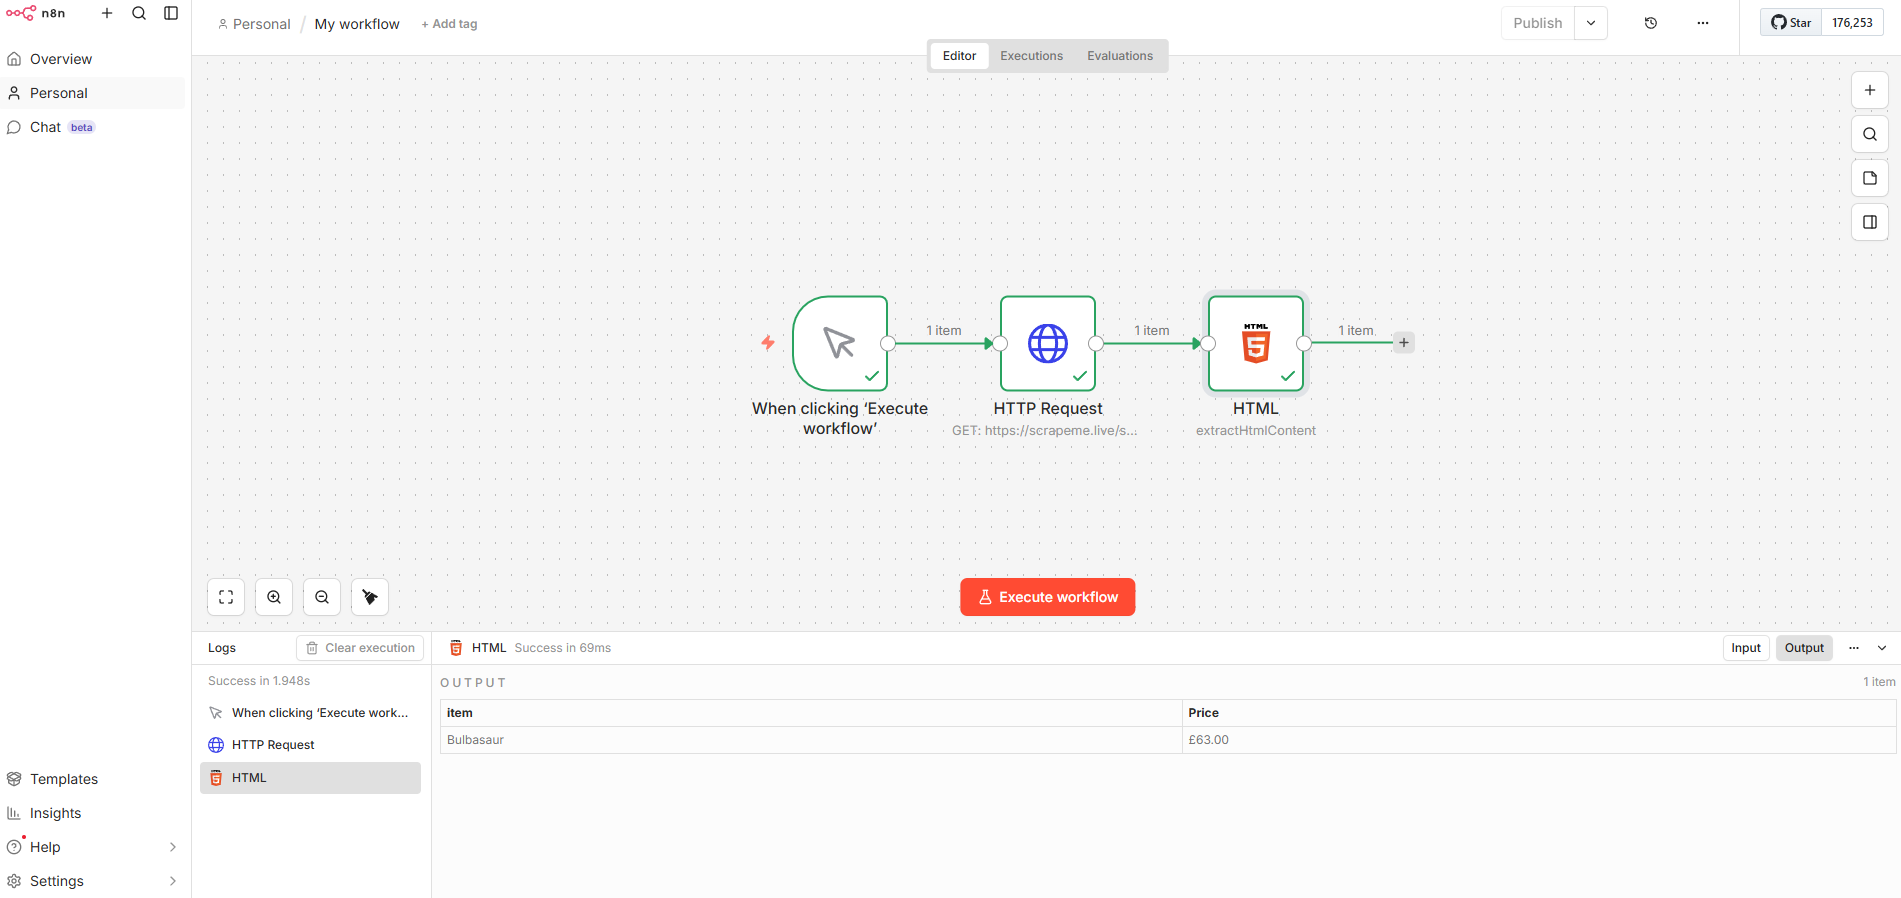
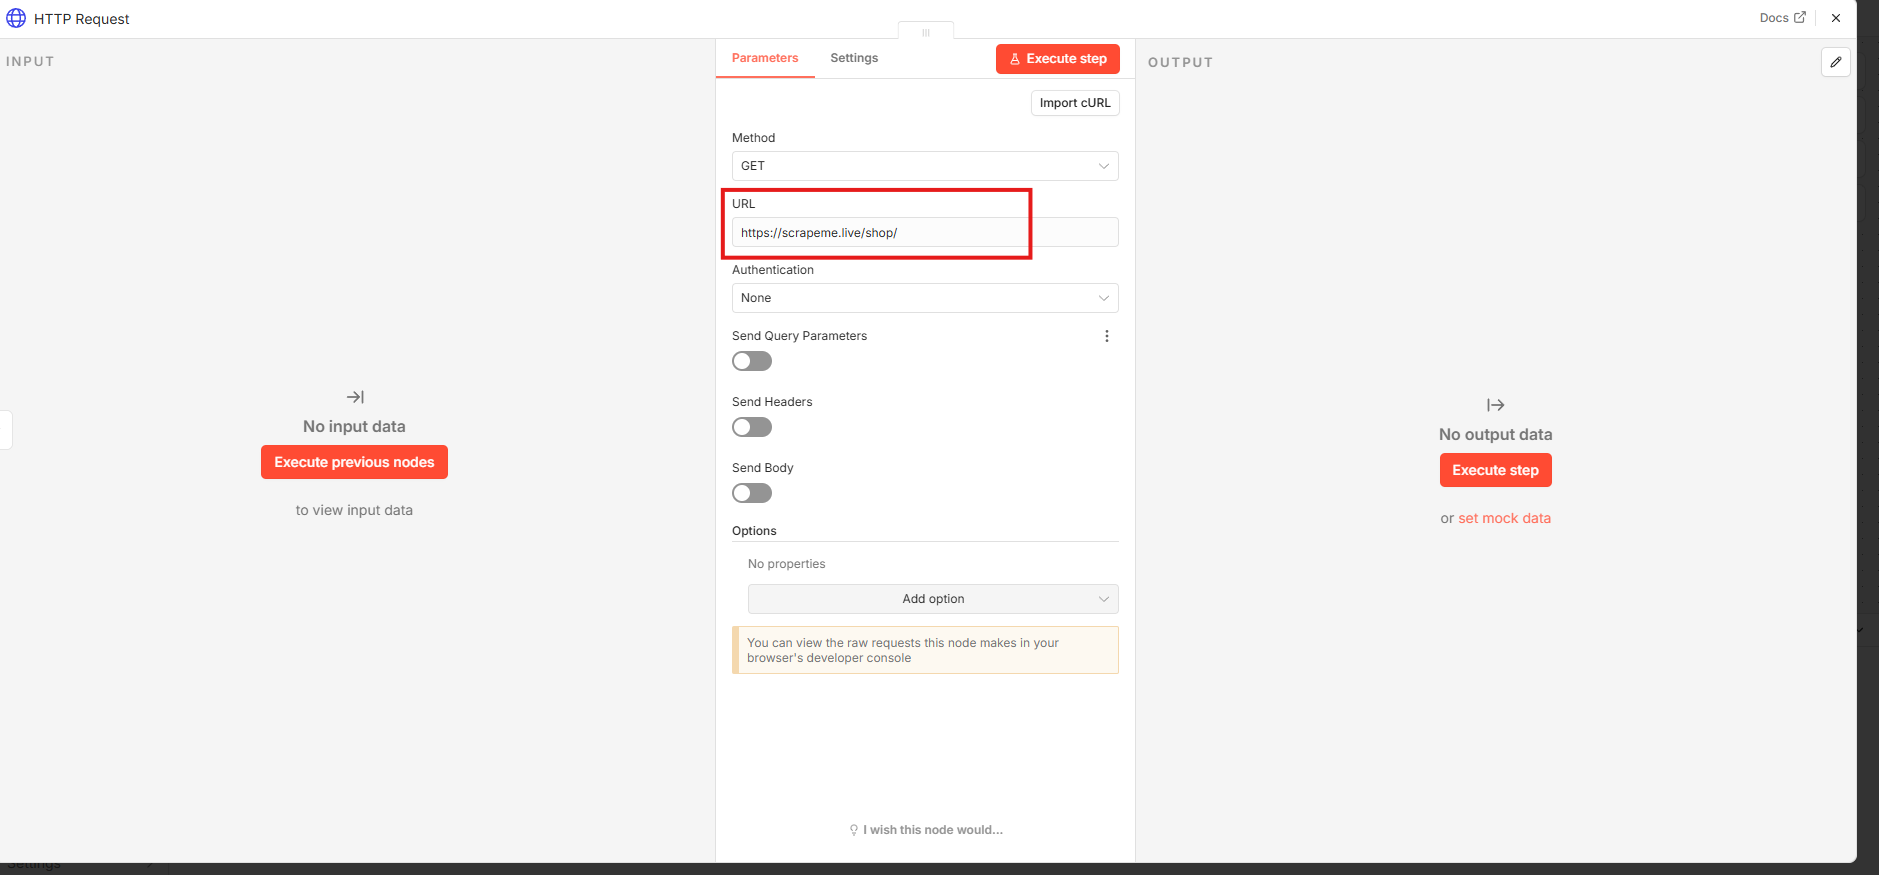
然后搜索并添加 “HTTP Request” 节点,连接到触发器。请求方法设为 GET,目标网址填 https://scrapeme.live/shop/ ——这是一个专门用于测试爬虫的公开电商页面。
接着再添加一个 “HTML” 节点,选择“Extract HTML Content”模式。这个节点会解析上一步返回的 HTML,提取结构化数据。
点击执行按钮,如果两个节点都显示绿色成功状态,说明请求和解析都完成了。可以点开 HTML 节点的输出查看提取到的商品列表。
这条流程展示的是另一种自动化模式:
手动触发 → HTTP 请求 → HTML 内容提取
和第一条 AI 流程放在一起,正好体现 n8n 的核心价值:不是某个单一功能强,而是能把不同类型的操作按逻辑串起来。
为什么本地工作流还需要公网入口?
如果只是自己手动点“执行”,本地 5678 端口完全够用。但一旦想让外部系统触发自动化,问题就来了——比如 GitHub 的 Webhook、企业微信的回调、或者手机上的快捷指令,它们都需要一个公网可访问的地址。
这时候引入 cpolar 就很清晰:n8n 只负责编排工作流,cpolar 只负责把本地 5678 端口映射出去。两者职责分明,网络层和业务逻辑不会混在一起。
用 cpolar 暴露 n8n 到公网
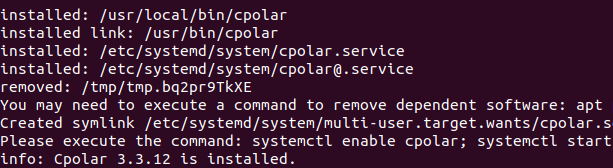
先安装 cpolar:
sudo curl https://get.cpolar.sh | sh安装完成后检查服务状态:
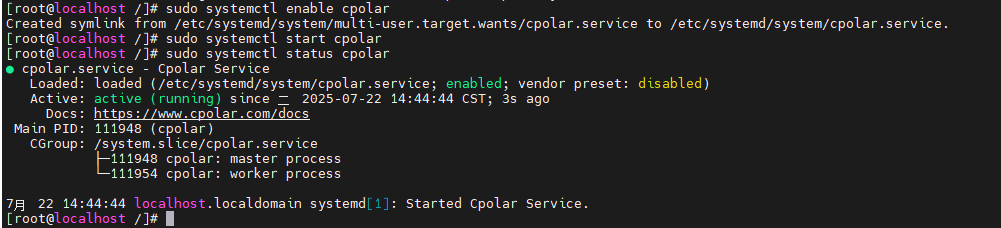
sudo systemctl status cpolar然后通过 http://服务器IP:9200 访问 cpolar 的 Web 管理界面,用注册账号登录。
先用随机域名测试连通性
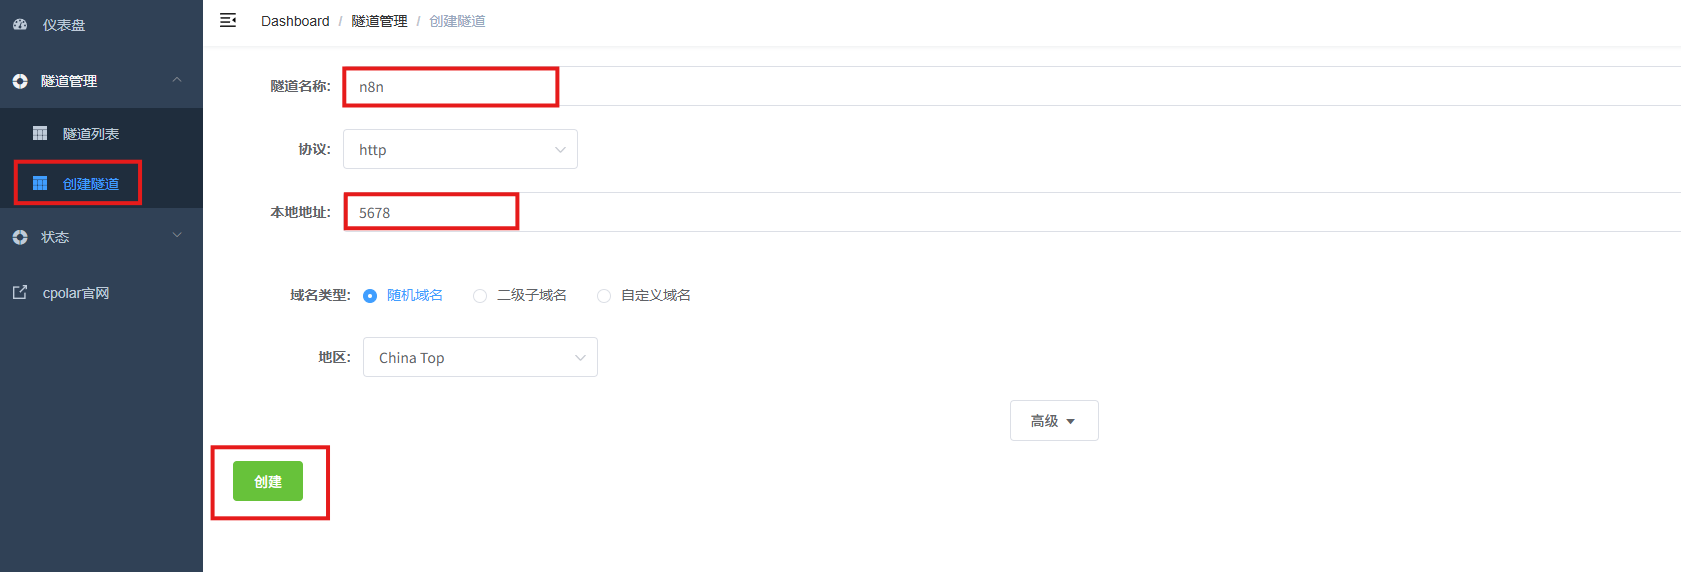
在【隧道管理 → 创建隧道】里配置:
- 隧道名称:
n8n - 协议:
http - 本地地址:
5678 - 域名类型:随机域名
- 地区:
China Top
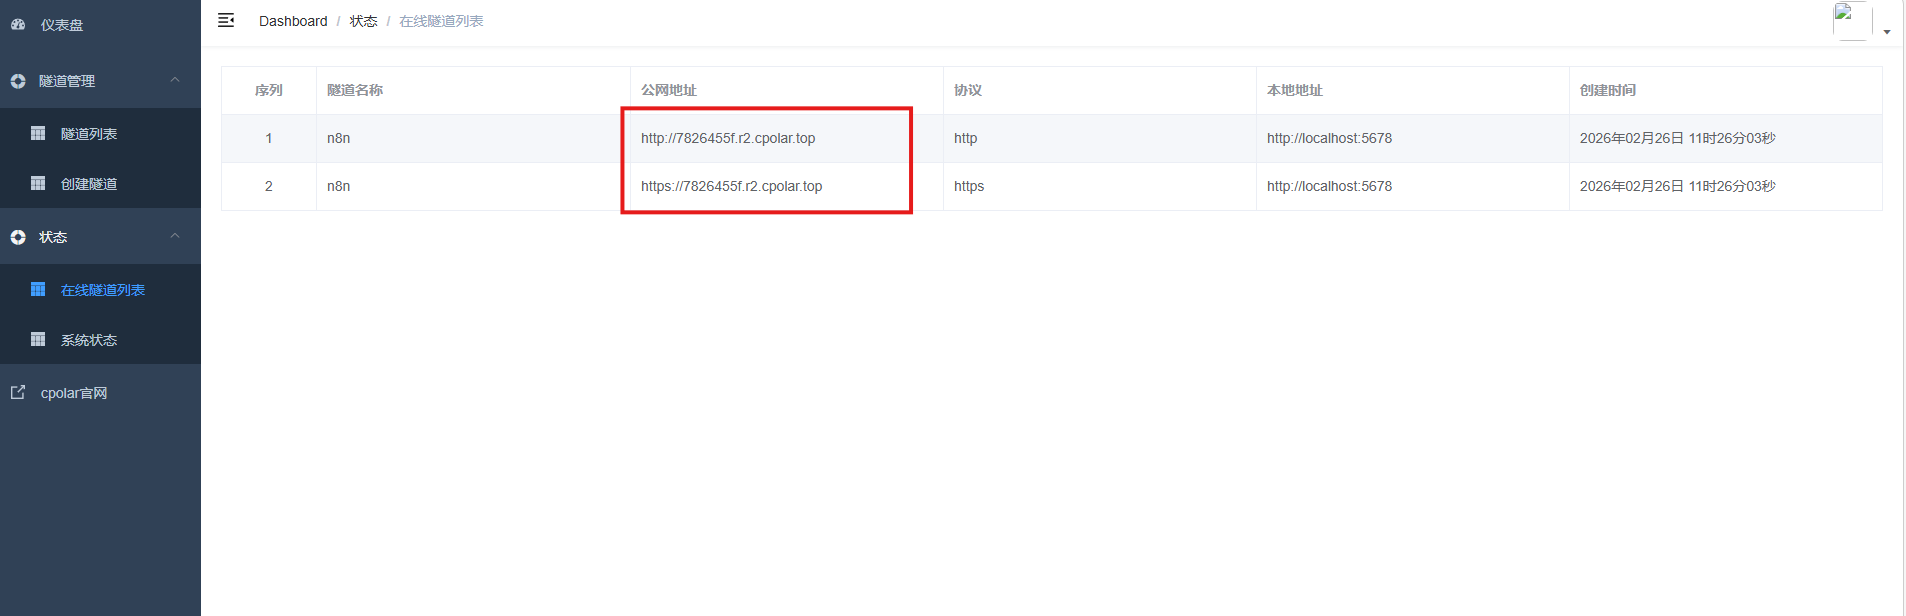
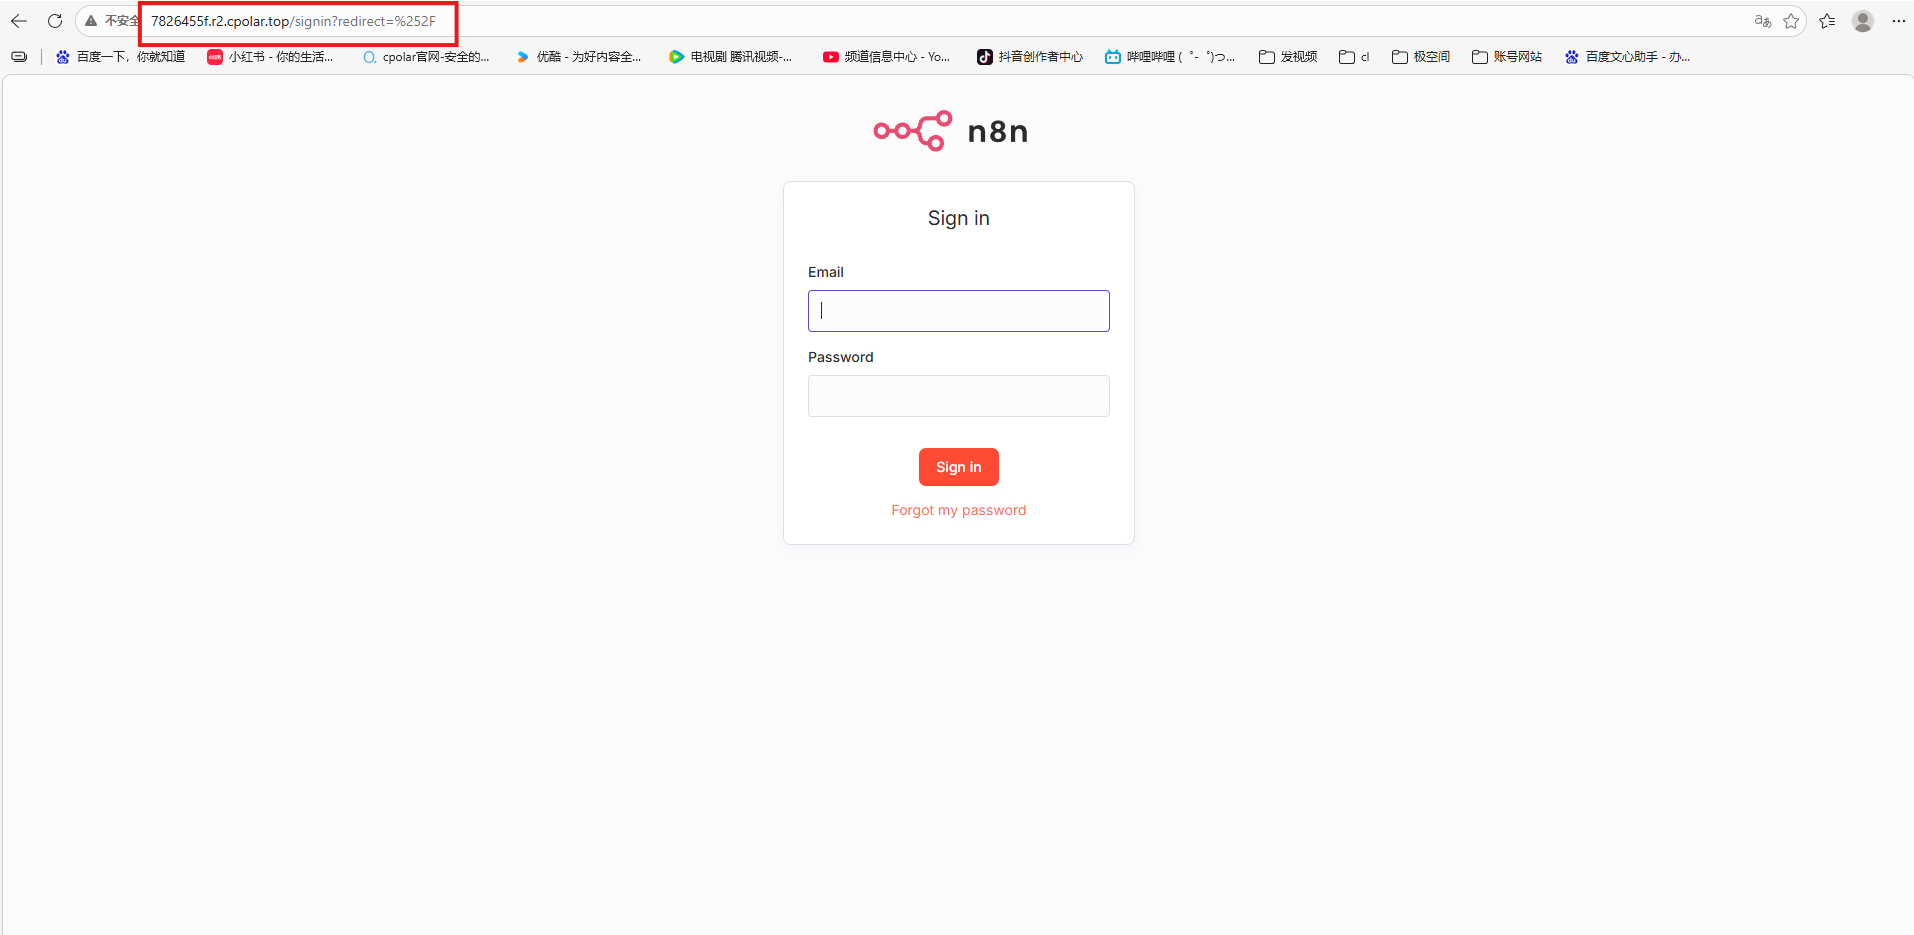
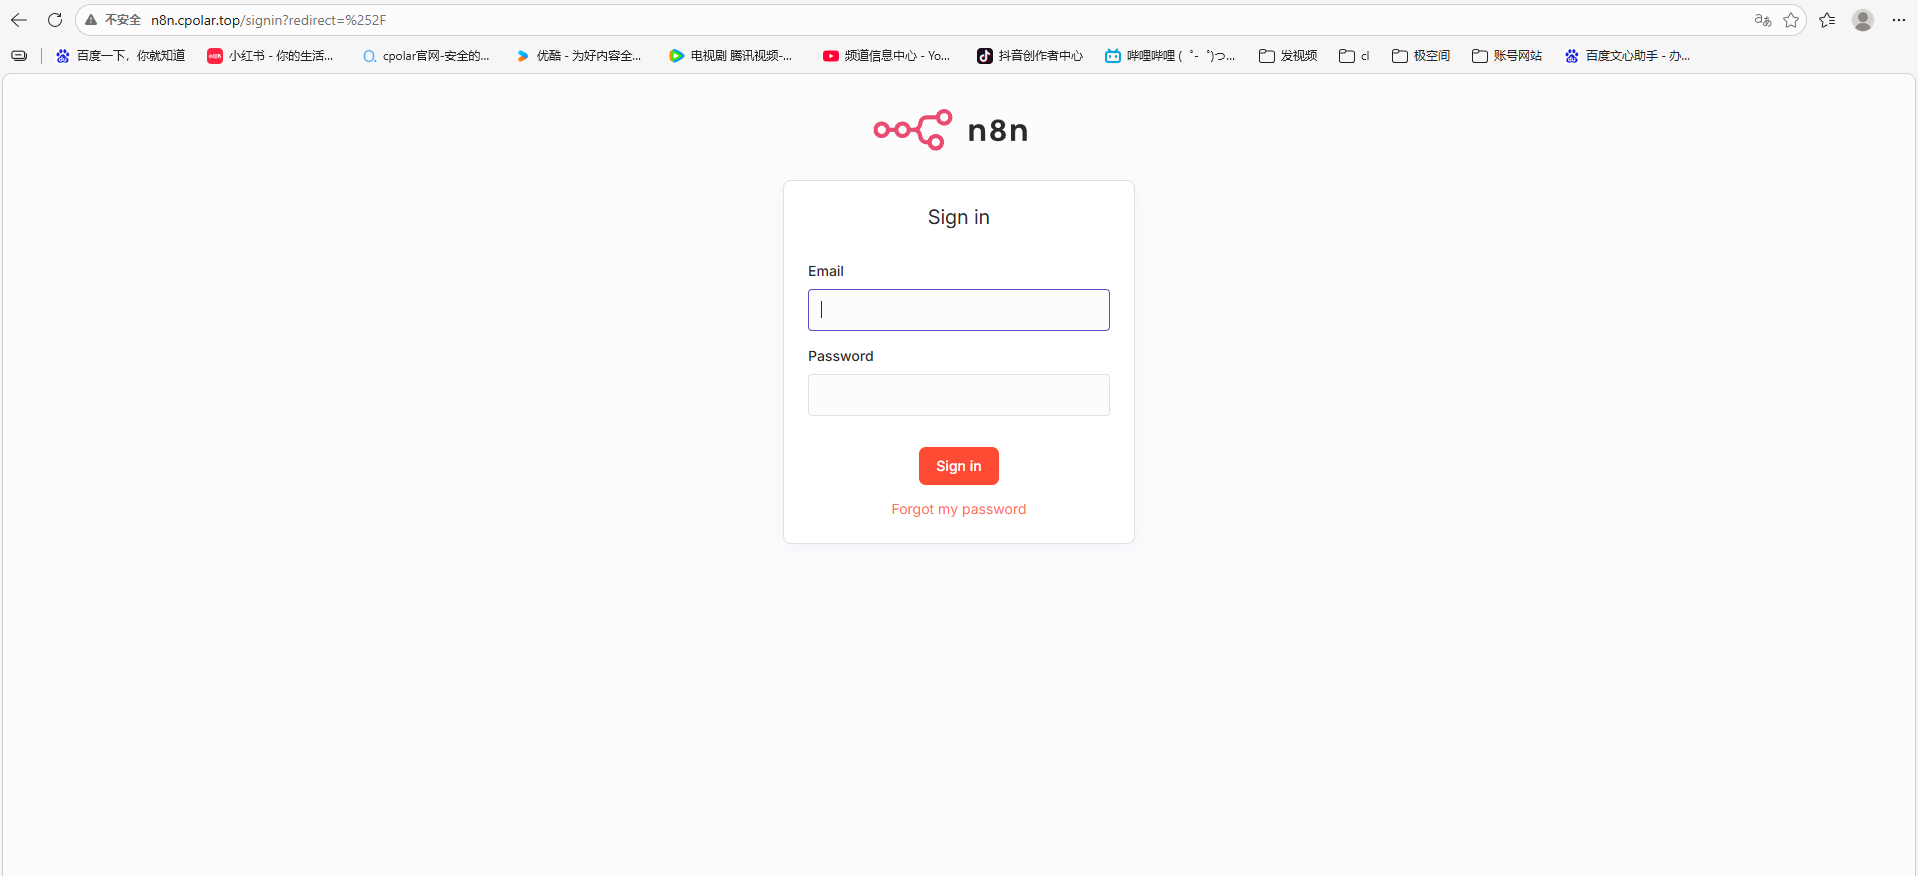
创建后,在“在线隧道列表”里会看到一个形如 xxx.cpolar.top 的公网地址。用手机或其他设备访问这个地址,如果能打开 n8n 登录页,说明映射成功。
配置固定二级子域名
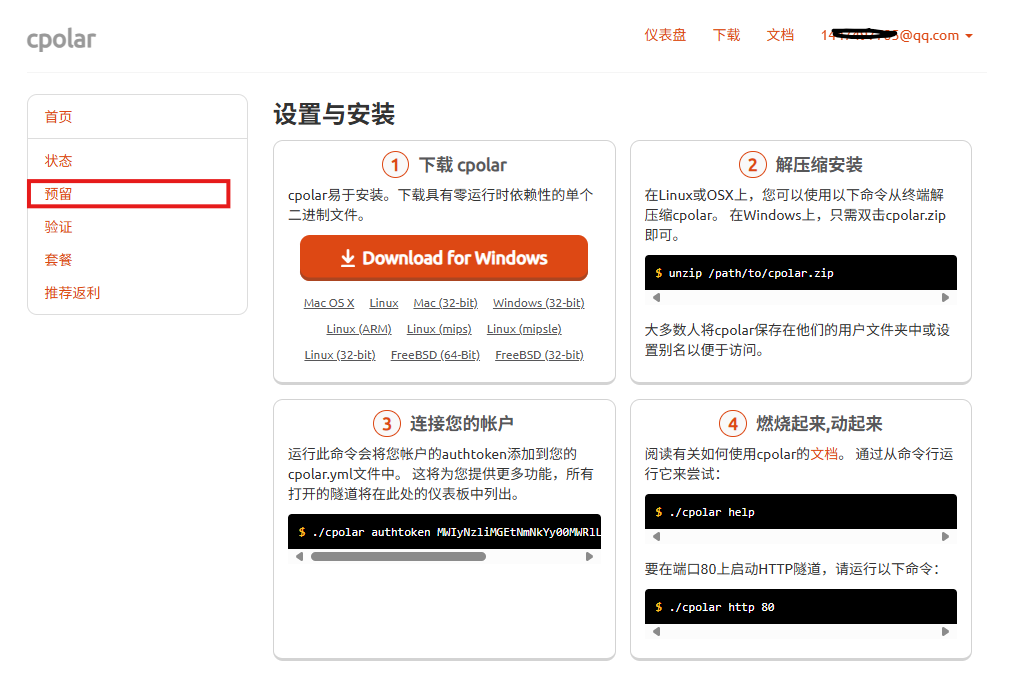
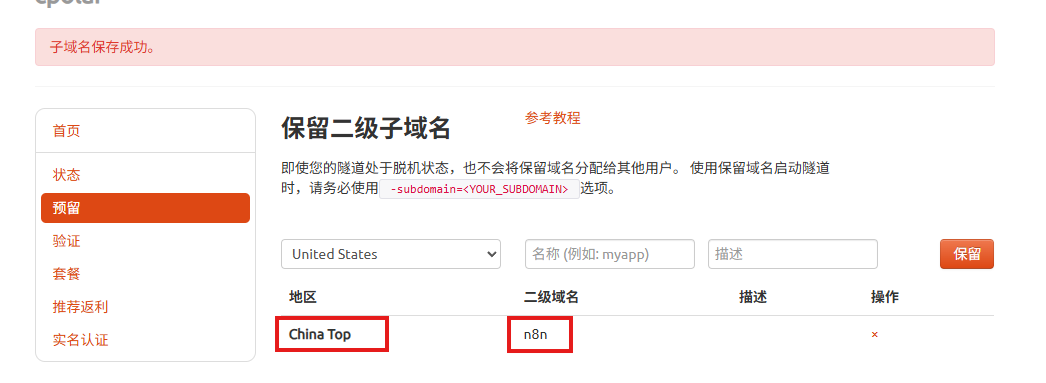
随机地址适合临时测试,但长期使用还是固定域名更可靠。在 cpolar 控制台的【预留】功能里,选择地区 China Top,保留一个二级子域名,比如 n8n。
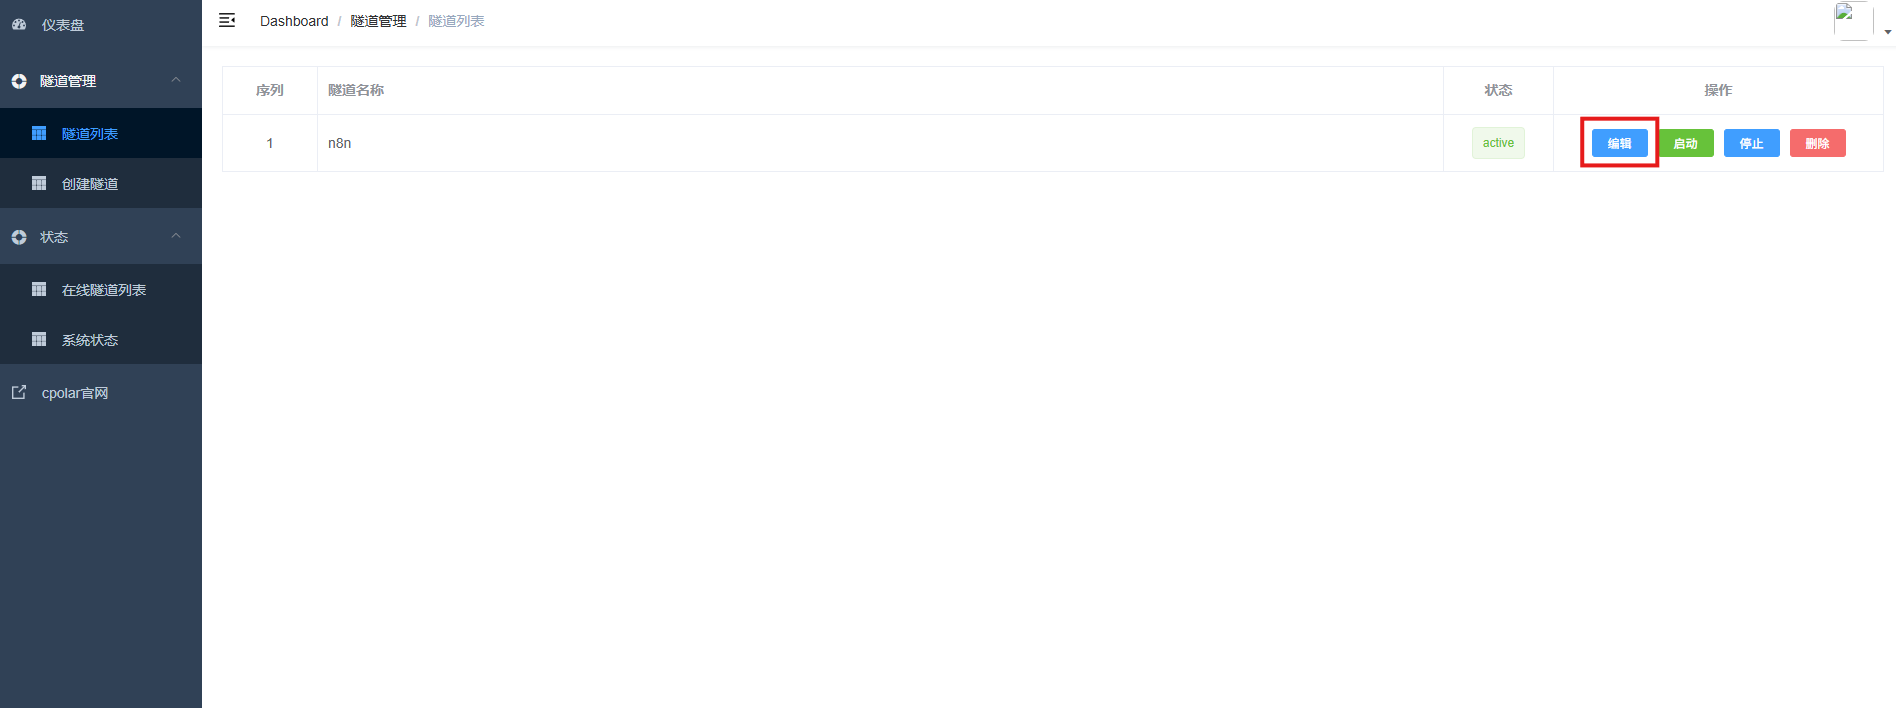
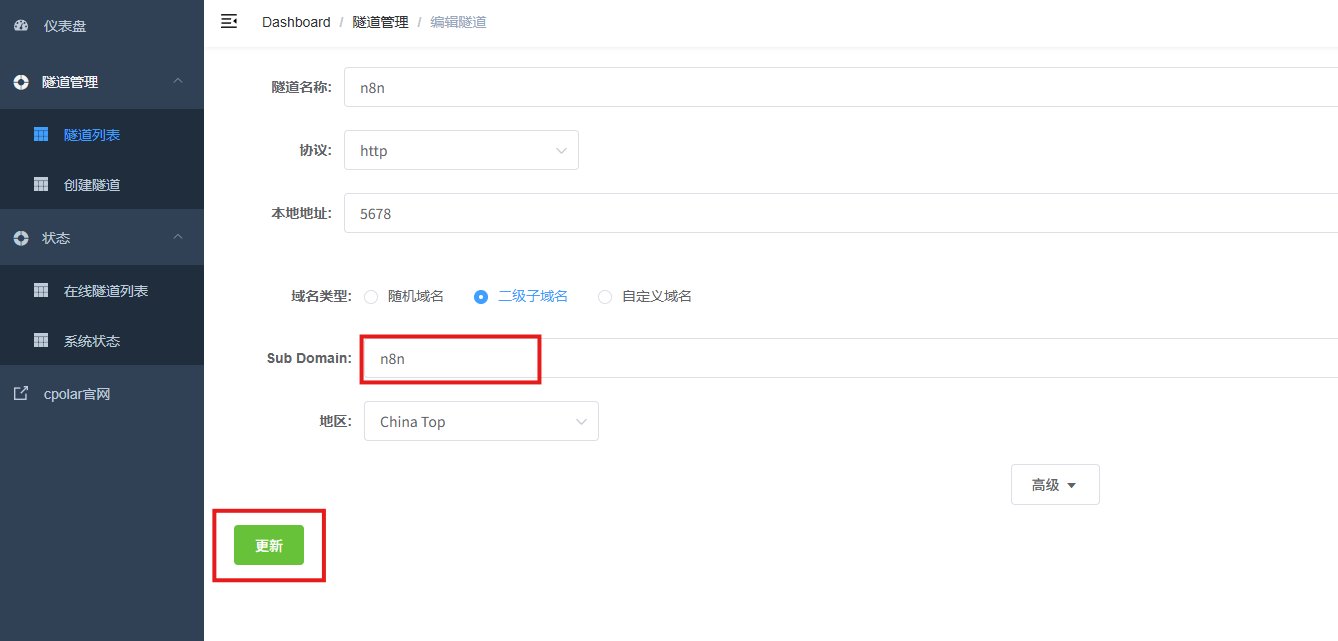
然后回到隧道列表,编辑刚才创建的隧道,把“域名类型”改成“二级子域名”,并在 Sub Domain 栏填入 n8n,地区保持 China Top,点击更新。
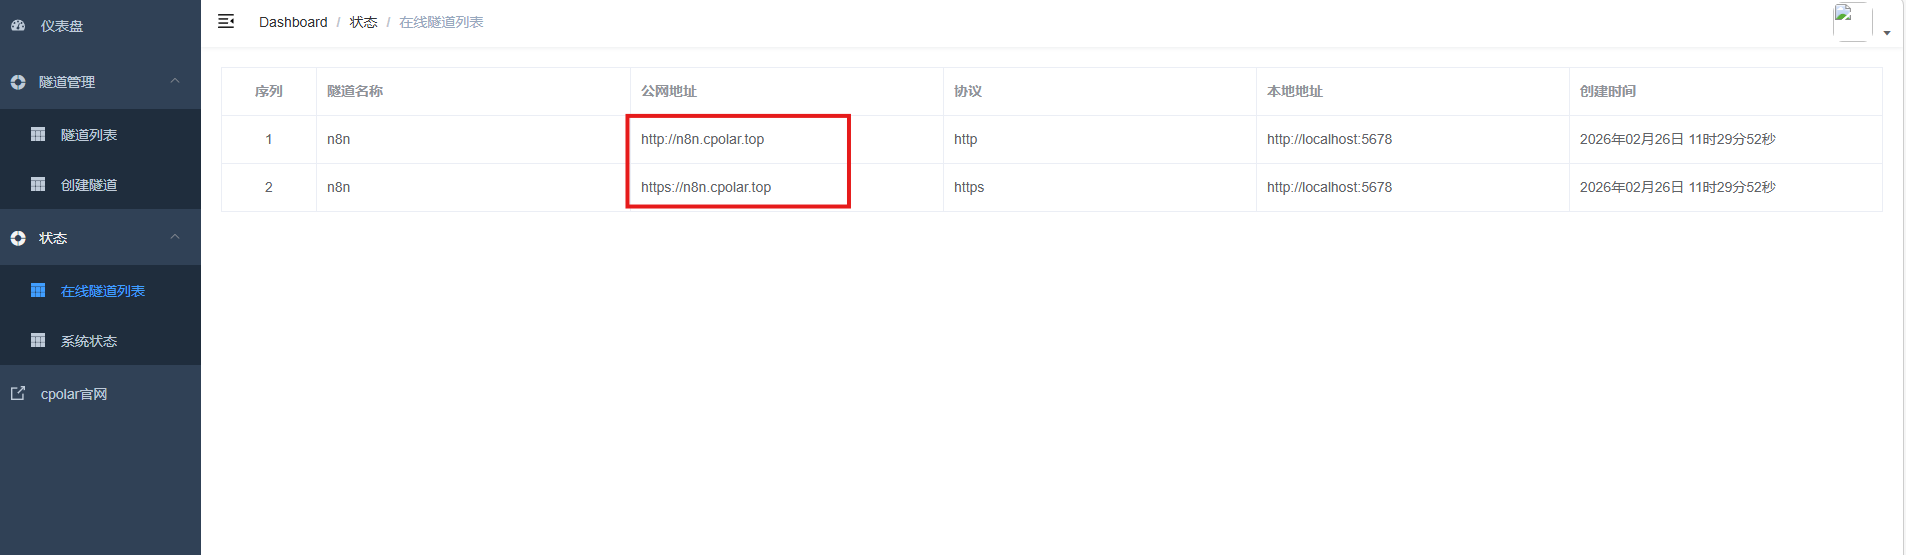
更新后,公网地址会变成 n8n.cpolar.top。再次访问,页面正常打开,说明固定映射已生效。
现在,任何外部服务都可以通过这个固定地址向 n8n 发送 Webhook 请求,触发你设计好的工作流。
总结:可视化带来的结构感
真正让我觉得 n8n 比“再写一个脚本”更顺手的,是自动化的结构终于能直接看见了:触发器在哪里、下一步调哪个节点、数据往哪流、哪一步失败,都能顺着画布查。
这次实际跑通的完整链路包括:
CentOS → Docker → n8n 容器 → 5678 端口 → 初始化 → DeepSeek AI 工作流 → 网页抓取工作流 → cpolar 随机隧道 → 固定二级子域名
所有关键配置也都落到了实处:
- Docker 的安装与镜像源设置
- 数据目录挂载
~/.n8n:/home/node/.n8n - 端口映射
5678:5678 - 基础认证开启及账号密码
- 时区与 Cookie 安全选项
- AI Agent 节点对接 DeepSeek
- HTTP Request + HTML 节点组合抓取
- cpolar 隧道配置与固定域名绑定
自动化并不会因为换成可视化工具就自动变简单,但它至少把原本散落在脚本、定时任务和接口文档里的关系,收拢到了同一个可执行、可调试、可扩展的工作流里。后面再接数据库、消息队列、通知平台或更多 AI 节点时,你是在已有流程上延伸,而不是继续往项目目录里堆新的孤立脚本。