PolaFormer++:用通道级尖锐特征映射解决线性注意力两大缺陷
线性注意力的两个硬伤
Transformer 的核心是 Softmax 自注意力,但它的计算复杂度是序列长度的平方(O(N²d))。处理高分辨率图像或长视频时,显存和算力开销迅速爆炸,根本跑不动。线性注意力试图解决这个问题——它用一个核函数 ϕ(·) 把 query 和 key 映射到新空间,把注意力写成 ϕ(Q)(ϕ(K)ᵀV) 的形式。借助矩阵乘法的结合律,复杂度能降到 O(Nd′²),看起来很美。

但代价也很明显:表达能力掉了。掉在哪?主要两处。
第一,负值被一刀切了。为了让注意力权重非负,主流线性注意力(比如用 ReLU 或 1+ELU 做映射)直接把 query 和 key 里的负数全变成零。可原始的 q·k 内积其实包含四项:正-正、负-负、正-负、负-正。前两项是同号交互,后两项是异号交互。ReLU 一上,负成分没了,后两项直接消失。模型再也拼不出完整的相似度。
第二,注意力太“平”。Softmax 有指数缩放,能让强相关的 token 权重飙升、弱相关的趋近于零,分布很“尖”。线性注意力没这机制,权重容易均匀化,信息熵高,关键信号被稀释。之前有人试过用固定幂函数强行拉尖(比如 FLatten Transformer),但所有通道用同一套参数,忽略了不同通道本该有不同的尖锐需求。
PolaFormer 的极性思路
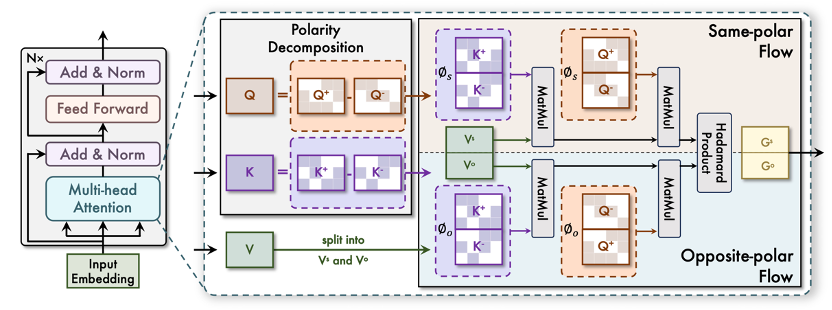
去年 ICLR 上的 PolaFormer 先迈了一步:既然负值重要,那就别扔,而是显式拆开。它把 q 和 k 按元素拆成正部和负部(q = q⁺ − q⁻,k = k⁺ − k⁻),然后让同号部分(q⁺·k⁺ + q⁻·k⁻)走一路,异号部分(−q⁺·k⁻ − q⁻·k⁺)走另一路。Value 向量也沿通道一分为二,分别接收两路信号。最后用两个可学习的门控矩阵 Gs 和 Go 对输出做加权,既补偿了“减法”操作的松弛,又保证最终权重非负。
这个设计让正负信息都能参与计算,重建相似度的能力强了不少。但它还是用统一的特征映射,尖锐度没法按需调节。
PolaFormer++:给每个通道配个“温度旋钮”
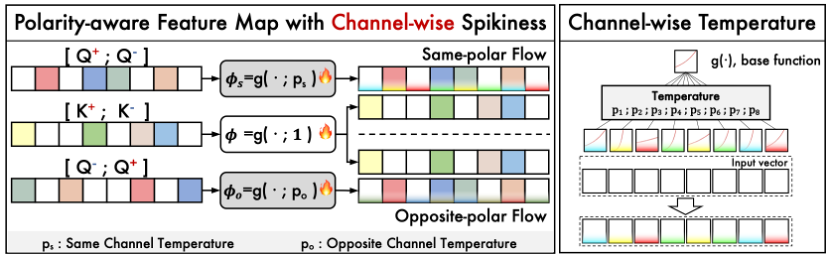
PolaFormer++ 的核心升级,就是把尖锐度从“全局统一”变成“通道级自适应”。作者提出了一种叫 PaCS(Polarity-aware Channel-wise Spiky)的特征映射。
具体做法是:以指数函数为基底,给每个通道配一个可学习的温度系数 p(用 sigmoid 归一化到 (0,1) 区间)。映射公式长这样:
ϕ(x; p) = (exp(p₁x₁), …, exp(p_d x_d)) − 1
同号流和异号流各自拥有一套温度向量 ps 和 po,所以有两套独立的映射 gs(·; ps) 和 go(·; po)。这样一来,每个通道、每条流都有自己的“尖锐度旋钮”——判别性强的响应可以被放大,次要的则被压平,强弱信号自然分离。
网络真的学出了差异吗?
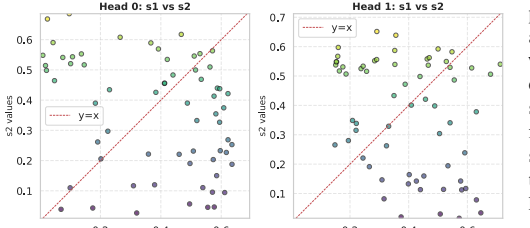
作者做了可视化验证。把训练完的同号流两个温度参数 (s₁, s₂) 按通道画成散点图,发现点云大面积弥散,明显偏离 y = x 对角线。这说明网络没偷懒,真给不同通道学出了高度独立的尖锐行为,而不是趋同于某个固定值。
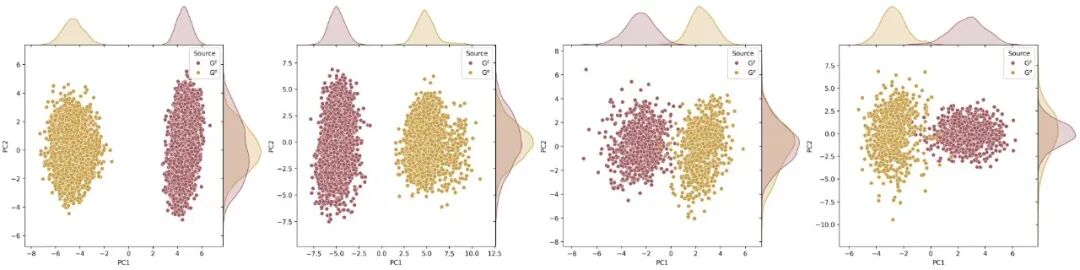
再看极性门控矩阵 Gs 和 Go。对多个层的矩阵做 PCA 可视化,红点(Gs)和黄点(Go)在特征空间里形成两个清晰分离的簇。这证明模型确实捕捉到了同号与异号信号之间的互补关系——两套调控策略各司其职。
六大视觉任务实测
团队构建了 b0 到 b5 共 6 个规格的骨干网络(7M–114M 参数),在六大类任务上系统测试。
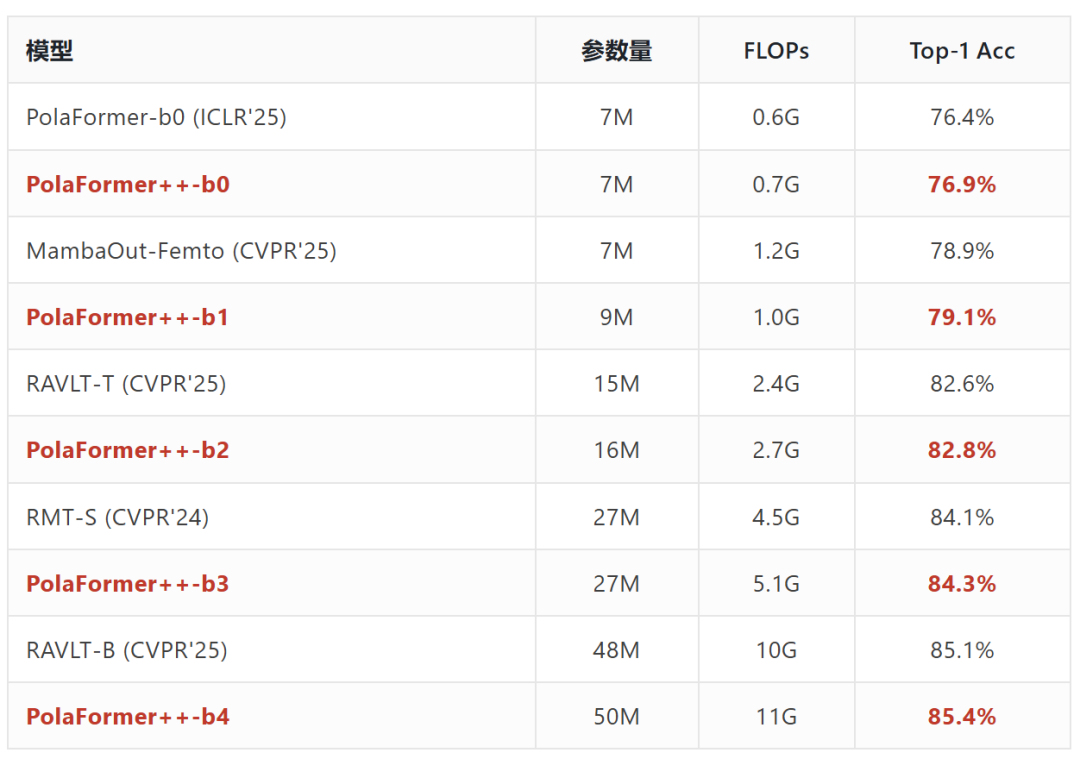
ImageNet-1K 分类:精度全面领先
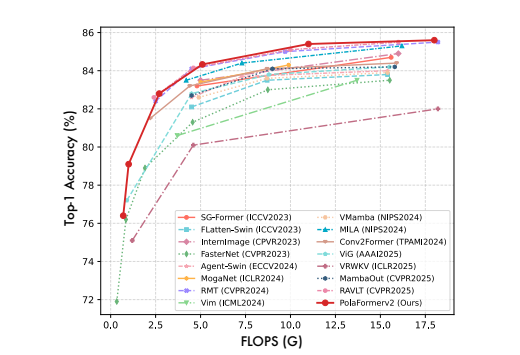
从 b0 到 b5,PolaFormer++ 在各档位都达到同级别最优或极具竞争力的 Top-1 精度。画出精度-FLOPs 曲线,红色实线整体压在最上方,把近三年的高效模型(如 EfficientViT、MobileViT、EdgeViT)全甩在后面。
长序列效率:200K 长度快 5.25 倍
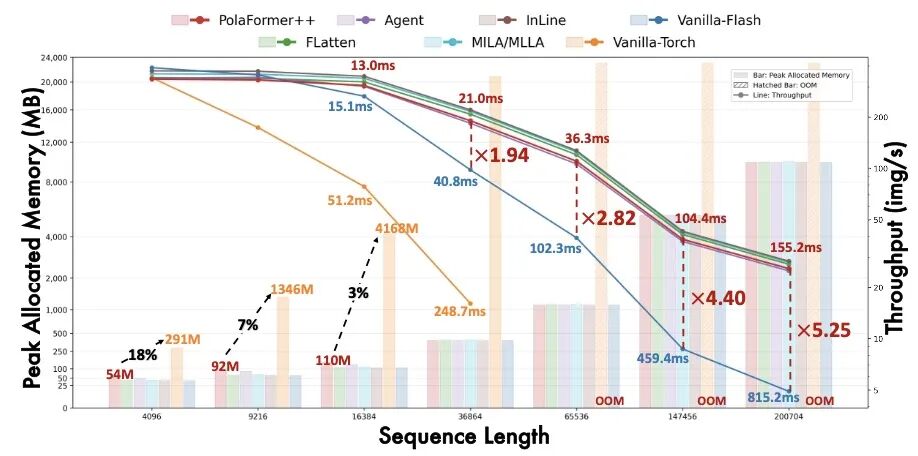
在 4K 到 200K 序列长度下实测吞吐和显存:普通 Softmax 注意力(Vanilla-Torch)跑到 65K 就爆显存;Flash Attention 虽不爆,但速度被越拉越远。PolaFormer++ 在 200K 长度下提速达 5.25 倍,且峰值显存始终最低。
COCO 目标检测与实例分割
用 RetinaNet 和 Mask R-CNN 框架测试:
- RetinaNet 1×:b2 达 46.0 AP,超过 RMT-T(45.1);b3 达 47.3 AP。
- Mask R-CNN 1×:b3 达 49.7 AP / 44.6 APm,参数更少但超过 InternImage-S(69M);b4 达 51.5 / 45.9,胜过 RMT-B(73M)。
- Mask R-CNN 3×:b4 达 52.9 AP / 46.2 APm,小幅领先 RMT-B(52.2 / 46.1)。
- 最大规格 b5(114M)在 1× 下达 51.9 AP / 46.1 APm,算力显著低于同精度对手。
ADE20K / Cityscapes 语义分割
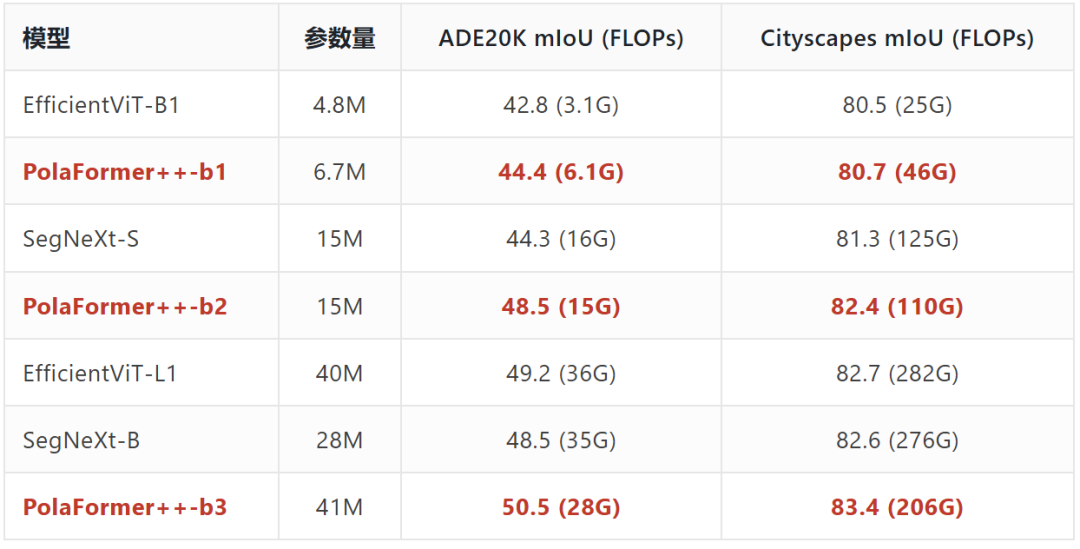
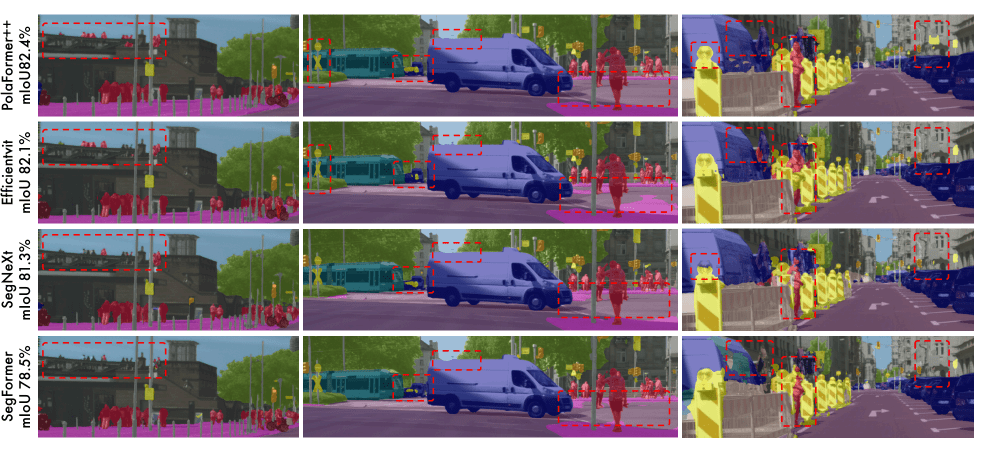
PolaFormer++-b3 在 ADE20K 上以 28G FLOPs 达 50.5% mIoU,比 EfficientViT-L1 高 1.3%,比 SegNeXt-B 高 2.0%。Cityscapes 上达 83.4% mIoU。可视化显示,它对行人、人行道、车辆的边界刻画更精细,远处人群也能完整分割。
扩散生成(PolaDiT)
把 DiT 的注意力换成 PolaFormer++,得到 PolaDiT:
- DiT-S/2 规模:FID 58.30 / IS 25.29,优于 DiG(62.06)、MHLA(59.80)等线性变体。
- DiT-B/2 规模:FID 36.00 / IS 41.56,继续保持线性注意力中的最优成绩。
3D 新视角合成(Pola-GNT)
在 GNT 框架下替换点积注意力,LLFF 数据集 8 个场景平均:PSNR 从 27.25 dB 提升至 27.34 dB,LPIPS 从 0.1019 降至 0.1009,SSIM 从 0.8868 提升至 0.8885。三项指标同步改善,说明它在 3D 几何建模中也管用。
轻量级图像超分
接入 ESRT 和 MambaIRv2:
- 精度:MambaIRv2-Pola++ 在全部 5 个 benchmark 上超过此前最优的 ESC(如 ×4 Set5 32.59 dB)。
- 效率:Urban100 ×3 下 ESRT-Pola++ 延迟仅 85.7ms,比原版(327.4ms)降 73.8%,显存省 90%;Manga109 上显存节省高达 92.5%。MambaIRv2 换回 Softmax 后,在大图上直接 OOM,小图延迟也飙到 20 倍(Set5:1504.8ms vs 78.6ms),而 Pola++ 版本几乎不增加开销。
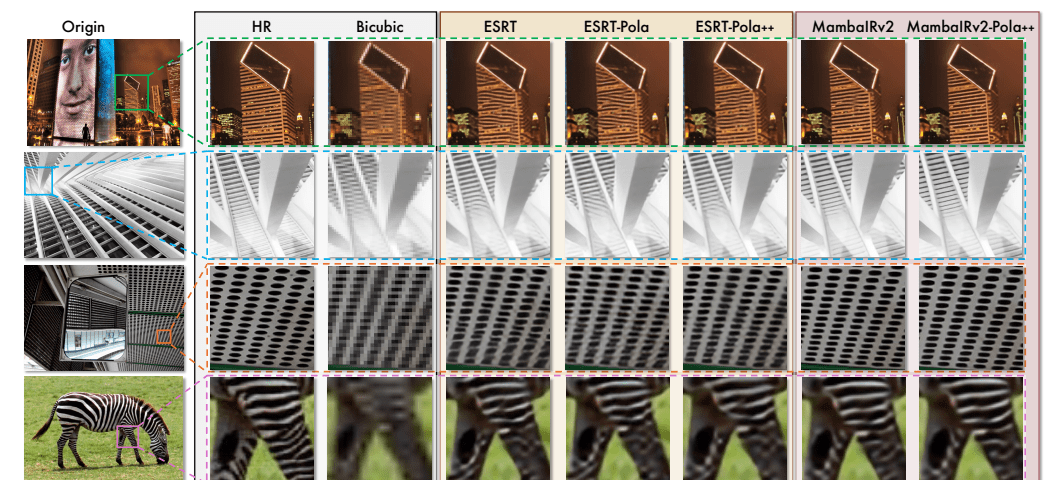
超分结果可视化显示,PolaFormer++ 在建筑边缘、斑马线、金属网格等高频细节上重建出更锐利、更连续的纹理。
消融实验与稳定性
- 模块消融(ImageNet b0):仅极性机制基线 76.3%,加入门控、可学习尖锐、PaCS 后逐步提升,完整模型达 76.9%。
- 线性注意力同台对比(~29M 参数):PolaFormer++ 以 82.8% 精度超过 Efficient Attn(81.0)、FLatten(82.1)、Agent(82.6)等所有基线,且保持线性复杂度。
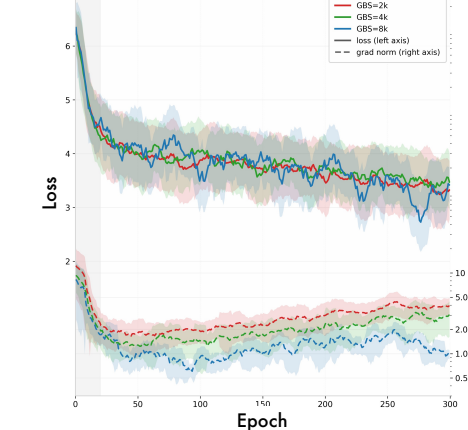
- 训练稳定性:BF16 混合精度下,全局 batch size 2048/4096/8192 三档跑 300 epoch,loss 和梯度范数全程平稳,无爆炸、无 NaN、无发散。
理论贡献:首次给出“降熵尖锐性”判据
除了工程改进,PolaFormer++ 还给出了理论支撑。作者基于 Schur-凹性,首次提出了判定一个特征映射是否具备“降熵尖锐性”的严格数学判据。这把 PolaFormer 中的特例证明推广成了通用框架,为后续设计提供了理论工具。
总的来说,PolaFormer++ 从负值丢失和注意力熵高这两个根本问题出发,用极性分解+通道级尖锐的组合拳,实现了精度与效率的更好平衡。代码已开源,覆盖分类、检测、分割、生成、3D、超分六大场景,算是给视觉领域的线性注意力交了一份扎实的答卷。