斯坦福用多智能体系统模拟虚拟药企,6小时处理3.7万项临床试验
一个能自己运转的“数字药企”长什么样?
2026年9月,《Science》刊登了一篇来自斯坦福大学的研究,标题直白又带点科幻感:《The Virtual Biotech: A multi-agent AI framework for therapeutic discovery and development》。听起来像是某种未来企业的蓝图,但它其实是一套高度结构化的多智能体 AI 系统——不是用来写诗或聊天,而是模拟一家真实生物科技公司的研发组织。
这套系统叫 Virtual Biotech,名字里没加“AI”或“智能”,因为它压根不打算当个工具,而是要扮演整个研发团队。它有四个虚拟部门,11个主要智能体,每个都有明确分工:有的专攻人类遗传学证据,有的负责单细胞数据分析,有的评估药物安全性,还有的设计临床开发路径。最关键的是,所有这些角色都由一个“虚拟首席科学官”(CSO)协调,确保信息流动和决策一致。
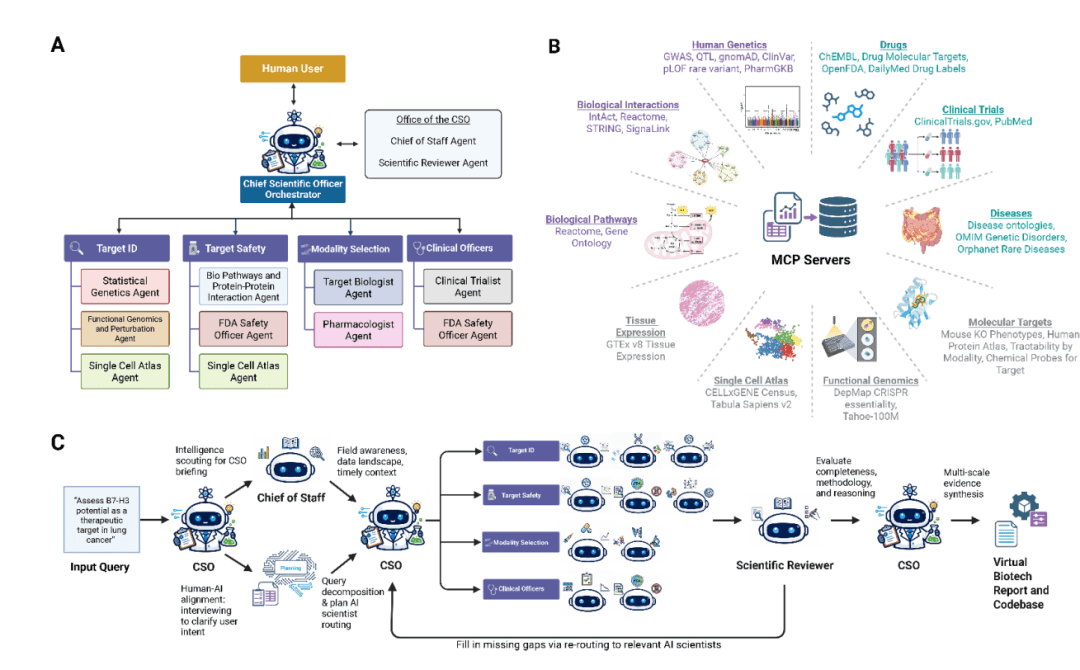
底层技术上,大部分智能体跑的是 Claude Sonnet 4.5,而负责战略简报和科学审查的两个轻量级角色则用 Claude Haiku 4.5。它们不是孤立运行的聊天机器人,而是通过 MCP(Model-Context-Protocol)服务器连接到真实的生物医学数据库、代码执行环境和分析工具。这意味着语言模型可以直接“动手”查数据、跑脚本、生成图表,而不是只输出文字描述。
6小时干完76天的活
最让人惊讶的不是架构有多精巧,而是它真能干活。研究团队给 Virtual Biotech 布置的第一个任务,是把 Open Targets 数据库里的临床试验信息补全——特别是终点结果和不良事件这类关键但分散的数据。
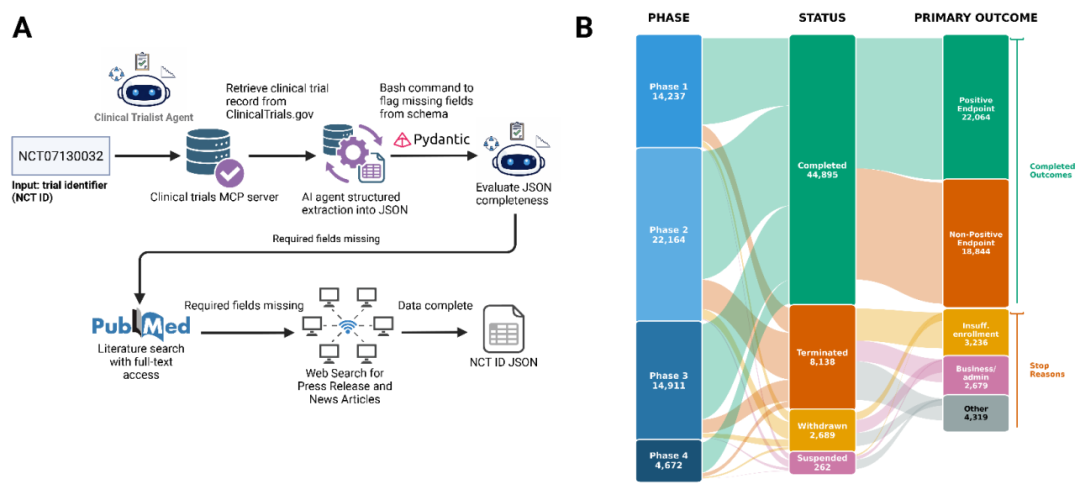
系统先让“临床试验智能体”制定一套数据提取规则,然后一口气启动了 37,075 个并行实例,每个负责一项 II 或 III 期临床试验。这些智能体自动访问 ClinicalTrials.gov,再根据需要去 PubMed、公司新闻稿、FDA 公告等地方抓取补充信息,并严格记录每条数据的来源。
整个过程只用了 6 小时。如果换成单个智能体串行处理,按同样逻辑估算需要约 1839 小时,也就是 76.6 天。效率差距接近 184 倍。
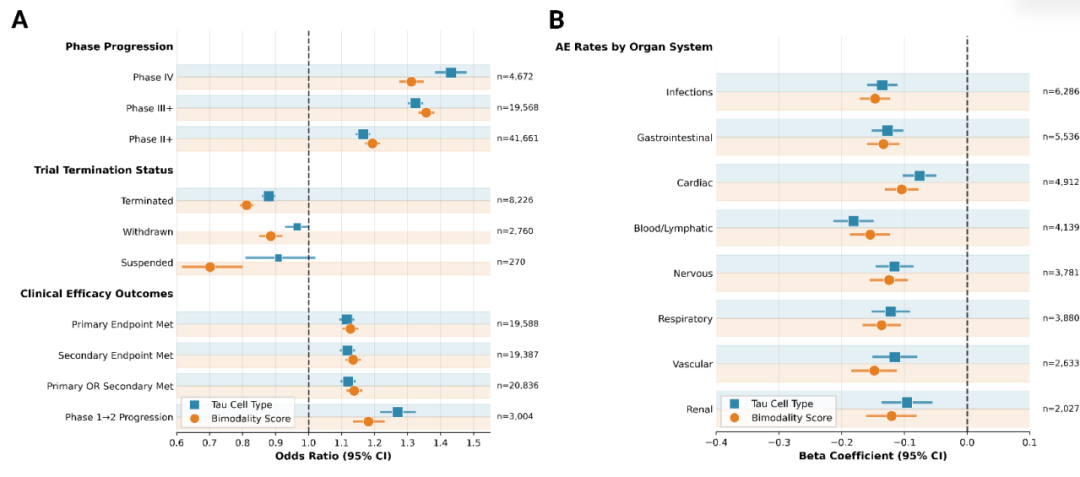
最终,团队拿到了覆盖 55,984 项临床试验的整合数据集,并成功将临床结果与药物靶点的遗传学特征、单细胞表达谱关联起来。分析发现了一个清晰趋势:靶点具有更强细胞类型特异性的药物,临床表现更好。具体来说,这类药物进入 IV 期的可能性高 48%,从 I 期推进到 II 期的概率高 40%,平均不良事件率低 32%。这个结论不是凭空推测,而是基于大规模数据交叉验证得出的。
它怎么判断一个靶点值不值得做?
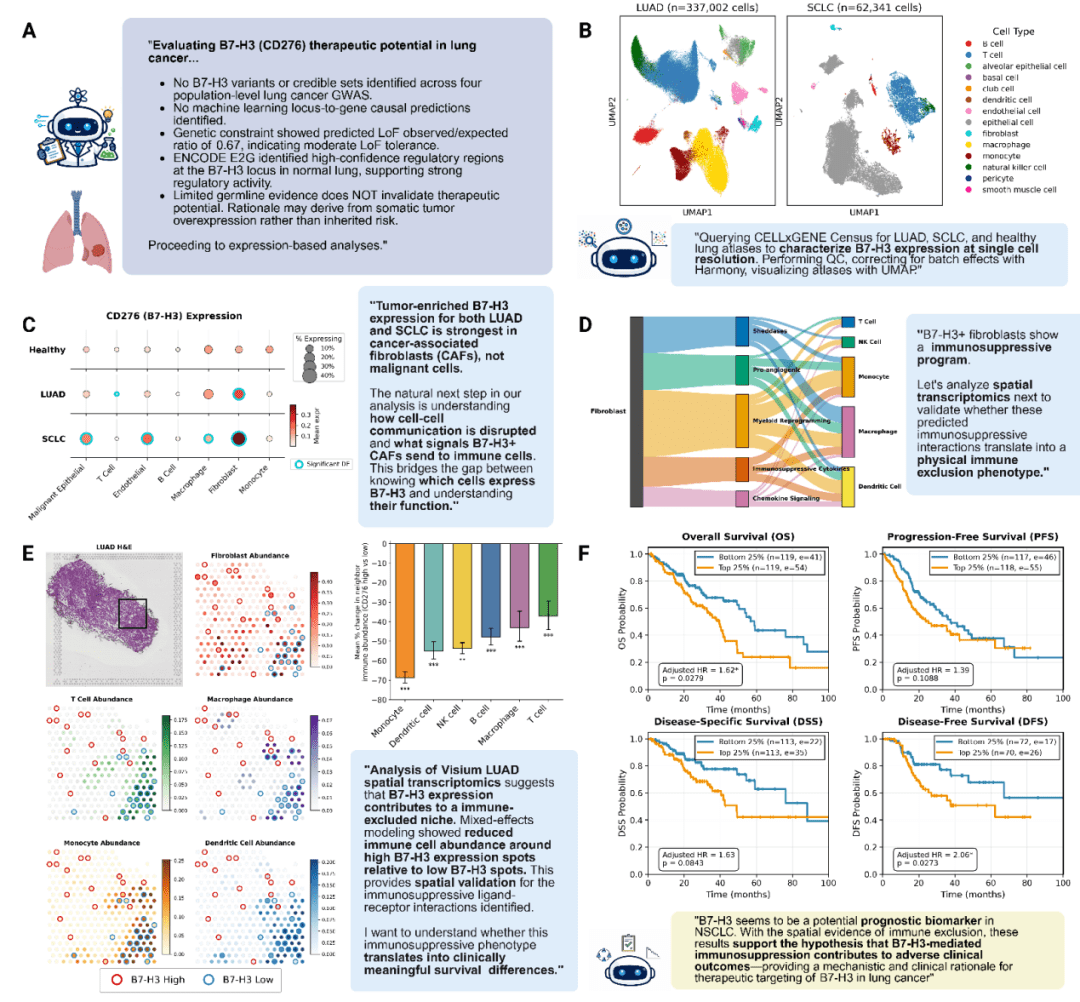
光会整理数据还不够,真正的考验是决策能力。研究人员于是抛出一个具体问题:B7-H3(也叫 CD276)适合作为肺癌治疗靶点吗?
Virtual Biotech 立刻调动多个智能体协同工作。一组分析人类遗传学数据库,看 B7-H3 是否与肺癌风险相关;另一组调取单细胞和空间转录组数据,观察它在肿瘤组织中的表达分布;还有智能体专门查患者生存记录和既往临床试验结果。
结果很快汇总:B7-H3 在肺腺癌和小细胞肺癌中的表达并不均匀,而且在高表达区域,T 细胞、巨噬细胞、树突状细胞等免疫细胞明显减少——这提示可能存在 免疫排斥微环境。
接着,系统把这一发现与 477 名肺腺癌患者的生存数据结合。在调整了年龄、癌症分期和性别等混杂因素后,B7-H3 高表达与更差的总生存期和无病生存期显著相关。
综合所有证据,虚拟 CSO 给出结论:B7-H3 很可能参与构建免疫抑制性肿瘤微环境,因此值得作为靶点开发。更进一步,系统还建议采用 抗体偶联药物(ADC) 作为首选治疗形式,理由是 ADC 能精准递送毒素到表达 B7-H3 的肿瘤细胞,同时减少对正常组织的损伤。
复盘失败试验,它也能做到
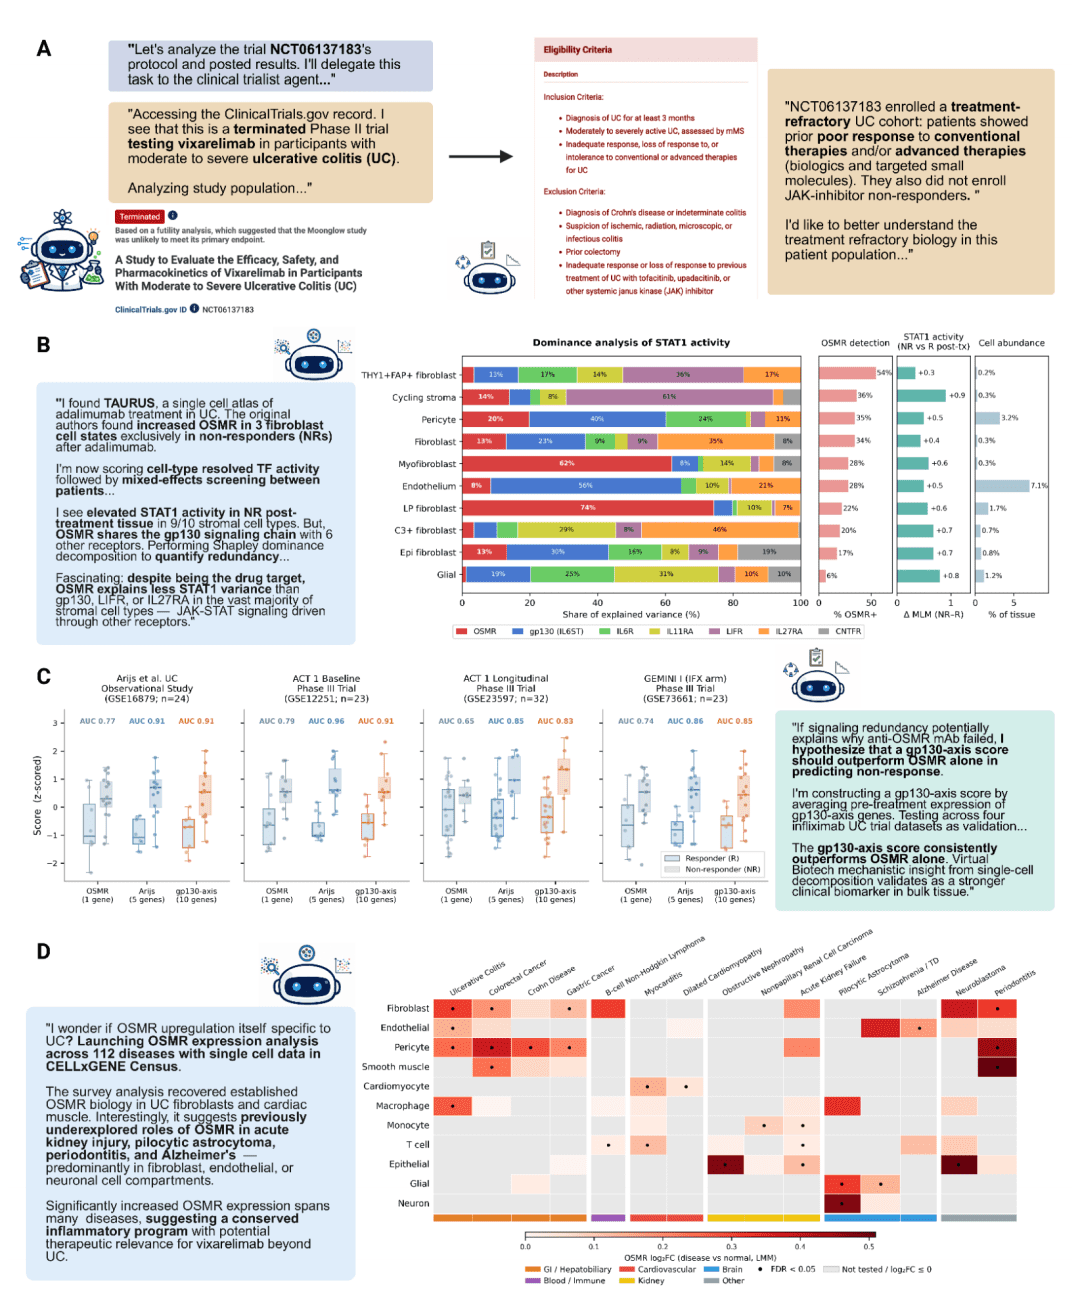
药物研发九死一生,失败是常态。研究团队于是又给了 Virtual Biotech 一个更棘手的任务:解释 MOONGLOW II 期临床试验为何提前终止。
这项试验在 2025 年 6 月因中期分析显示“几乎不可能达到主要终点”而被叫停。传统复盘往往依赖专家经验,但 Virtual Biotech 选择从数据底层重新梳理。
它首先检查了入组患者的基线特征,再调取单细胞数据,重点分析 OSMRβ(该试验靶点)的下游信号通路。很快,系统发现 gp130 信号轴的整体活性可能比单一 OSMR 表达更能预测疗效。
于是,它设计了一个 gp130 信号风险评分,整合多个通路基因的表达水平。随后在四个独立患者队列中验证,这个评分 consistently(持续地)优于仅用 OSMR 表达的预测模型。
换句话说,如果当初试验设计时用了这个评分来筛选患者,或许就能富集到更可能获益的人群,避免因整体疗效稀释而提前终止。这不是马后炮式的批评,而是一种可操作的改进方案。
人类专家怎么看?
为了验证 Virtual Biotech 的可靠性,研究团队请了 4 位独立的人类专家,让他们复现系统完成的 8 项关键分析——包括数据提取逻辑、统计方法、代码实现和结论推导。
结果令人意外:所有专家都认可 AI 得出的结论,并且认为生成的分析代码 没有实质性错误,不会影响最终判断。这说明系统不仅快,而且稳。
不过,研究者也坦承当前系统的局限。Virtual Biotech 目前只覆盖 计算分析、证据整合和优先级排序,不包含湿实验(wet lab)验证。它无法合成化合物、做细胞实验或动物模型测试。对于罕见病或研究极少的靶点,由于缺乏足够数据,它的判断力也会下降。
因此,与其说它是一家“虚拟药企”,不如说是一支 高速并行的数字研发团队——擅长从海量信息中提炼信号,但最终仍需人类科学家接手实验验证和临床推进。
下一步:和真实药厂合作?
论文最后提到,团队正计划将 Virtual Biotech 与真实制药公司对接,或者将其接入 自主实验室(self-driving lab) 系统。后者能自动执行实验操作,如果和 Virtual Biotech 的决策能力结合,或许真能实现“从靶点到候选药物”的端到端自动化研发。
当然,这离完全取代人类还很远。但至少现在,我们看到一种可能:未来的药物研发不再是几十人围在白板前争论,而是一个由 AI 智能体组成的“数字组织”,昼夜不停地筛选、验证、迭代——而人类的角色,从执行者转变为监督者和战略制定者。
这种转变未必浪漫,但足够高效。毕竟,在每年耗资上百亿美元、失败率超过90%的药物研发领域,速度和准确性,就是生命。