腾讯优图与深大提出 ForgeryVCR:用视觉证据替代文字推理检测图像篡改
图像鉴伪为何不能只靠“说”
现在改一张图太容易了。用生成模型或编辑软件,几乎能在不破坏画面观感的前提下替换人脸、移动物体甚至凭空添加元素。这种高保真伪造给社交媒体、新闻机构和司法取证带来巨大挑战——我们怎么知道眼前这张图没被动过手脚?
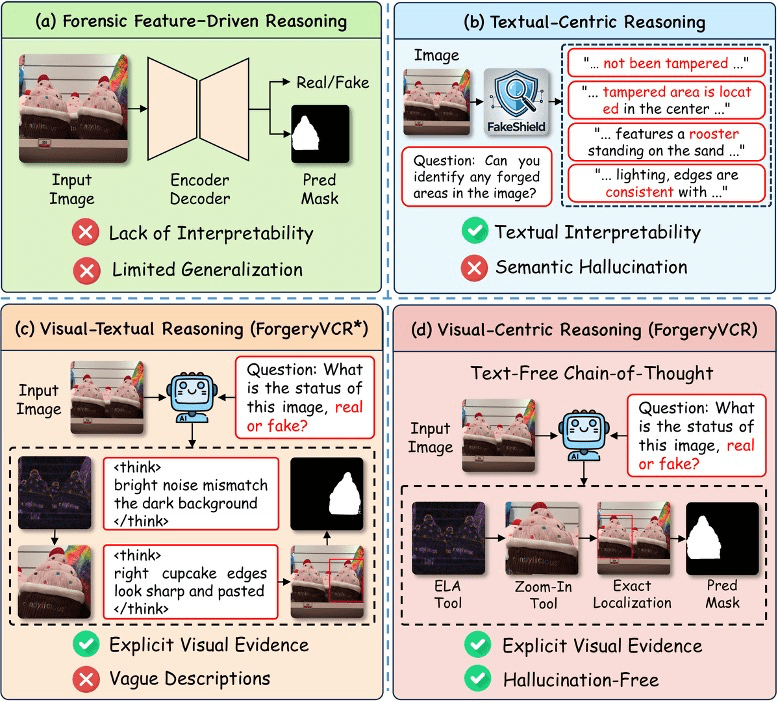
过去几年,研究者尝试用多模态大模型(MLLM)来解决这个问题。主流做法是让模型先“看图说话”:用自然语言描述哪里可疑,比如“边缘模糊”“光照不一致”,再根据这些文字判断真假。听起来合理,但实际问题很大。
图像篡改的关键线索往往藏在像素级的低层痕迹里,比如压缩伪影、传感器噪声分布异常或频域能量突变。这些信号极其微弱,人眼根本看不见,现有的视觉编码器也主要训练去识别物体和场景,对这类细粒度统计特征并不敏感。更麻烦的是,一旦强迫模型把看到的转成文字,信息就会大量丢失。比如“左下角有高频噪声”这种描述,既无法还原原始信号强度,又可能被高层语义干扰——模型干脆把画面里本来存在的复杂纹理(比如树叶或砖墙)当成伪造证据,产生所谓的“语义幻觉”。
把不可见的痕迹变成看得见的证据
针对这个问题,腾讯优图实验室与深圳大学的研究团队提出了 ForgeryVCR。它的核心思路很直接:别让模型“说”痕迹,而是让它“看”痕迹。
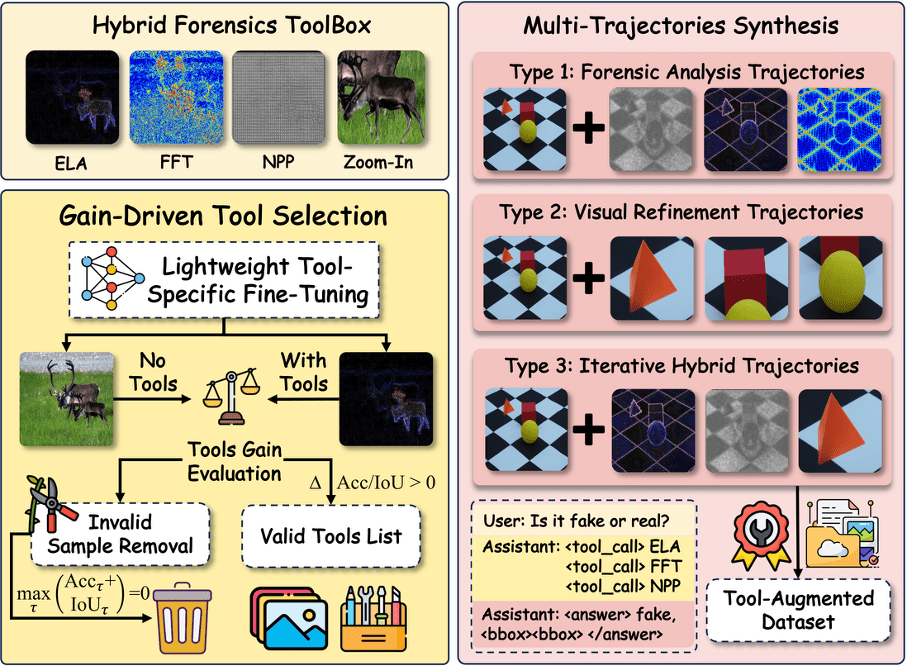
ForgeryVCR 构建了一个闭环的取证智能体框架,包含三个关键设计:
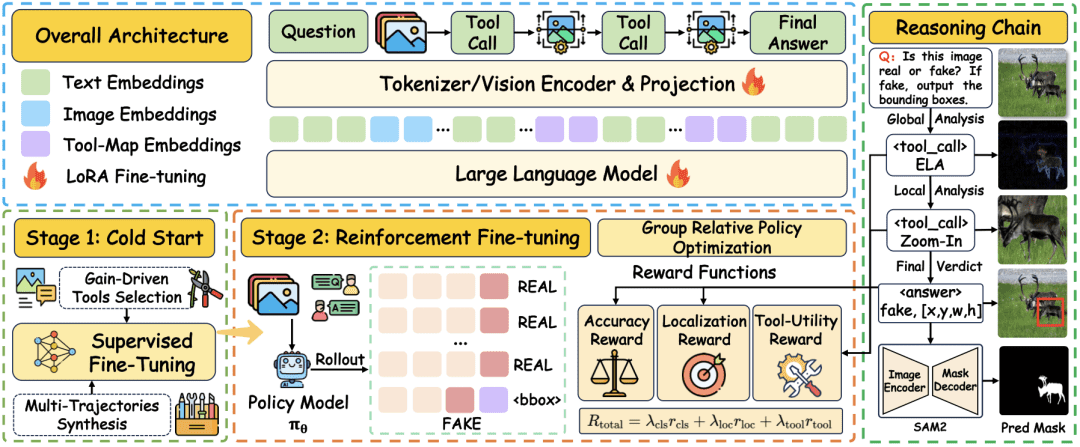
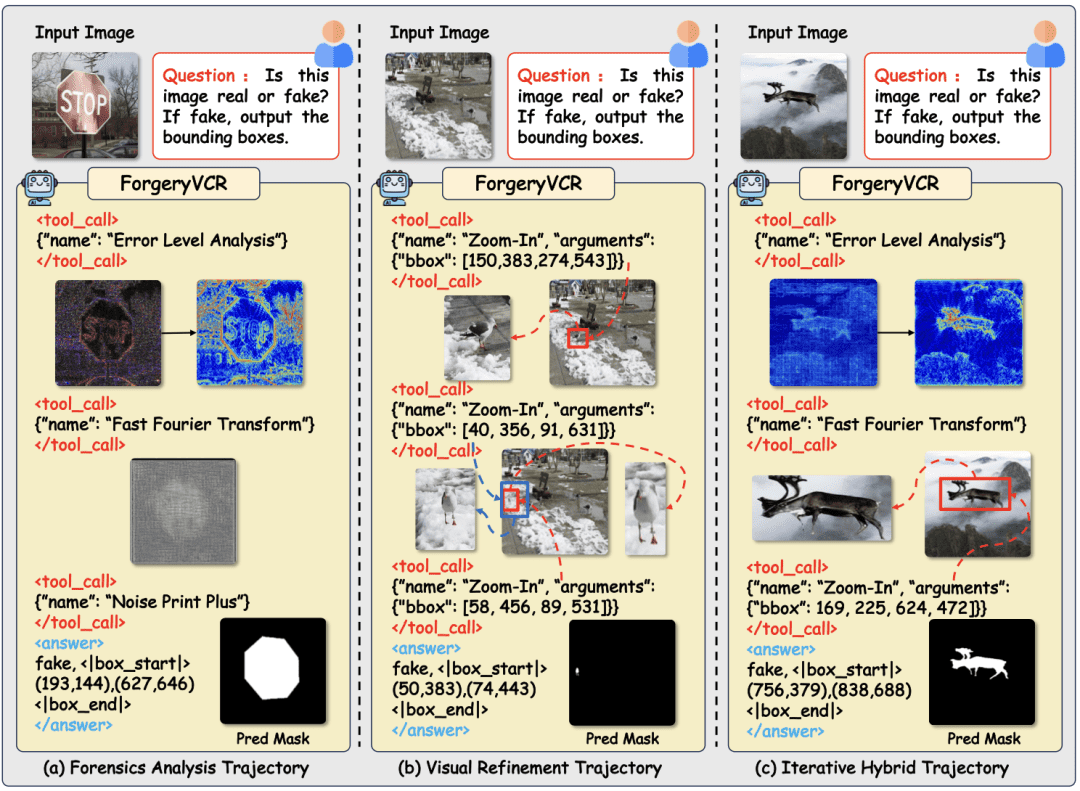
- 痕迹可见化:通过轻量代码调用一系列取证算子,把原本隐藏在数据底层的异常转化为中间图像。比如用 ELA(误差级别分析)突出 JPEG 压缩不一致区域,用 FFT(快速傅里叶变换)可视化频域能量异常,或用 Zoom-In 裁剪局部细节放大可疑边界。
- 判决可溯源:这些工具生成的视觉证据直接作为新输入送回模型,参与后续真假判断。最终结论不是基于一段文字推理,而是建立在若干张可查验的中间图像之上。
- 调用自适应:模型学会按需调用工具。简单样本直接判别;复杂样本才触发工具链,且优先选择最可能提供决定性证据的工具,避免无意义的重复操作。
这套机制把图像取证从“依赖文本解释”转向“基于显式视觉证据推理”的新范式。
取证工具箱:选对工具比堆数量更重要
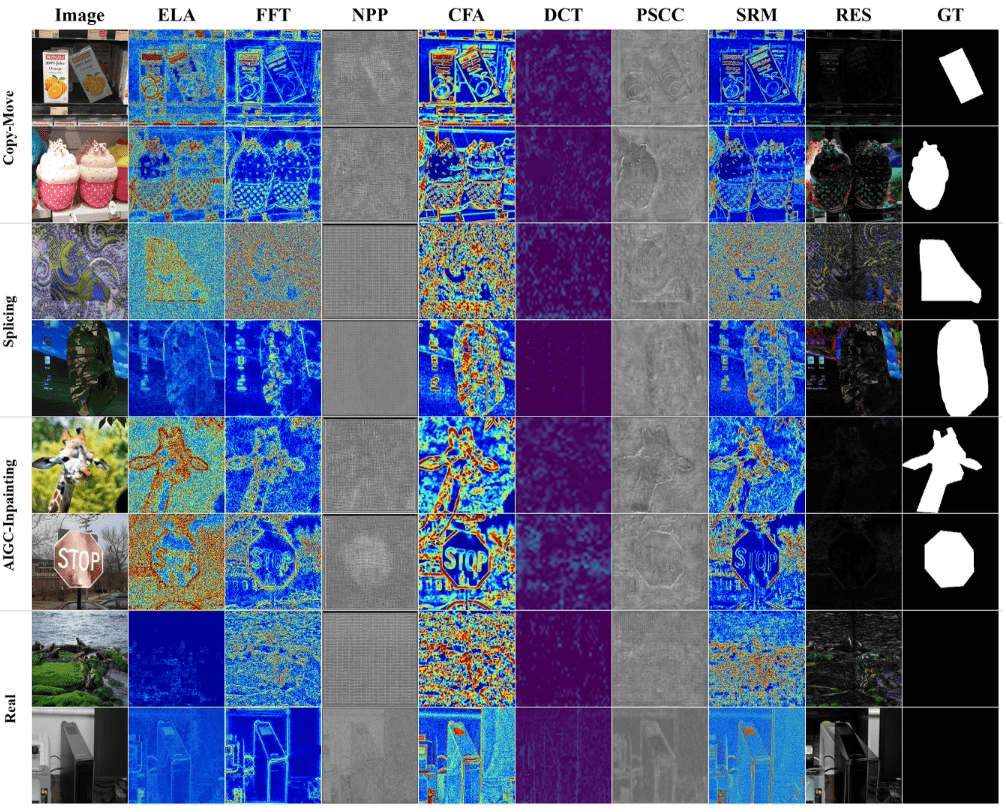
ForgeryVCR 的工具箱并非随意拼凑。团队首先筛选了一批经典取证方法,包括 ELA、NPP(噪声模式分析)、PSCC(光谱一致性检查)、SRM(残差富集)、CFA(彩色滤镜阵列分析)、FFT、DCT(离散余弦变换)、VAE 重建残差和 Zoom-In 局部放大。
接着,他们在冷启动数据集上逐一测试单个工具及组合的效果。评判标准有两个:一是能否提升检测/定位性能,二是生成的中间图像是否能被视觉编码器有效感知。最终保留了 ELA、FFT、NPP 和 Zoom-In 四项工具。这组工具覆盖了压缩域、频率域、噪声域和空间细节四个维度,彼此正交性强,能高效捕捉不同类型的篡改痕迹。
例如,ELA 对复制-粘贴或拼接类篡改特别敏感,因为不同来源区域的压缩历史不同;FFT 则擅长发现生成模型留下的周期性伪影;NPP 能揭示传感器噪声分布的不连续;而 Zoom-In 在边界模糊或几何畸变场景中提供关键细节。
让模型学会“聪明地”调工具
有了工具箱,下一步是教会模型何时用、用哪个。ForgeryVCR 采用两阶段训练策略:

第一阶段:监督微调(SFT)冷启动
研究者设计了一套 增益驱动的轨迹合成流程:
- 先训练一个“无工具基线”模型和四个“单工具专家”模型。
- 对每个训练样本,比较各专家与基线的表现。只有当某工具带来的性能增益超过预设阈值,才会被纳入该样本的候选工具链,并按增益高低排序。
- 如果没有任何工具有效,工具链为空,模型直接用原始图像判别。
- 从排序后的工具链中,构造多种推理路径:不调工具、调单个工具、或多工具顺序调用。通过 多轨迹合成(MTS) 平衡各类路径的数据量。
- 最后剔除所有模型都判错的“难解样本”,提升冷启动数据质量。
这套流程生成的 SFT 数据,让模型初步掌握按样本复杂度选择推理路径的能力。
第二阶段:强化学习(GRPO)优化调用策略
在 GRPO 框架下,模型继续学习更精细的工具调用策略。奖励函数包含三部分:
- 分类奖励(Rcls):图像级真假判断正确与否。
- 定位奖励(Rloc):像素级篡改区域定位的 IoU 得分。
- 工具效用奖励(Rtool):仅当工具提取的痕迹确实帮助模型做出正确判断时,才给予正向反馈。
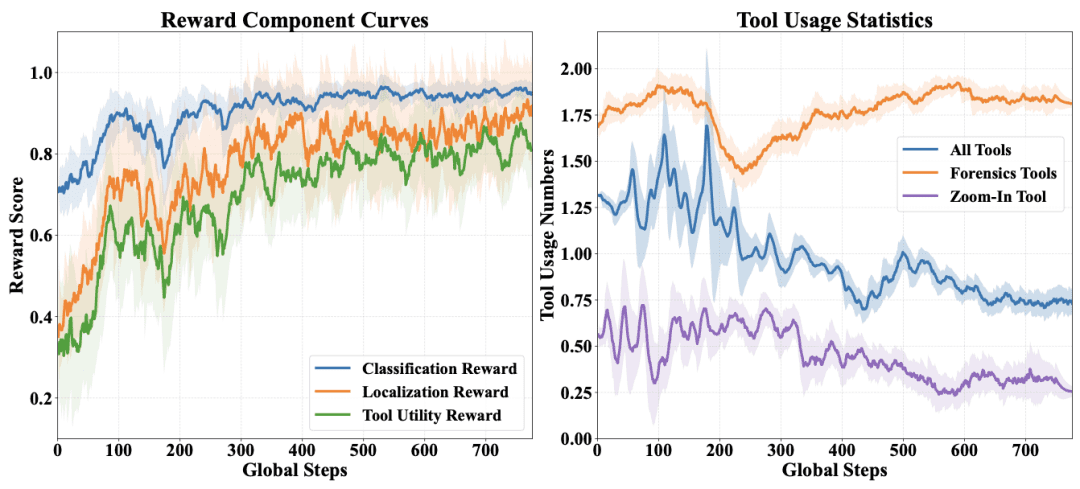
训练初期,模型倾向于频繁调用工具试探。随着训练推进,它逐渐收敛到“按需调用”策略:工具调用轮数下降,而检测与定位精度持续上升。这意味着模型学会了识别哪些样本需要额外证据,以及哪种工具最可能提供关键线索。
实验结果:视觉证据胜过文字描述
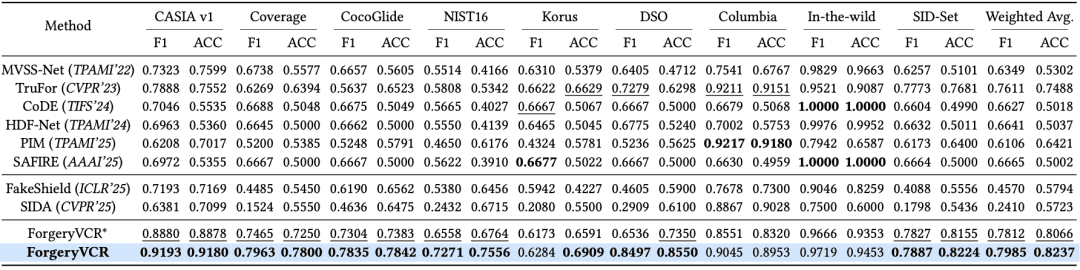
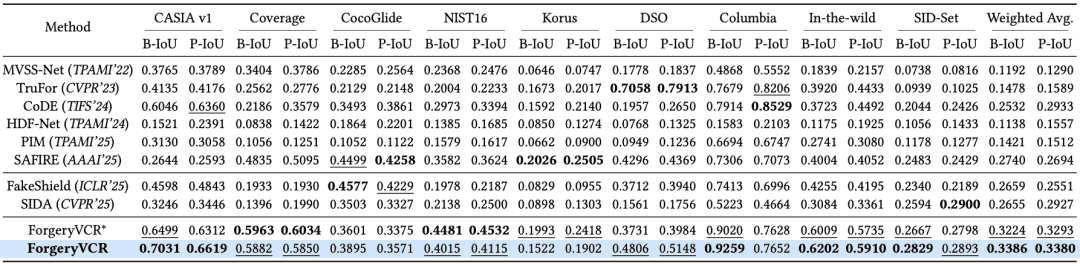
ForgeryVCR 在 9 个主流图像取证基准上进行了全面测试,涵盖图像级检测(F1/ACC)、区域级定位(B-IoU)和像素级定位(P-IoU)。
泛化性表现
按加权平均计算,ForgeryVCR 显著优于现有方法:
- 图像级检测 F1 达 0.7985,比此前最优方法提升 4.91%;ACC 为 0.8237,提升 10.00%。
- 区域级 B-IoU 0.3386(↑23.58%),像素级 P-IoU 0.3380(↑15.24%)。
这说明其视觉中心推理范式在未见篡改类型上具有更强泛化能力。
关键消融实验
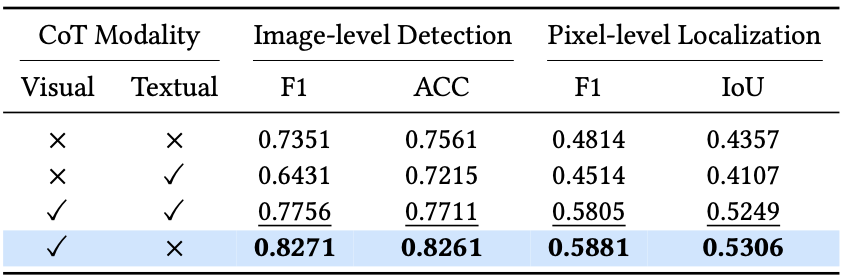
推理模态对比:研究者测试了纯视觉 CoT、纯文本 CoT 和混合模态。结果发现,纯视觉 CoT 性能最佳。一旦引入文本描述,检测与定位效果反而下降。这直接验证了“省去语言中间环节能减少信息损失”的假设。
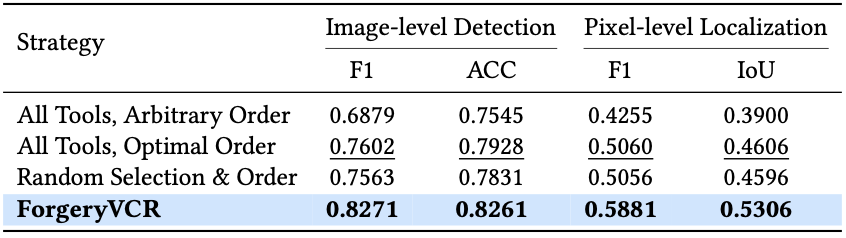
工具策略对比:固定调用全部工具、预设顺序或随机选择,效果均不如 ForgeryVCR 的自适应策略。增加工具数量本身并不能保证收益——关键在于按需选择和排序。
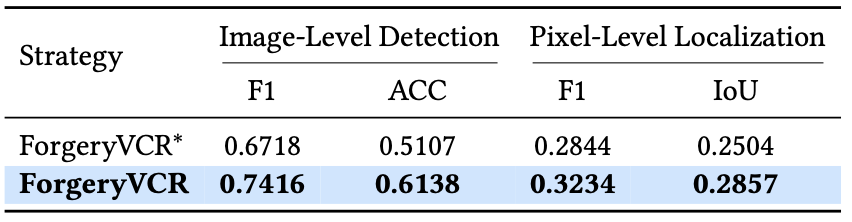
语义幻觉抑制:在容易受无关场景干扰的子集上(如复杂背景被误判为伪造),纯视觉 CoT 版本的图像级 ACC 从 0.5107 提升至 0.6138(↑20.2%),像素级 IoU 从 0.2504 提升至 0.2857(↑14.1%)。这证明视觉证据能有效规避高层语义带来的误判。
可视化推理轨迹
ForgeryVCR 能根据样本构建多样化的推理路径。例如:
- 对简单拼接图,可能只调用 ELA 一次就完成判断。
- 对生成模型产物,先用 FFT 发现频域异常,再用 Zoom-In 验证局部细节。
- 对复杂复合篡改,则交替调用 NPP 和 ELA,逐步汇聚多视角证据。
在线 Demo 展示了这一过程:模型接收图像后,自主选择并执行工具,输出真假结论、可疑区域框和像素级掩码,全程无需人工干预。
不只是技术升级,更是范式转变
ForgeryVCR 的意义不止于指标提升。它推动图像取证从“解释性黑箱”走向“可核验白箱”:
- 对审核平台:不再依赖模型输出的一段模糊文字,而是能直接查看 ELA 图、FFT 图等中间证据,人工复核更高效。
- 对用户信任:当系统指出“此处可疑”时,背后有可视化的痕迹支撑,而非难以验证的语言推测。
- 对模型自身:通过工具效用奖励,学会克制冗余操作,在精度与效率间取得平衡。
这项工作已被 ACM Multimedia 2026 接收为 Oral Presentation。研究团队希望,这种“让判决建立在看得见的证据之上”的思路,能为内容安全、可信生成和数字媒体治理提供新方向。