Jev 模型开放使用:专做结构化判断的 AI,送 5 美元起步额度
Jev 开放注册,送 5 美元额度
TypeSafe AI 最近正式开放了 Jev 模型的访问权限,不再需要候补名单。任何开发者现在都可以直接登录控制台使用,而且一上来就送 5 美元额度——按官方说法,这大约能跑 1.2 亿个 token。
体验入口很简单:https://console.typesafe.ai/login。
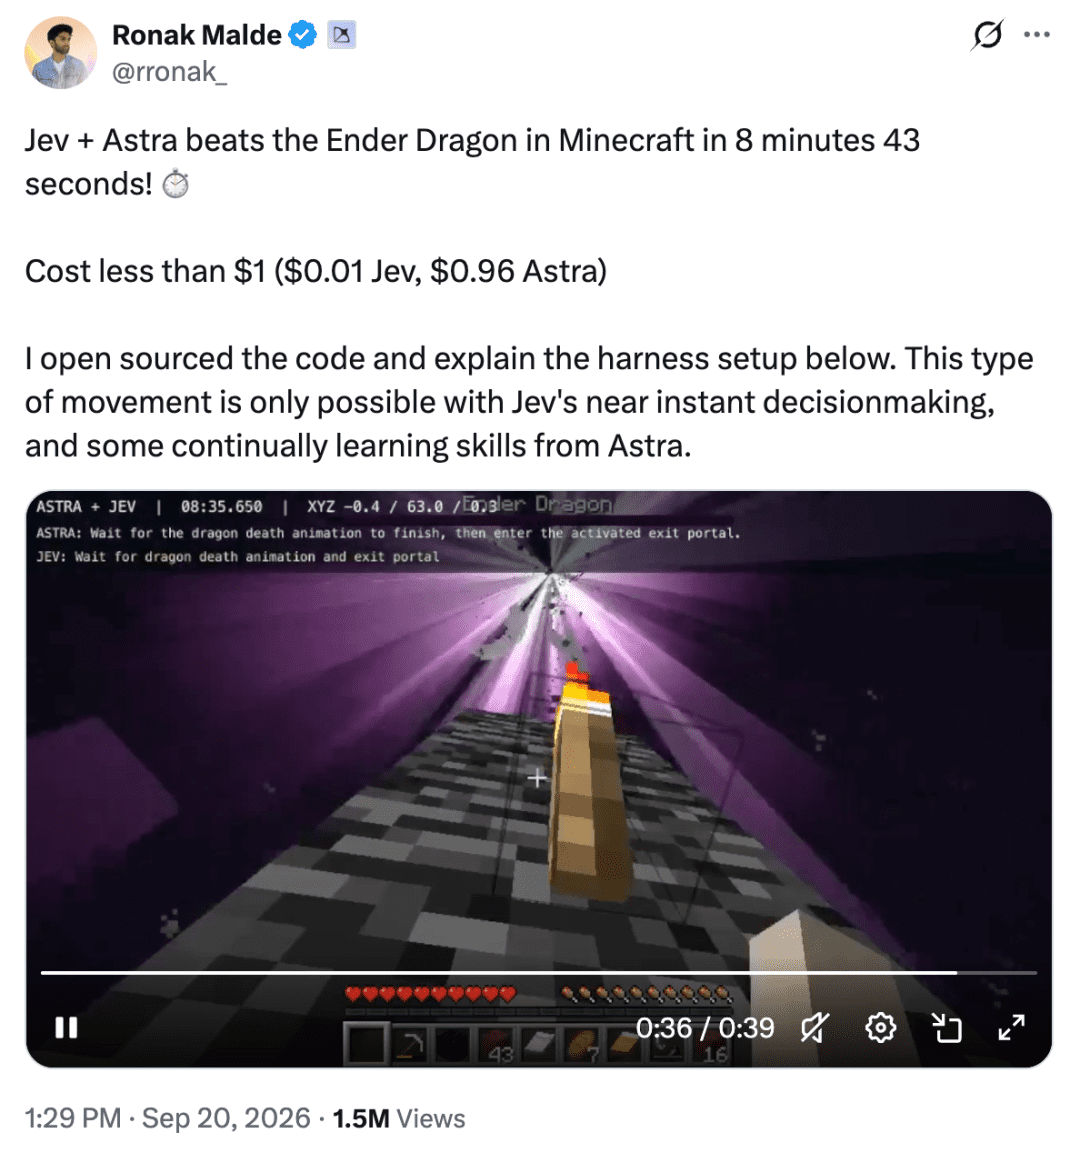
过去一周,Jev 在技术圈里刷了不少存在感。最出圈的例子是一位网友用它搭配 GPT-6 Astra,在《我的世界》里自动打末影龙,全程只用了 8 分 43 秒。整个过程成本不到 1 美元,其中 Jev 花了 0.01 美元,Astra 花了 0.96 美元。相关代码已经开源在 GitHub 上,项目名叫 minecraft-agent。

这件事之所以引人注意,不是因为打龙多快,而是 Jev 在里面扮演的角色很特别:它不做生成,只做判断。
一个专门做判断的模型
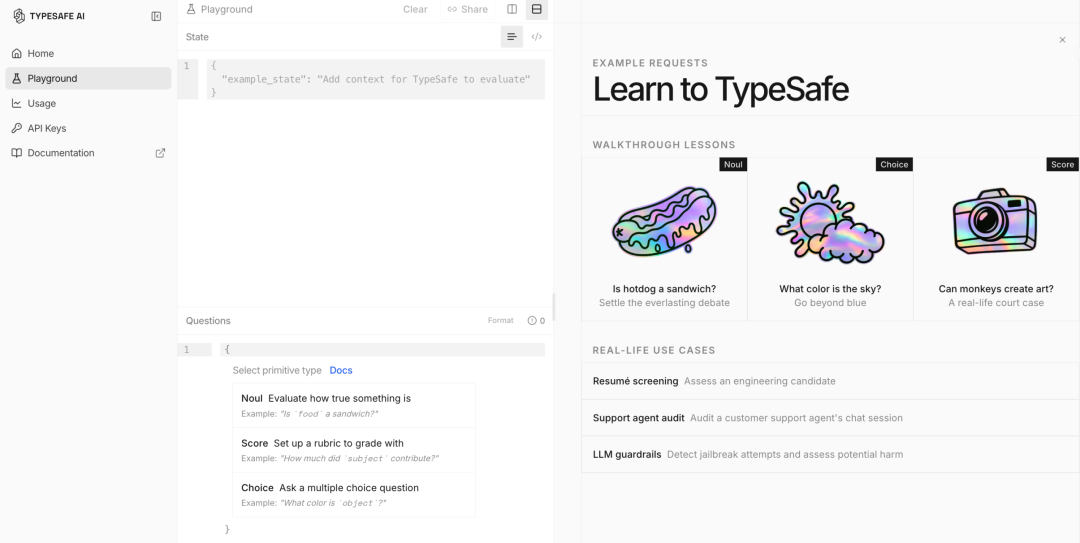
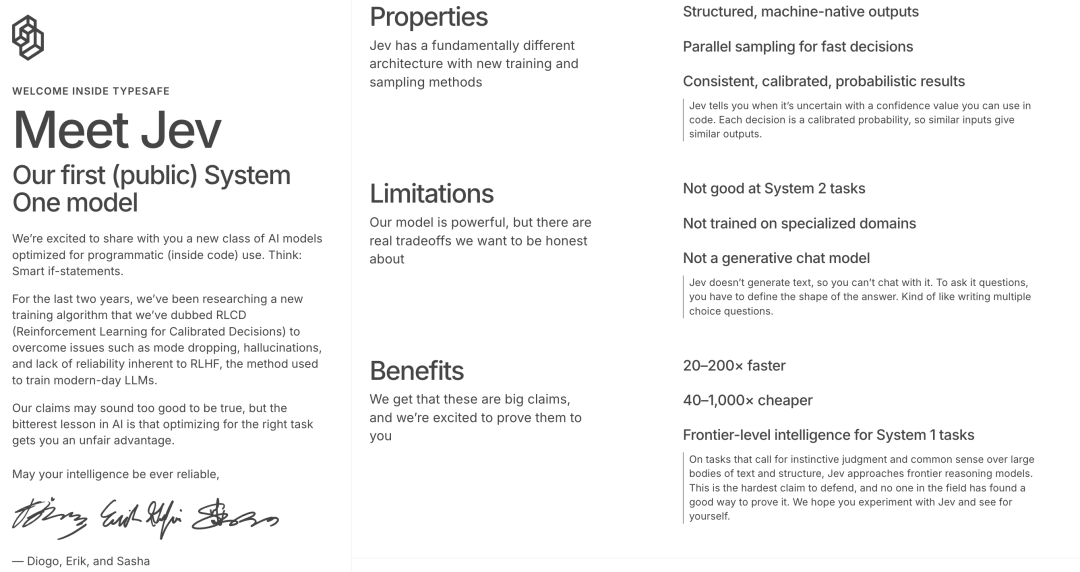
TypeSafe AI 把 Jev 叫作「System One model」,灵感来自心理学中的“系统一”思维——那种快速、直觉式的判断。你给它一段上下文(他们叫 state),再提一个边界清晰的问题,并列出几个可能的答案,Jev 就会告诉你哪个最可能正确,还附上概率。
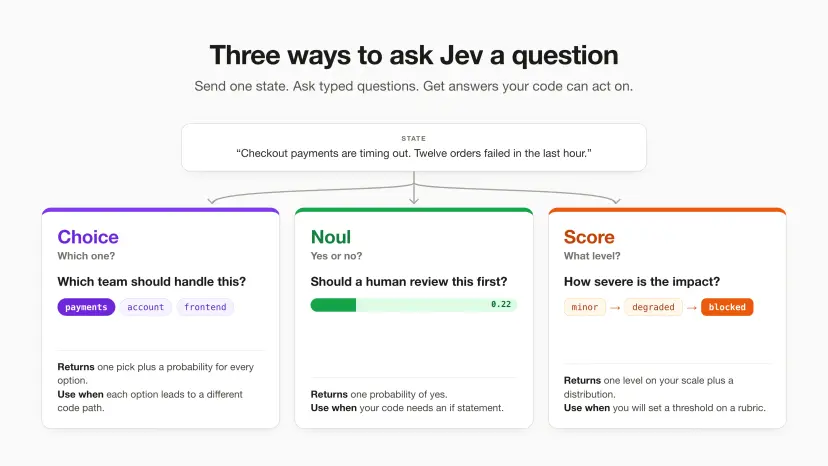
举个客服工单的例子。你可以让 Jev 同时回答三个问题:
- 这个工单该分给哪个团队?(支付 / 账户 / 前端)
- 是否需要人工审核?(是 / 否)
- 问题严重程度如何?(低 / 中 / 高)
对应地,Jev 提供三种输出类型:
- Choice:从给定选项中选一个。
- Noul:返回某件事发生的概率(比如“需要人工审核”的可能性是 73%)。
- Score:把结果映射到有序等级,比如风险评分。
关键在于,这些判断是独立的。你一次提交多个问题,Jev 会分别作答,前一个结果不会干扰后一个。这让它很容易嵌入现有系统——主程序继续走业务逻辑,只在需要快速决策的地方调用 Jev。
泛化能力才是重点
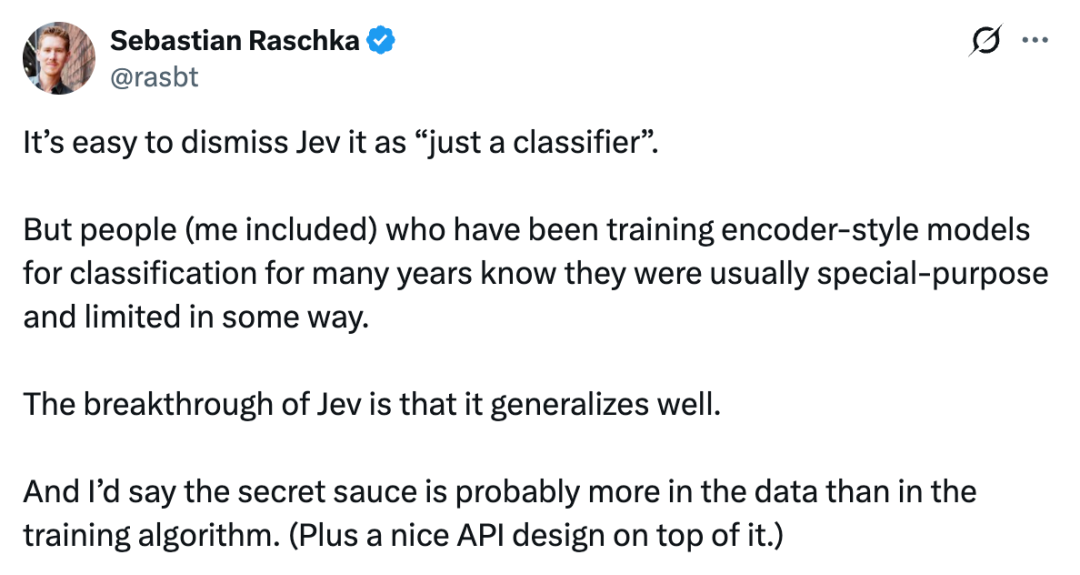
乍看之下,Jev 像是个高级分类器。但大模型工程师 Sebastian Raschka 提醒,这么想会低估它。
传统分类模型一旦训练完成,标签集合就固定了。如果业务变了,比如新增一个工单类型,你得重新标注数据、再训练一遍。Jev 不一样:它的选项是在运行时通过自然语言传进去的。今天你问“支付还是账户”,明天改成“支付、账户还是 API”,不用动模型,直接改输入就行。
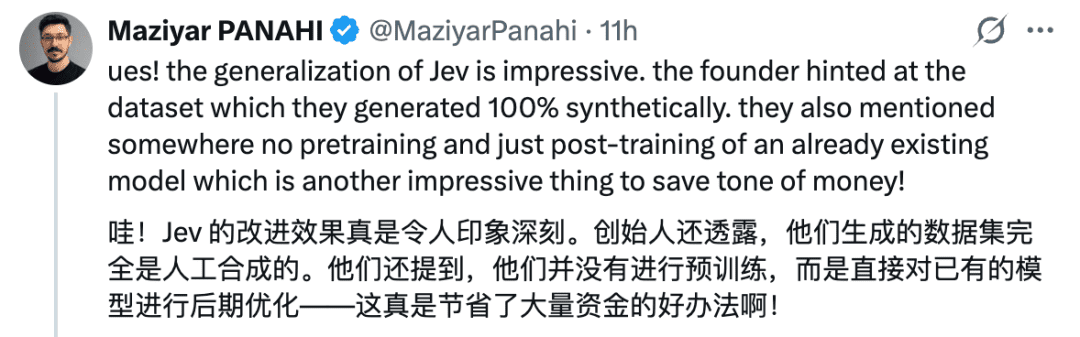
有开发者透露,Jev 可能基于合成数据训练,并在已有模型上做后训练,没搞大规模预训练,所以成本可控。这也解释了为什么它能大方送额度。
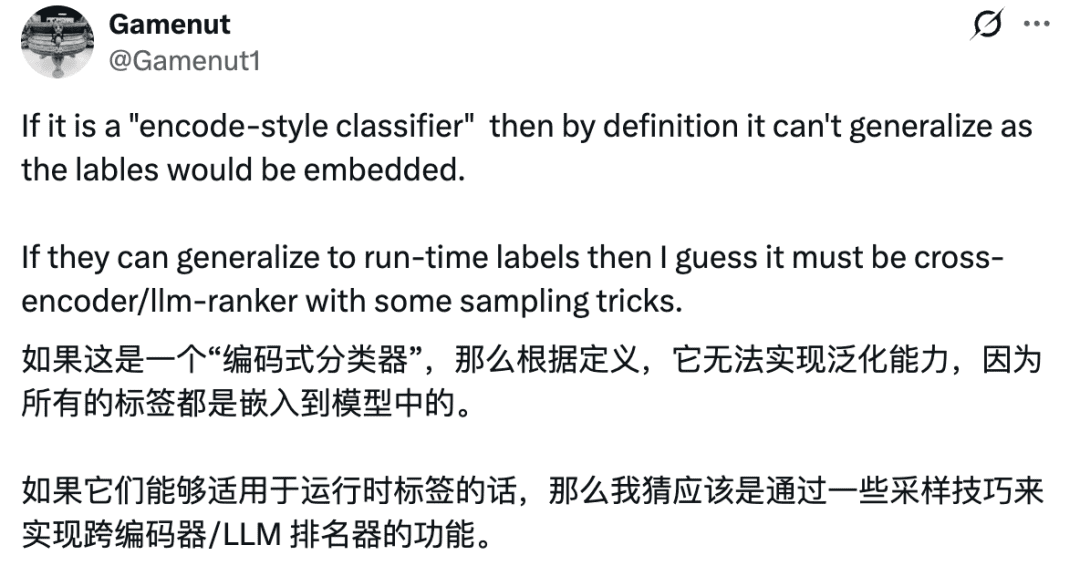
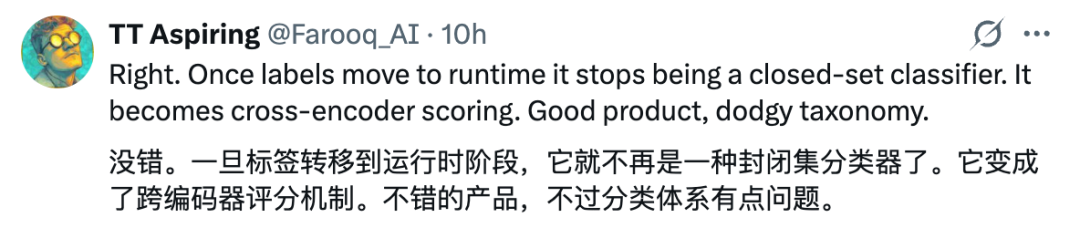
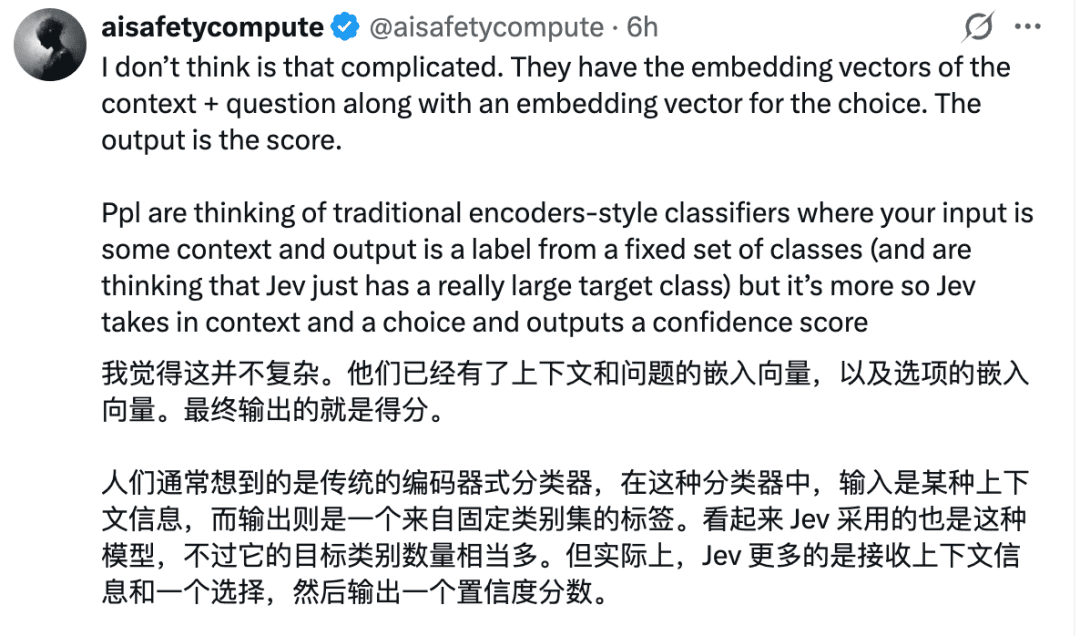
至于技术归类,社区还在争论。有人觉得它更像 cross-encoder 或 LLM ranker,因为会分别处理上下文、问题和候选答案,再给每个选项打分。不管叫什么,它的产品形态确实跳出了传统分类器的框。
它想成为 Agent 的决策层
Jev 最适合那些答案范围明确、又要反复执行的判断任务。
比如在模型路由场景中,你可以让它决定一个用户请求该交给便宜的小模型,还是昂贵的大模型;在内容审核里,判断一条评论的风险等级;在 Agent 系统中,检查一次工具调用是否安全,或者模型输出是否达标。
它返回的不只是最终标签,还有完整的概率分布。当两个选项的概率非常接近(比如 51% vs 49%),你就知道模型其实很犹豫。这时候,代码可以介入:设置阈值、加入硬规则,或者直接转人工。
这种设计让 Jev 更像一个可复用的“判断模块”。它可以放在 Agent 循环的外围,负责路由、风控、筛选和质检,而不参与生成或规划。
概率真的靠谱吗?
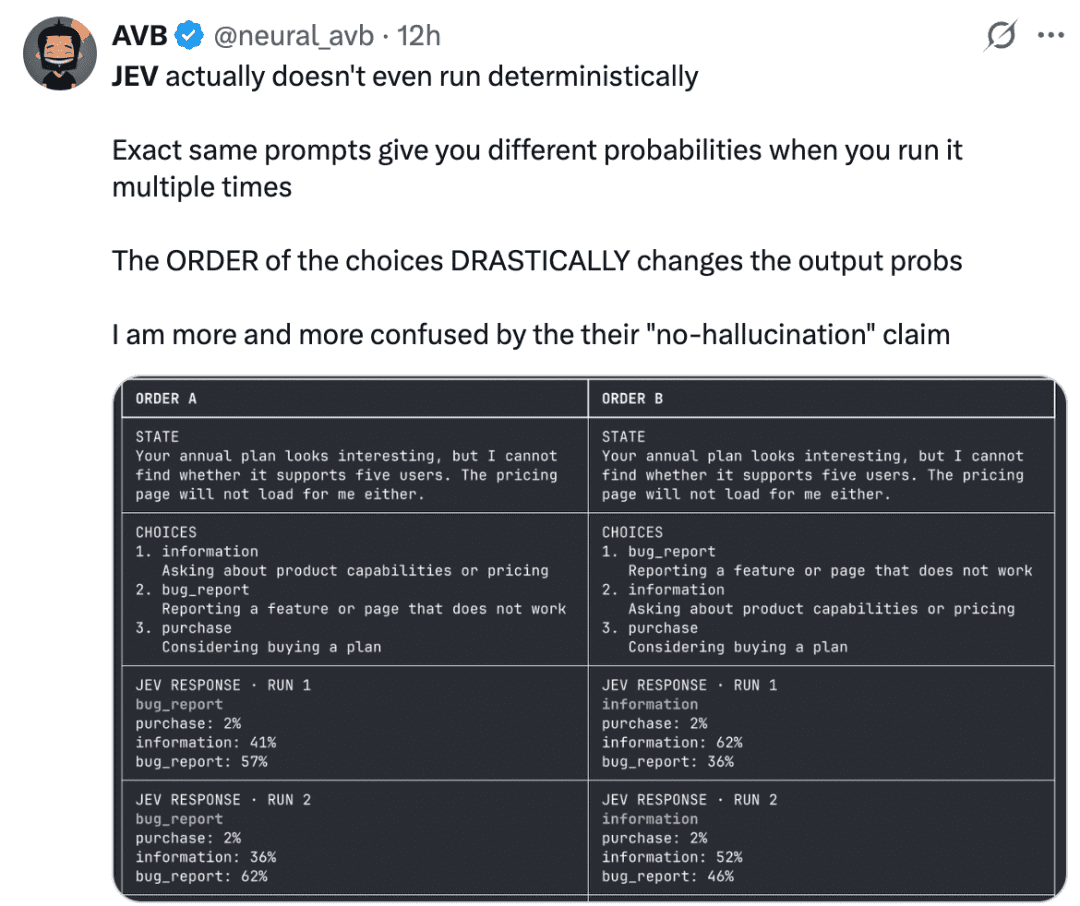
尽管泛化能力受认可,Jev 的概率输出稳定性却引发质疑。
有网友发现,同样的提示词多次运行,结果会有波动。更麻烦的是,选项的顺序会显著影响输出。比如客户消息不变,只是把“信息咨询”和“bug 报告”调换位置,模型就从倾向选 bug_report 变成倾向选 information。
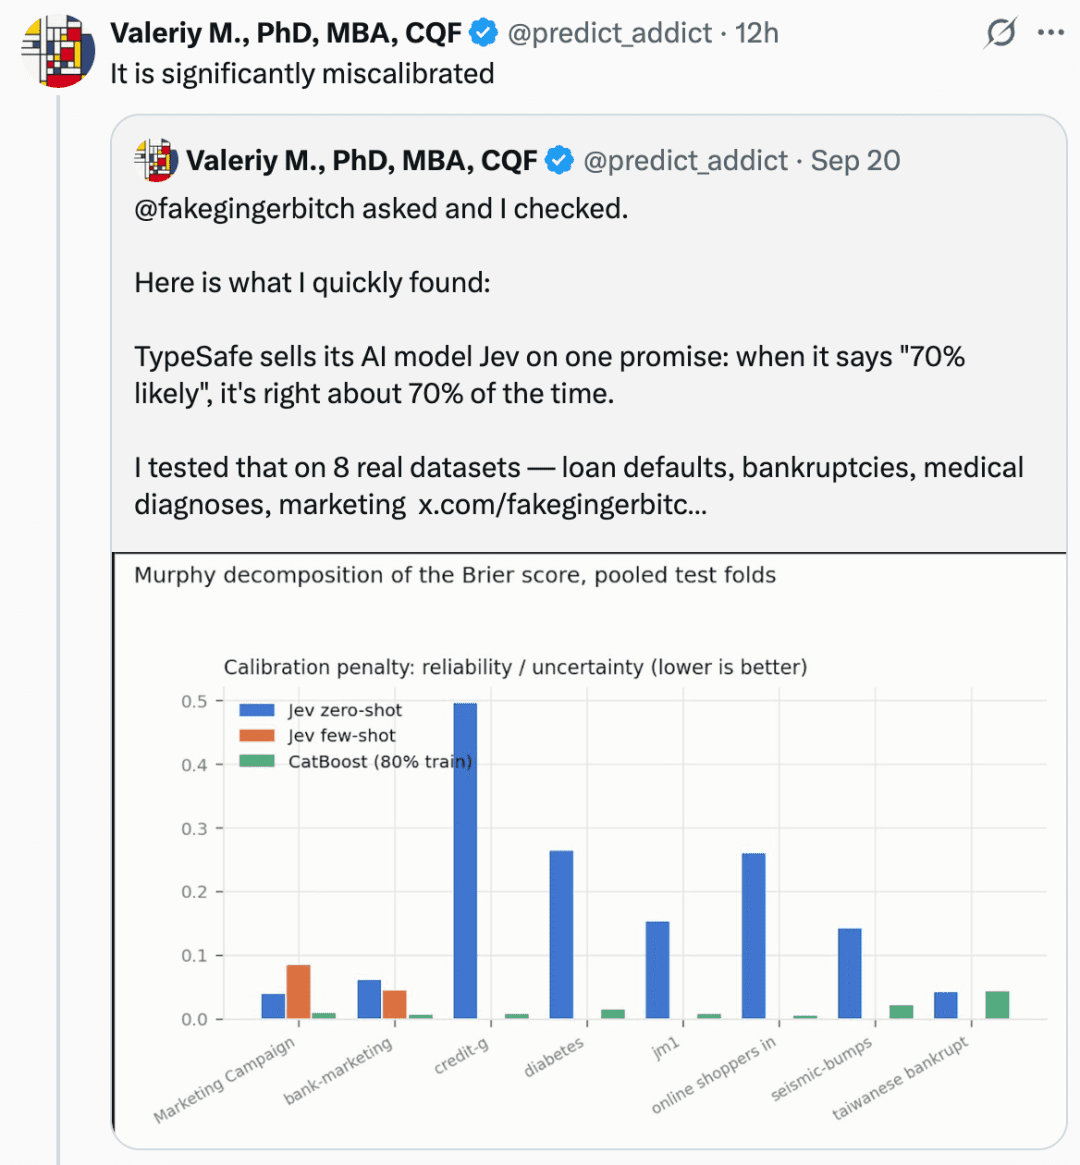
用户 @predict_addict 在八个真实数据集(包括贷款违约、企业破产、医疗诊断)上测试后指出,Jev 的概率校准明显不如 CatBoost,经常高估负面结果。不过,经过简单的后处理(比如 Platt scaling),部分误差可以修正。
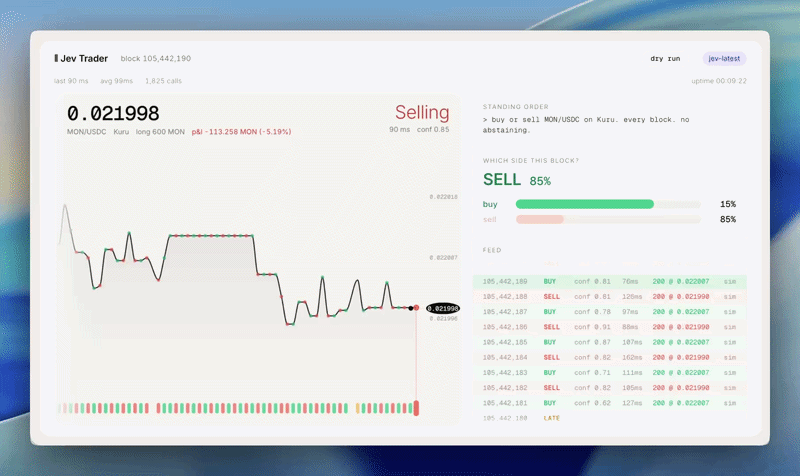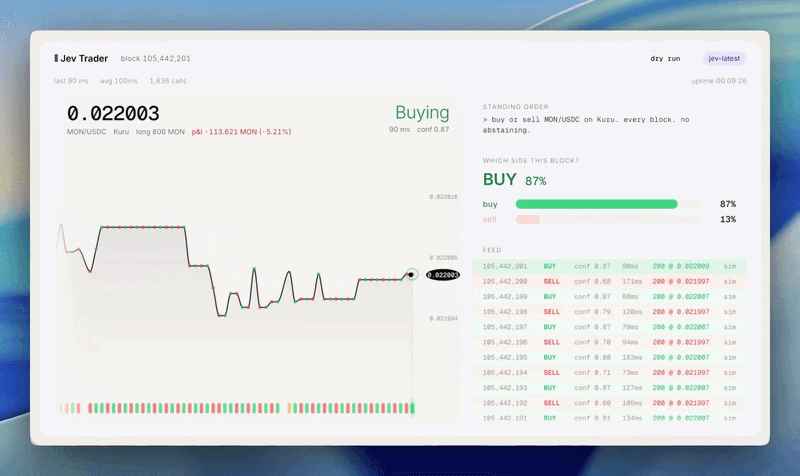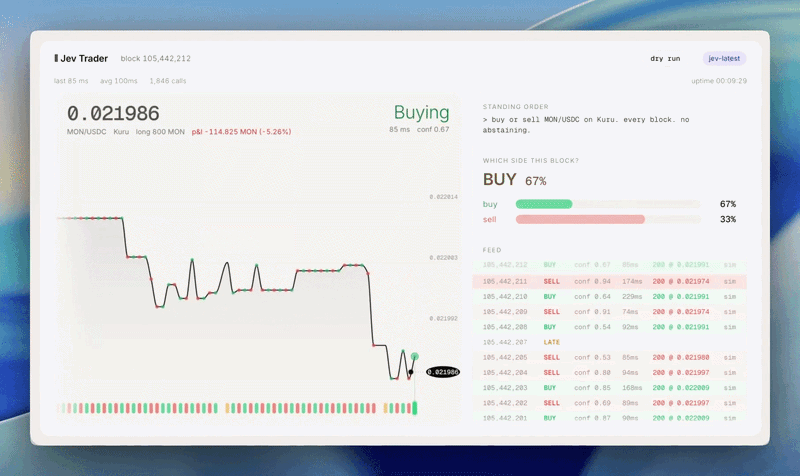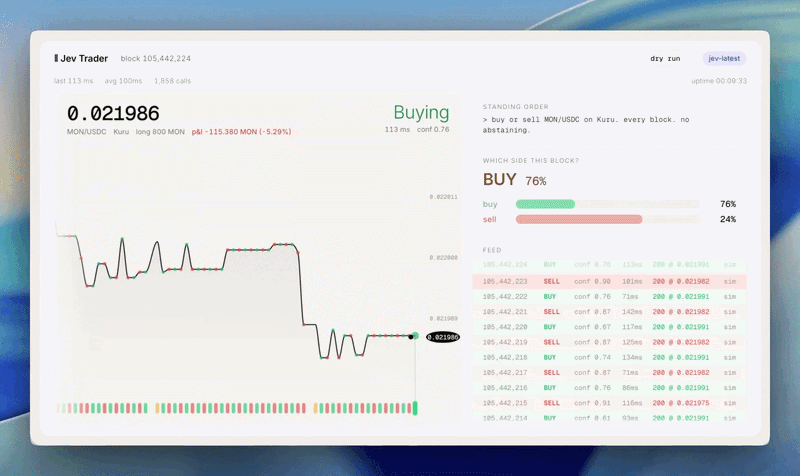
还有人拿它搭了个全自动交易机器人,结合链上和链下数据做买卖决策,结果一个早上亏了 3 万多美元——当然,这更多是策略问题,但也能看出盲目信任模型概率的风险。
TypeSafe AI 自己也在 Jev 1.13 的文档里坦承,模型在算术、计数、日期解析、字面匹配、对抗性输入和矛盾条件等任务上表现不稳定。换句话说,别指望它处理需要精确逻辑或数值计算的场景。
总结:小而专的判断工具
Jev 不是下一个通用大模型,而是一个高度聚焦的工具。它解决的问题很具体:在已知选项中做快速、可解释的判断,并给出不确定性度量。
对开发者来说,它的价值在于省去了为每个新分类任务重新训练模型的麻烦。只要问题边界清晰、选项可枚举,Jev 就能快速集成。
不过,别把它当成黑箱 oracle。它的概率会漂移,受输入顺序影响,校准也不完美。用的时候,最好加上后处理、阈值控制和 fallback 机制。
现在免费额度已经开放,不妨去试试看——至少打个末影龙的成本,你还能承受。