OceanBase登顶国际Data Agent榜单,国产数据库首次突破90%准确率
国产方案首次在DAB登顶
近日,OceanBase团队提交的Data Agent方案在国际数据智能体基准Data Agent Benchmark(DAB)中以90.62%的准确率位列第一。这是该榜单自设立以来,首个准确率突破90%的参评系统。更值得注意的是,这一成绩完全基于国产技术栈:底层大模型采用智谱AI的GLM-5.2,数据库为OceanBase自研引擎,未使用GPT、Claude Opus或Claude Fable等海外模型。
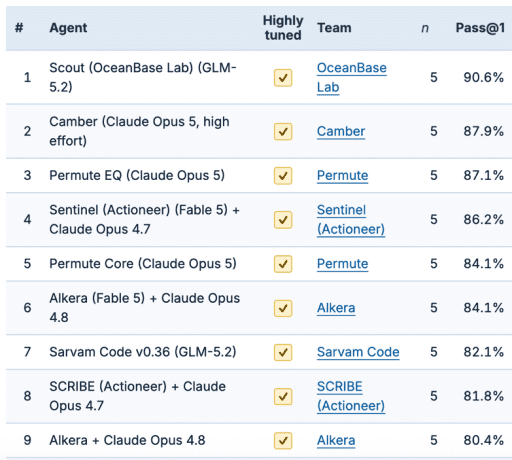
DAB由加州大学伯克利分校EPIC Data Lab与Hasura PromptQL联合推出,评测覆盖互联网、金融、生物医学、知识产权、政务、媒体等多个真实业务场景,并兼容PostgreSQL、MongoDB、SQLite、DuckDB等多种数据库类型。与传统Text-to-SQL仅测试自然语言转SQL的能力不同,DAB考察的是AI在真实数据环境中完成完整分析任务的能力——从理解问题、发现数据、规划路径、执行查询,到验证结果是否合理。
这意味着,一个合格的Data Agent不仅要会写SQL,还得知道该查哪张表、哪些字段相关、中间结果是否可信,甚至在出错时能自我修正。这种端到端的能力,考验的是“模型+Agent+数据系统”的协同效率。
不只是模型强,更是系统协同好
OceanBase此次参评的内部代号为Scout的方案,核心在于构建了一个完整的分析闭环。系统首先通过DataLens模块自动构建数据画像,识别表结构、字段语义及表间关联关系。当用户提出一个模糊或复杂的查询请求时,Agent会根据任务难度动态规划执行路径——比如先筛选关键表,再逐步关联计算,而不是一股脑生成复杂SQL。
得到初步结果后,系统不会直接返回,而是启动证据追踪和答案校验机制。例如,若查询“某公司近一年营收增长率”,系统会检查时间范围是否覆盖完整财年、收入字段是否包含非经营性收入、同比计算逻辑是否正确。一旦发现异常,会自动调整查询策略并重新验证,直到结果稳定可靠。
这种“理解—执行—验证—修复”的循环,正是90.62%高准确率的关键。它说明,即便底层模型并非全球最强(GLM-5.2在通用能力上仍略逊于GPT-4),但通过与数据库深度耦合,整体系统反而能在特定任务上超越依赖更强模型但缺乏数据协同的对手。
数据库角色正在发生根本转变
过去,数据库的核心职责是高效存储、快速查询和保证事务一致性。AI出现后,情况变了。现在的AI Agent不只是“取数据”,而是要“用数据做事”——比如分析用户流失原因、预测库存周转、生成合规报告。这些任务往往涉及多表关联、业务逻辑嵌套和结果可信度判断,远超传统SQL的范畴。
OceanBase的思路是:数据库不能只做被动的数据仓库,而要成为AI的“数据工作引擎”。这意味着,数据库需要主动帮助AI理解数据语义、组织分析流程、验证计算结果。比如,当AI问“为什么上季度销售额下降?”,数据库不仅要提供销售表,还要提示可能相关的营销活动表、退货记录、区域经济指标等,并协助构建归因分析链路。
这种转变,正是OceanBase从传统数据库向AI数据平台演进的核心逻辑。本次DAB登顶的Scout方案,后续将能力沉淀到OceanBase DataPilot产品中。DataPilot的目标不是替代BI工具,而是让AI能直接在数据库内完成从问题到洞察的全过程,减少数据搬运和上下文丢失。
国产技术栈的协同价值凸显
这次登顶还有一个隐含信号:国产软硬件协同正在形成独特优势。GLM-5.2作为国产大模型,在中文业务场景的理解上有天然适配性;OceanBase作为分布式数据库,在高并发、强一致性和复杂查询优化上积累深厚。两者结合,能在金融、政务等对数据安全和本地化要求高的领域快速落地。
相比之下,许多海外方案虽然模型强大,但在面对中文业务术语、本地数据规范(如企业财报格式、医保编码体系)时,往往需要额外微调或人工干预。而OceanBase+GLM的组合,从一开始就针对这些场景设计数据画像和推理规则,减少了“水土不服”的问题。
当然,这并不意味着国产方案已全面领先。DAB目前仍以结构化数据为主,未来若加入非结构化数据(如日志、文档、图像)的联合分析,挑战会更大。但至少在当前阶段,OceanBase证明了:在AI时代,数据库的价值不再只是“存得下、查得快”,而是“帮AI把数据真正用起来”。
从底座到引擎,数据库的新定位
数据库与AI的关系,正在从“服务者”变为“协作者”。过去,AI调用数据库就像点外卖——下单、取餐、走人。现在,数据库更像是厨房里的智能助手:不仅备好食材,还能建议菜谱、提醒火候、尝味调整。
OceanBase的这次突破,本质上是在验证这种新角色的可行性。它没有追求单点技术的极致(比如不用最强模型),而是通过系统级整合,在真实任务中实现更高整体准确率。这种思路或许比单纯堆模型参数更有实际意义——毕竟企业要的是可靠答案,不是炫技demo。
随着DataPilot产品逐步集成Scout的能力,未来用户可能只需用自然语言提问,就能获得经过多轮验证的分析结论,而不仅是原始数据或简单图表。这或许才是AI时代数据库该有的样子:不再是沉默的仓库,而是活跃的数据工作伙伴。